발표자료 다운로드 — 에이전트를 업무에 쓰기 위한 열두 가지 판단
AI 에이전트는 LLM이 도구를 써서 업무를 처리하는 시스템이다. 중간 절차를 사람이 아니라 모델이 정하기 때문에 설계와 도입과 통제를 함께 준비해야 업무에 쓸 수 있다.
전체 88장, PDF로 88쪽이다. 앞의 네 파트는 에이전트가 무엇이고 어떻게 만드는지를 다룬다. 뒤의 여덟 파트는 도입 전략과 조직, 개발 방식, 운영과 보안, 실행 기반을 다룬다.
장점만 적지 않았다. 토큰 비용, 프로젝트 중단 전망, 승인 피로처럼 도입 뒤에 드러나는 부담도 같은 비중으로 담았다.
사내 검토 자료나 팀 스터디 자료로 바로 쓸 수 있도록 원본 구성 그대로 PDF로 공개한다.
MSAP.ai 백서 구독하기🔔
새로운 백서 소식을 가장 먼저 만나보세요!
MSAP.ai 가 전하는 AI 기반 운영 인사이트와 최신 백서 소식을 가장 빠르게 받아보실 수 있습니다.
구독해 주시면 더 좋은 콘텐츠로 보답하겠습니다.🙏
발표 영상으로 먼저 보기 — LLM 게이트웨이 편
발표자료의 열두 번째 파트는 로컬 LLM과 LLM 게이트웨이를 다룬다. 에이전트가 늘어나면 모델 호출이 여러 경로로 흩어지고, 그 경로를 한 곳으로 모으는 것이 운영의 출발점이 된다.
아래 영상은 그 파트의 핵심인 게이트웨이와 직접 연동의 차이를 짧게 설명한다.
영상에서 다루는 순서는 다음과 같다.
- 애플리케이션이 모델을 직접 부를 때 생기는 키 관리와 비용 집계 문제
- 모든 요청이 게이트웨이 한 곳을 지나야 하는 이유
- 게이트웨이를 두었을 때 바뀌는 통제와 기록 방식
에이전트의 정의와 구조를 먼저 정리하려면 AI 에이전트란 무엇인가를 함께 보면 된다.
이 발표자료가 답하는 일곱 가지 질문
에이전트 도입을 검토하는 조직에서 반복해서 나오는 질문을 기준으로 슬라이드를 배치했다.
- AI 에이전트는 챗봇이나 RPA와 무엇이 다른가
- 업무마다 자율 수준은 어떻게 정하는가
- Workflow와 에이전트는 언제 나눠 쓰는가
- 멀티 에이전트는 언제 필요한가
- 에이전트 도입은 어떤 순서로 진행하는가
- 에이전트의 보안 위험은 무엇이 다르고 어떻게 막는가
- 로컬 LLM과 LLM 게이트웨이는 언제 필요한가
챗봇은 질문에 답하고 에이전트는 업무를 끝까지 처리한다
Chat AI는 질문을 받아 한 번 응답하고 끝난다. AI 에이전트는 목표를 받아 계획을 세우고, 도구를 호출하고, 결과를 확인하는 과정을 업무가 끝날 때까지 반복한다.
미수금 정리를 요청하면 차이가 분명해진다. Chat AI는 정리하는 방법을 설명한다. 에이전트는 ERP를 조회해 표를 만들고 거래처에 보낼 메일 초안까지 작성한다. 그래서 도입 대상이 질문 응답에서 업무 처리로 넓어진다.
챗봇의 검토 항목을 에이전트에 그대로 쓰면 안 된다. 에이전트는 사람의 확인 없이 다음 단계로 넘어가므로 잘못된 판단 하나가 다음 단계의 입력이 된다.
| 구분 | Chat AI | AI 에이전트 |
|---|---|---|
| 입력 | 질문 | 목표 |
| 처리 | 한 번 응답 | 계획, 도구 호출, 결과 확인 반복 |
| 출력 | 답변 글 | 업무 결과물 |
| 사람의 역할 | 매번 다음 질문 | 목표 설정과 결과 승인 |
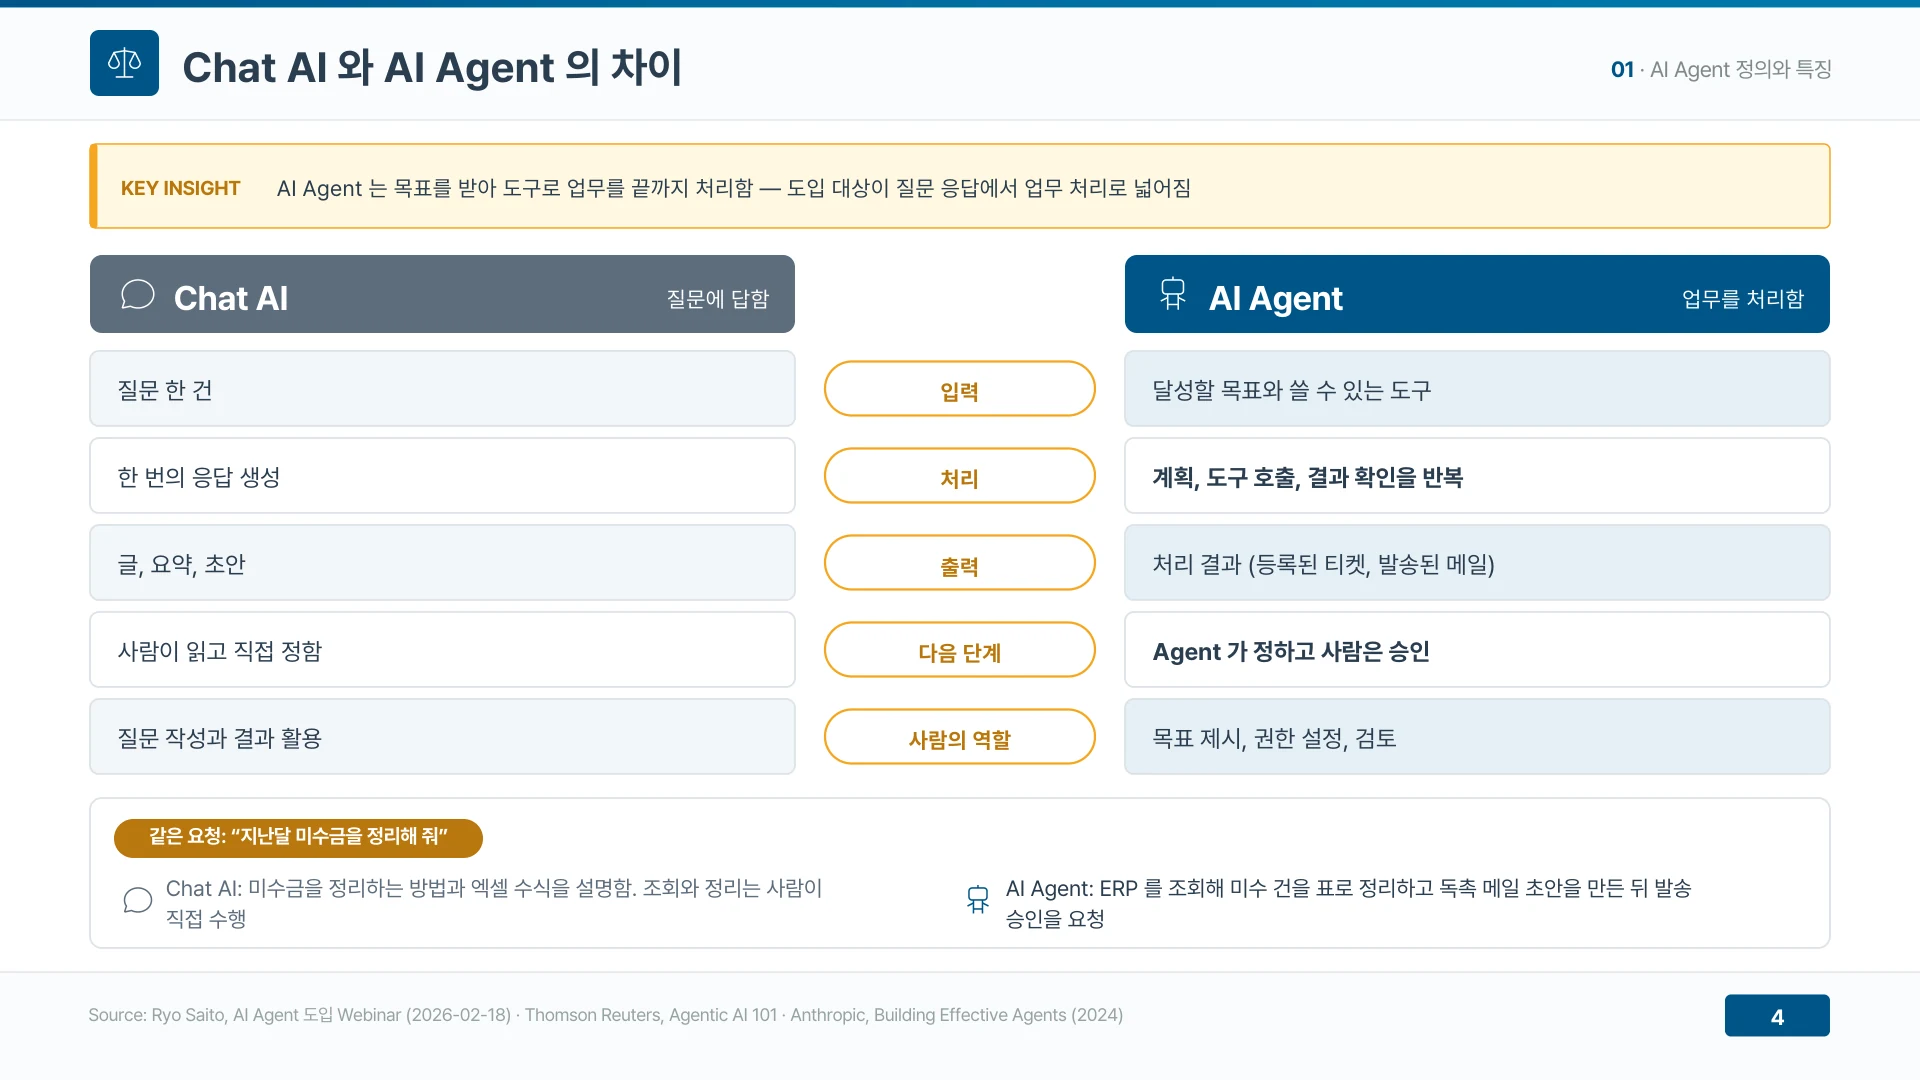
▲ 챗봇은 질문에 답하고 AI 에이전트는 목표를 받아 업무를 끝까지 처리한다 (발표자료 4쪽)
자율 수준은 업무의 위험과 되돌릴 수 있는 정도로 정한다
에이전트인지 아닌지를 둘로 나누지 않고 자율 수준으로 본다. 업무마다 알맞은 자율 수준을 정하는 것이 설계의 출발점이다.
자율 수준은 예약된 순차 처리에서 시작해 이벤트 기반 순차 처리, 사람의 응대 모방, 반자율, 자율 폐쇄 루프로 올라간다. 피해가 크거나 되돌릴 수 없는 업무는 사람이 감독하는 반자율 이하에서 시작한다. 모든 업무에 완전 자율이 맞는 것은 아니다.
기존 자동화와의 경계도 같은 기준으로 긋는다. 규칙 기반 자동화는 정해진 절차를 따르고, 에이전트는 목표에 따라 절차를 정한다. 절차를 순서도로 그릴 수 있으면 규칙 기반이 먼저다. 건당 비용과 결과의 일정함은 RPA가 유리하다.
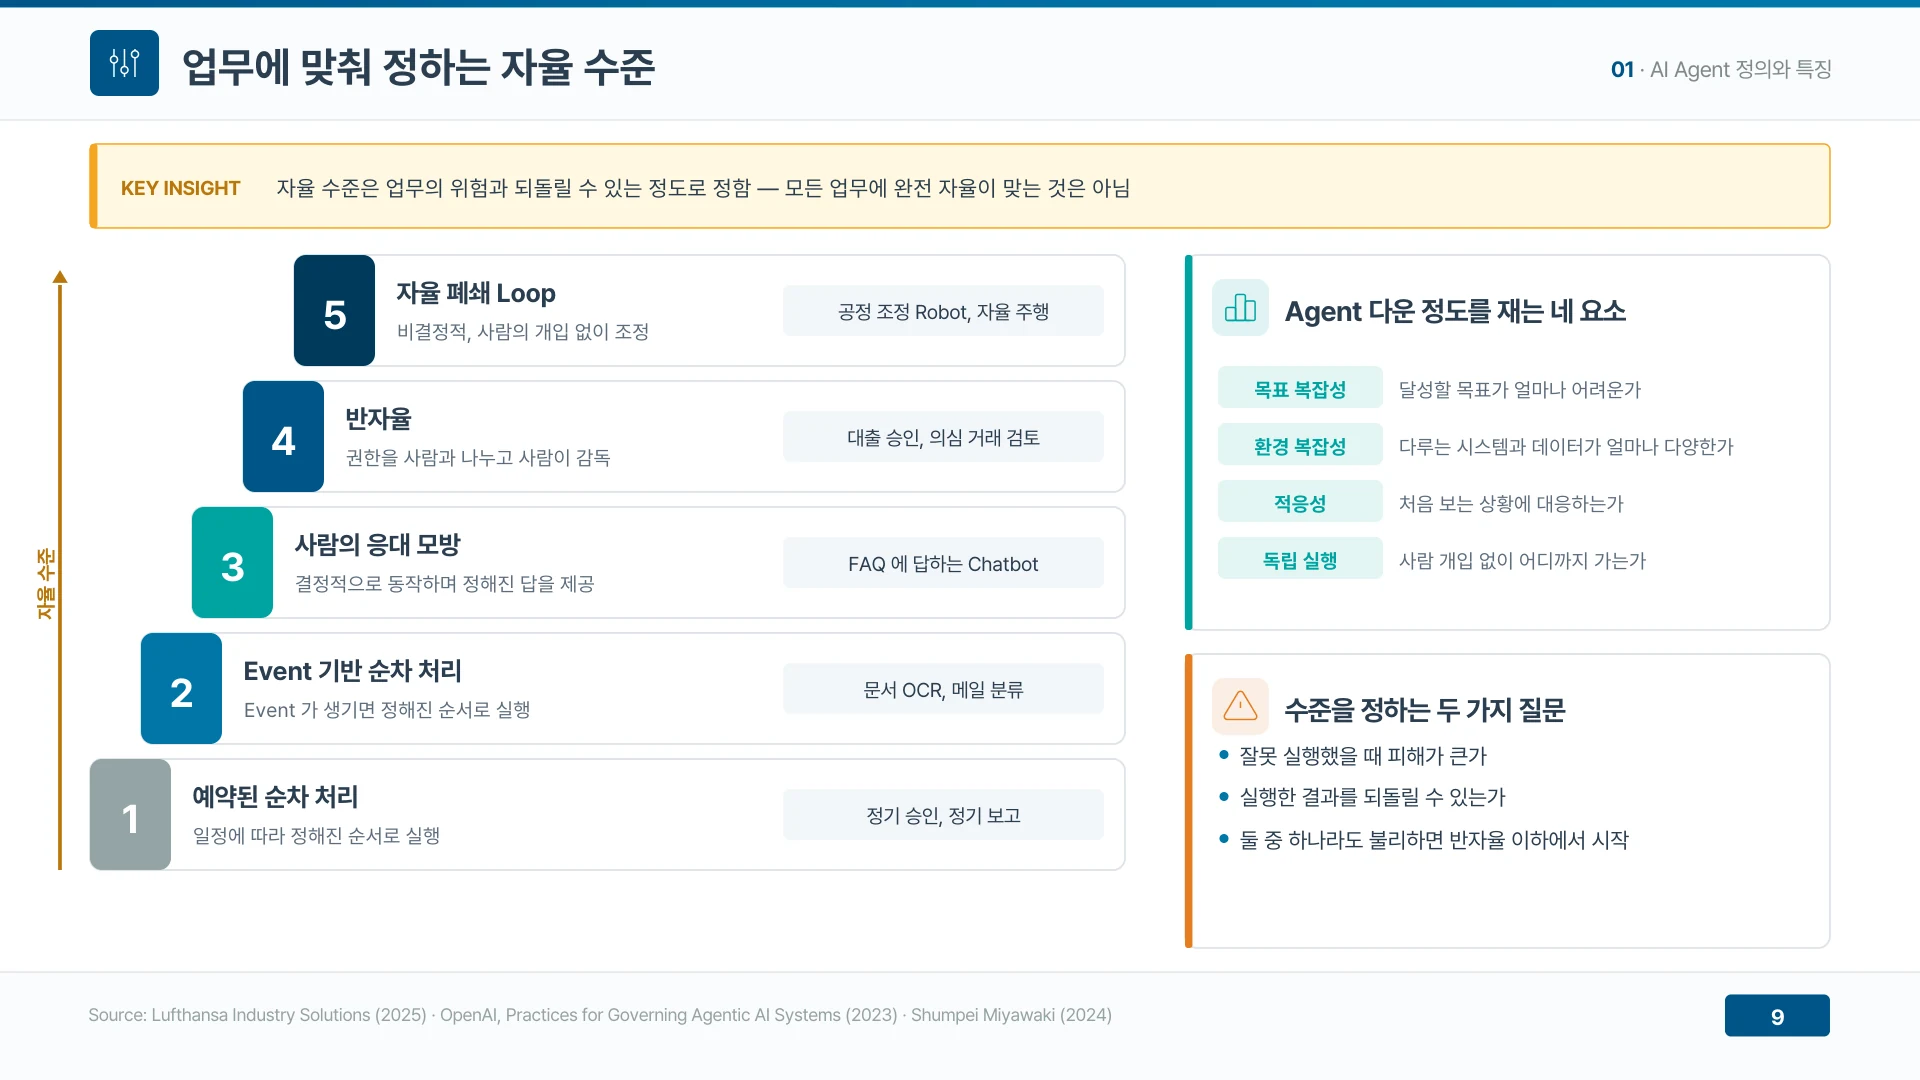
▲ 자율 수준은 업무의 위험과 되돌릴 수 있는 정도로 정한다 (발표자료 9쪽)
ReAct 루프는 사실 오류를 줄이지만 반복 상한이 필요하다
에이전트의 기본 동작은 계획, 도구 사용, 관측의 반복이다. 이 반복을 구현한 대표 패턴이 생각과 행동과 관찰을 번갈아 수행하는 ReAct다.
ReAct 원 논문의 실패 분석에서 틀린 사실의 생성은 ReAct가 0%, Chain of Thought가 56%였다. 외부 근거를 확인하므로 사실 오류가 줄어든다. 반대로 추론 오류는 ReAct가 47%로 더 많았다. 같은 행동을 되풀이하는 오류가 생기기 때문이다. 그래서 반복 상한과 멈추는 조건을 함께 정해 둔다.
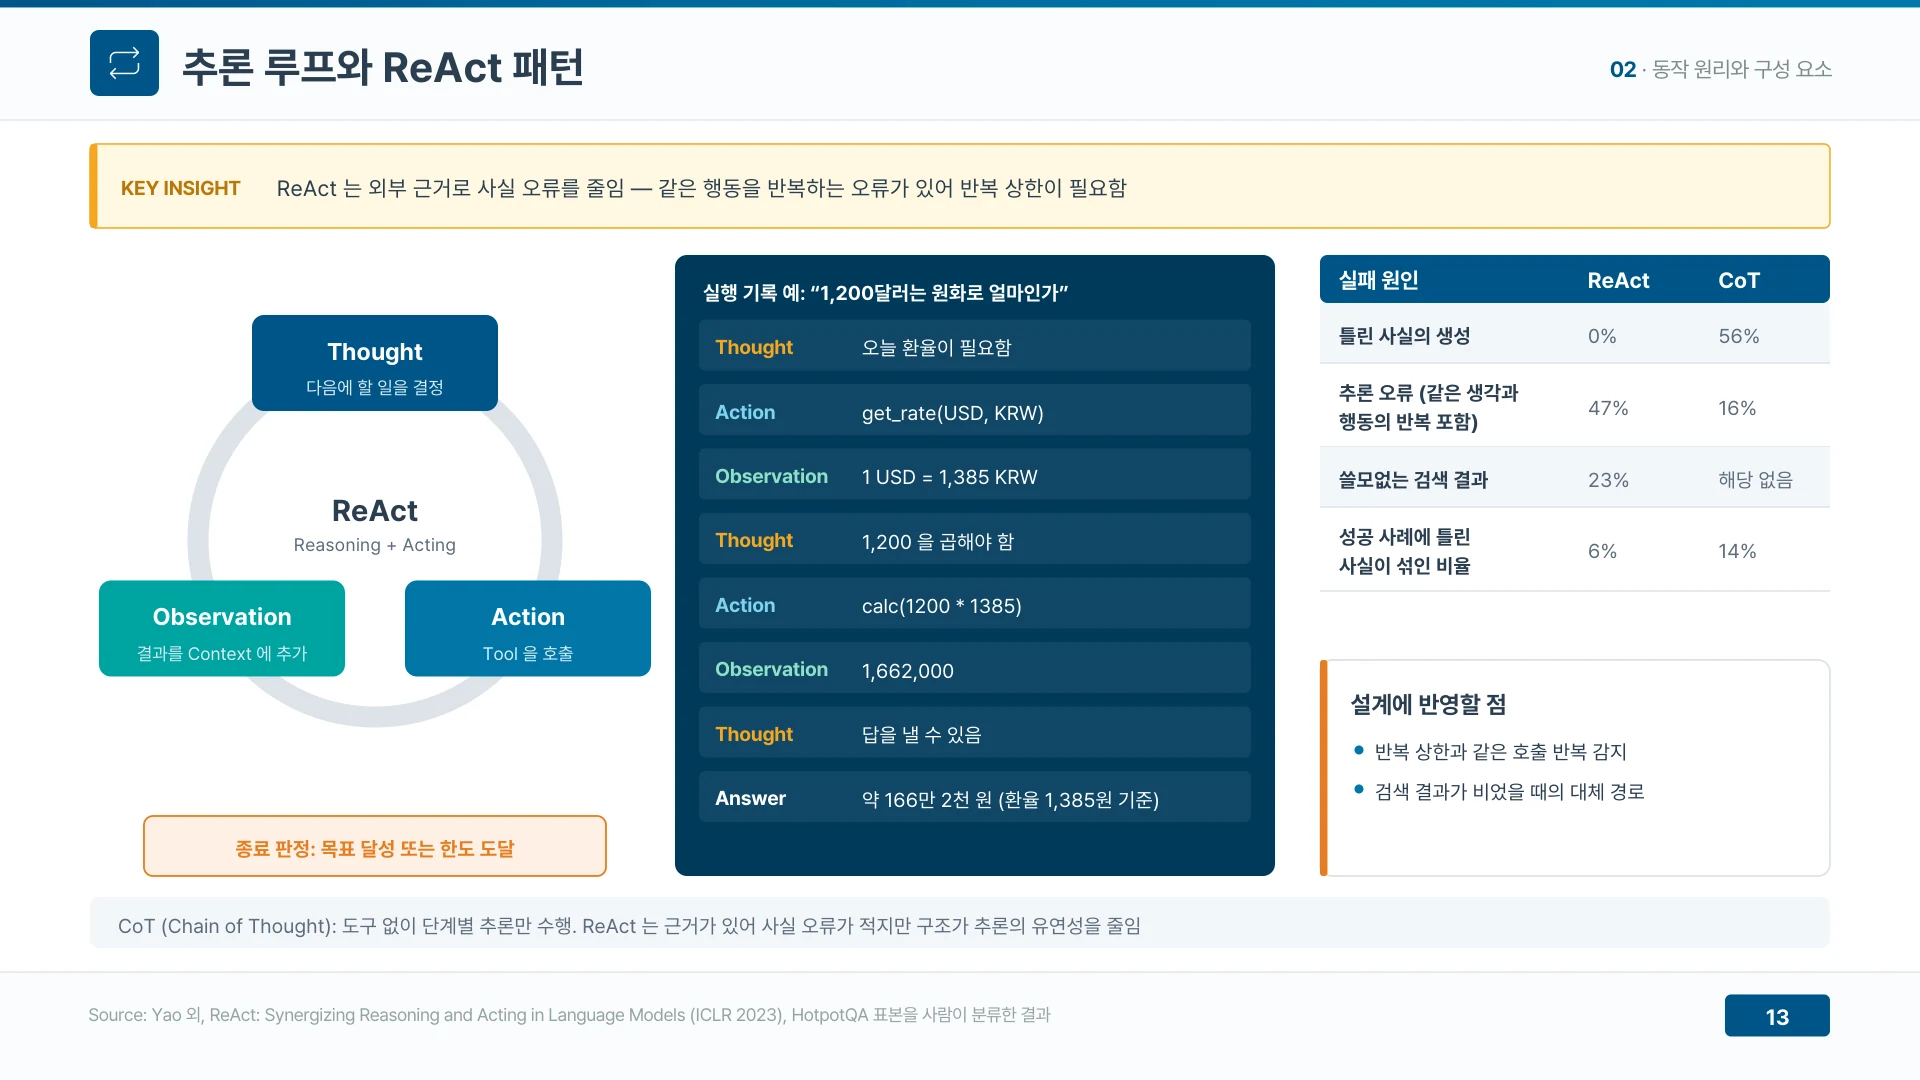
▲ ReAct는 외부 근거로 사실 오류를 줄이지만 같은 행동을 반복하는 오류가 생긴다 (발표자료 13쪽)
LLM은 도구를 직접 실행하지 않고 호출 인자만 만든다
에이전트가 할 수 있는 일의 범위는 주어진 도구가 정한다. 도구는 정보를 얻는 것과 환경을 바꾸는 것으로 나뉜다.
Function Calling에서 LLM은 호출 인자만 만든다. 실행과 권한 검사는 애플리케이션이 맡는다. 그래서 환경을 바꾸는 도구일수록 권한을 좁혀야 하고, 도구의 이름과 설명과 인자 스키마의 품질이 호출 정확도를 정한다.
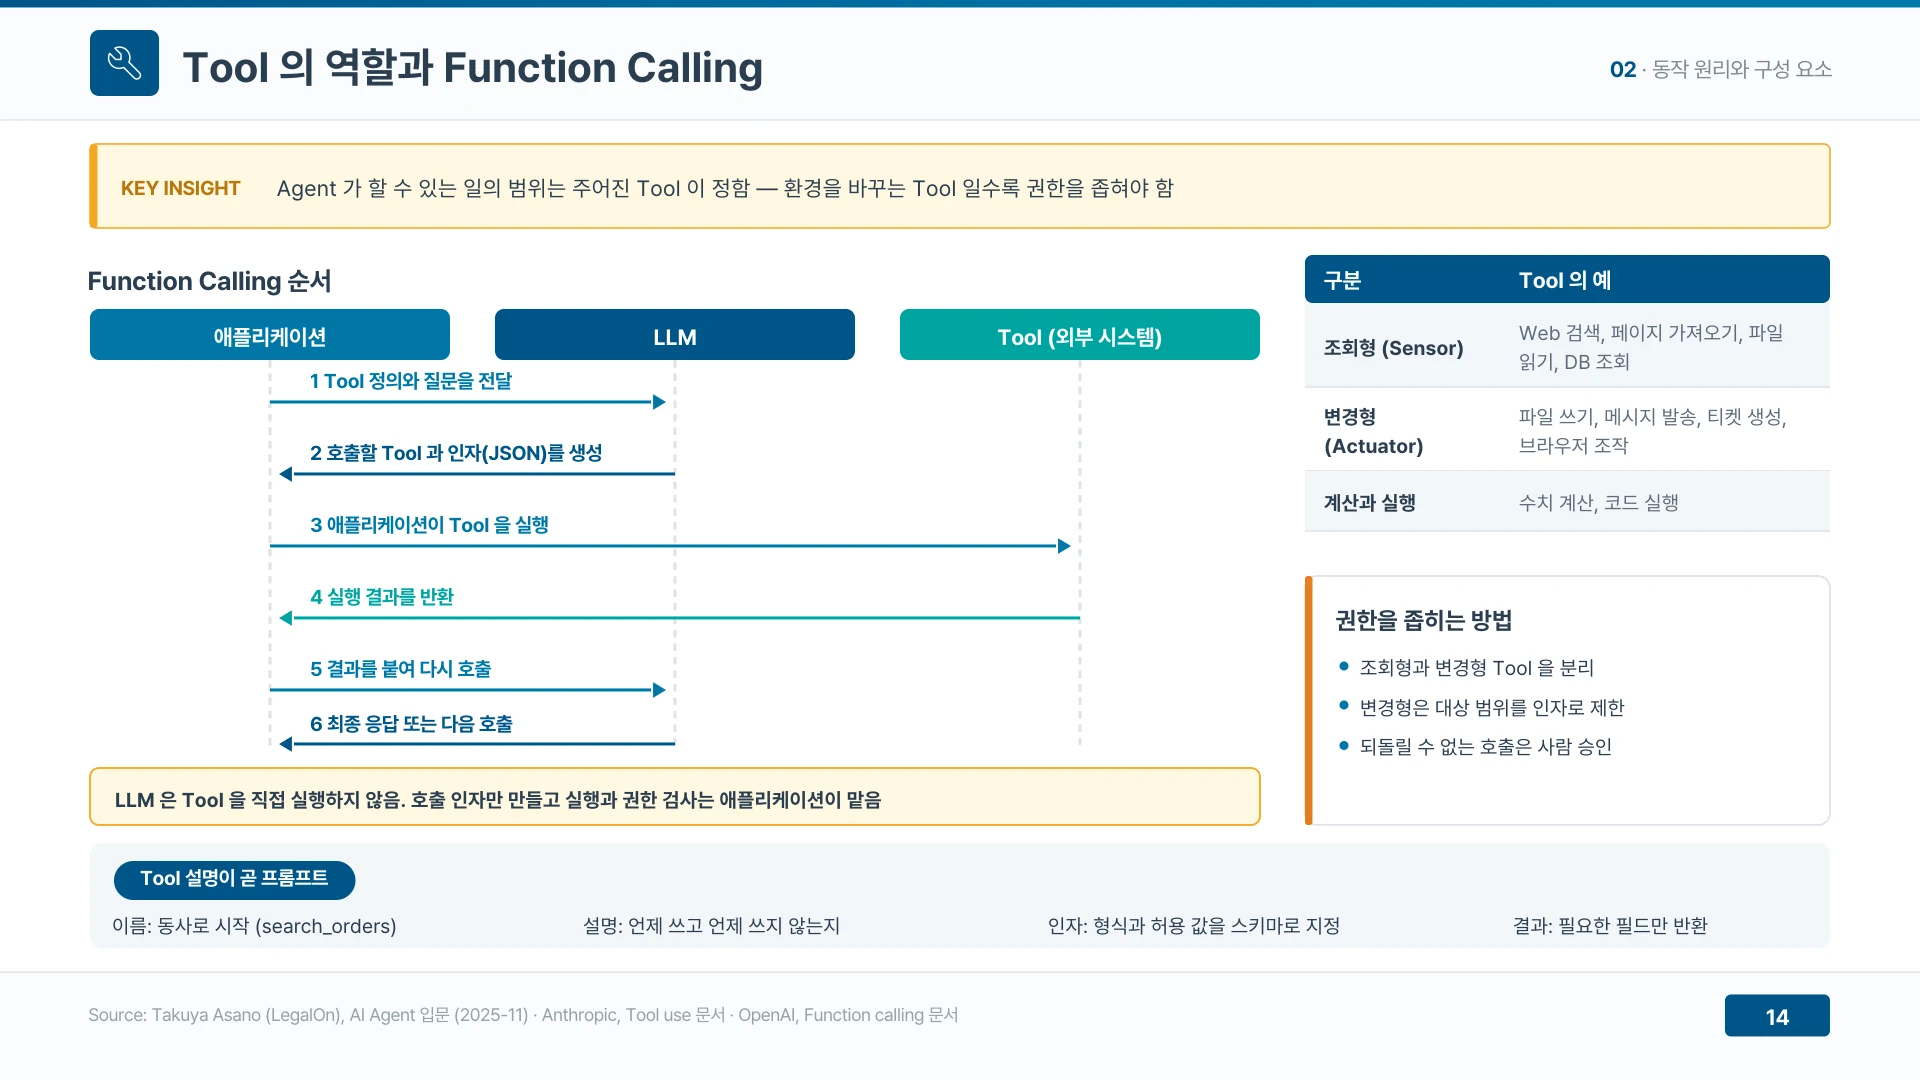
▲ LLM은 호출 인자만 만들고 도구 실행과 권한 검사는 애플리케이션이 맡는다 (발표자료 14쪽)
정형 업무는 Workflow로 고정하고 판단 구간만 에이전트에 맡긴다
Workflow는 코드가 실행 순서를 정하고, 에이전트는 LLM이 순서를 정한다. 예측 가능성과 유연성을 맞바꾸는 선택이다.
Anthropic은 Workflow 패턴을 Prompt Chaining, Routing, Parallelization, Orchestrator-Workers, Evaluator-Optimizer 다섯 가지로 정리했다. 업무 대부분은 에이전트까지 가지 않고 이 고정된 흐름으로 해결된다. 실무에서는 둘을 결합한다.
복잡도는 LLM 호출 한 번, RAG와 도구, Workflow, 단일 에이전트, Skill, 멀티 에이전트 순서로 올린다. 측정 결과가 요구할 때만 한 칸씩 올린다. 복잡한 구성은 지연과 비용을 늘리기 때문이다.
Workflow를 코드 없이 화면에서 조립하는 빌더도 있다. n8n, Flowise, Dify, LangFlow의 차이는 AI 에이전트 빌더 4종 심층 비교에서 함께 볼 수 있다.
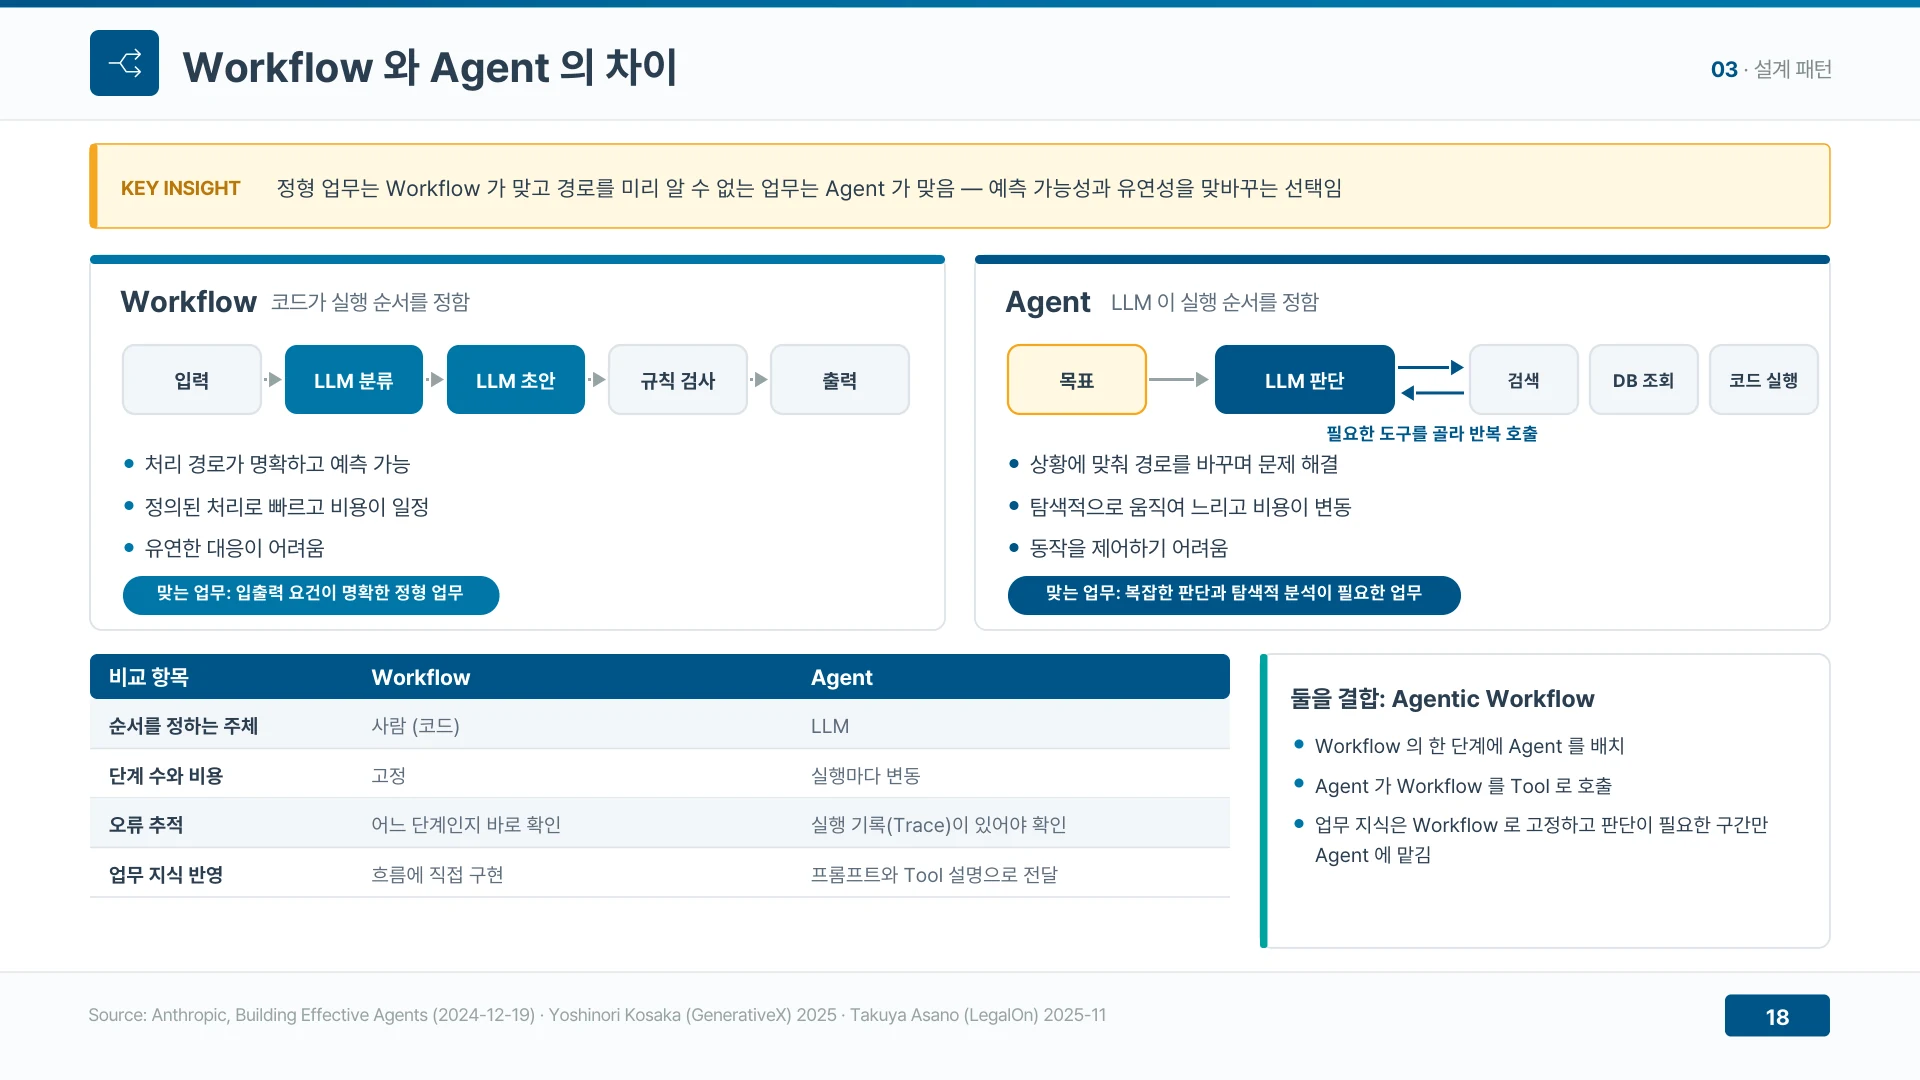
▲ 정형 업무는 Workflow가, 경로를 미리 알 수 없는 업무는 에이전트가 맡는다 (발표자료 18쪽)
멀티 에이전트는 경계가 드러난 뒤에 나눈다
Context가 길어지고 도구가 많아지면 에이전트 하나의 정확도가 떨어진다. 이때 역할을 나눠 전문 에이전트에 적은 수의 도구를 준다.
비용이 따른다. Anthropic은 자사 연구 시스템에서 멀티 에이전트가 일반 대화의 약 15배 토큰을 쓴다고 밝혔다. 그래서 단일 에이전트로 시작하고, 나누기 전에 Skill 추가로 해결되는지 먼저 확인한다.
나눈 뒤의 실패는 대개 모델 성능이 아니라 사양과 조율에서 생긴다. 역할과 종료 조건을 문서로 고정하고 검증을 별도 단계로 분리한다.
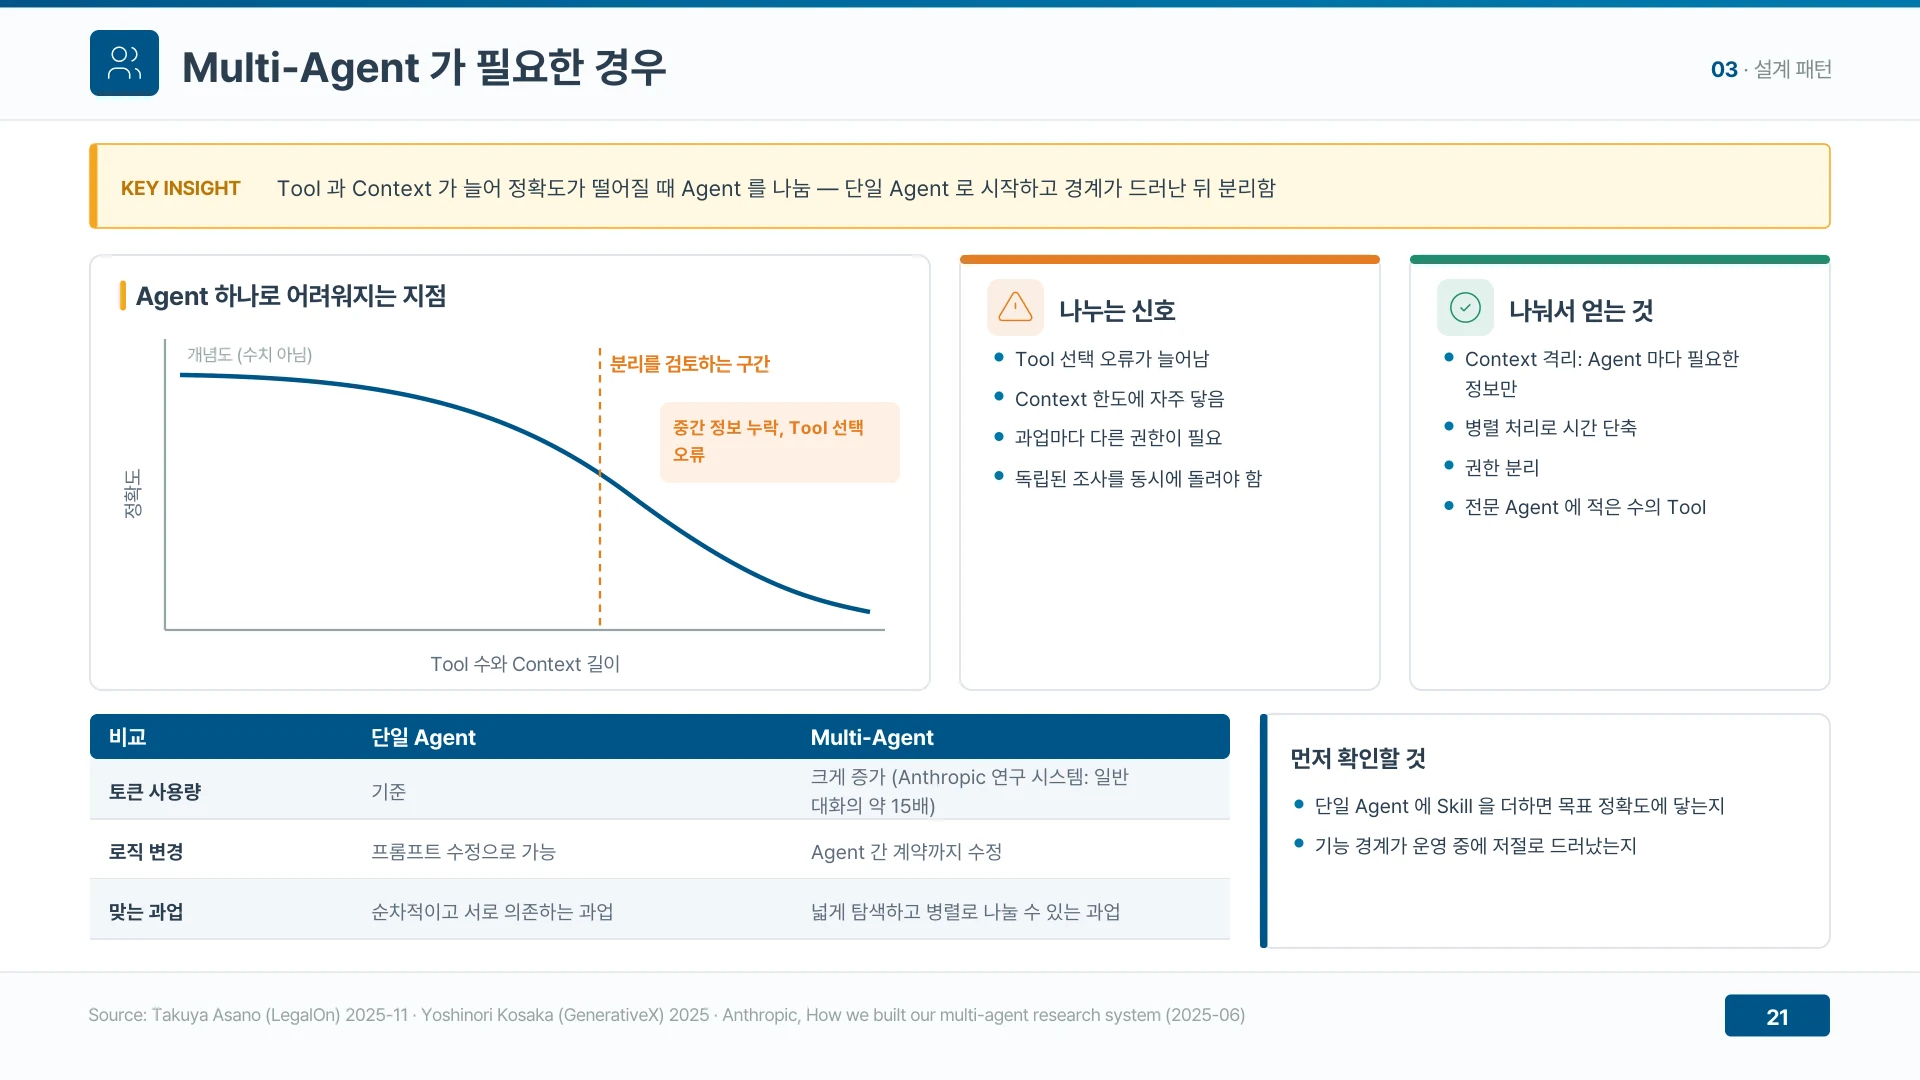
▲ 도구와 Context가 늘어 정확도가 떨어질 때 에이전트를 역할별로 나눈다 (발표자료 21쪽)
MCP는 도구 연결을, A2A는 에이전트 사이 연결을 맡는다
MCP는 에이전트와 외부 도구를 잇는 공개 표준이다. 도구를 한 번 MCP 서버로 만들면 여러 에이전트에서 그대로 쓸 수 있어, 에이전트 세 개와 도구 세 개를 잇는 연동이 아홉 개에서 여섯 개로 줄어든다.
A2A는 서로 다른 에이전트가 상대를 찾아 일을 맡기는 프로토콜이다. Agent Card를 조회하고, Task를 만들고, 진행 상태를 받고, 결과물인 Artifact를 받는다. 같은 조직 안에서는 하위 에이전트를 도구로 호출하면 충분하고, 다른 조직이 만든 에이전트와 연동할 때 A2A가 필요하다.
MCP 서버는 공급망 위험 대상이다. 출처와 권한 범위를 검토한 뒤에 연결해야 한다.
에이전트는 실행 시점에 도구를 불러와 역량을 조립하므로 배포 때의 의존성 목록으로는 실제 연결을 알 수 없다. 연결된 MCP 서버와 도구 목록을 자동으로 생성해야 공급망 통제 대상이 정해진다.
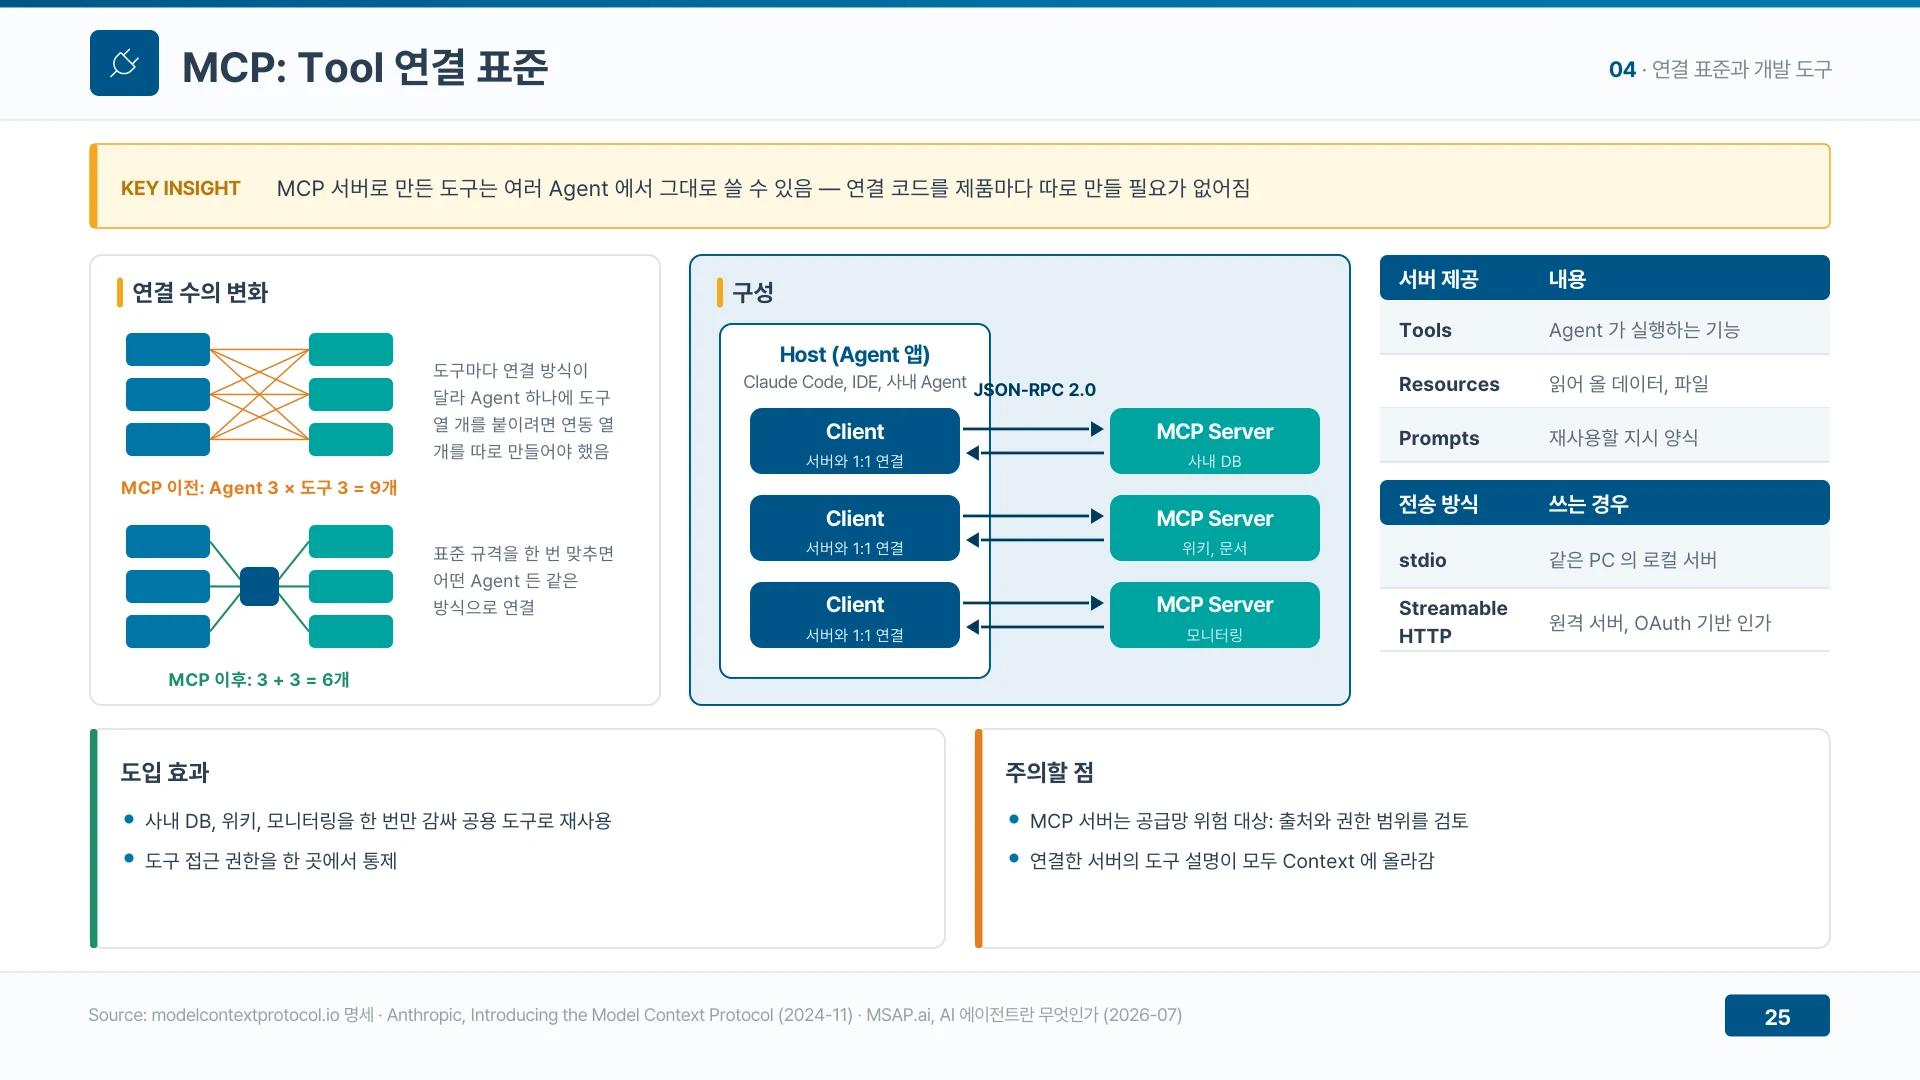
▲ MCP 서버로 만든 도구는 여러 에이전트에서 그대로 쓸 수 있다 (발표자료 25쪽)
Agent Skills는 도구가 아니라 일하는 절차를 준다
Agent Skills는 작업 절차와 스크립트, 참고 자료를 한 폴더로 묶은 것이다. 도구가 기능 하나를, MCP가 연결 방법을 준다면 Skill은 작업 전체의 방법을 준다.
Skill은 이름과 설명만 먼저 올리고 본문과 스크립트는 필요할 때 읽는다. 그래서 많이 설치해도 시작할 때 토큰 부담이 작다. MCP가 도구 설명을 처음부터 모두 올리는 것과 다르다. Agent Skills는 2025년 12월 공개 표준이 됐고, 지금은 여러 코딩 에이전트가 같은 Skill 폴더를 그대로 읽는다.
| 구분 | 제공하는 것 | 로딩 방식 |
|---|---|---|
| 도구 | 기능 하나 | 정의를 모두 올림 |
| MCP | 외부 시스템 연결 방법 | 도구 설명을 처음부터 올림 |
| Agent Skills | 일하는 절차와 스크립트 | 이름과 설명만 먼저, 본문은 필요할 때 |
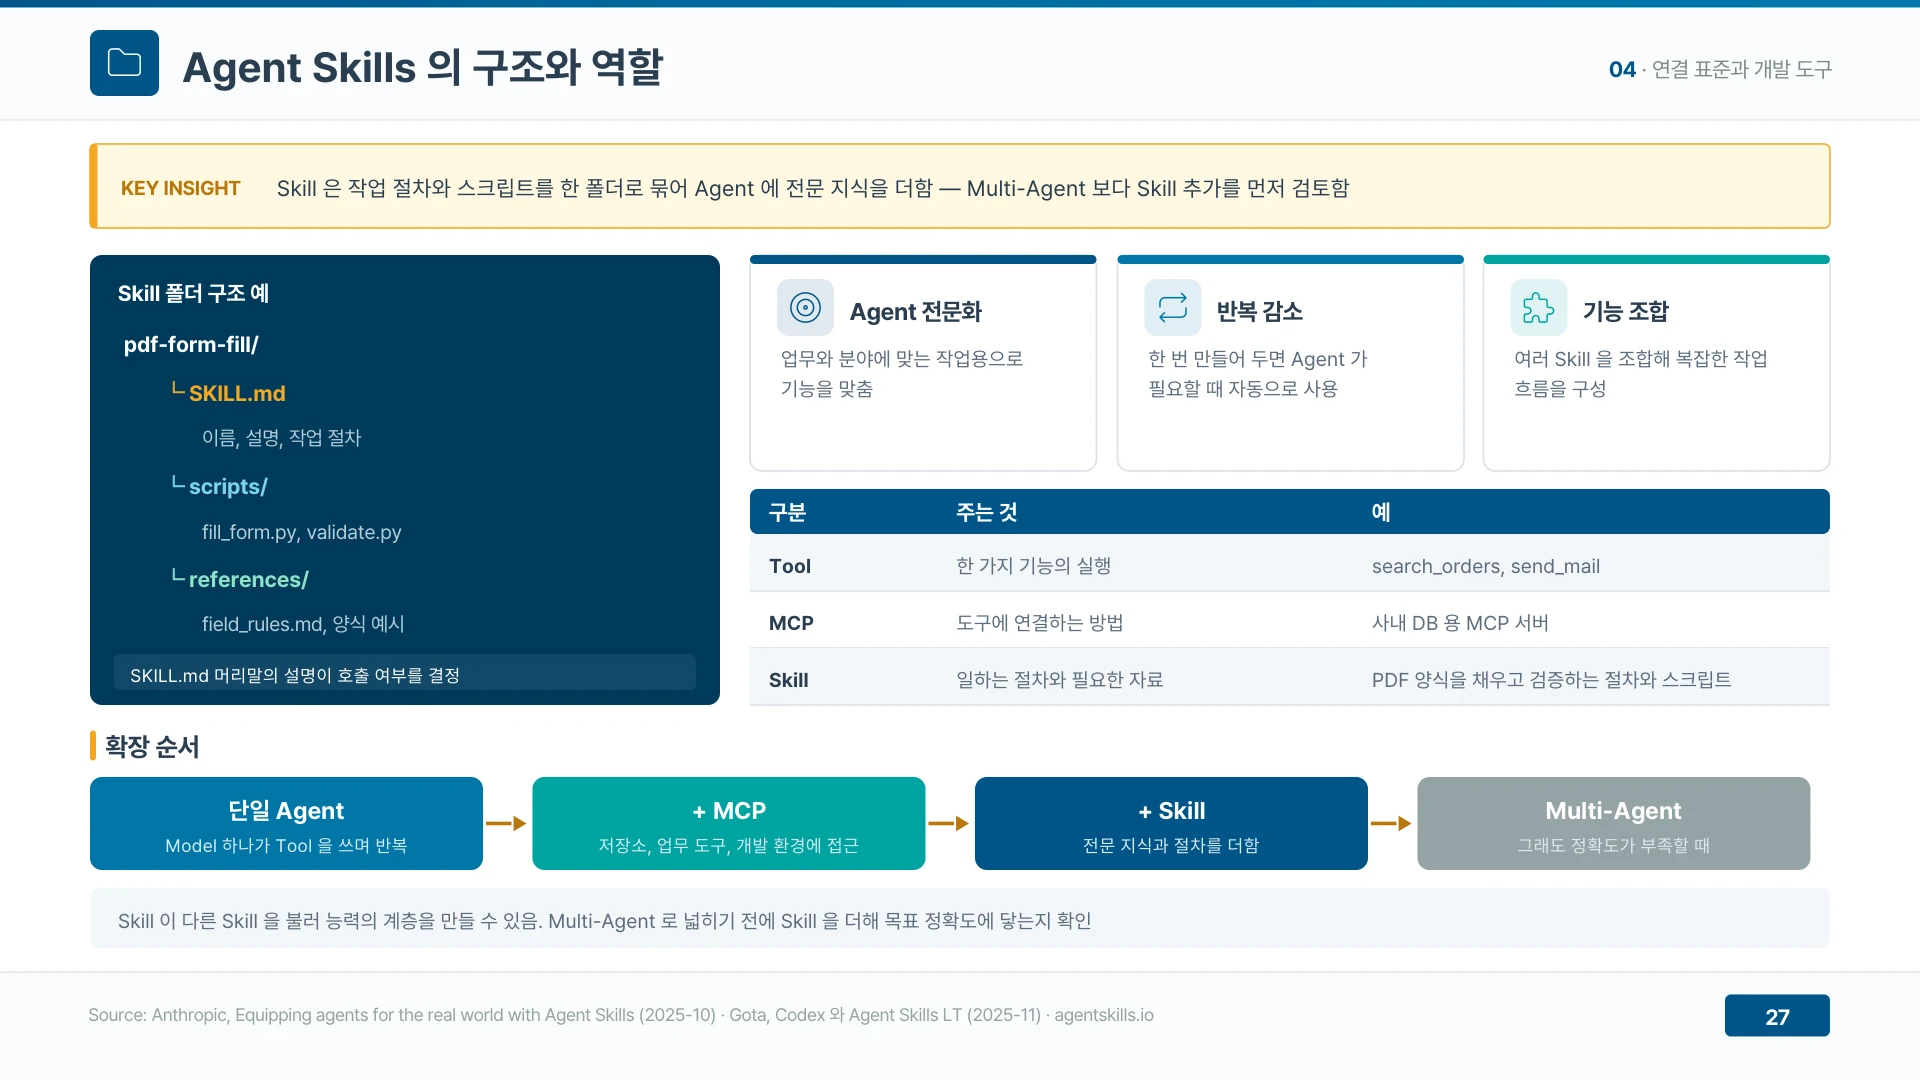
▲ Agent Skills는 작업 절차와 스크립트를 한 폴더로 묶어 에이전트에 전달한다 (발표자료 27쪽)
사람이 처리할 수 없는 양과 시간대의 업무에서 효과가 크다
AI 도입 전략은 DX에서 AX로 바뀌었다. 어디에 AI를 적용할지를 묻던 단계에서, 사람과 에이전트가 무엇을 함께 할지를 정하는 단계가 됐다.
기대는 높다. Gartner의 2025년 Hype Cycle에서 AI 에이전트는 기대의 정점에 있다. 같은 Gartner는 2027년 말까지 Agentic AI 프로젝트의 40% 이상이 비용 증가, 불명확한 사업 가치, 미흡한 위험 통제 때문에 중단될 것으로 전망했다.
효과가 공개된 사례는 모두 업무를 좁게 정했다. JPMorgan은 계약 문서 검토에서 연간 36만 시간을 줄였고, Klarna의 AI 상담원은 첫 달 230만 건의 채팅을 처리했고, Walmart는 8억 5천만 건의 상품 데이터를 정비했다. Klarna는 이후 품질 문제로 사람 상담을 다시 늘렸다. 시작할 때는 빈도가 높고, 위험이 낮고, 규칙이 명확한 업무를 고른다.
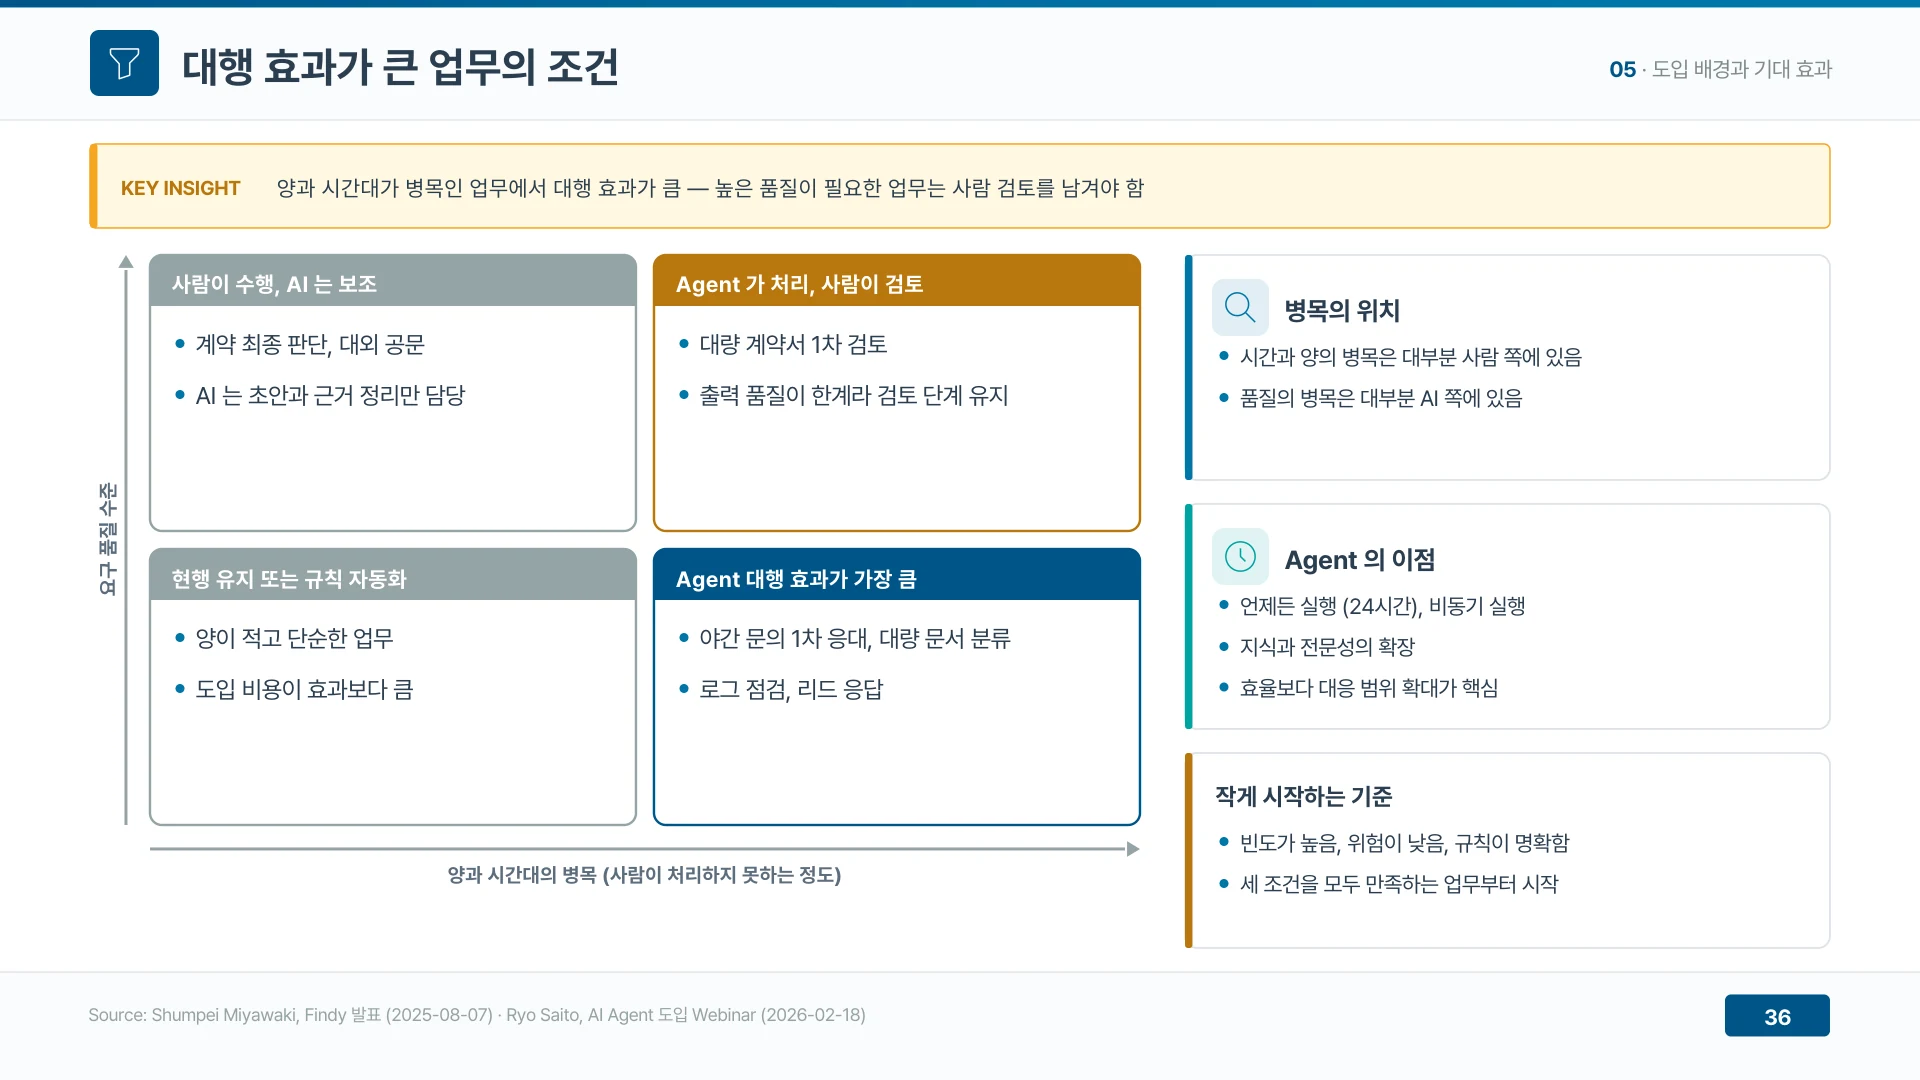
▲ 사람이 처리할 수 없는 양과 시간대의 업무에서 대행 효과가 가장 크다 (발표자료 36쪽)
도입은 업무 파악에서 시작해 네 단계를 반복한다
도입은 업무 파악, 업무 분해, 작은 시작, 평가와 개선 네 단계로 진행한다. 한 번으로 끝내지 않고 반복하는 것이 중요하다.
업무 분해에서 찾기, 판단하기, 실행하기는 AI가 맡고 최종 승인과 예외 판단은 사람이 맡는다. 한 단계는 한 줄로 설명되는 크기로 나누고 입출력을 정의한다. 맡길 업무가 모호한 채 시작하면 범위와 일정과 평가가 모두 흔들린다.
ROI에는 개발비 외에 토큰, 운영, 교육 비용을 넣는다. 에이전트는 반복 호출 때문에 단순 챗봇보다 토큰을 많이 쓰므로, 개발비만 계산하면 운영 단계에서 수지가 맞지 않는다.
기업 도입 관점에서 개념과 절차를 함께 정리한 글은 AI 에이전트, Agentic AI 개념부터 기업 도입까지다.
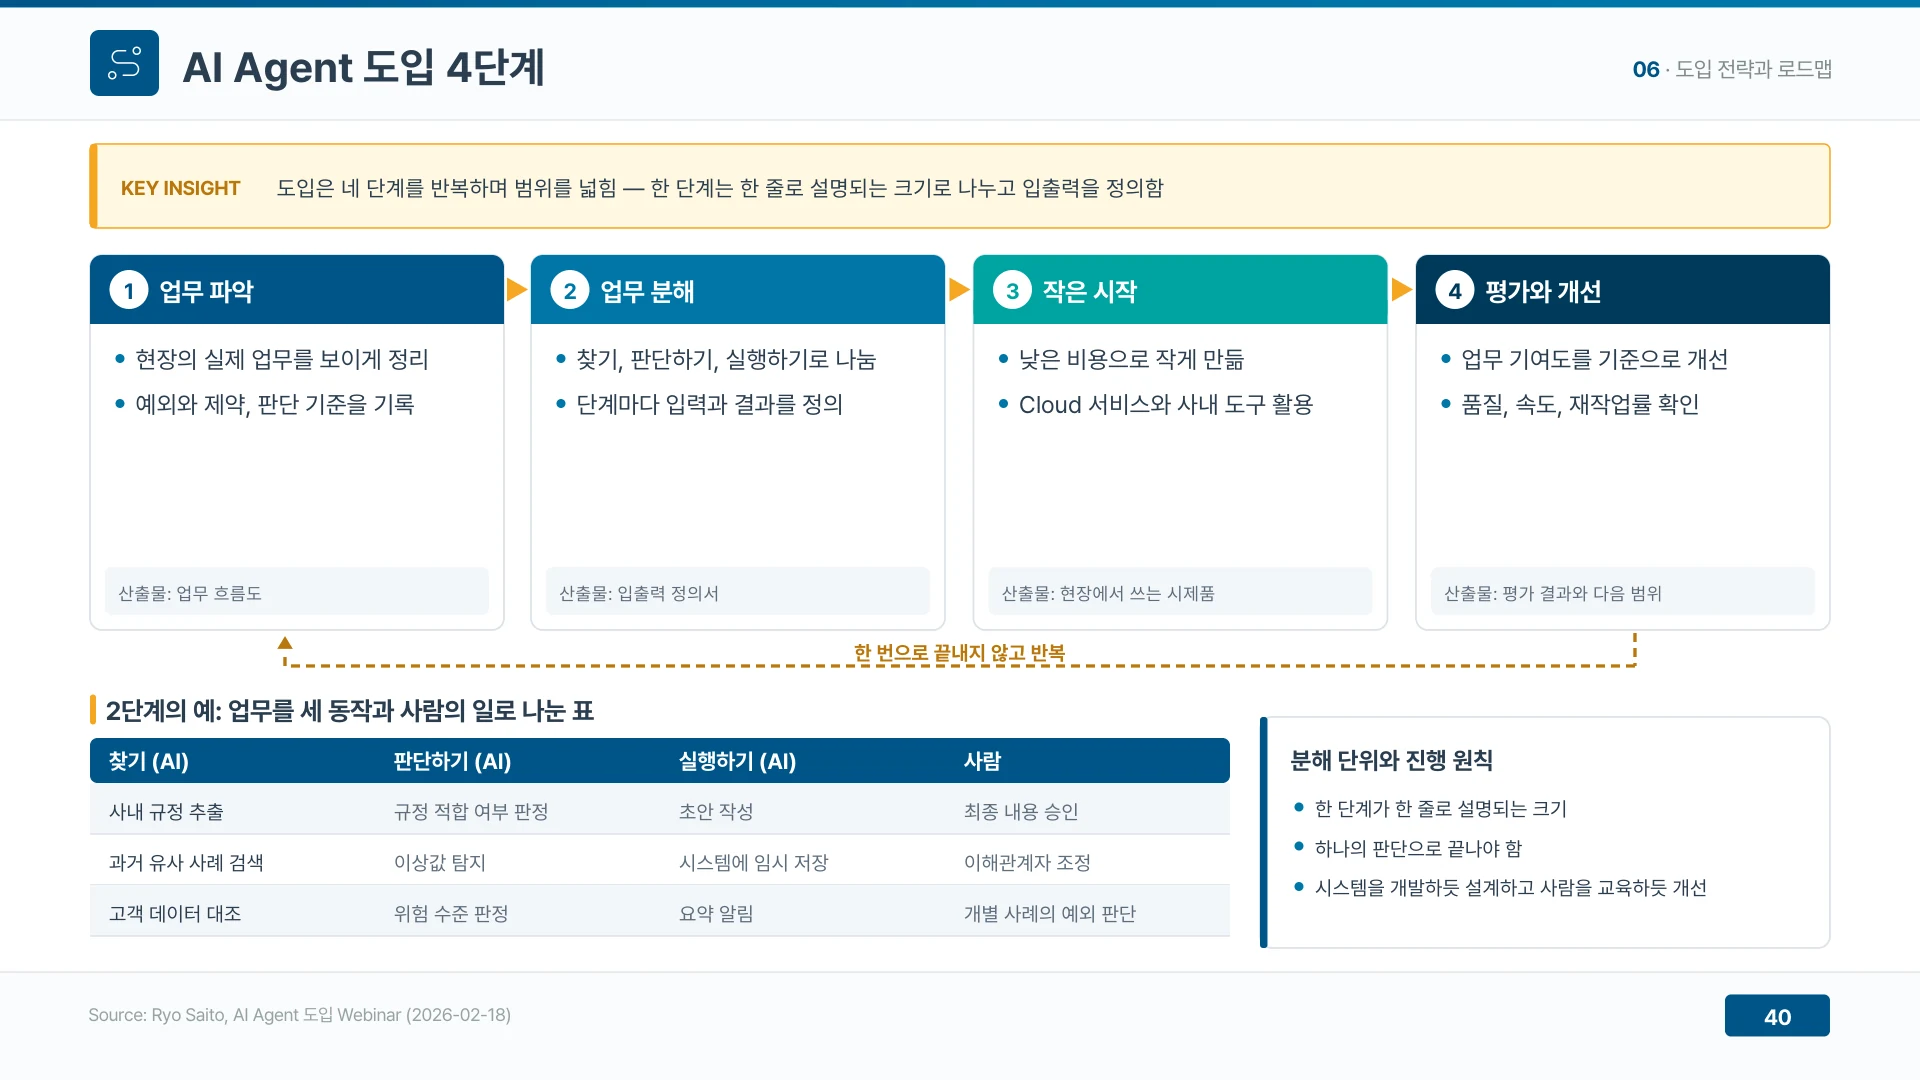
▲ 도입은 업무 파악, 업무 분해, 작은 시작, 평가와 개선 네 단계를 반복한다 (발표자료 40쪽)
사람에게 넘기는 시점을 수치로 정해야 책임이 비지 않는다
AI 직원은 사람과 같은 직무, 업무, 스킬 체계로 설계한다. 직무는 에이전트의 역할 정의에, 업무는 Agentic Workflow에, 스킬은 도구와 Agent Skills에 대응한다.
직무마다 사람은 판단과 관계와 전략을 맡고, 에이전트는 탐지와 분석과 초안 작성을 맡는다. 고객지원이라면 환불 한도를 넘거나 두 번 연속 해결하지 못할 때 사람에게 넘긴다. 넘길 때는 지금까지 한 일과 남은 판단을 함께 전달한다.
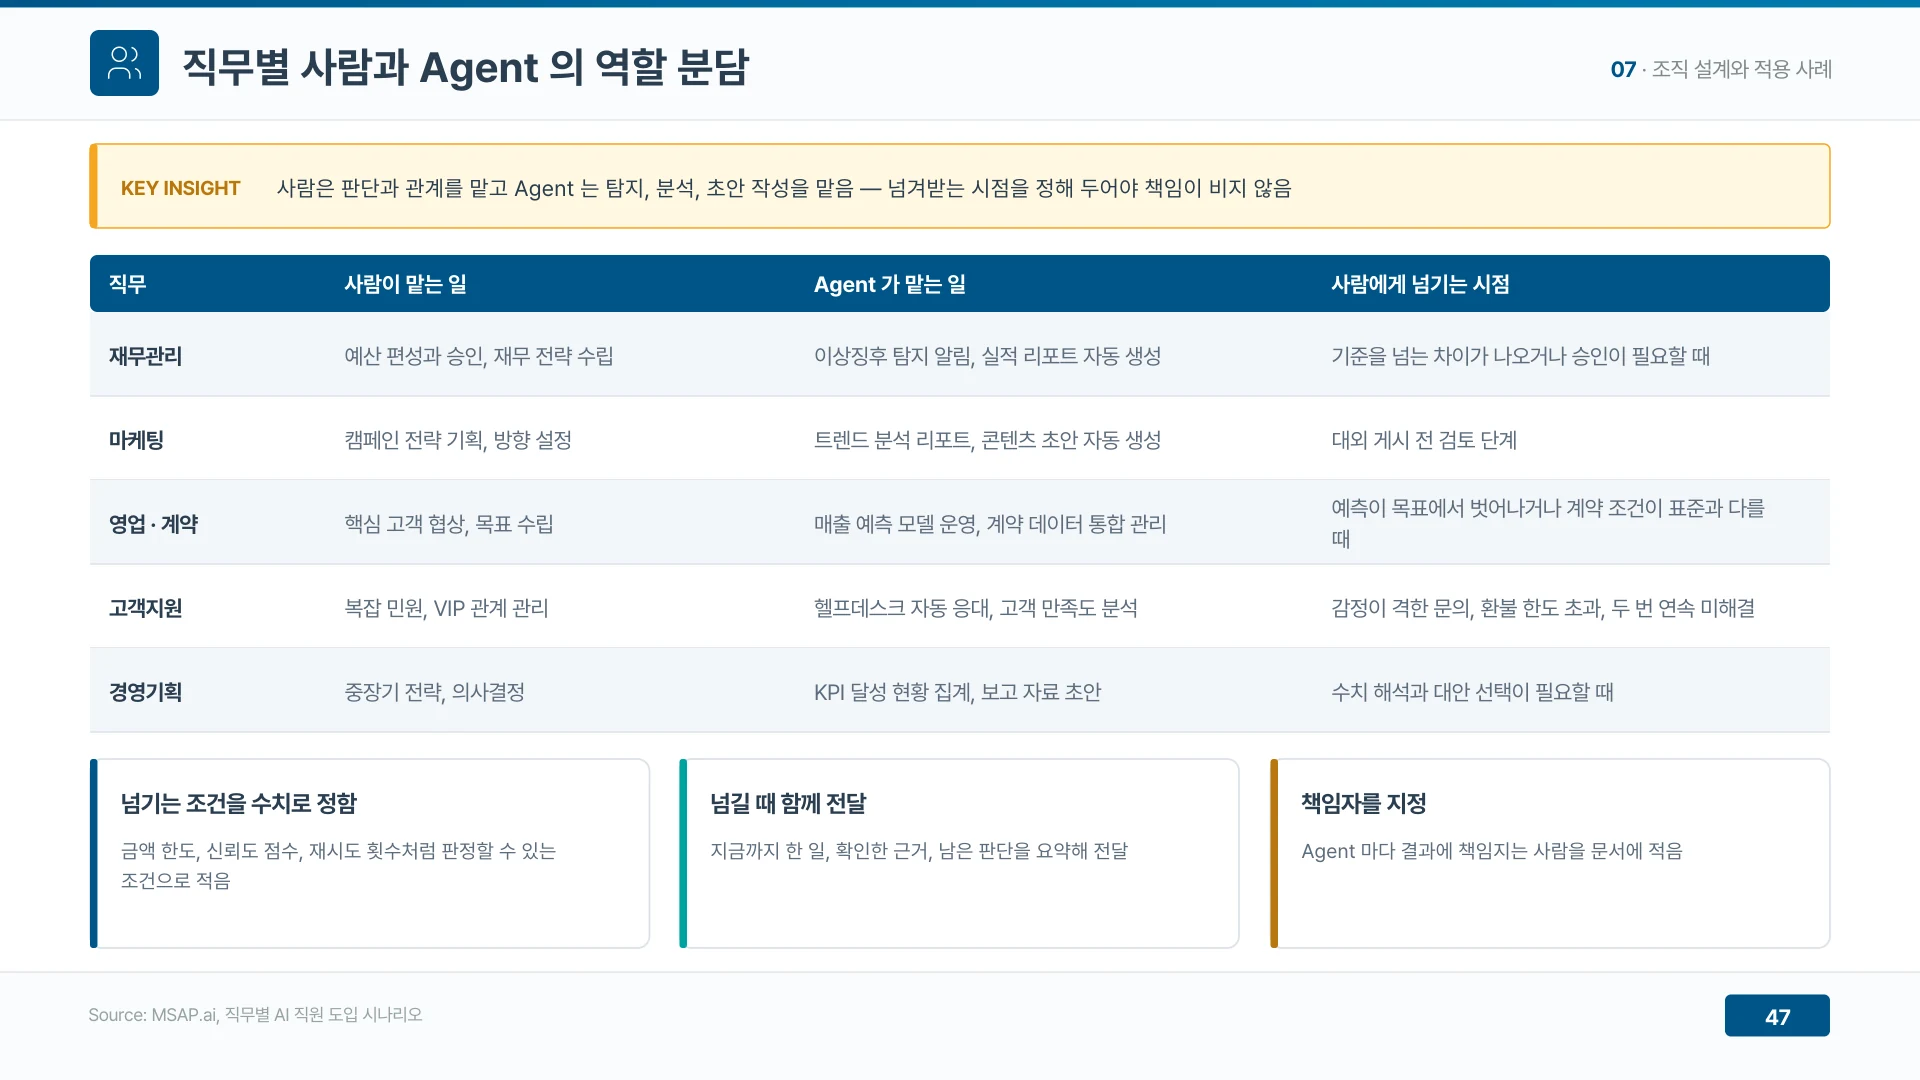
▲ 사람은 판단과 관계를 맡고 에이전트는 탐지, 분석, 초안 작성을 맡는다 (발표자료 47쪽)
코딩 에이전트에서 사람의 일은 지시에서 목표와 검토로 바뀐다
Agentic Coding에서는 사람이 목표를 전달하고 AI가 계획, 구현, 수정을 반복한다. 자동 완성과 채팅에서는 사람이 루프를 돌렸고, 에이전트에서는 모델이 루프를 돌린다.
코드를 검토하지 않는 좁은 뜻의 Vibe Coding은 시제품에만 맞다. 운영 코드는 사람이 검토해야 하고, AI가 쓴 코드의 책임은 승인한 사람에게 남는다. 그 편차를 줄이는 방법으로 Spec을 먼저 쓰는 SDD가 나왔다. 사람은 Spec을 승인하고 AI가 구현한다.
Spec에는 목적과 범위, 동작과 기술 요건, 검증 방법을 적는다. 검증 방법이 없으면 완료를 판정할 수 없으므로 인수 조건이 테스트와 연결되어야 한다.
에이전트형 코딩 도구는 저장소를 분석해 여러 파일 수정과 테스트 실행까지 이어서 처리한다. 개발자의 시간은 코드 작성보다 요구사항 정리와 결과 검증에 더 쓰인다.
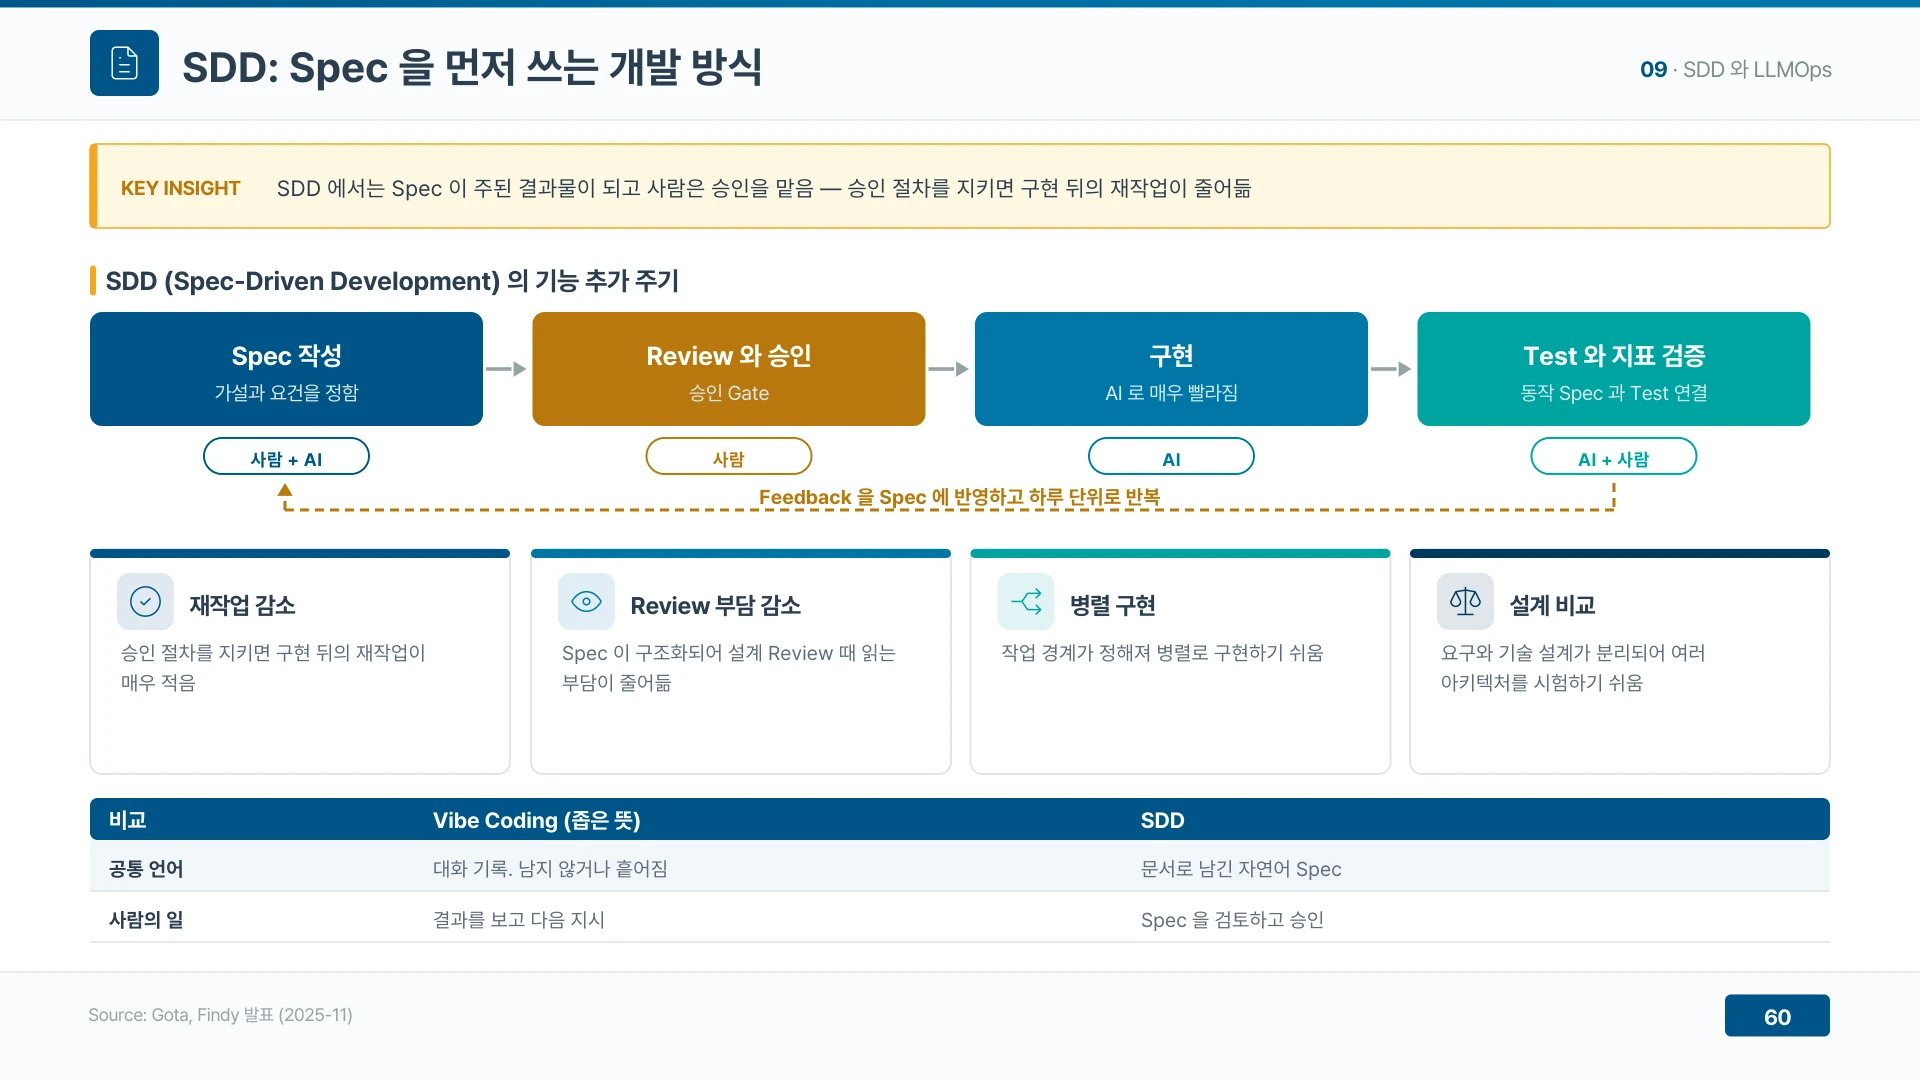
▲ SDD에서는 Spec이 주된 결과물이 되고 사람은 승인을, AI는 구현을 맡는다 (발표자료 60쪽)
LLMOps는 관측이 먼저 갖춰져야 평가와 개선이 가능하다
LLMOps는 모델을 다시 학습하지 않고 프롬프트와 Workflow와 Context를 바꿔 개선한다. 데이터 수집과 학습을 거치는 MLOps보다 주기가 짧다.
순서가 중요하다. 관측 없이 프롬프트만 고치면 나아졌는지 알 수 없다. 에이전트는 결과만 보면 어느 단계에서 틀렸는지 알 수 없으므로, 도구 호출 인자와 결과, 반복 횟수, 단계별 토큰을 Trace로 남긴다.
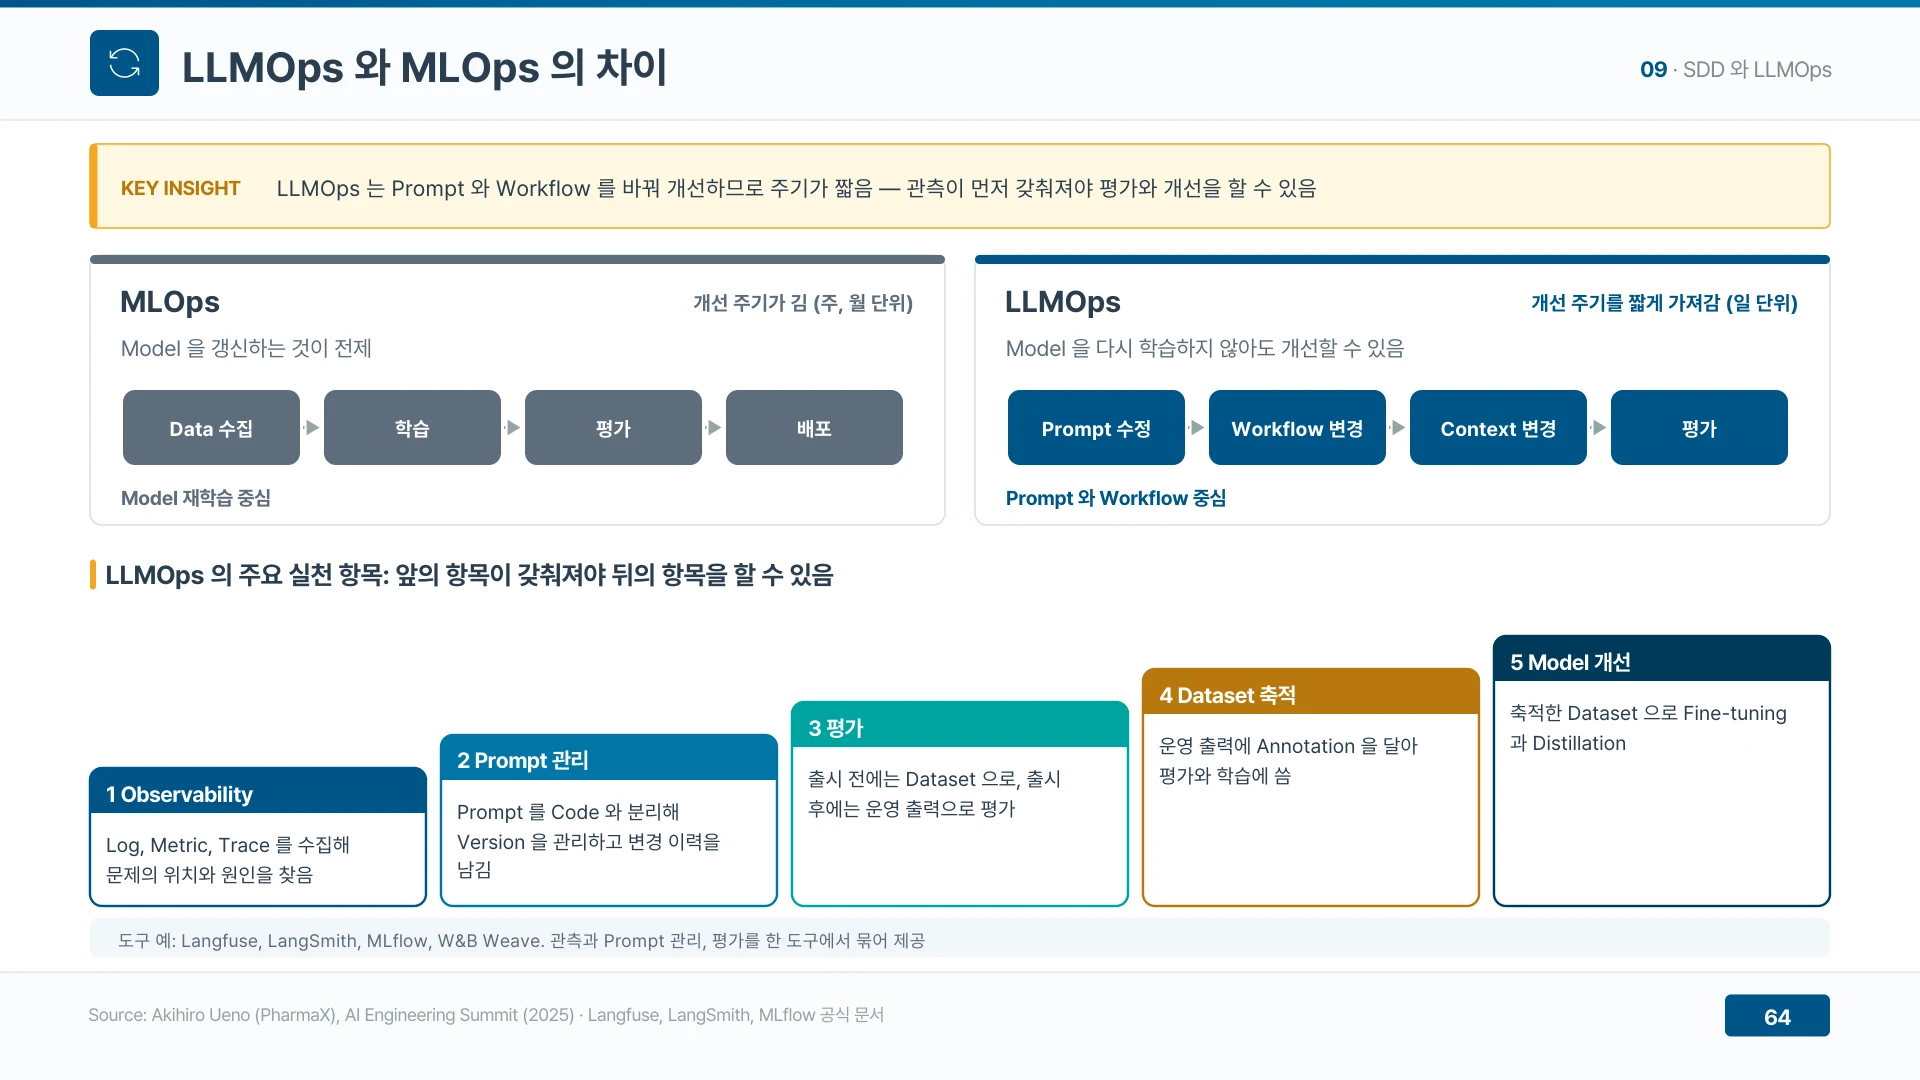
▲ LLMOps는 관측을 먼저 갖춰야 평가와 개선이 가능하다 (발표자료 64쪽)
프롬프트 지시는 보장 수단이 아니고 실행 환경이 막아야 한다
Agentic AI는 답변을 넘어 실제 조작을 실행한다. 사고가 나면 정보 유출에 더해 시스템 변경까지 일어난다. 기억 오염, 간접 Prompt Injection, 과도한 권한 같은 기존 위험도 에이전트에서 커진다. 읽은 내용이 곧 행동으로 이어지기 때문이다.
OWASP는 2025년 12월 Agentic 애플리케이션 Top 10을 공개했고, 상위 두 항목은 목표 탈취와 도구 오용이다. 프롬프트로 금지를 지시하거나 모델이 리뷰하게 해도 확률적이라 방지를 보장하지 못한다. 도달 범위와 도구와 자원 상한은 설정 파일로 선언하고, 시작 전에 검증하고, 실행 중에 목록 밖 통신을 차단한다.
OWASP Gen AI Security Project는 이 목록과 함께 에이전트 위협 모델링 가이드와 개발 단계 통제 문서도 공개한다. 자율성 범위와 권한 경계를 정하기 전에 위협 모델링을 적용하면 통제를 둘 자리가 드러난다.
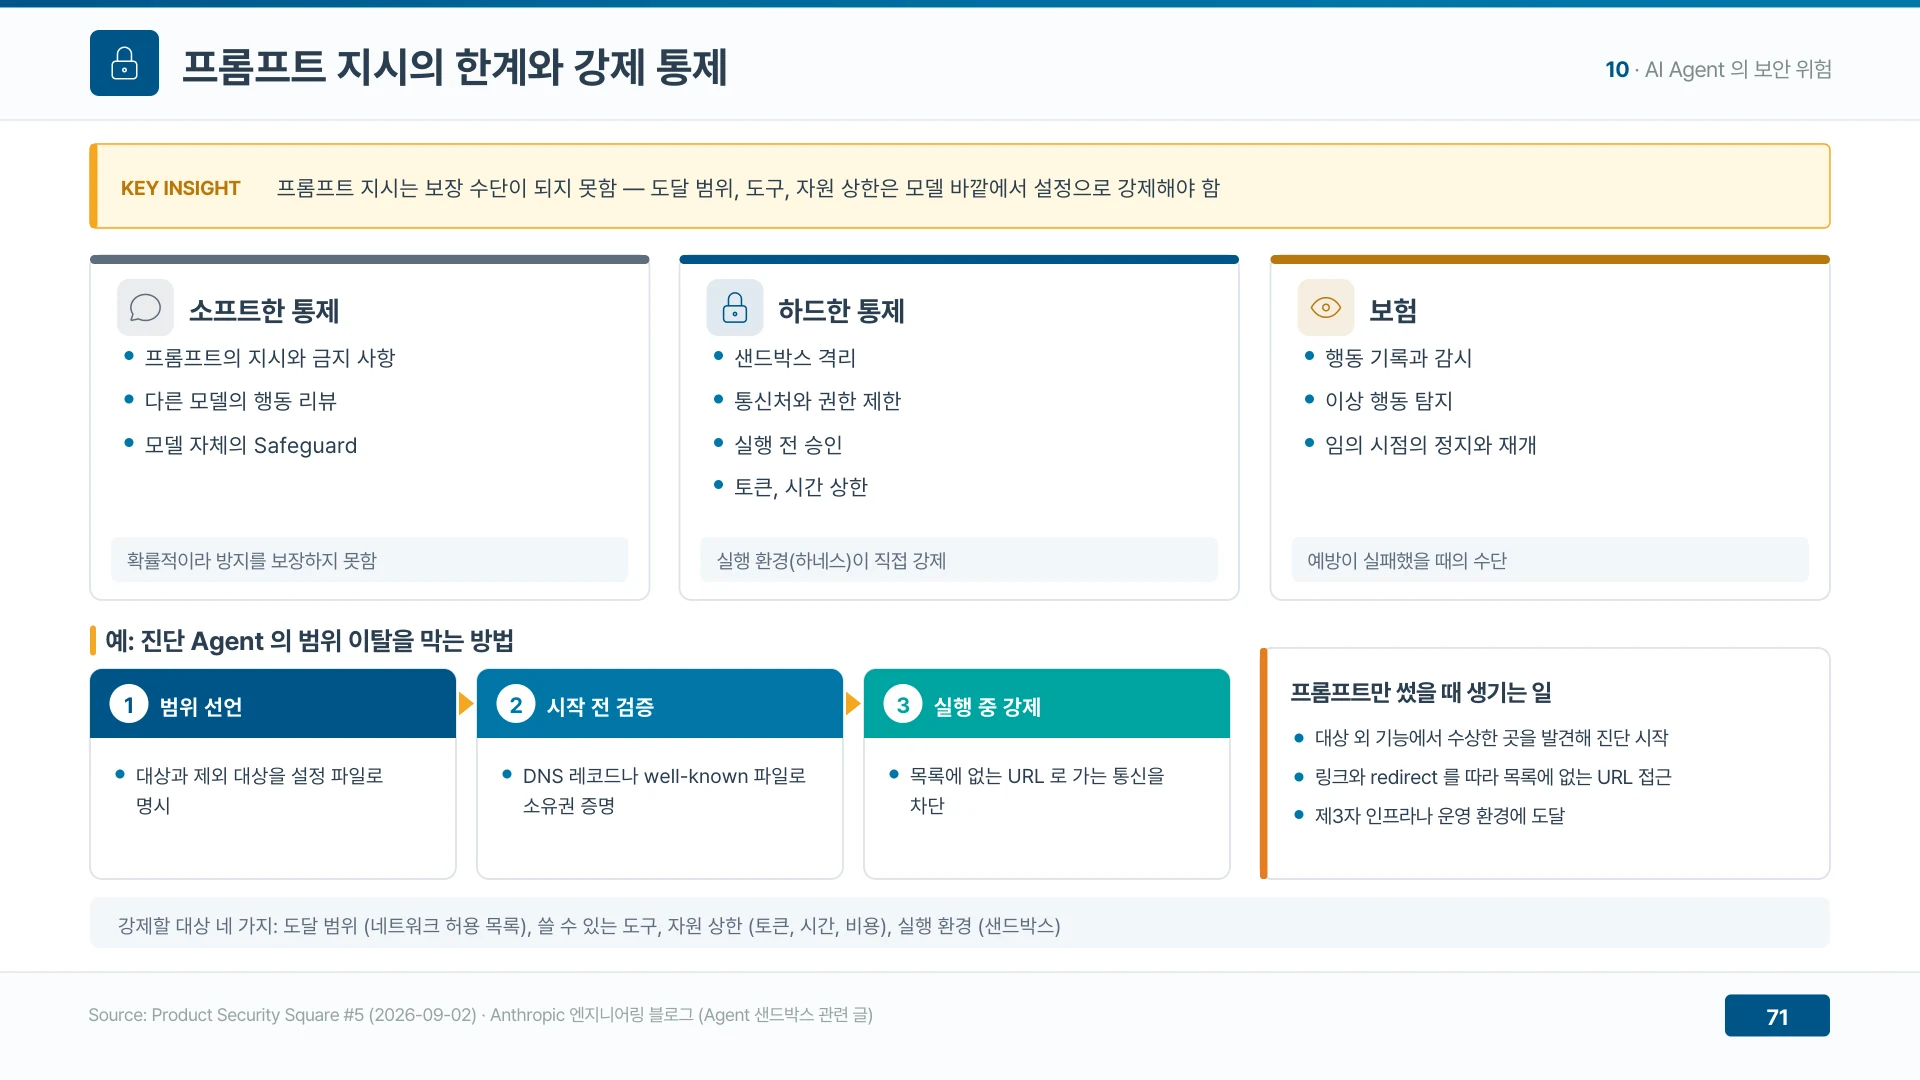
▲ 프롬프트 지시는 보장 수단이 아니고 실행 환경이 범위와 권한을 막아야 한다 (발표자료 71쪽)
되돌릴 수 없는 행동은 백엔드가 사람 승인을 강제한다
가드레일은 입력과 출력 양쪽에서 주제, 금지어, 민감 정보, 유해 내용, 근거를 검사한다. 규칙으로 확인할 수 있는 것은 규칙으로 검사하고 의미 판단만 LLM에 맡긴다. 에이전트는 파일과 데이터베이스를 스스로 읽으므로 도구 실행 결과도 LLM에 넘기기 전에 검사한다.
결제, 삭제, 운영 환경 변경처럼 영향이 크거나 되돌릴 수 없는 행동은 사람 승인이 필수다. 승인 대상인지는 에이전트가 정하지 않고 백엔드 로직이 판정한다. 요청이 너무 많으면 사람이 읽지 않고 승인하는 승인 피로가 생기므로 대상을 좁힌다.
승인 대상을 정할 때는 요청 빈도도 본다. 승인이 형식이 되면 OWASP가 사람과 에이전트 사이 신뢰 악용으로 분류한 위험이 열린다.
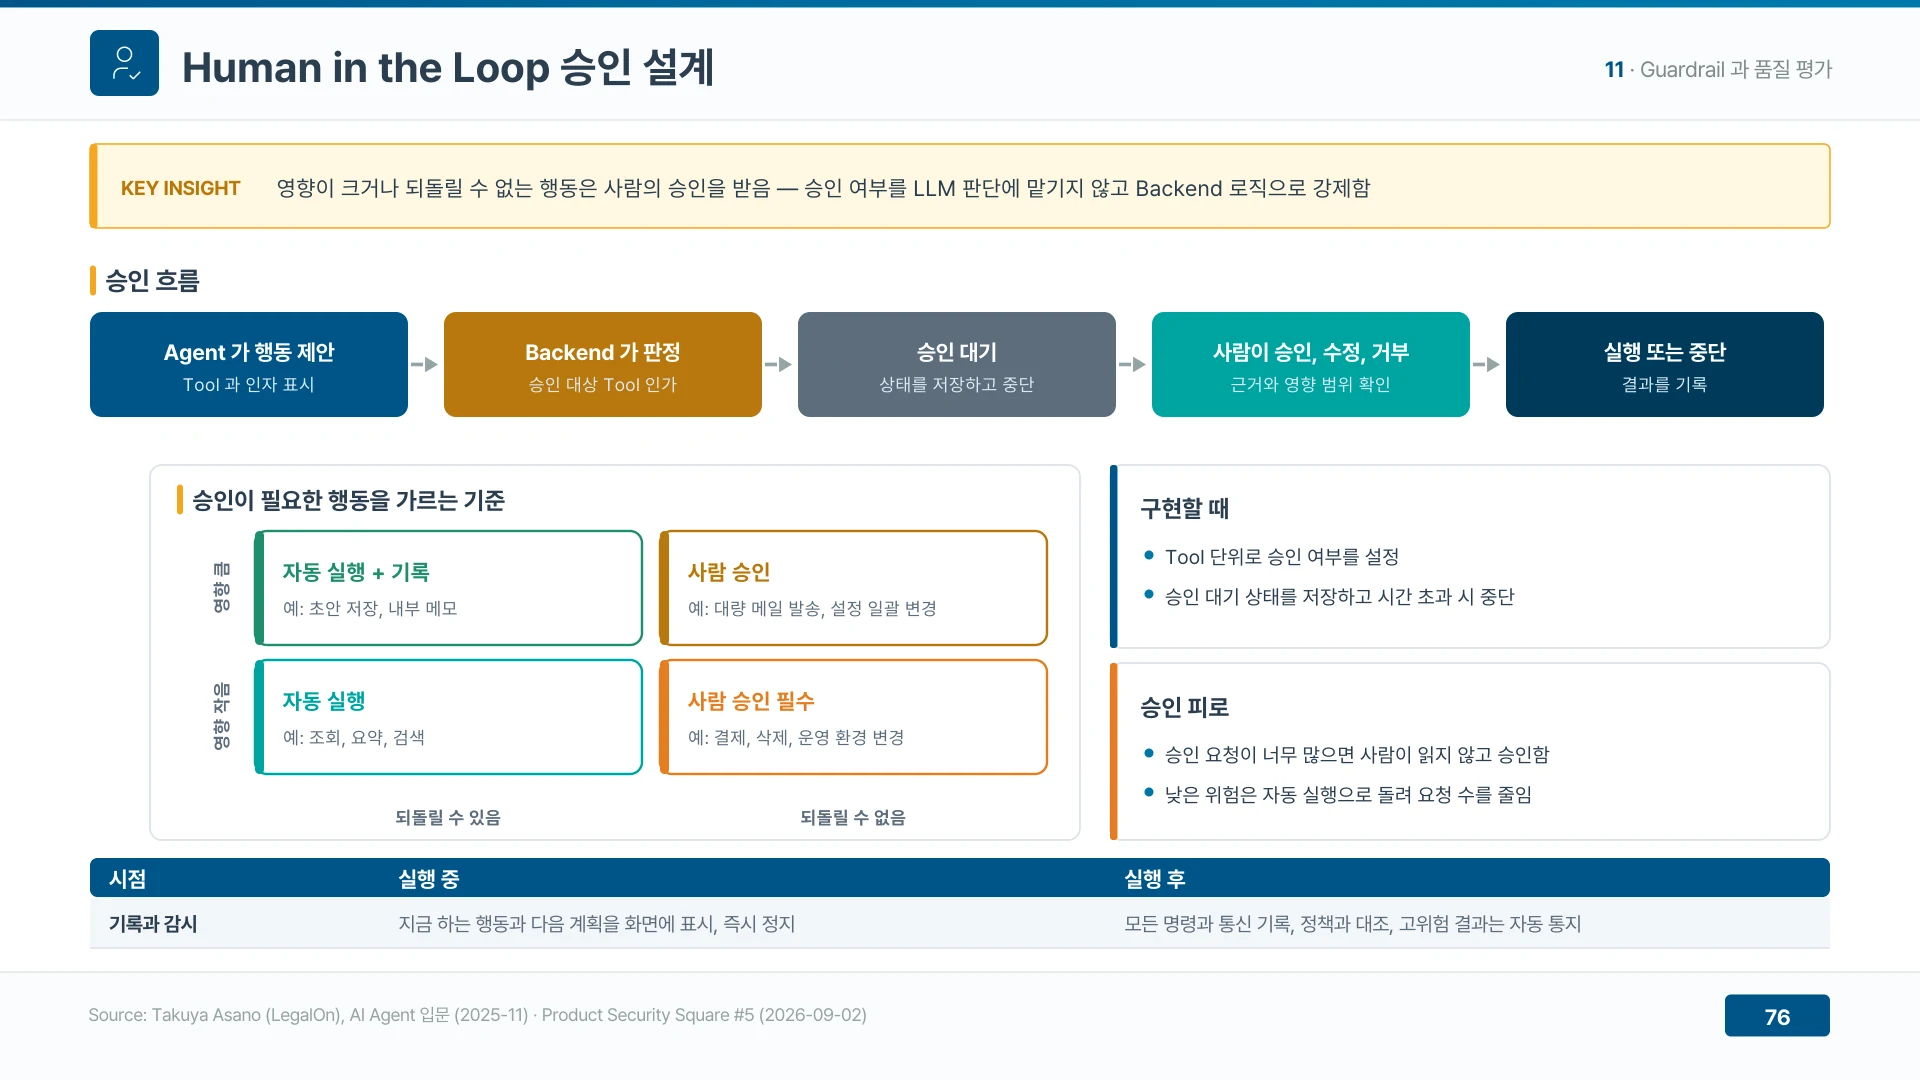
▲ 영향이 크거나 되돌릴 수 없는 행동은 백엔드가 사람 승인을 강제한다 (발표자료 76쪽)
LLM 게이트웨이는 모든 모델 호출을 한 경로로 모은다
기밀 데이터와 비용 상한 때문에 클라우드 LLM을 쓸 수 없는 업무가 있다. 그런 업무에만 로컬 LLM을 두고 나머지는 클라우드를 그대로 쓰는 편이 현실적이다. 4bit 양자화 기준으로 GPU 메모리는 10억 파라미터당 약 0.6~0.7GB가 들고, 24GB GPU 한 장이면 20B~32B급까지 올릴 수 있다. 이 수치는 가중치 기준 어림셈이다.
데이터를 밖으로 보낼 수 없는 공공기관의 기준은 공공기관 AI, 왜 온프레미스여야 하는가에서 함께 볼 수 있다.
모델이 여러 개가 되면 LLM 게이트웨이가 접근을 한 곳에서 통제한다. 업무 앱과 에이전트는 게이트웨이 주소 하나만 호출하고, Virtual Key로 사용자와 팀별 키를 발급해 예산을 건다. 누가 얼마나 썼는지를 키와 팀 단위로 추적할 수 있다.
라우팅의 첫 기준은 데이터 민감도다. 로컬 모델에 장애가 났을 때 폴백이 클라우드로 가면 민감 데이터가 외부로 전송되므로, 민감 경로는 로컬 모델끼리만 폴백한다.
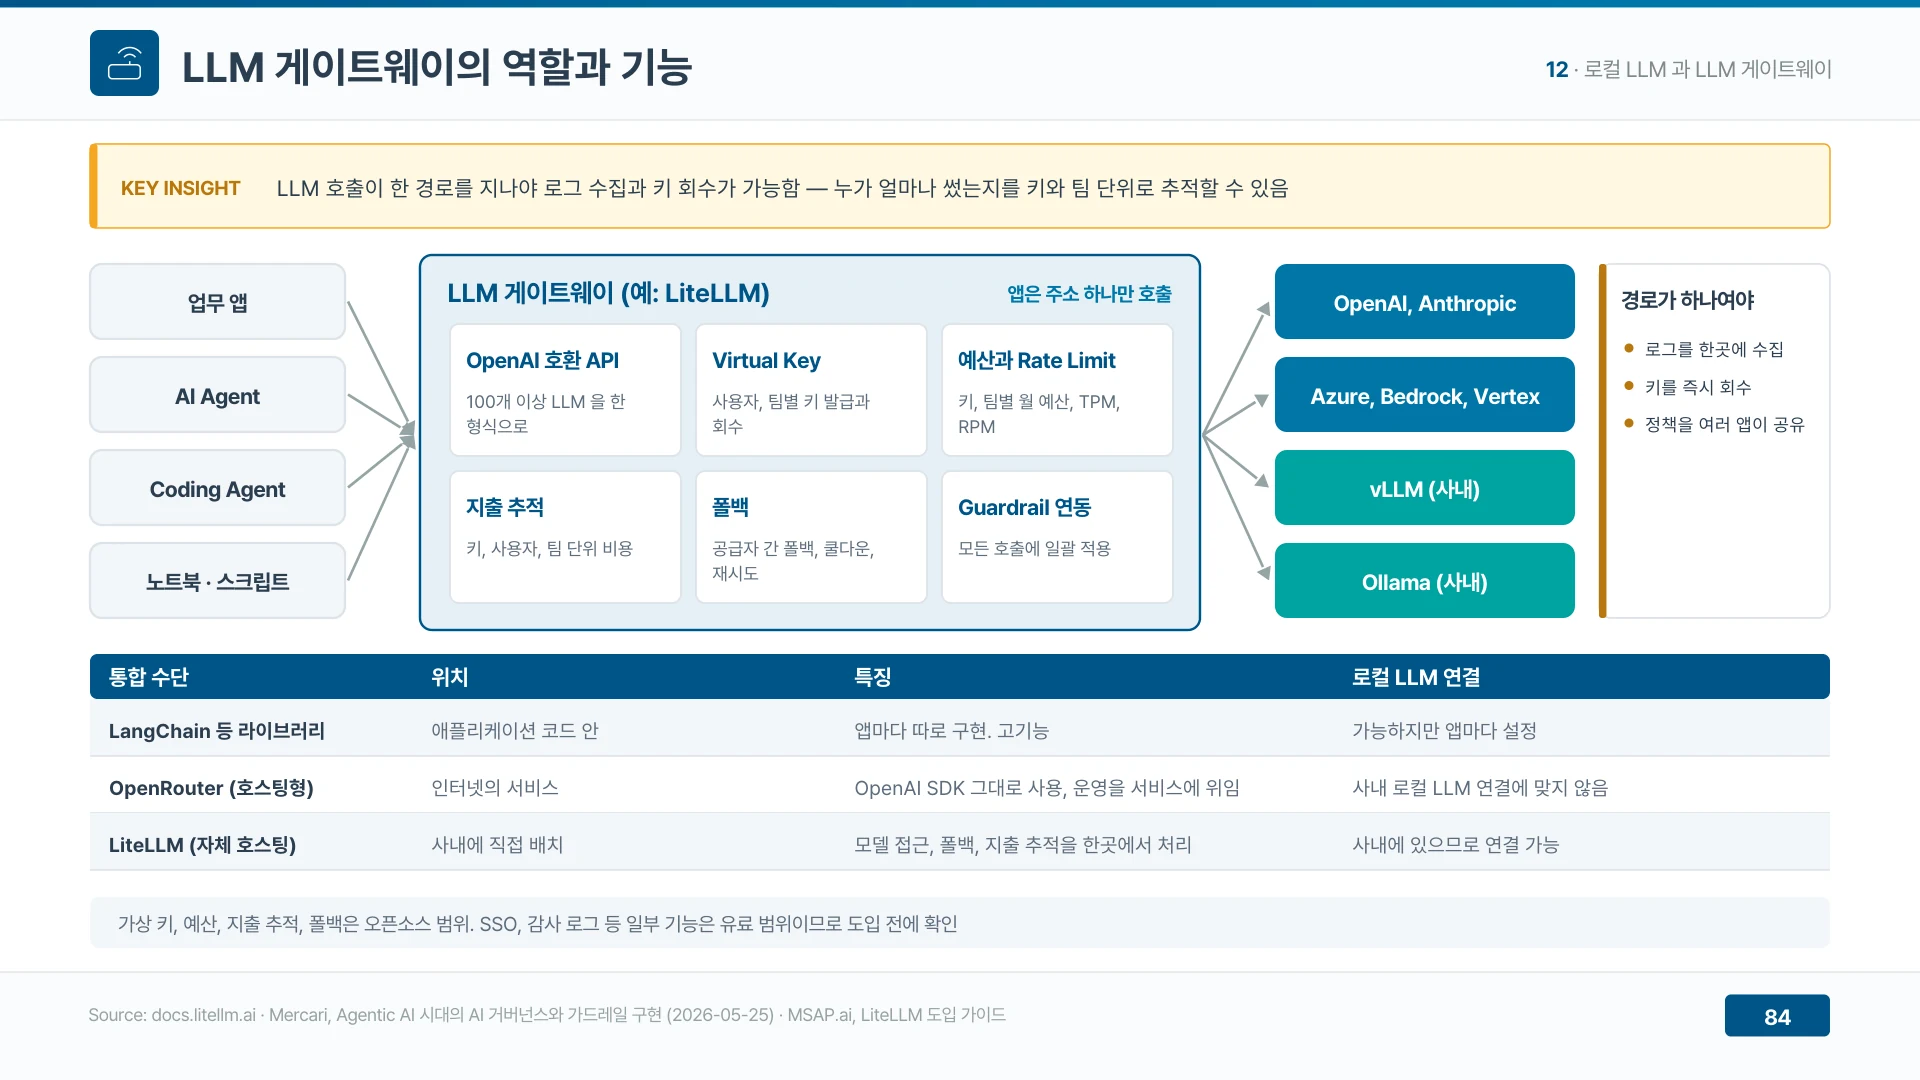
▲ LLM 게이트웨이는 모든 모델 호출을 한 경로로 모아 키와 예산을 관리한다 (발표자료 84쪽)
핵심 정리
AI 에이전트 도입의 원칙은 세 가지다. 단순하게 시작하고, 업무를 좁게 정하고, 모델 바깥에서 통제한다. 열두 파트가 모두 이 세 문장으로 수렴한다. 자율 수준과 복잡도는 업무의 위험과 측정 결과가 허용하는 만큼만 올리고, 통제는 프롬프트가 아니라 권한과 가드레일과 백엔드 승인으로 강제한다.
검토를 시작한다면 다음 순서를 권한다.
- 빈도가 높고 위험이 낮고 규칙이 명확한 과제 하나를 골라야 한다.
- 그 업무를 찾기, 판단하기, 실행하기로 분해하고 사람에게 넘기는 조건을 수치로 정해야 한다.
- 단일 에이전트와 API 직접 호출로 PoC를 진행해야 한다.
- Trace와 평가 지표를 붙여 단계별 실패를 관측해야 한다.
- 도구 권한, 가드레일, 사람 승인을 설정으로 강제한 뒤 범위를 넓혀야 한다.
자주 묻는 질문
AI 에이전트는 챗봇이나 RPA와 무엇이 다른가
챗봇은 질문에 한 번 답하고 끝나고, AI 에이전트는 목표를 받아 계획과 도구 호출과 결과 확인을 반복해 업무를 끝까지 처리한다. RPA는 정해진 절차를 따르고 에이전트는 목표에 따라 절차를 정한다. 절차를 순서도로 그릴 수 있으면 RPA가 먼저다.
업무마다 자율 수준은 어떻게 정하는가
업무의 위험과 되돌릴 수 있는 정도로 정한다. 피해가 크거나 되돌릴 수 없는 업무는 사람이 감독하는 반자율 이하에서 시작한다. 모든 업무에 완전 자율이 맞는 것은 아니다.
Workflow와 에이전트는 언제 나눠 쓰는가
경로를 미리 알 수 있는 정형 업무는 Workflow가, 경로를 미리 알 수 없는 업무는 에이전트가 맞다. 실무에서는 둘을 결합한다.
멀티 에이전트는 언제 필요한가
Context가 길어지고 도구가 많아져 에이전트 하나의 정확도가 떨어질 때다. 멀티 에이전트는 일반 대화의 약 15배 토큰을 쓰므로 단일 에이전트로 시작하고, 나누기 전에 Skill 추가로 해결되는지 먼저 확인한다.
에이전트 도입은 어떤 순서로 진행하는가
업무 파악, 업무 분해, 작은 시작, 평가와 개선 네 단계를 반복한다. 맡길 업무를 글로 정리해 공유하는 일이 먼저다.
에이전트의 보안 위험은 무엇이 다르고 어떻게 막는가
에이전트는 읽은 내용을 지시로 받아들여 실제 조작을 실행할 수 있다. OWASP Agentic Top 10의 상위 두 항목도 목표 탈취와 도구 오용이다. 프롬프트 지시로는 보장되지 않으므로 권한 최소화, 가드레일, 백엔드가 강제하는 사람 승인으로 막는다.
로컬 LLM과 LLM 게이트웨이는 언제 필요한가
데이터를 밖으로 보낼 수 없거나 종량 과금의 상한이 보이지 않는 업무에는 로컬 LLM을 둔다. 모델이 여러 개가 되면 게이트웨이로 호출 경로를 하나로 모아 키와 예산을 관리하고, 민감 경로는 로컬 모델끼리만 폴백한다.
참고 리소스
MSAP.ai 자료
- AI 에이전트란 무엇인가 — 정의, 구조, 기업 도입 기준
- Agentic AI(에이전틱 AI)란 무엇인가 — 생성형 AI의 다음 단계
- AI 에이전트와 챗봇의 차이 — 5가지 기준 비교
- 생성형 AI 진화 4단계 — LLM에서 Agentic까지
- 멀티 에이전트 시스템 설계 — 협업 패턴과 도입 전 알아야 할 실패 모드
- AX 추진 전략과 로드맵 — 진단부터 전사 확산까지
- AX vs DX — 디지털 전환과 AI 전환, 무엇이 다른가
- AI 에이전트 필수 기능 여덟 가지, 도입 전 점검 기준
- AI 에이전트를 위한 LLM 게이트웨이 — LiteLLM 도입 가이드
- LiteLLM 제품 소개 — LLM 게이트웨이 기능과 도입 순서
외부 공개 자료