발표자료 다운로드 — LLM 호출 경로를 한 지점으로 모으는 설계
LLM 게이트웨이의 원리는 하나다. 모든 요청이 한 지점을 반드시 지나게 만들면 그 지점에서 측정하고 통제하고 기록할 수 있다. LiteLLM Proxy는 그 지점을 OpenAI 호환 엔드포인트 하나로 구현한다.
전체 102장, PDF로 102쪽이다. 앞쪽은 호출 경로가 흩어졌을 때의 문제와 LiteLLM의 개념, Proxy의 핵심 기능을 다룬다. 가운데는 설치와 요건 평가, 로컬 모델 연결, 공개된 도입 사례 네 건과 실제 구성 진단을 다룬다. 뒤쪽은 모니터링과 2026년 보안 사고, 쿠버네티스 배포, 도입 판단 기준과 실행 순서를 정리한다.
제품의 장점만 적지 않았다. Enterprise 버전의 경계, 사례 조직이 직접 밝힌 한계, 올해의 침해 사고와 취약점도 같은 비중으로 담았다.
사내 검토 자료나 팀 스터디 자료로 바로 쓸 수 있도록 원본 구성 그대로 PDF로 공개한다.
MSAP.ai 백서 구독하기🔔
새로운 백서 소식을 가장 먼저 만나보세요!
MSAP.ai 가 전하는 AI 기반 운영 인사이트와 최신 백서 소식을 가장 빠르게 받아보실 수 있습니다.
구독해 주시면 더 좋은 콘텐츠로 보답하겠습니다.🙏
발표 영상 — AI 에이전트 재생목록에서 이어 보기
이 발표자료는 영상 14편으로 나눠 설명하도록 구성했다. 편마다 간지 한 장과 본문 네 장에서 여덟 장으로 이루어지고, 한 편이 질문 하나에 답한다.
아래 재생목록은 클라우드네이티브TV의 AI 에이전트와 AX 영상 모음이다.
발표자료의 14편은 다음 순서로 이어진다.
| 편 | 주제 | 다루는 내용 |
|---|---|---|
| 1~2 | 문제 정의 | 흩어진 호출 경로, 벤더 AI 통합 뒤에 남는 과제 |
| 3~4 | 개념과 기능 | OpenAI 호환 API, 별칭, Virtual Key, 예산, 라우팅, 가드레일, 캐싱 |
| 5~7 | 설치와 평가 | SDK와 Proxy 선택, 요건 여덟 개, 대안 비교, 로컬 모델 혼합 구성 |
| 8~10 | 사례와 진단 | 도입 사례 네 건, Docker 기반 Proxy 구성 진단, 요청 흐름 |
| 11~12 | 운영 | Prometheus 지표와 TTFT, 공급망 사고와 점검 항목 |
| 13~14 | 배포와 판단 | Helm 배포, Redis 이중화, 도입 판단 기준과 실행 순서 |
에이전트의 구조와 도입 기준을 먼저 정리하려면 AI 에이전트란 무엇인가를 함께 보면 된다.
이 발표자료가 답하는 일곱 가지 질문
LLM 게이트웨이 도입 회의에서 반복해서 나오는 질문을 기준으로 슬라이드를 배치했다.
- LiteLLM은 무엇이고 무엇을 표준화하는가
- LLM 게이트웨이는 API 게이트웨이와 무엇이 다른가
- SDK와 Proxy 가운데 무엇을 골라야 하는가
- Virtual Key와 예산을 쓰려면 무엇이 필요한가
- 폴백은 어떤 장애에서 동작하지 않는가
- 2026년 공급망 사고 뒤에 무엇을 점검해야 하는가
- 도입은 어떤 순서로 진행해야 하는가
호출 경로가 흩어지면 키와 비용부터 관리가 안 된다
LLM을 부르는 클라이언트를 구분하지 못하면 키 회수와 비용 집계와 모델 교체가 모두 막힌다. 클라이언트는 에이전트 루프, 에이전트 밖 보조 스크립트, 독립 서비스 세 형태로 나뉘고, 형태마다 키가 놓이는 위치와 관리 담당이 다르다.
MSAP.ai가 조사한 한 사례 구성에서는 사흘 동안 Chat Completions 요청 약 2,500건이 모두 같은 마스터 키로 도착했다. 어느 에이전트가 몇 건을 보냈는지 가려낼 수 없었고, 프록시를 우회한 직접 호출 3건은 모두 스크립트와 서비스 쪽에서 나왔다. 그래서 도입 검토는 제품 비교보다 호출 경로 조사표에서 시작하는 편이 맞다.
통제 지점을 따로 두지 않은 조직은 세 가지 비용을 되풀이해 치른다. 애플리케이션마다 흩어진 연동 코드를 유지보수하는 비용, 어느 팀이 얼마나 썼는지 모르는 상태에서 나는 예산 사고, 키와 접근 권한이 분산돼 감사가 불가능해지는 위험이다.
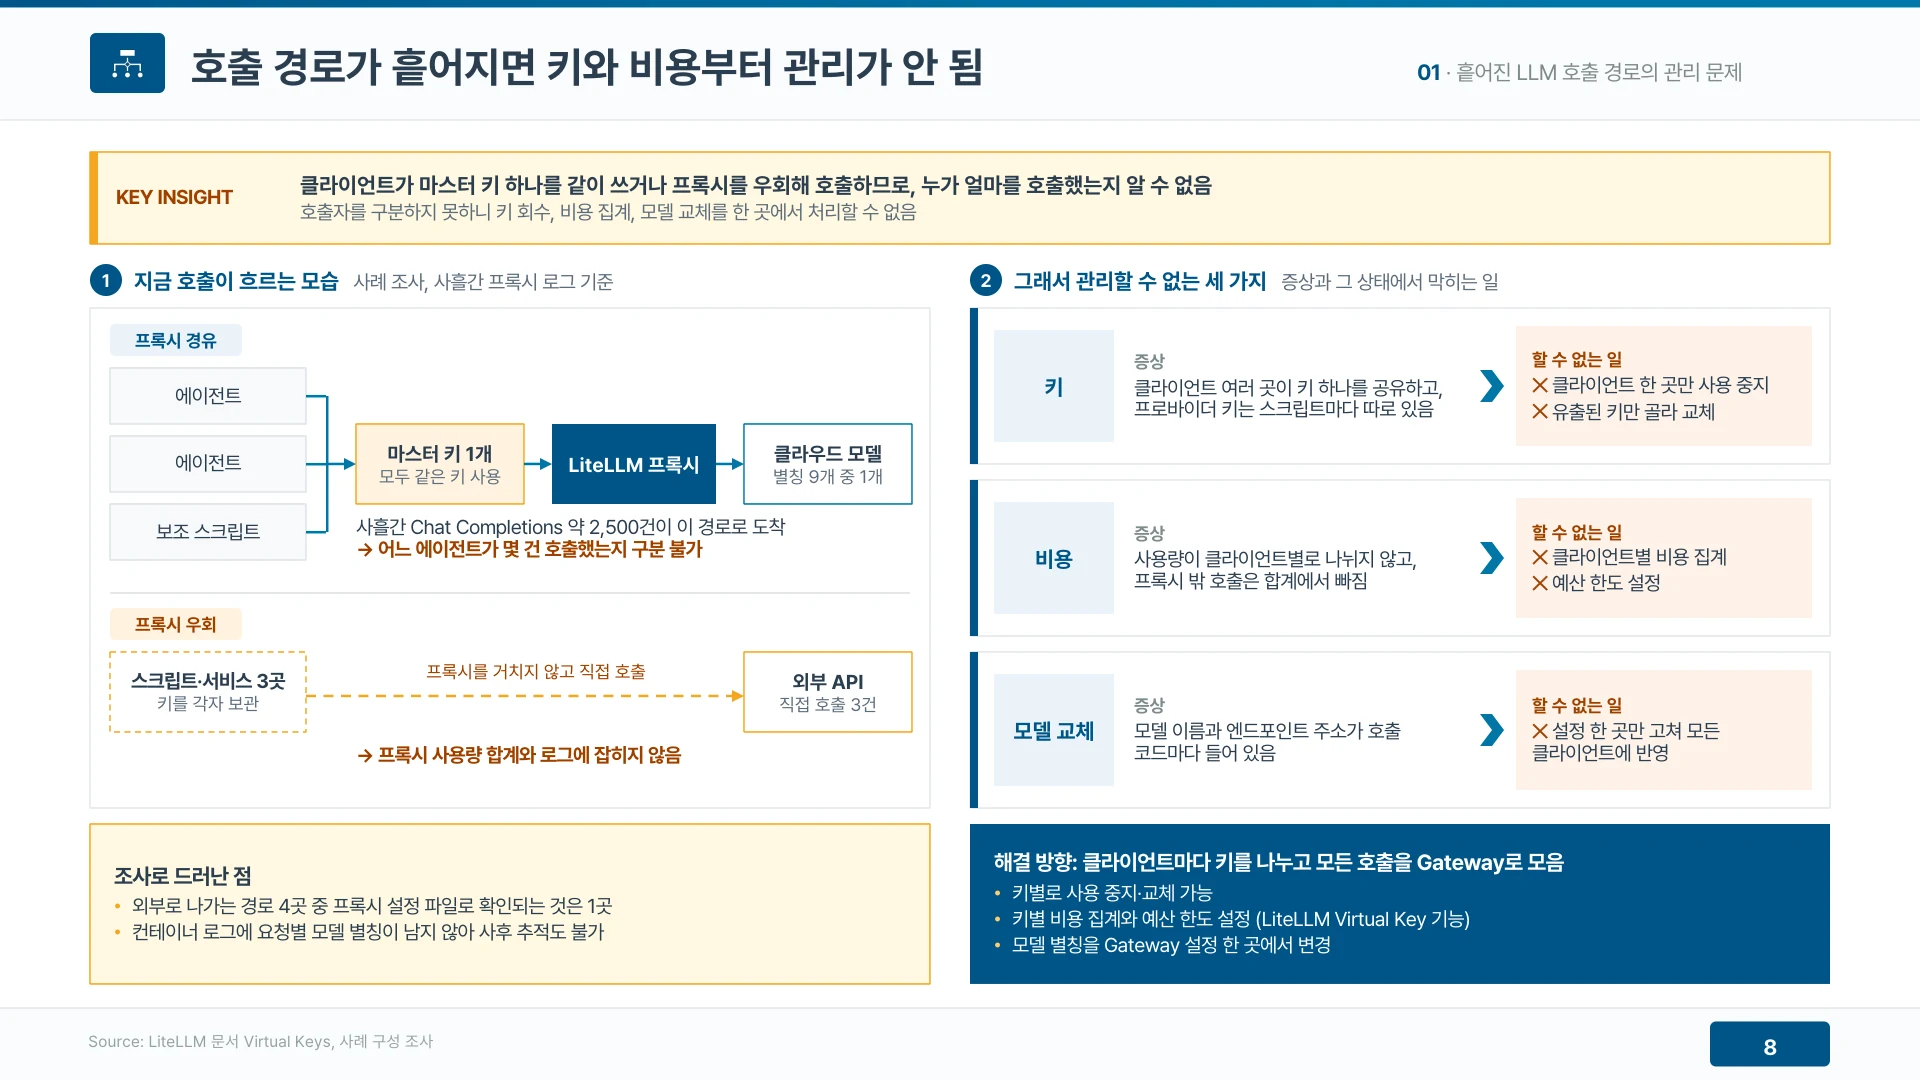
▲ 마스터 키 하나를 같이 쓰면 누가 얼마를 호출했는지 구분할 수 없다 (발표자료 8쪽)
벤더 AI로 모아도 과제 네 가지가 남는다
Amazon Bedrock이나 Azure OpenAI Service로 모으면 데이터 학습 이용 문제는 상당 부분 풀린다. 하지만 누가 어떤 모델을 얼마나 쓰는지는 여전히 조직이 관리해야 한다.
남는 과제는 네 가지다. 사용자별 비용을 추적하기 어렵고, 전원에게 클라우드 권한을 발급해야 하며, 모델을 나눠 열 수단이 없고, 프로바이더마다 API 형식이 다르다. primeNumber의 SRE 책임자는 2025년 7월 발표에서 악의 없이 많이 쓴 것만으로 요금이 급증하는 상황을 가장 걱정했다고 밝혔다.
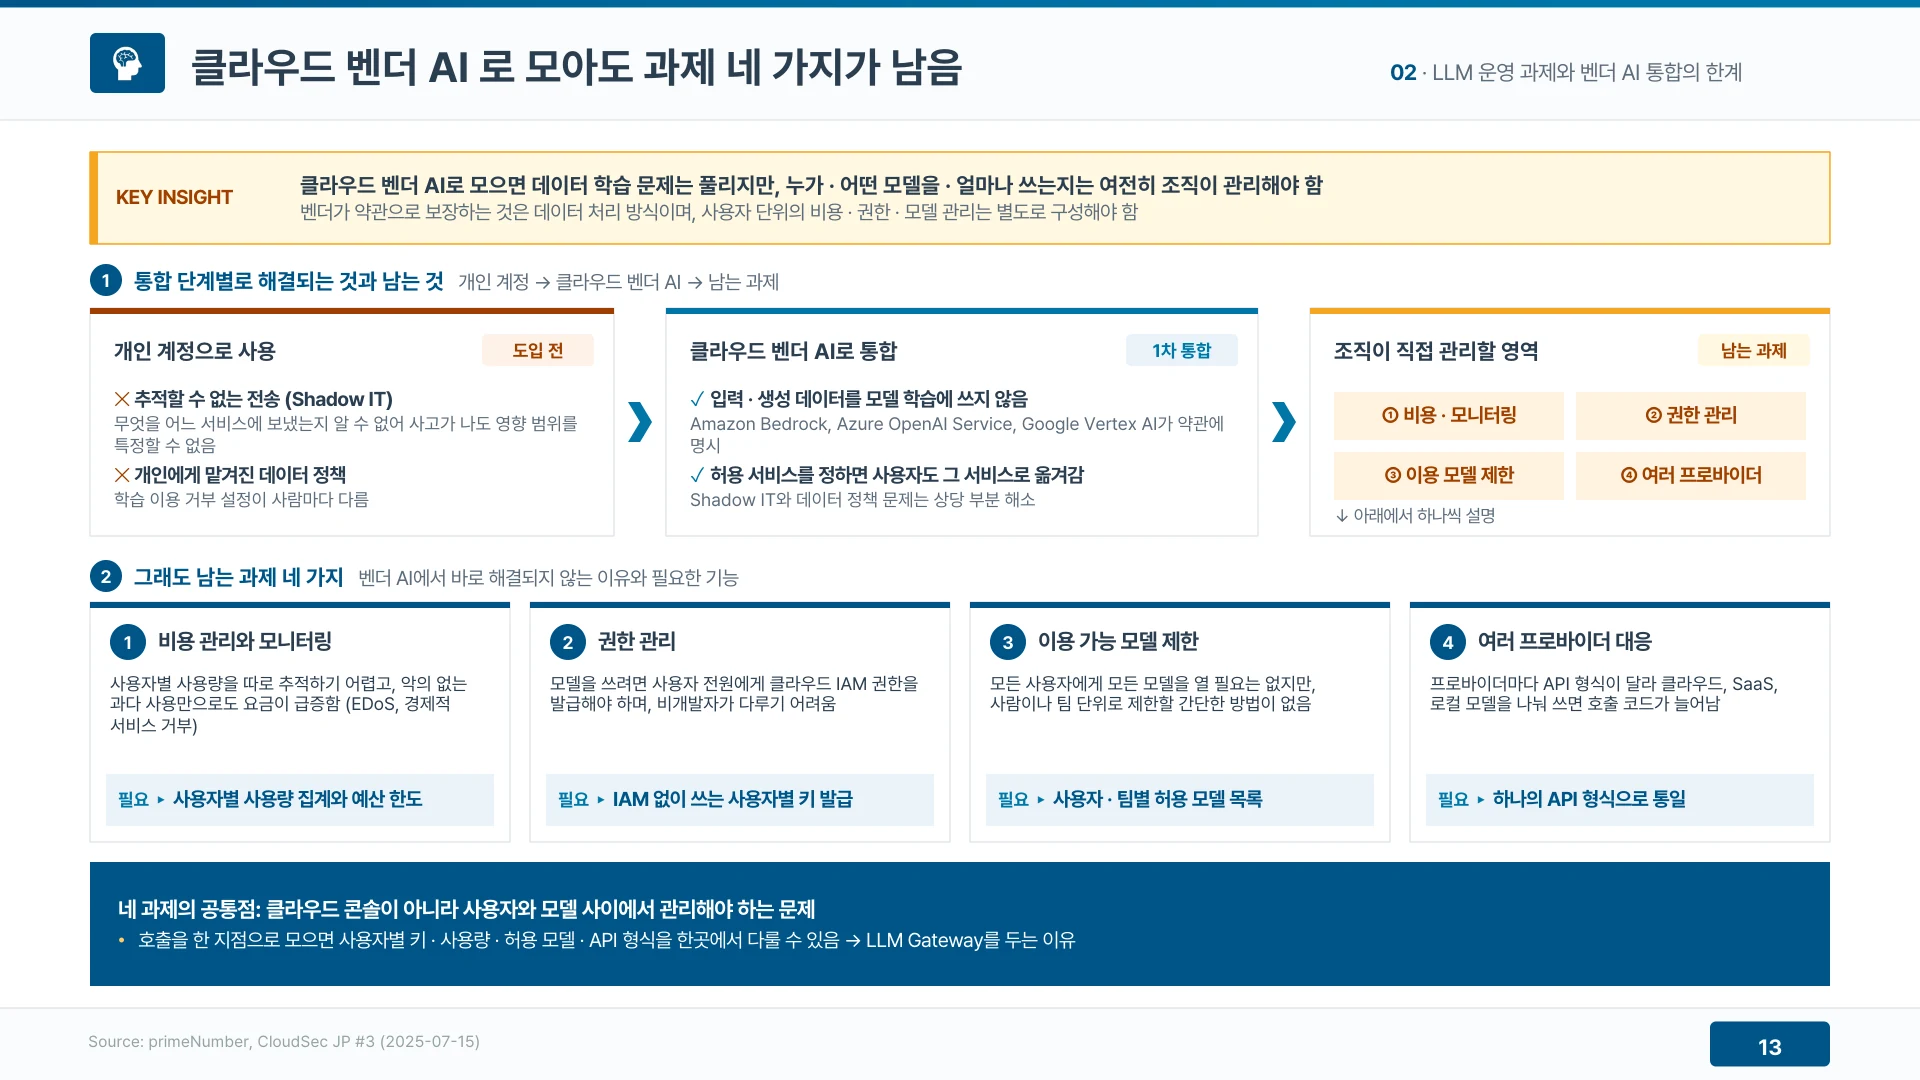
▲ 벤더 AI로 모아도 비용, 권한, 모델 제한, 여러 프로바이더 대응은 조직에 남는다 (발표자료 13쪽)
LLM 게이트웨이는 요청 수가 아니라 토큰과 예산으로 제어한다
API 게이트웨이와 LLM 게이트웨이는 인증과 로깅과 부하 분산이 같고, 제어 단위가 다르다. LLM 요금은 호출 건수가 아니라 토큰으로 정해지므로 요청 수만 세는 게이트웨이로는 비용 상한을 둘 수 없다.
| 구분 | API 게이트웨이 | LLM 게이트웨이 |
|---|---|---|
| 제한 기준 | 요청 수 | 토큰 수와 예산 금액 |
| 라우팅 기준 | URL 경로 | 모델 이름 |
| 장애 대응 | 재시도와 차단 | 다른 모델로 폴백 |
| 공통 기능 | 인증, 로깅, 부하 분산 | 인증, 로깅, 부하 분산 |
게이트웨이를 거치면 키는 앱마다 흩어진 저장에서 중앙 발급과 회수로, 예산은 사후 청구서에서 사전 한도로 바뀐다. 이 구조의 기본 개념은 AI 에이전트를 위한 LLM 게이트웨이에서 먼저 다뤘다.
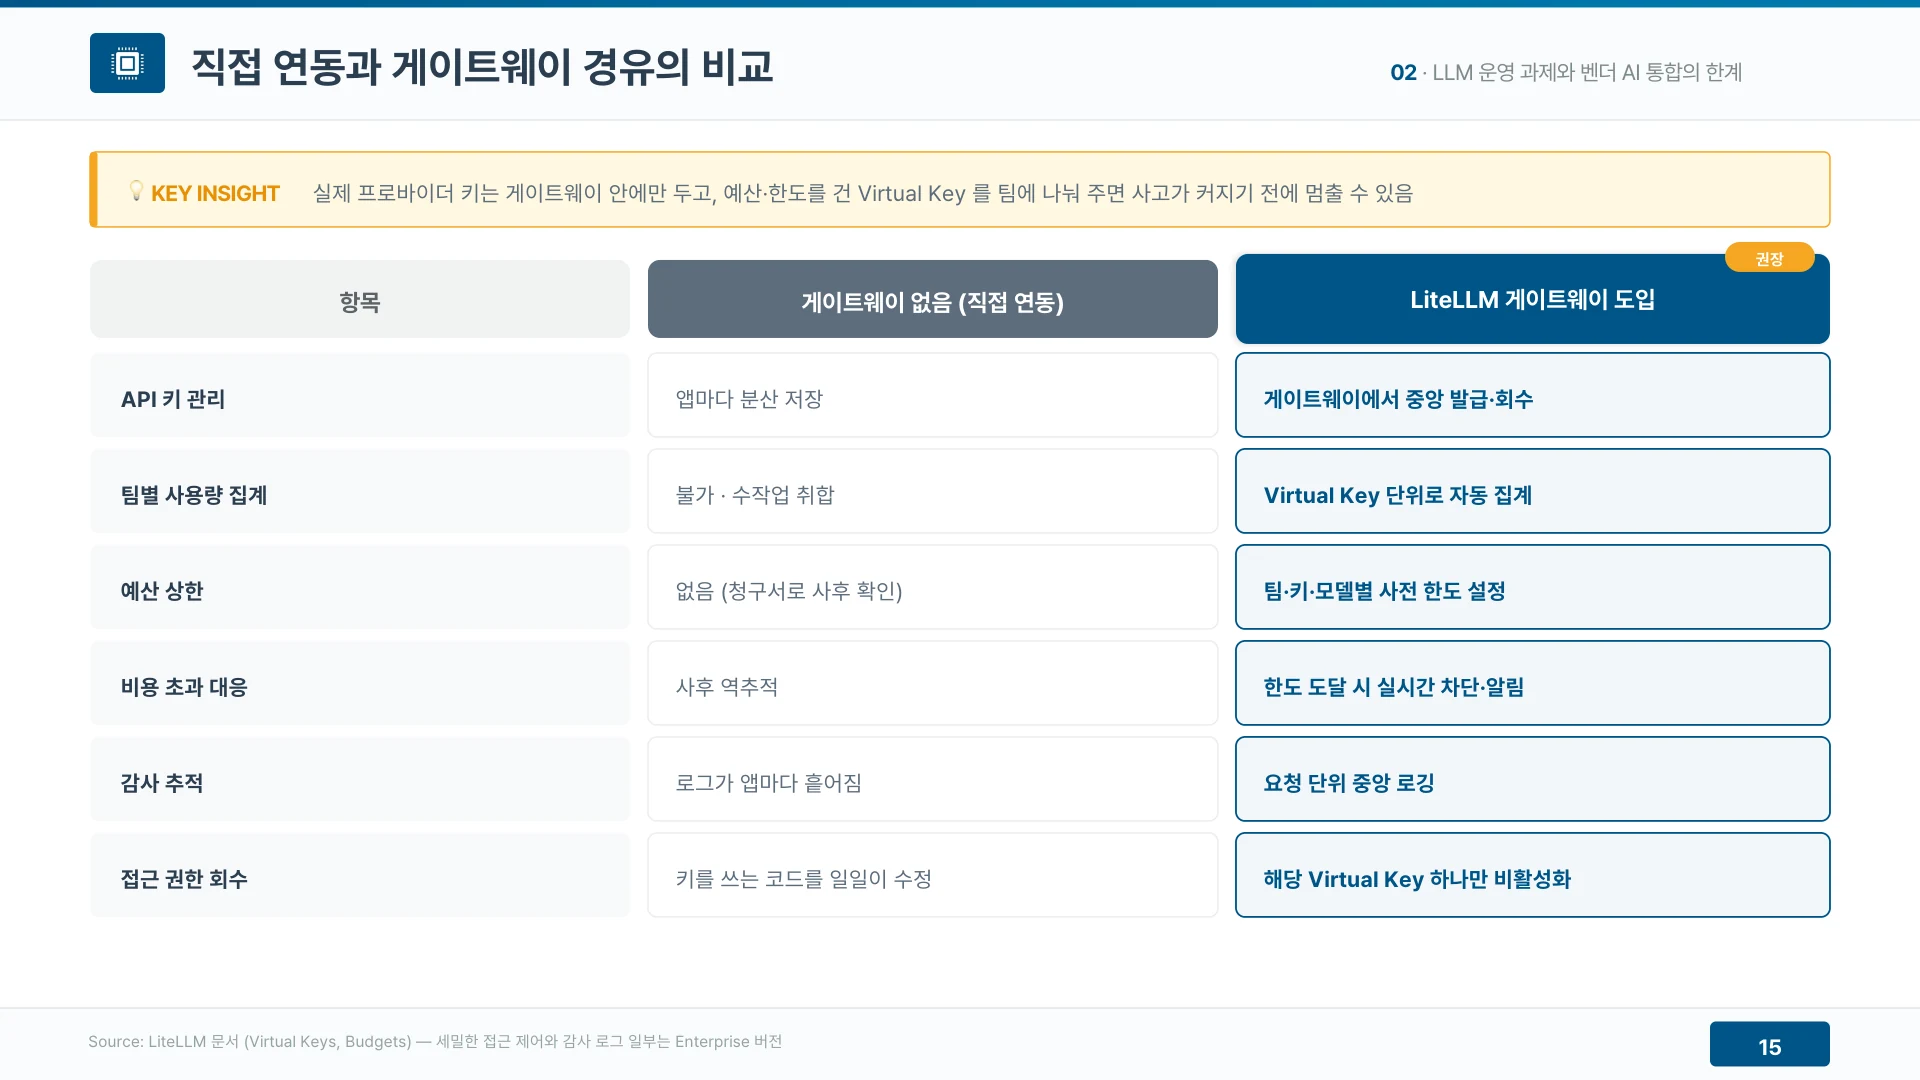
▲ 모든 요청이 한 지점을 지나면 그 자리에서 측정하고 통제하고 기록한다 (발표자료 15쪽)
LiteLLM은 성능 도구가 아니라 표준화 계층이다
LiteLLM은 프로바이더마다 다른 인증 헤더와 파라미터 이름과 응답 스키마를 OpenAI 형식 하나로 맞춰 주는 변환 계층이다. 호출 코드는 그대로 두고 model 값만 바꾸면 다른 모델을 부른다.
LiteLLM 공식 문서와 GitHub 저장소 기준으로 지원 프로바이더는 138종이고 저장소 스타는 6만 개를 넘는다. 형태는 둘이다. SDK는 애플리케이션 안에 들어가는 라이브러리이고 Proxy는 여러 팀이 한 주소로 접속하는 게이트웨이 서버다. LiteLLM이라는 이름이 나오면 둘 가운데 어느 쪽인지부터 구분해야 한다.
한 가지 오해는 먼저 바로잡아야 한다. LiteLLM은 추론 자체를 빠르게 만들지 않는다. 토큰을 실제로 생성하는 추론 가속은 vLLM 같은 추론 엔진의 역할이고, LiteLLM은 그 앞에서 요청을 표준화하고 분배한다. 그래서 두 제품은 경쟁 관계가 아니라 클라이언트, 게이트웨이, 추론 엔진 순서로 놓이는 조합이다.
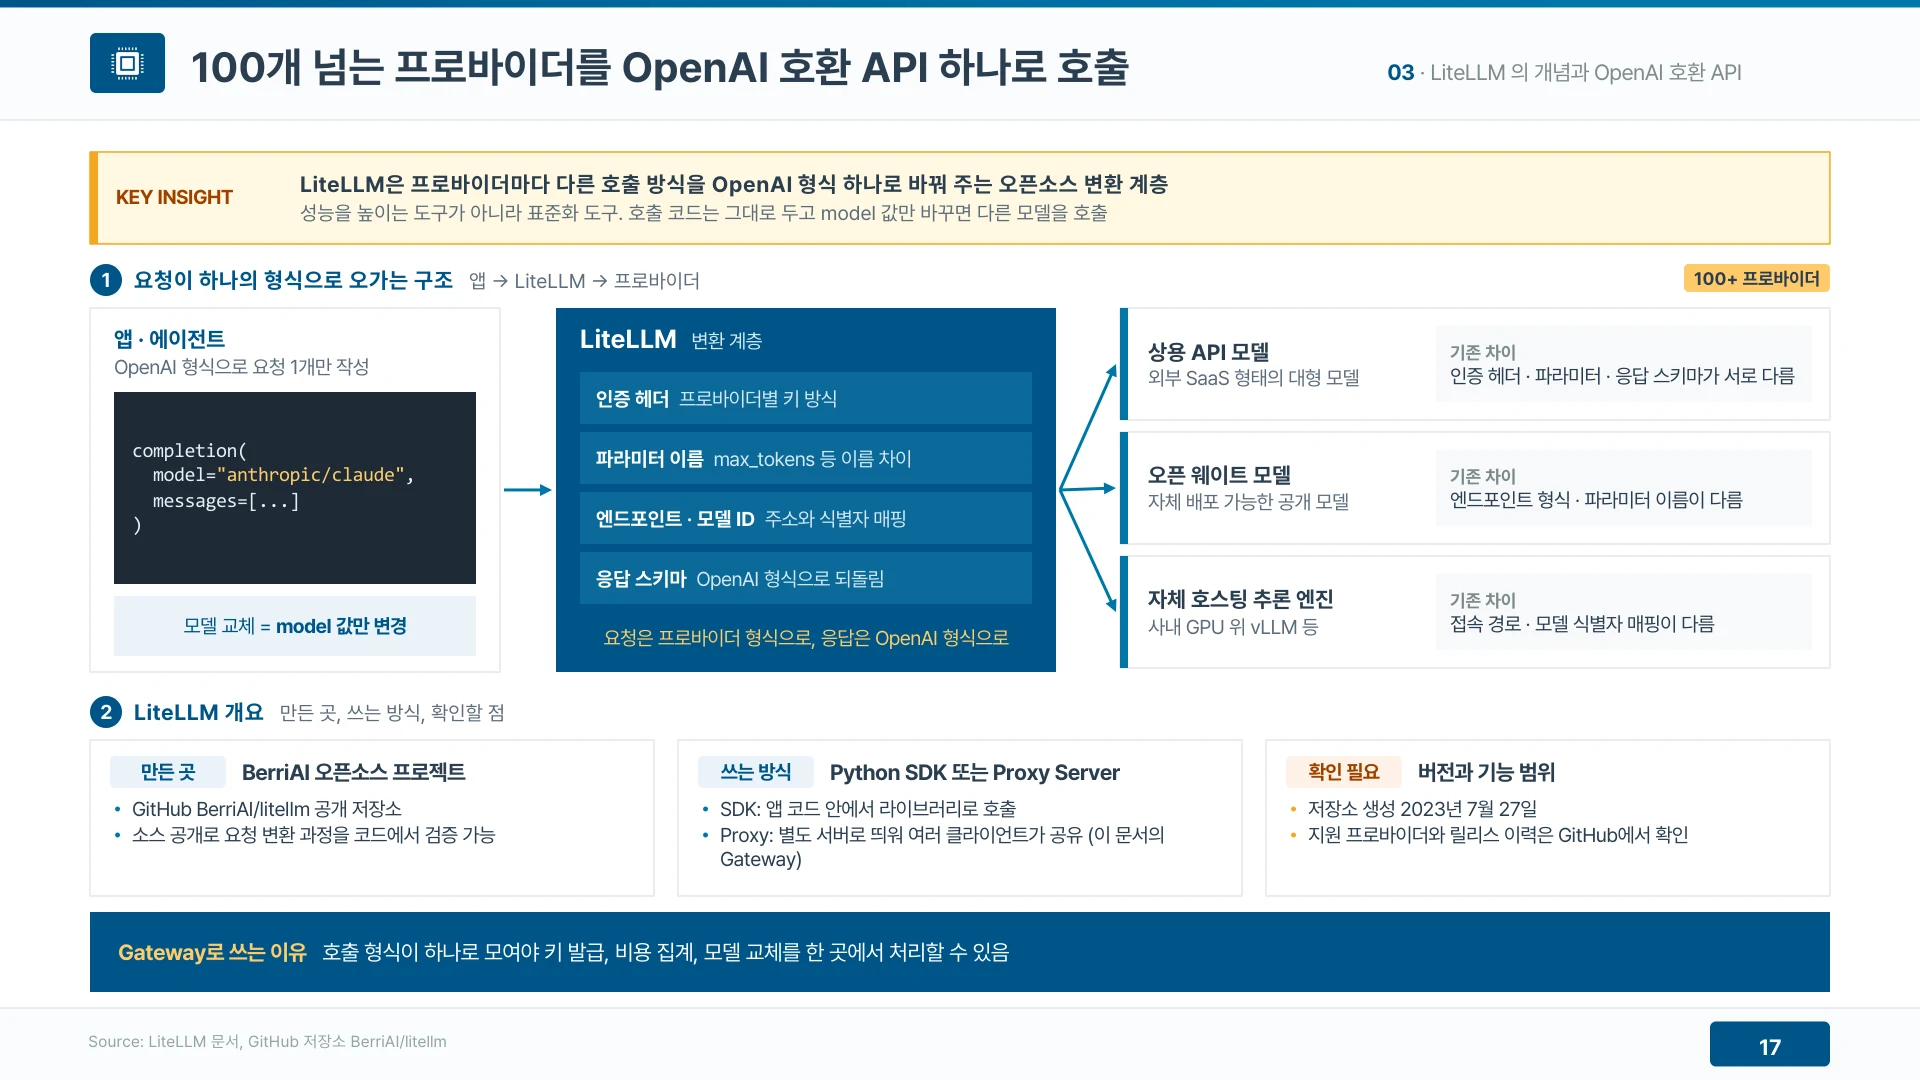
▲ LiteLLM은 프로바이더마다 다른 호출 방식을 OpenAI 형식 하나로 바꾼다 (발표자료 17쪽)
Virtual Key가 유출 피해를 키 하나의 예산 안에 묶는다
프로바이더 자격증명은 Proxy만 갖고, 사용자는 Proxy가 발급한 Virtual Key만 갖는다. 키마다 허용 모델과 예산, 분당 요청 수와 토큰 수 한도, 유효 기간을 정하고, 조직과 팀과 사용자와 키로 이어지는 계층에 각각 한도를 건다.
키가 유출돼도 그 키 하나만 지우면 되고 피해는 그 키의 예산 안에서 멈춘다. 주의할 점도 있다. 비용은 내장 단가표로 계산하므로 수치의 정확도가 단가표에 달려 있다. 청구서와 주기적으로 대조해야 한다.
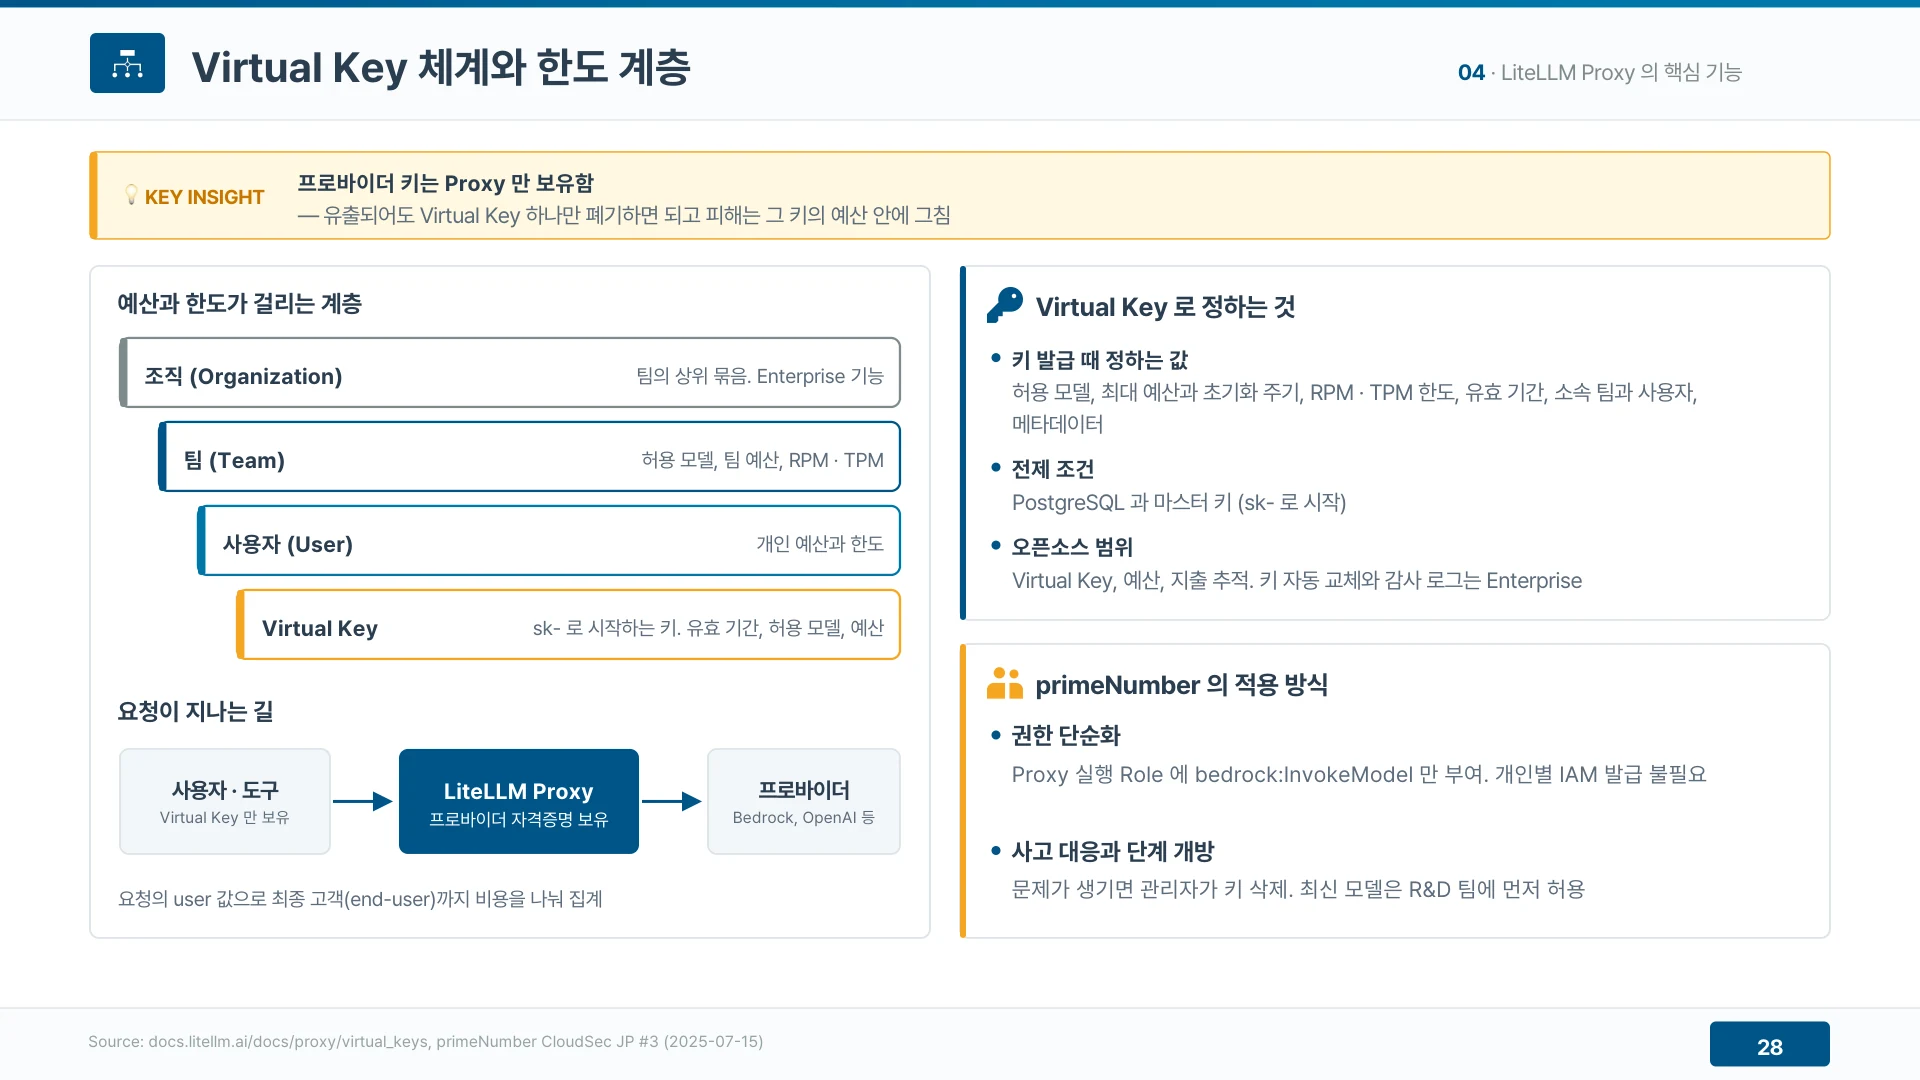
▲ 프로바이더 자격증명은 Proxy만 갖고 사용자는 한도가 걸린 Virtual Key만 받는다 (발표자료 28쪽)
폴백은 오류에만 반응하고 느려진 응답에는 걸리지 않는다
LiteLLM의 폴백은 오류와 타임아웃에만 반응한다. 요청이 실패하면 재시도하고, 실패가 쌓인 배포를 쿨다운으로 잠시 뺀 뒤, 다른 모델 그룹으로 넘긴다. 쿨다운 기본값은 분당 실패 세 번을 넘으면 5초 동안 제외하는 것이다.
응답은 오는데 느려진 상태에서는 전환되지 않는다. 전화 자동 응대 서비스 IVRy의 실제 장애가 이 형태였다. 평소 1초쯤이던 지연이 20초 가까이 치솟았지만 오류가 없어 폴백이 걸리지 않았다. 지연 감시와 전환 판단은 따로 설계해야 한다.
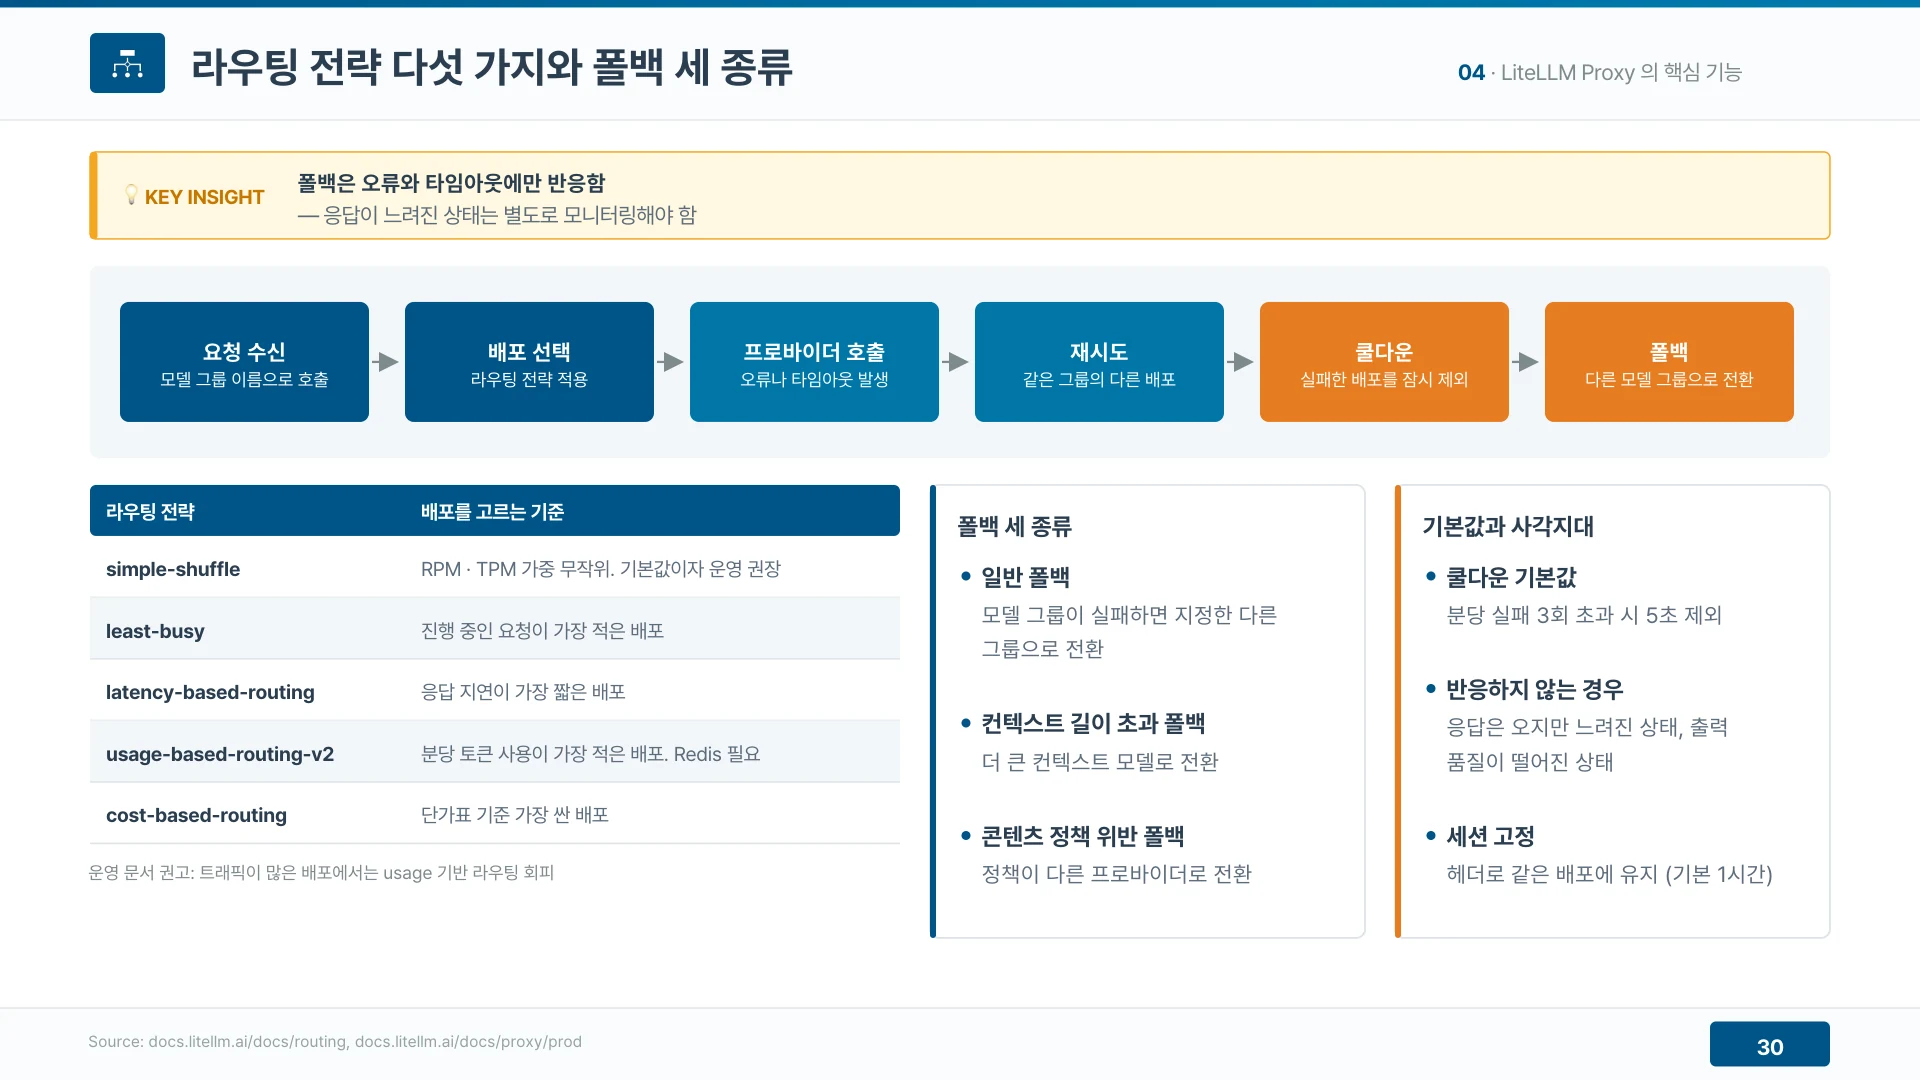
▲ 실패한 요청은 재시도와 쿨다운을 거쳐 다른 모델 그룹으로 넘어간다 (발표자료 30쪽)
Virtual Key와 예산은 Postgres를 연결해야 쓸 수 있다
폴백과 재시도는 설정 파일만으로 동작하지만 Virtual Key와 예산은 Postgres가 있어야 한다. 두 기능 모두 오픈소스 버전에 들어 있어 추가 계약은 필요 없다. 대신 데이터베이스의 백업과 복구가 운영 업무에 더해진다.
자주 틀리는 판단이 하나 있다. 폴백이 필요하다는 이유만으로 Proxy를 도입하면 근거가 맞지 않는다. 재시도와 폴백과 부하 분산은 SDK에서도 동작한다. Proxy에만 있는 것은 Virtual Key, 예산, 관리 화면, 한 곳에 모이는 로그다.
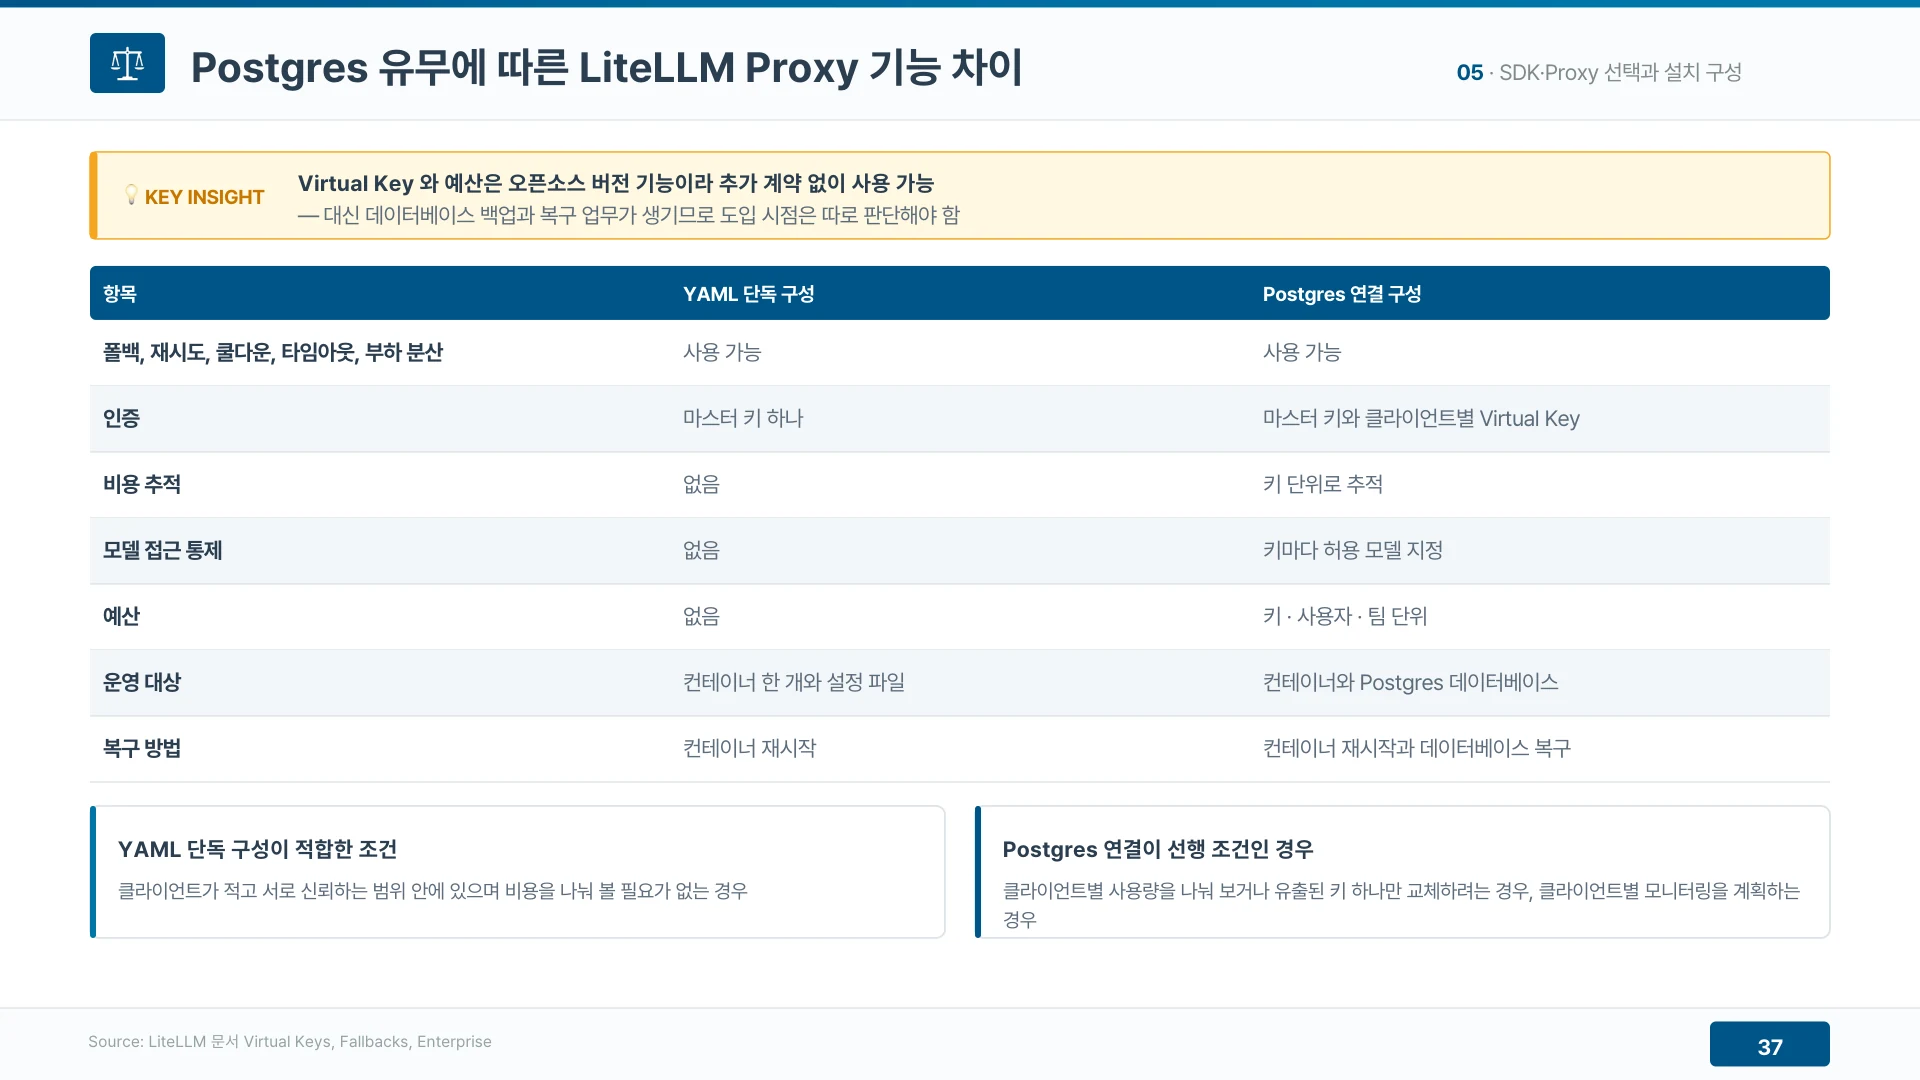
▲ 폴백은 설정 파일만으로 동작하고 Virtual Key와 예산은 Postgres가 있어야 한다 (발표자료 37쪽)
YAML 설정만으로 요건 여덟 개 가운데 다섯 개를 채운다
LLM 게이트웨이의 요건은 기본 네 가지와 상세 네 가지다. 데이터베이스 없이 YAML 단독 구성으로도 여덟 요건 가운데 다섯은 충족까지 도달한다.
| 요건 | YAML 단독 구성 | Postgres 연결 구성 |
|---|---|---|
| OpenAI 호환 엔드포인트와 모델 별칭 | 충족 가능 | 충족 가능 |
| 키 관리 | 부분 충족 | 충족 가능 |
| 폴백과 안정성 설정 | 충족 가능 | 충족 가능 |
| 요청과 응답 로깅 | 부분 충족 | 충족 가능 |
| 클라이언트별 Virtual Key와 예산 | 미충족 | 충족 가능 |
| 지연과 TTFT 모니터링 | 충족 가능 | 충족 가능 |
| 공급망 보안 | 충족 가능 | 충족 가능 |
| 게이트웨이 가용성 | 충족 가능 | 충족 가능 |
클라이언트를 구분하는 요건만 Postgres에 달려 있다. 그래서 선행 조건이 없는 버전 고정과 지표 수집을 먼저 하고, 그다음에 Postgres와 Virtual Key로 넘어간다.
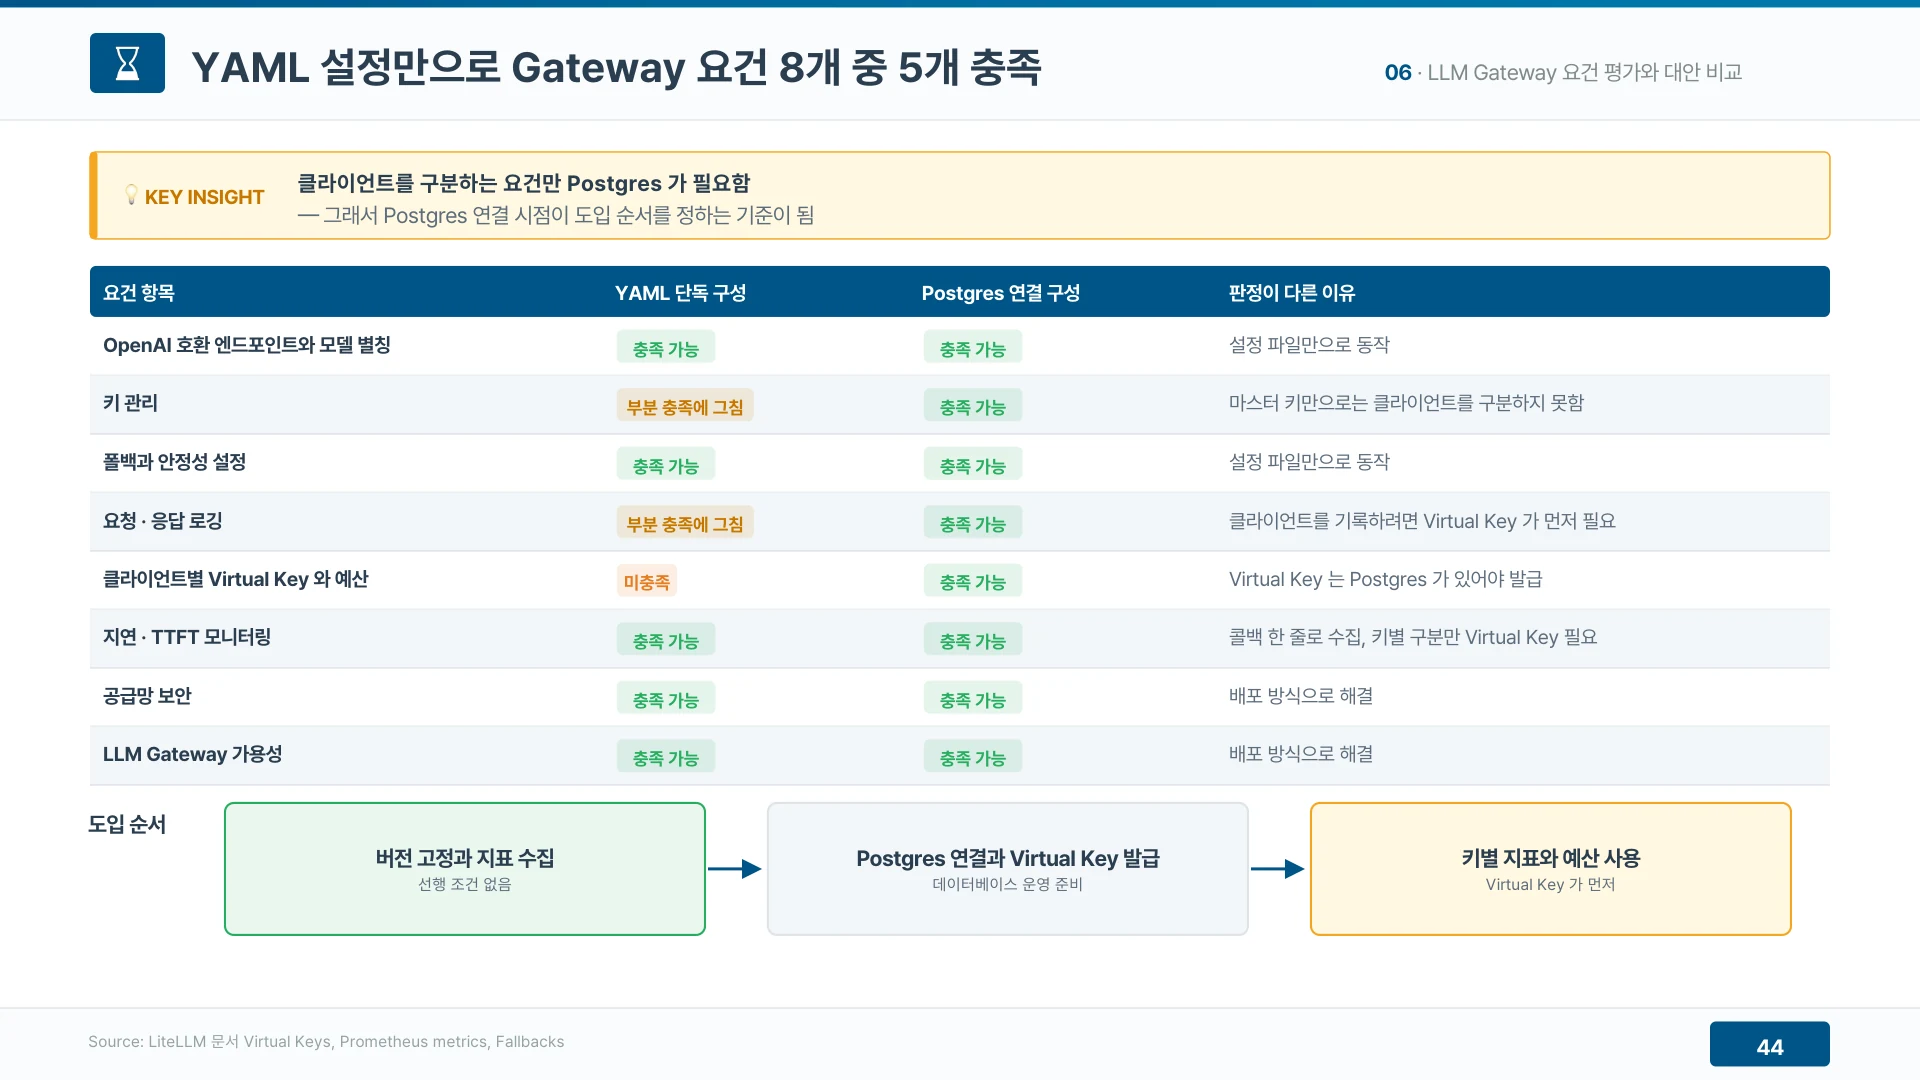
▲ 클라이언트를 구분하는 요건만 Postgres 연결이 필요하다 (발표자료 44쪽)
도입 사례가 밝힌 한계는 기능이 아니라 운영 부담이다
공개된 사례에서 보고된 한계는 기능이 모자라서가 아니라 운영 부담에서 나왔다. 벤고시닷컴은 ECS Fargate와 Aurora PostgreSQL 위에 올려 한 달 만에 전사 공개했고, RAKUS는 LiteLLM을 독립 파드로 분리해 에이전트의 Bedrock 호출을 모았다.
primeNumber는 한계를 직접 밝혔다. 원하는 기능이 Enterprise 쪽에 있고, 결함이 잦아 이슈를 계속 지켜봐야 하며, 정액 구독 도구는 통제 밖에 남는다. 버그 추적과 호스팅을 맡을 담당자가 있어야 도입 효과를 유지할 수 있다.
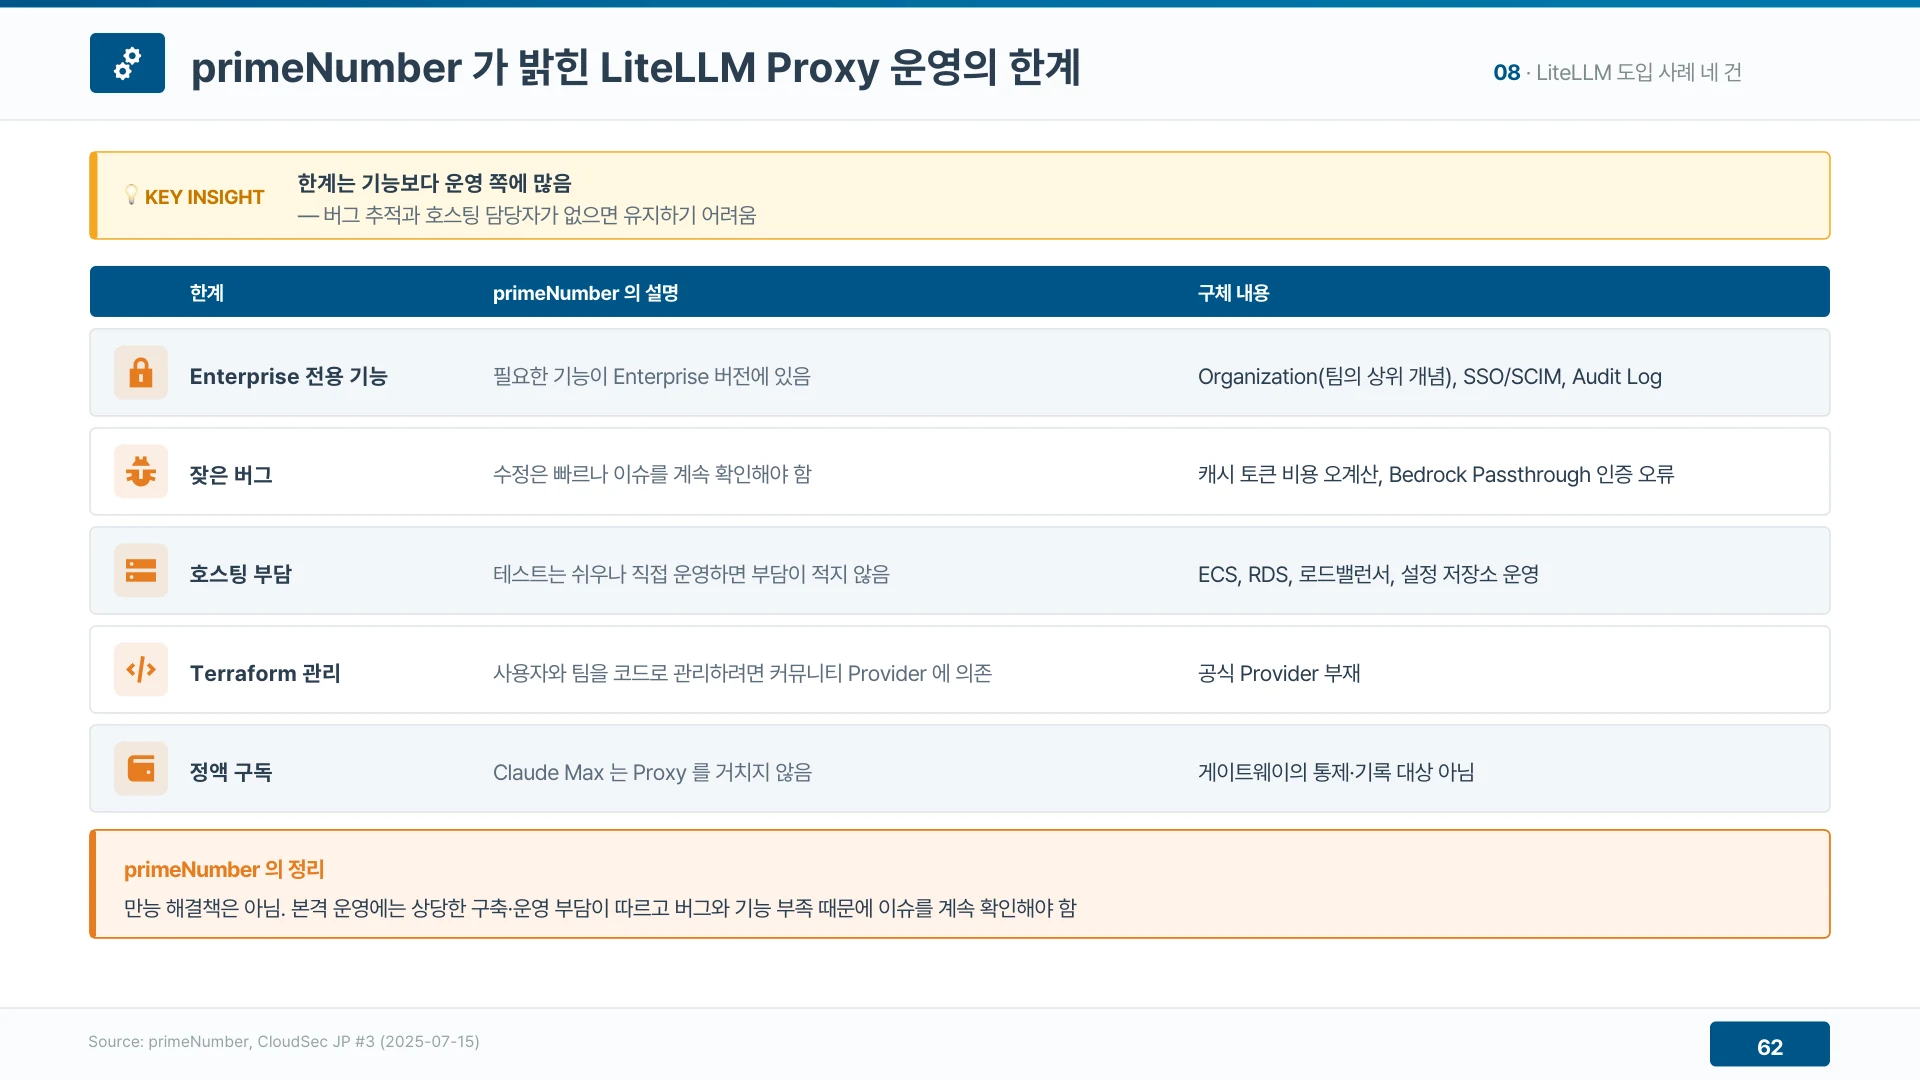
▲ primeNumber는 Enterprise 경계와 잦은 결함과 정액 구독의 통제 공백을 한계로 꼽았다 (발표자료 62쪽)
컨테이너 한 대 구성은 요건 여덟 개 중 하나만 충족했다
Docker 컨테이너 한 개와 YAML 파일 한 개로 운영하는 실제 구성을 평가표에 대입하면 충족 하나, 부분 충족 넷, 미충족 셋이 나온다. 미충족은 Virtual Key, 모니터링, 공급망 보안이다.
이 구성에서는 에이전트 프로파일 16개가 모두 같은 마스터 키로 접속하고, 프록시가 멈추면 추론 서버가 정상이어도 모든 에이전트가 모델을 호출하지 못한다. 미충족 셋은 오픈소스 버전 기능과 배포 방식으로 채울 수 있다. 제품을 바꿀 필요는 없다. 지표 수집은 설정 파일에 콜백 한 줄을 넣으면 데이터베이스 없이 시작된다.
에이전트가 붙은 구성에서는 질문을 하나 더 던진다. 사람 확인 없이 수행되는 동작 가운데 되돌리기 어려운 것이 무엇인가. OWASP Gen AI Security Project는 2025년 12월 9일 OWASP Top 10 for Agentic Applications 2026을 공개해 에이전트형 애플리케이션의 위험을 열 개 범주로 정리했다. 예약 작업처럼 사람이 지켜보지 않는 호출에는 키별 예산이 그 통제의 한 층이 된다.
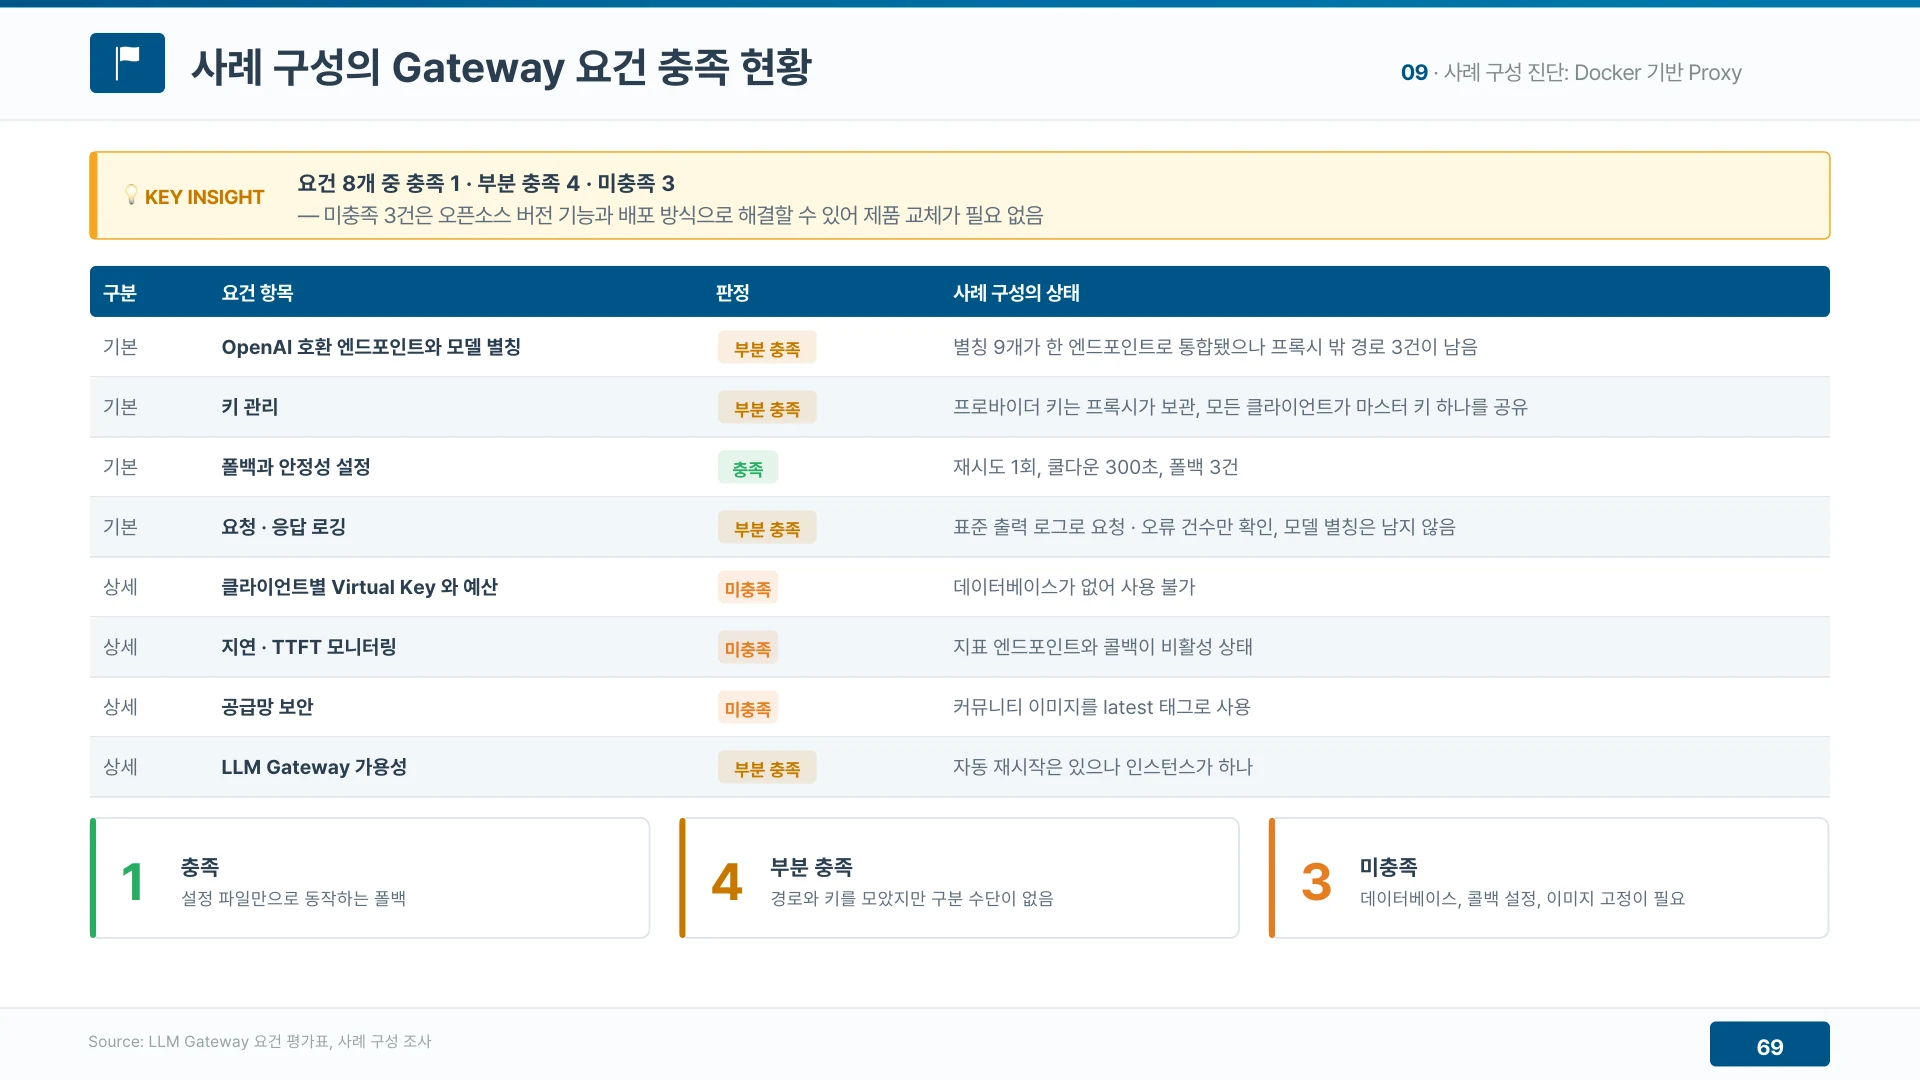
▲ 컨테이너 한 대 구성은 요건 여덟 개 가운데 충족 하나, 부분 충족 넷, 미충족 셋이다 (발표자료 69쪽)
2026년 공급망 사고는 버전 고정 여부로 영향이 갈렸다
2026년 3월 24일 LiteLLM의 PyPI 패키지 두 버전이 악성 코드를 담은 채 약 40분 동안 배포됐다. 악성 코드는 환경변수와 클라우드 자격증명을 모아 외부로 보냈다. 버전을 고정한 공식 Docker 이미지로 운영한 환경은 영향을 받지 않았다.
4월과 6월에는 인증 없이 공격할 수 있는 취약점이 나왔고, 4월 취약점은 공개 36시간쯤 뒤에 실제 공격이 관측됐다. Proxy는 내부망에만 두고, 버전을 고정하고 서명을 검증하며, 새 버전은 3~7일 늦게 받는다. 게이트웨이는 모든 프로바이더 키가 지나는 자리여서 침해 때 교체할 키 목록도 미리 만들어 둔다.
공급망 통제는 게이트웨이만의 숙제가 아니다. OWASP Top 10 for LLM Applications 2025는 공급망을 LLM03 항목으로 따로 두었고, 국가정보원이 2025년 12월에 낸 국가·공공기관 AI보안 가이드북도 보안위협 15개 유형과 보안대책 30개를 정리했다. 두 문서는 무엇을 할 수 있는지를 알려 줄 뿐이어서, 어느 버전을 언제 받을지는 조직이 직접 정해야 한다.
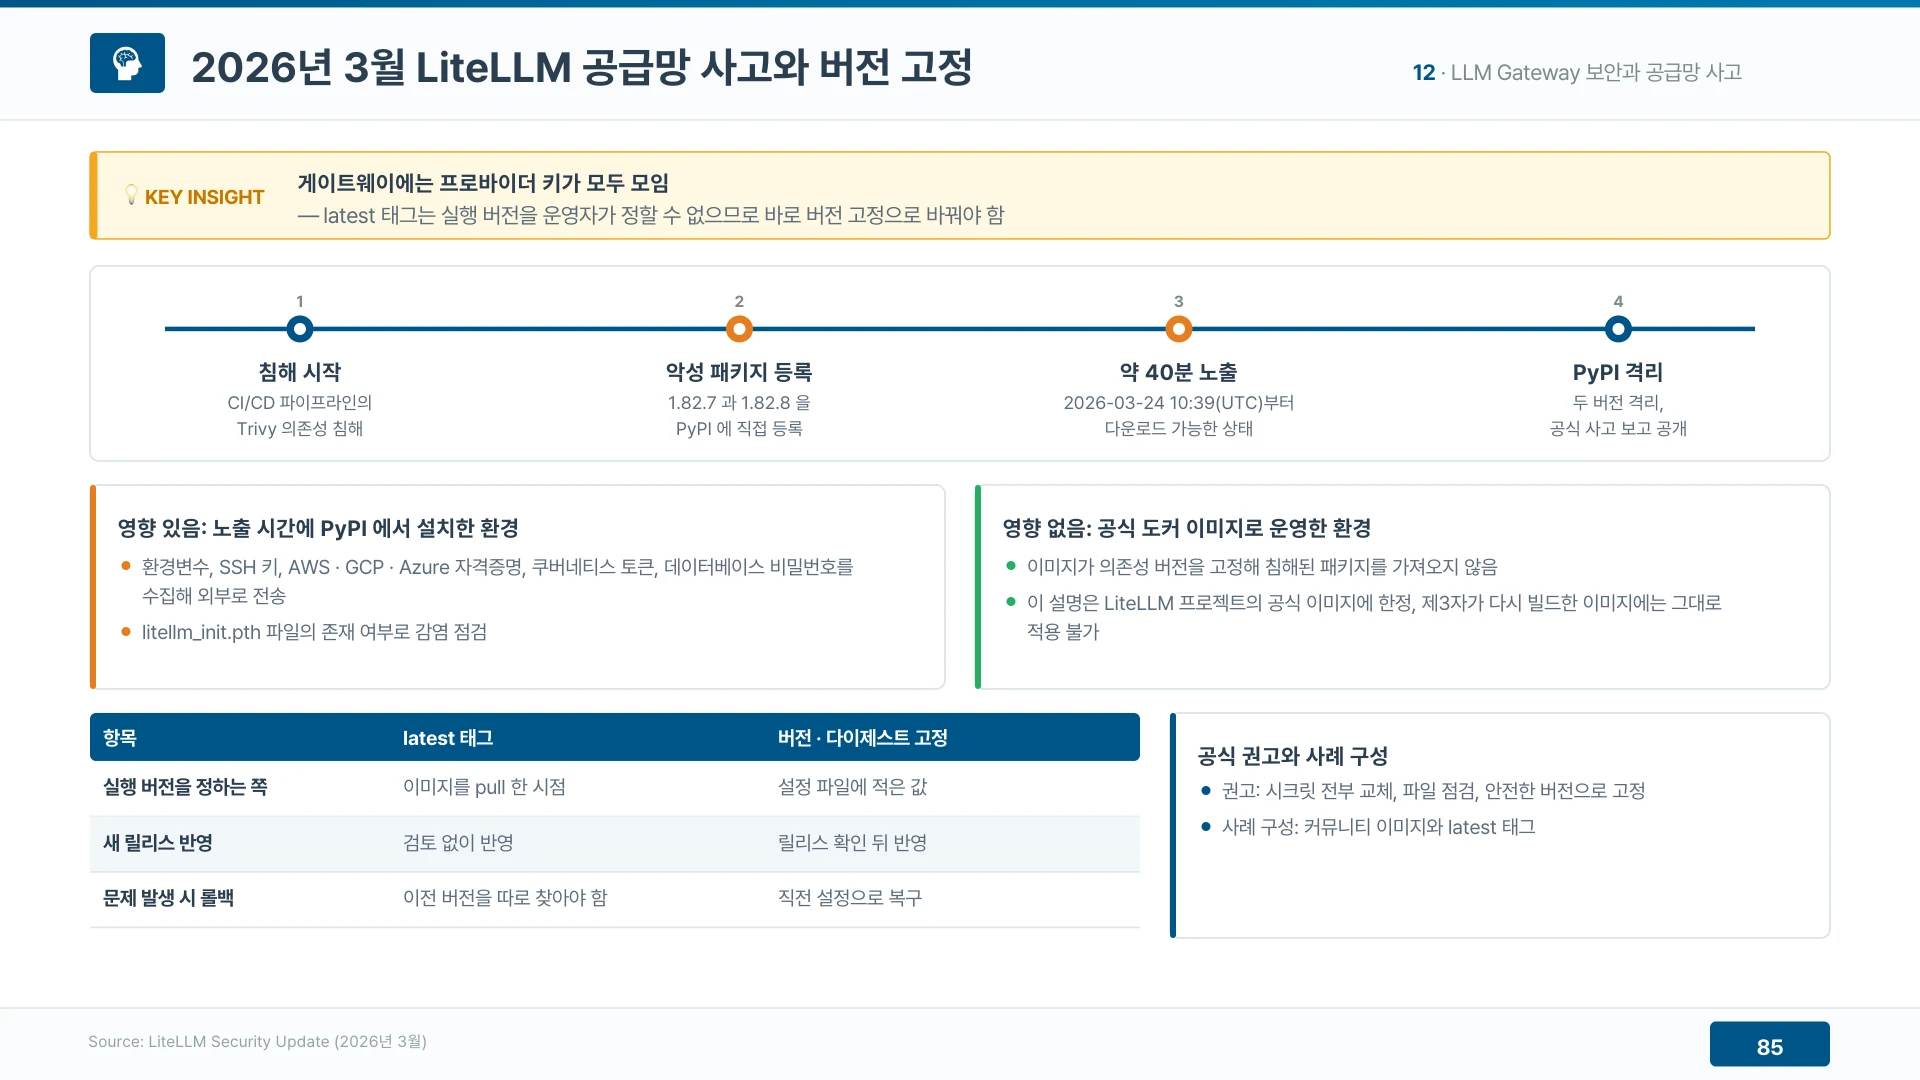
▲ 악성 패키지는 약 40분 동안 배포됐고 버전을 고정한 환경은 영향이 없었다 (발표자료 85쪽)
Proxy를 둘 이상 실행하면 Redis가 한도를 공유한다
Proxy를 이중화하면 Redis가 필요하다. Redis가 없으면 인스턴스마다 한도를 따로 계산해서, 인스턴스가 세 대면 실제 허용량이 세 배가 된다. 쿨다운 상태도 인스턴스마다 달라진다.
공식 권장 사양은 파드마다 1 vCPU와 4GB, 워커 한 개다. LiteLLM 공식 벤치마크에서 오버헤드는 인스턴스 네 대일 때 2~8ms였고 두 대로 줄이면 12~29ms로 늘었다. 병목은 Proxy의 CPU가 아니라 지출 로그를 쓰는 데이터베이스의 연결 수 한도다. 쿠버네티스에는 Helm 차트로 배포하고, 차트와 이미지 모두 버전 태그를 고정한다.
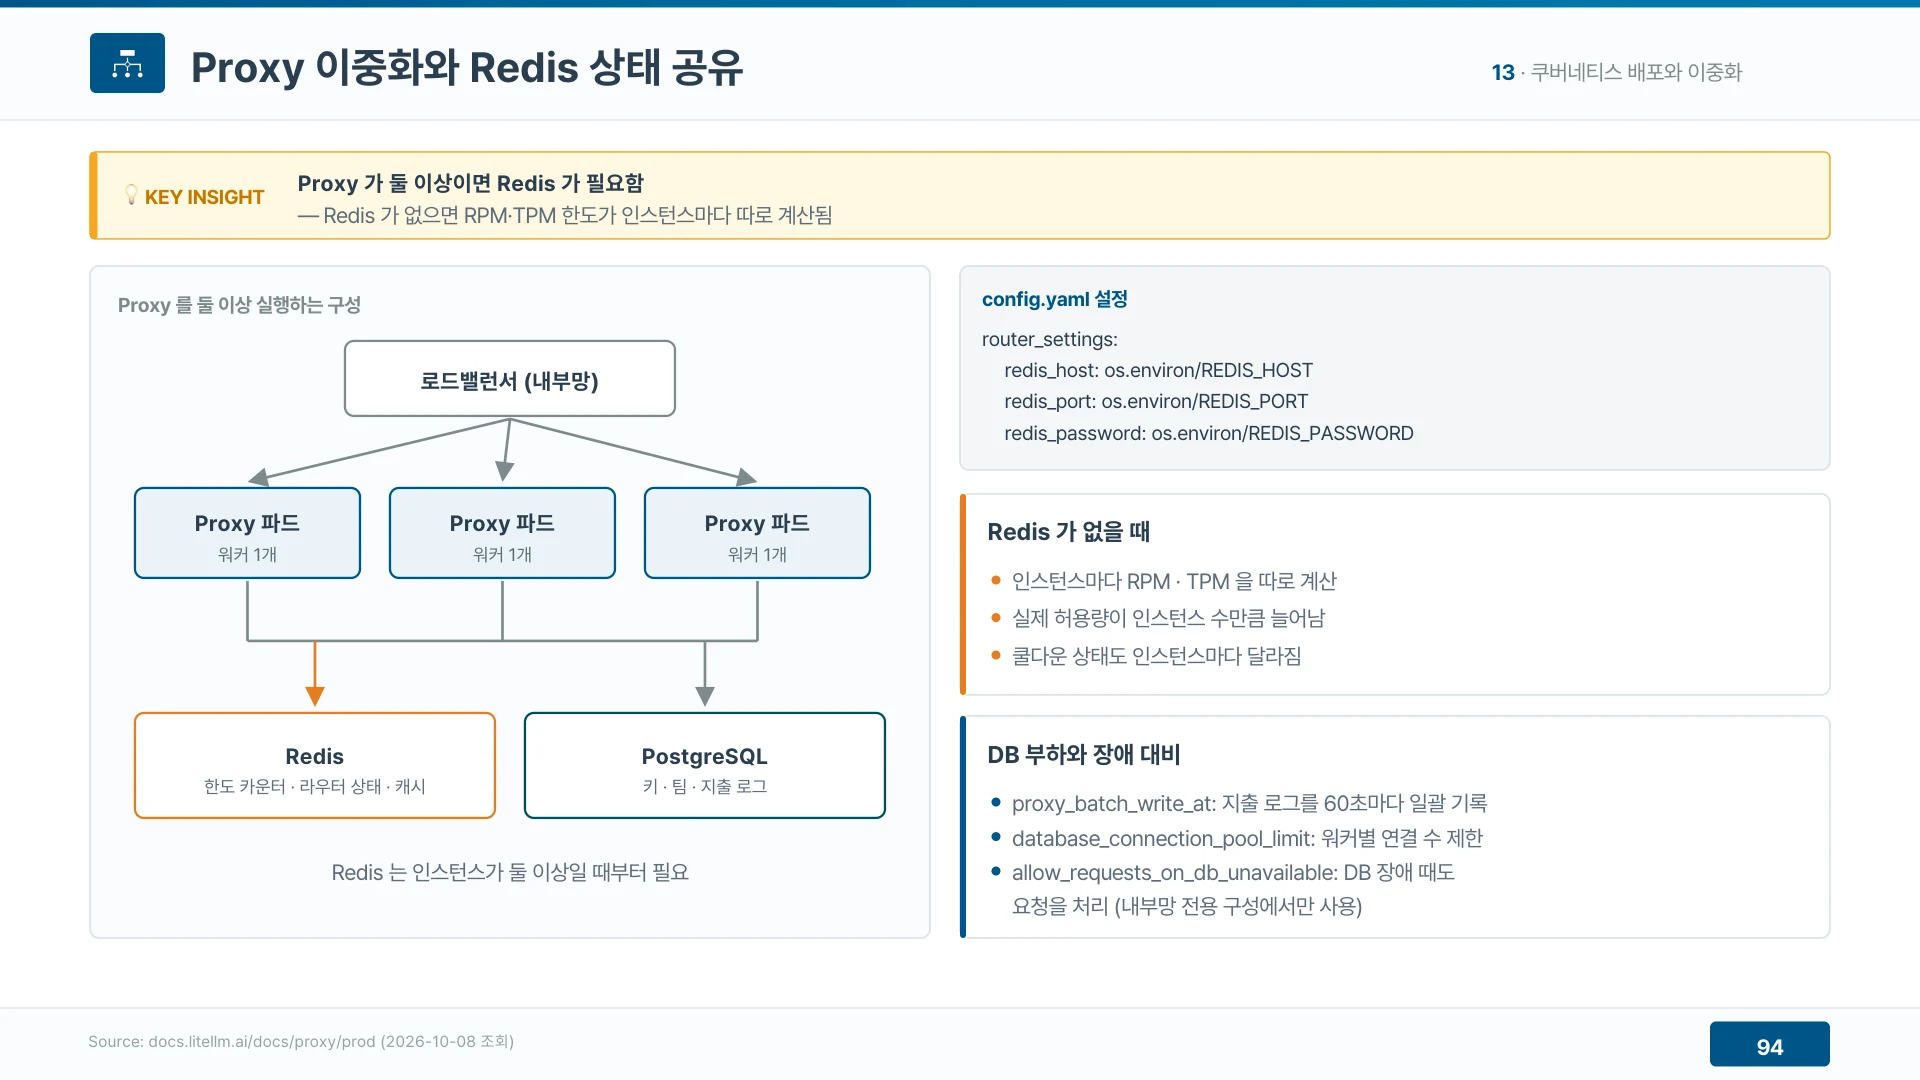
▲ Proxy가 둘 이상이면 Redis로 한도 카운터와 라우터 상태를 공유한다 (발표자료 94쪽)
실행 순서는 날짜가 아니라 선행 조건으로 정한다
도입 단계는 의존 관계로 순서를 정한다. 호출 경로 조사와 버전 고정과 지표 수집은 선행 조건이 없어 바로 시작한다. Postgres 연결과 Virtual Key 발급이 그다음이고, 프록시 밖 경로 이전과 이중화가 마지막이다.
지표를 Virtual Key보다 먼저 켜 두면 키를 나누기 전과 후를 같은 지표로 비교할 수 있다. 버전은 3월의 악성 버전 두 개를 제외하고 취약점이 수정된 1.83.7 이상으로 고정한다.
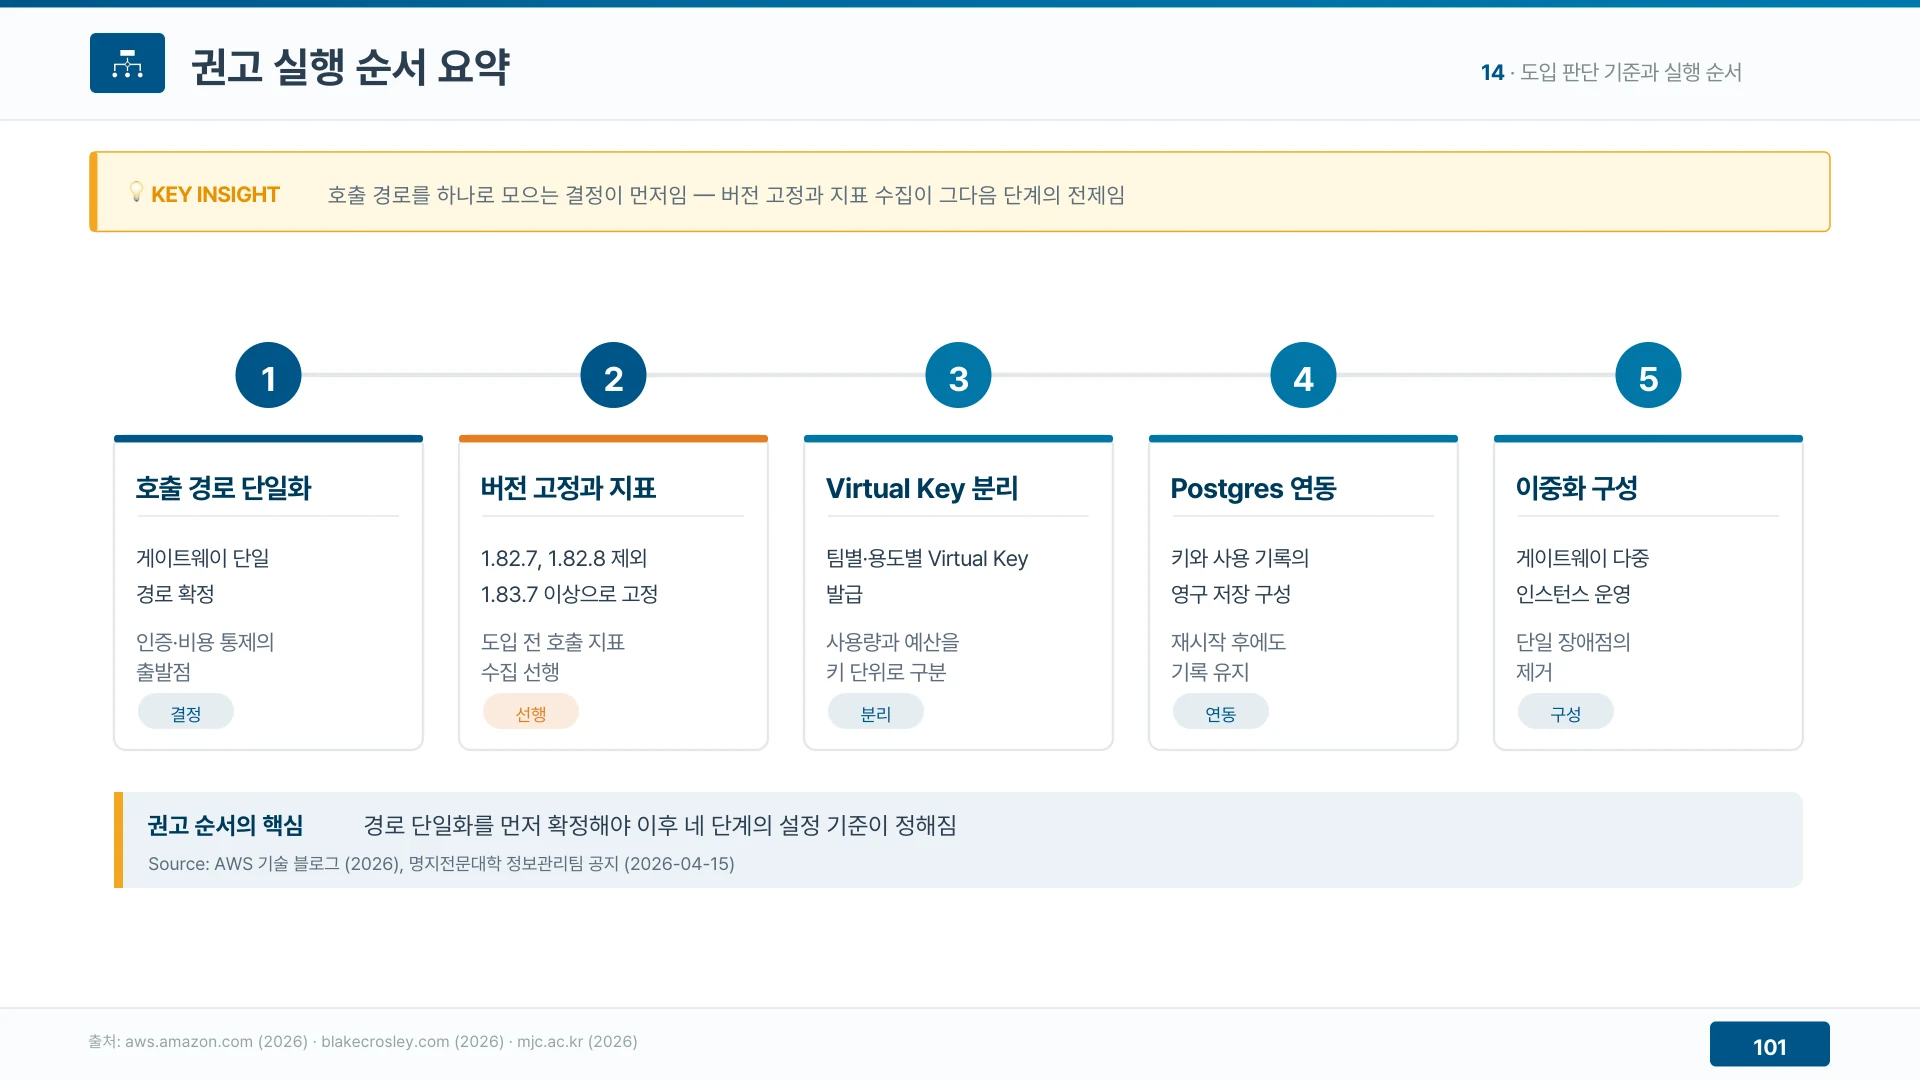
▲ 경로 단일화 결정 뒤에 버전 고정과 지표 수집, Virtual Key, 이중화가 이어진다 (발표자료 101쪽)
핵심 정리
LiteLLM 도입에서 내릴 결정은 하나다. LLM 호출 경로를 게이트웨이 한 곳으로 모으는 것이다. 별칭으로 모델을 바꾸는 이점도, 키별 비용 집계도 모든 클라이언트가 Proxy를 거칠 때만 성립한다. 호출 경로를 한 곳으로 모으면 그 한 곳의 통제 수준이 전체의 통제 수준이 된다.
LiteLLM Proxy가 맞는 자리는 사내 개발 도구의 공용 통로, 팀별 비용 통제, 에이전트의 호출 계층 분리, 로컬 모델과 클라우드의 혼용이다. 파이썬 애플리케이션 하나가 여러 프로바이더를 부르는 정도라면 SDK로 충분하다. 운영 담당 없이 인터넷에 내놓는 구성은 맞지 않는다.
검토를 시작한다면 다음 순서를 권한다.
- 클라이언트 한 곳을 한 행으로 적는 호출 경로 조사표를 작성해야 한다.
- 이미지 태그를 latest에서 검증한 버전으로 고정해야 한다.
- 설정 파일에 Prometheus 콜백을 넣어 지연과 폴백 지표를 수집해야 한다.
- Postgres를 연결하고 클라이언트마다 Virtual Key를 발급해야 한다.
- Proxy를 거치지 않던 직접 호출 경로를 Proxy로 옮겨야 한다.
- Proxy를 둘 이상으로 늘리고 Redis와 헬스 체크를 연결해야 한다.
자주 묻는 질문
LiteLLM은 무엇이고 무엇을 표준화하는가
LiteLLM은 프로바이더마다 다른 호출 방식을 OpenAI 형식 하나로 바꿔 주는 오픈소스 변환 계층이다. 인증 헤더와 파라미터 이름, 엔드포인트, 응답 스키마의 차이를 흡수한다. 새 성능을 만드는 도구가 아니라 표준화 도구다.
LLM 게이트웨이는 API 게이트웨이와 무엇이 다른가
제어 단위가 다르다. API 게이트웨이는 요청 수로 제한하고, LLM 게이트웨이는 토큰 수와 예산 금액으로 제한한다. 라우팅도 URL 경로 대신 모델 이름으로 하고, 장애가 나면 다른 모델로 폴백한다.
SDK와 Proxy 가운데 무엇을 골라야 하는가
클라이언트가 둘 이상이고 키와 예산을 책임질 담당자가 있으면 Proxy를 검토한다. 애플리케이션 하나가 여러 프로바이더를 부르는 정도면 SDK로 충분하다. 폴백은 SDK에서도 동작하므로 Proxy를 고를 근거가 되지 않는다.
Virtual Key와 예산을 쓰려면 무엇이 필요한가
Postgres를 연결해야 한다. 두 기능은 오픈소스 버전에 들어 있어 Enterprise 계약은 필요 없다. Proxy를 둘 이상 실행해 한도를 공유하려면 Redis도 추가한다.
폴백은 어떤 장애에서 동작하지 않는가
응답은 오는데 느려진 장애와 Proxy 자체가 멈춘 장애다. 폴백은 오류와 타임아웃에만 반응하고, Proxy 안에서 판단하는 기능이라 Proxy의 정지에는 대응하지 못한다.
2026년 공급망 사고 뒤에 무엇을 점검해야 하는가
버전을 고정한 공식 Docker 이미지를 쓰는지부터 확인한다. 이어서 서명 검증, 새 버전 지연 적용, 3월 침해 흔적 점검, CI 자격증명의 단기 발급 전환을 본다. Proxy는 내부망에만 둔다.
도입은 어떤 순서로 진행해야 하는가
호출 경로 조사, 버전 고정과 지표 수집, Postgres 연결과 Virtual Key 발급, 직접 호출 경로 이전, 이중화 순서다. 날짜가 아니라 선행 조건으로 순서를 정한다.
참고 리소스
MSAP.ai 자료
- AI 에이전트란 무엇인가 — 정의, 구조, 기업 도입 기준
- AI 에이전트를 위한 LLM 게이트웨이 — LiteLLM 도입 가이드
- LiteLLM Proxy로 AI 에이전트 LLM Gateway 구축 백서
- AI LLM 가속 엔진 vLLM — GPU 병목과 도입 비용 줄이기
- 프라이빗 sLLM Qwen 3.6 27B — 데이터 주권과 TCO를 함께
- LLM이란 무엇인가 — 원리부터 기업 도입 판단까지
- 멀티 에이전트 시스템 설계 — 협업 패턴과 실패 모드
- AI 에이전트 필수 기능 여덟 가지, 도입 전 점검 기준
LiteLLM 공식 자료