TL;DR — AI 생산성은 과제와 사람에 따라 갈린다. 하위 성과자와 정형 업무에서 크고, 조직 성과로 옮기려면 일하는 방식부터 바꿔야 한다.
2025년 METR 실험에서 숙련 개발자는 AI 를 쓰며 20% 빨라졌다고 느꼈지만 실제 작업은 19% 더 걸렸다. 클라우드네이티브TV 「AI 시대 일하는 법」 EP.02 는 이런 실측 연구를 모아, 기업과 IT 책임자가 AI 생산성을 체감이 아닌 숫자로 판단하는 방법을 정리한다. 이 글은 영상의 일곱 장면을 따라 그 숫자와 해석을 풀어 쓴다.
영상으로 먼저 보기: AI 생산성 실측 결과
7분 33초 분량의 영상은 컨설턴트·상담원·개발자·노동시장·경제 규모 다섯 갈래의 실측 결과를 한 흐름으로 묶는다.
영상에서 다루는 순서는 다음과 같다.
- 00:00 AI 생산성을 숫자로 본다
- 01:34 하위 성과자가 가장 많이 올랐다
- 02:28 좋은 본보기를 AI 로 배운다
- 03:19 AI 는 기존 역량을 증폭한다
- 04:14 개인은 빨라졌는데 조직은 아직이다
- 05:10 신입 채용의 현관문이 좁혀진다
- 06:19 생산성 효과는 한국 경제의 10배 규모
발표자료 다운로드: AI 시대 어떻게 일할 것인가
이 영상의 원본은 333쪽 발표자료 「AI 시대 어떻게 일할 것인가」의 생산성 실측 장이다. 발표자료는 일의 구조부터 직무·조직·개인·역할별 AI 사용법까지 대분류 여섯 개, 중분류 47개로 나뉘어 있어 주제별로 끊어 읽거나 사내 교육 한 회차로 쓰기 좋다. BCG·METR·스탠퍼드 연구처럼 이 글에 나온 숫자의 출처는 장마다 바닥글에 적혀 있다.
이 영상이 답하는 7가지 질문 정리
- AI 생산성은 누구에게서 가장 크게 나타나는가?
- AI 가 오히려 성과를 떨어뜨리는 과제는 어떤 것인가?
- 초보 상담원은 어떻게 34% 더 많은 상담을 처리했는가?
- 개발자가 느낀 속도와 실제 측정은 왜 반대로 나왔는가?
- 개인 생산성이 올랐는데 조직 성과는 왜 그만큼 오르지 않는가?
- 노동시장에서는 어떤 신호가 먼저 나타나는가?
- AI 생산성의 경제 효과는 경영진이 다룰 만한 규모인가?
하위 성과자에게 가장 컸던 AI 생산성 효과
AI 생산성의 첫 번째 실측 결과는 잘하는 사람보다 덜 하던 사람이 더 많이 오른다는 것이다. 하버드 경영대학원과 BCG(보스턴컨설팅그룹)가 함께 진행한 실험에 BCG 컨설턴트 758명이 참여했다. 연구진은 먼저 AI 가 잘하는 범위 안에 드는 과제를 주고, GPT-4 를 쓴 그룹과 쓰지 않은 그룹을 비교했다.
GPT-4 를 쓴 그룹은 과제를 12.2% 더 많이 끝냈고, 처리 시간은 25.1% 짧았으며, 결과물 품질 평가는 40% 이상 높았다. 영상은 여기서 한 걸음 더 들어가 “누가 가장 큰 덕을 봤는가”를 묻는다. 실험 전 기준 성과로 나눠 보면 하위 절반은 43%, 상위 절반은 17% 올랐다. 같은 도구를 줬는데 효과의 크기가 두 배 넘게 벌어진 셈이다.
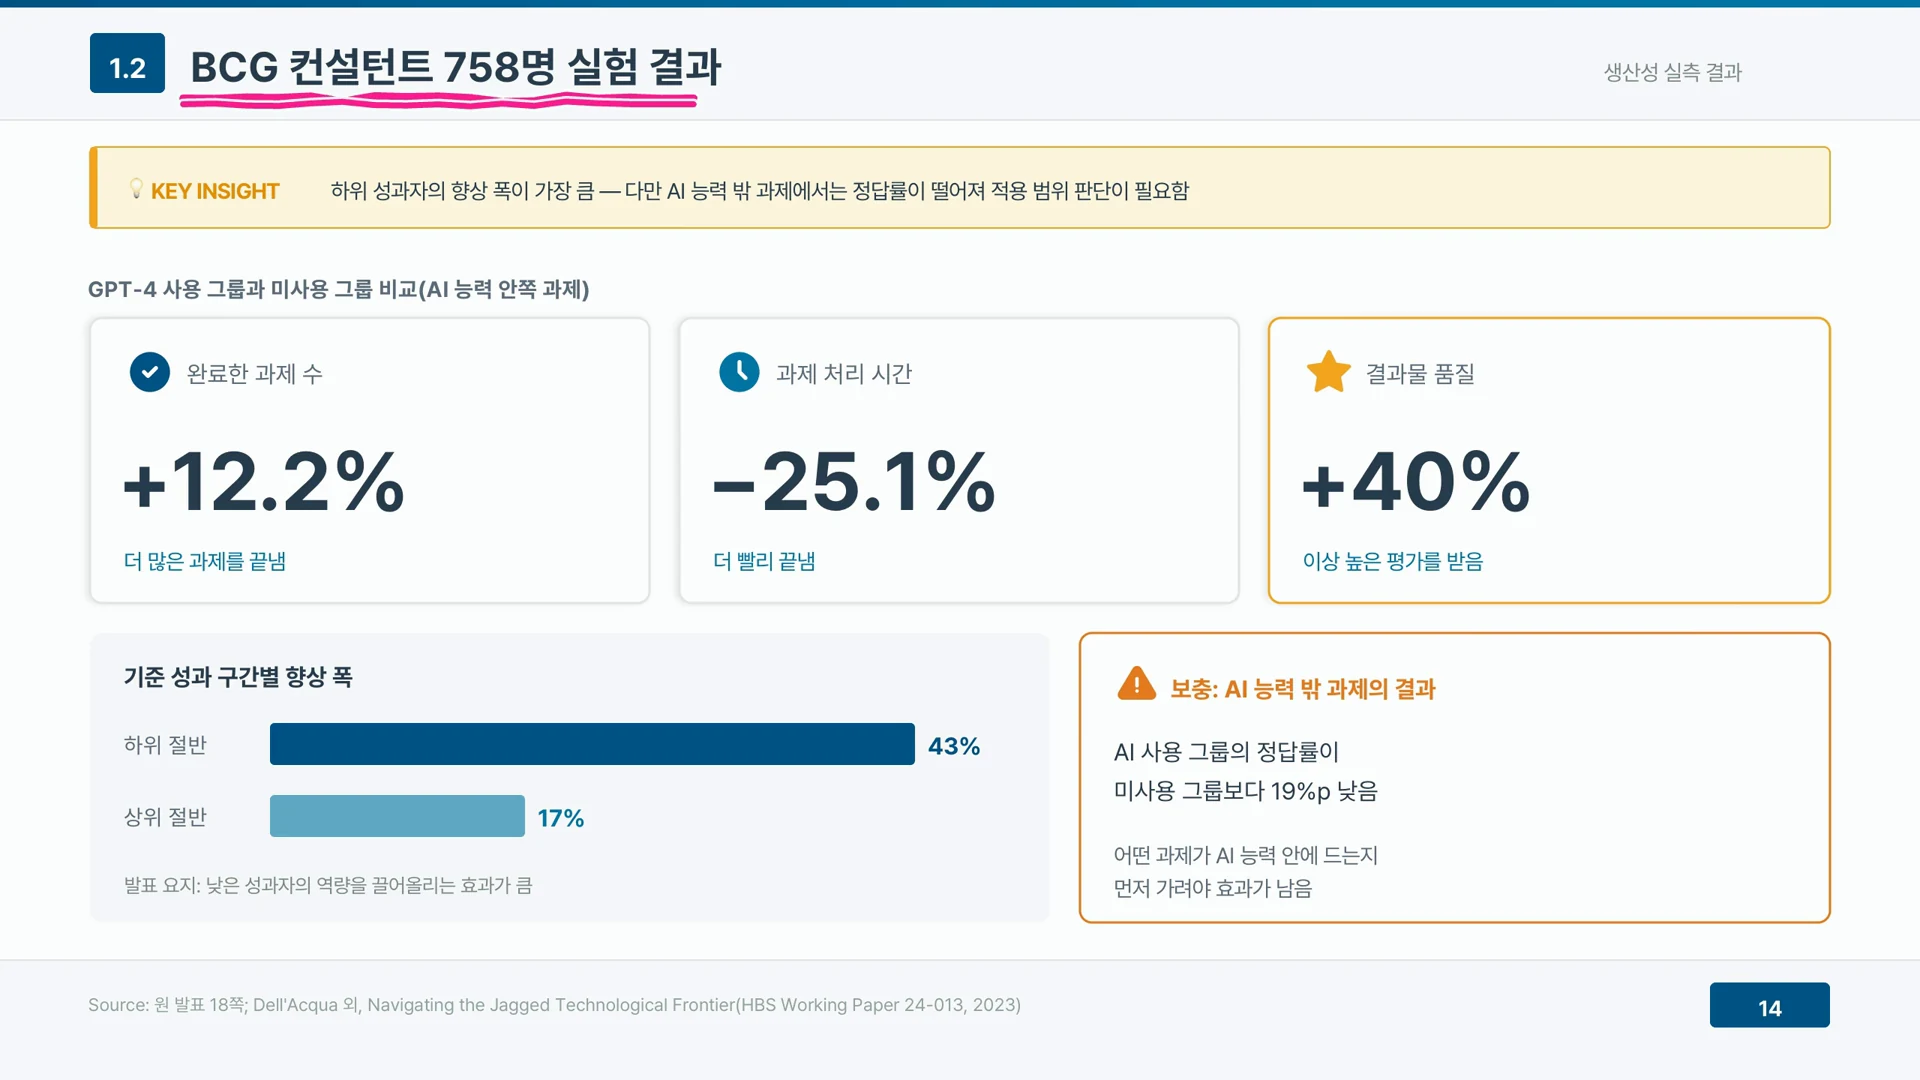
▲ 하위 절반 +43%, 상위 절반 +17% — 격차를 줄이는 AI (영상 1:36)
영상은 이 차이를 내비게이션에 빗댄다. 길을 잘 아는 운전자에게 내비게이션은 확인 도구에 그치지만, 처음 가는 길에서는 운전 자체를 바꿔 놓는다. AI 생산성도 마찬가지로 기준점이 낮은 사람에게 더 크게 나타난다. 도입을 검토하는 조직이라면 전사 평균만 볼 것이 아니라, 경력과 숙련도에 따라 효과를 나눠서 측정해야 한다. 평균 수치 하나로는 누가 실제로 혜택을 받는지 보이지 않는다.
이 결과는 AI 생산성을 어디에 먼저 적용할지에 대한 실마리도 준다. 신규 입사자의 업무 적응, 처음 맡는 업무, 문서 초안 작성처럼 기준점이 낮은 자리에서 AI 생산성 효과가 먼저 드러날 가능성이 크다. 반대로 숙련자에게 같은 폭의 개선을 기대하고 목표치를 잡으면 실망하기 쉽다. 효과 측정 표를 만들 때 경력 구간별 칸을 따로 마련해야 한다.
AI 능력 밖 과제에서 정답률이 떨어진 사례
같은 BCG 실험에는 반대 방향의 결과도 있다. 연구진은 AI 가 잘하지 못하는 범위, 곧 AI 능력 밖에 있는 과제도 함께 줬다. 이 과제에서 AI 를 쓴 그룹의 정답률은 쓰지 않은 그룹보다 19%포인트 낮았다. AI 생산성이 항상 플러스로 나오는 것이 아니라는 뜻이다.
연구 제목이 말하는 “들쭉날쭉한 경계(jagged frontier)”가 바로 이 지점이다. AI 가 잘하는 일과 못하는 일의 경계는 직관과 맞지 않게 울퉁불퉁하다. 겉보기에 비슷한 두 과제라도 하나는 AI 능력 안에, 다른 하나는 밖에 있을 수 있다. 문제는 사용자가 그 경계를 모른 채 AI 의 답을 믿으면, 능력 밖 과제에서도 그럴듯한 오답을 그대로 채택한다는 점이다.
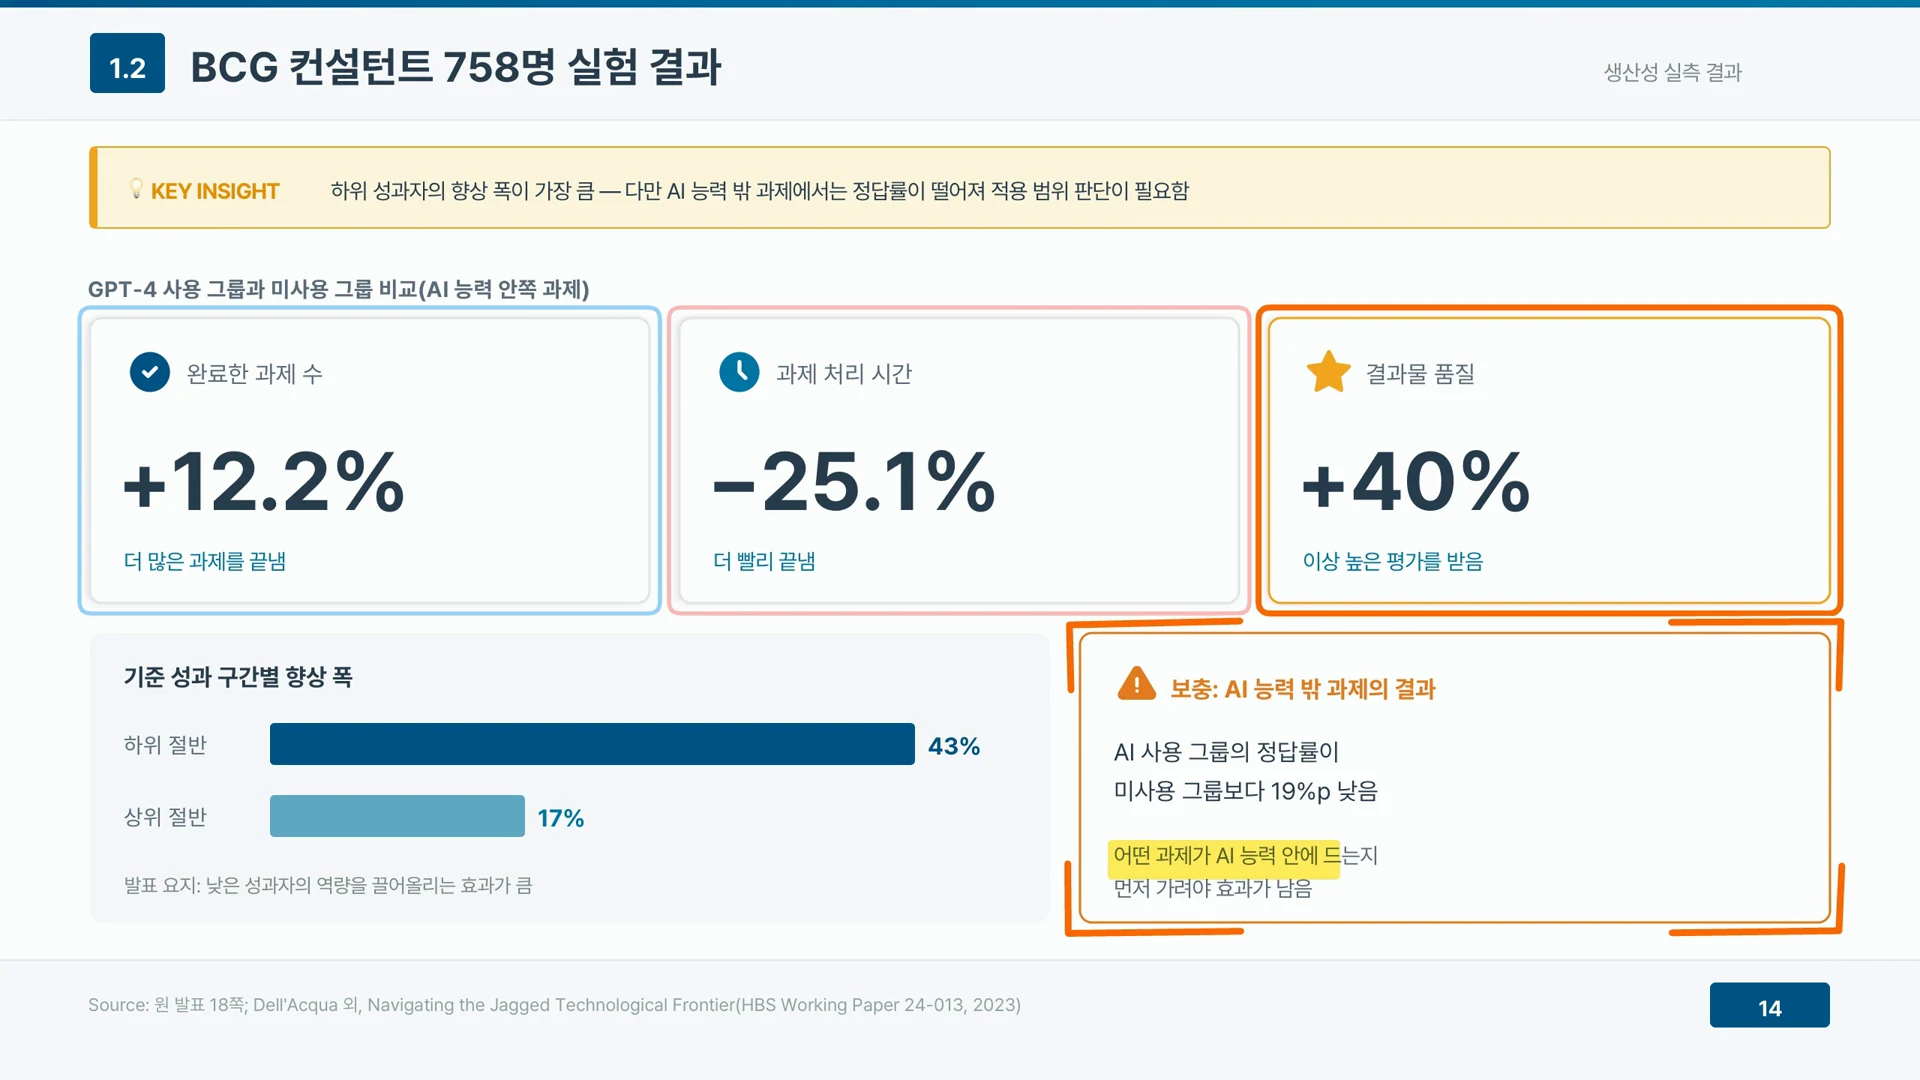
▲ BCG 컨설턴트 758명 실험 — 범위 안에서는 오르고 범위 밖에서는 떨어진다 (영상 2:24)
영상의 결론은 짧다. 어떤 과제가 AI 능력 안에 드는지 먼저 가려야 효과가 남는다. 조직이 할 일은 과제 목록을 놓고 AI 에 맡길 일, 사람이 검토할 일, AI 를 쓰지 않을 일을 나누는 것이다. 이 분류 없이 “모든 업무에 AI 를 쓰라”고 지시하면, 범위 안 과제에서 얻은 이득을 범위 밖 과제의 오답이 깎아 먹는다.
실무에서는 AI 능력 범위를 문서로 남겨 두는 것이 출발점이다. 어떤 유형의 질의에 AI 답을 바로 써도 되는지, 어떤 유형은 반드시 사람이 근거를 확인해야 하는지 팀 단위로 합의해 두면 AI 생산성의 이득은 지키고 오답 비용은 줄일 수 있다. 이 경계는 모델이 바뀔 때마다 움직이므로 한 번 정하고 끝낼 목록이 아니다. 분기마다 실제 업무 표본으로 다시 점검해야 한다.
좋은 본보기를 AI 로 배우는 방식
두 번째 실측 무대는 고객상담 현장이다. 상담원 5,179명에게 대화를 도와주는 AI 를 붙였더니 시간당 해결 건수가 평균 14% 늘었다. 경력이 짧은 초보 상담원은 34%나 늘었고, 숙련 상담원은 거의 그대로였다. BCG 실험과 같은 방향의 결과가 전혀 다른 직무에서 다시 나온 것이다.
연구진은 이 차이를 지식이 옮겨 가는 방식으로 설명한다. 우수 상담원이 쓰던 응대 방식이 AI 에 담겨 초보에게 전해졌다는 해석이다. 영상은 맛집 사장님의 비법 노트를 신입 직원이 옆에 펴 놓고 일하는 장면에 빗댄다. 숙련자는 이미 그 노트를 머릿속에 갖고 있으니 새로 얻을 것이 적다.
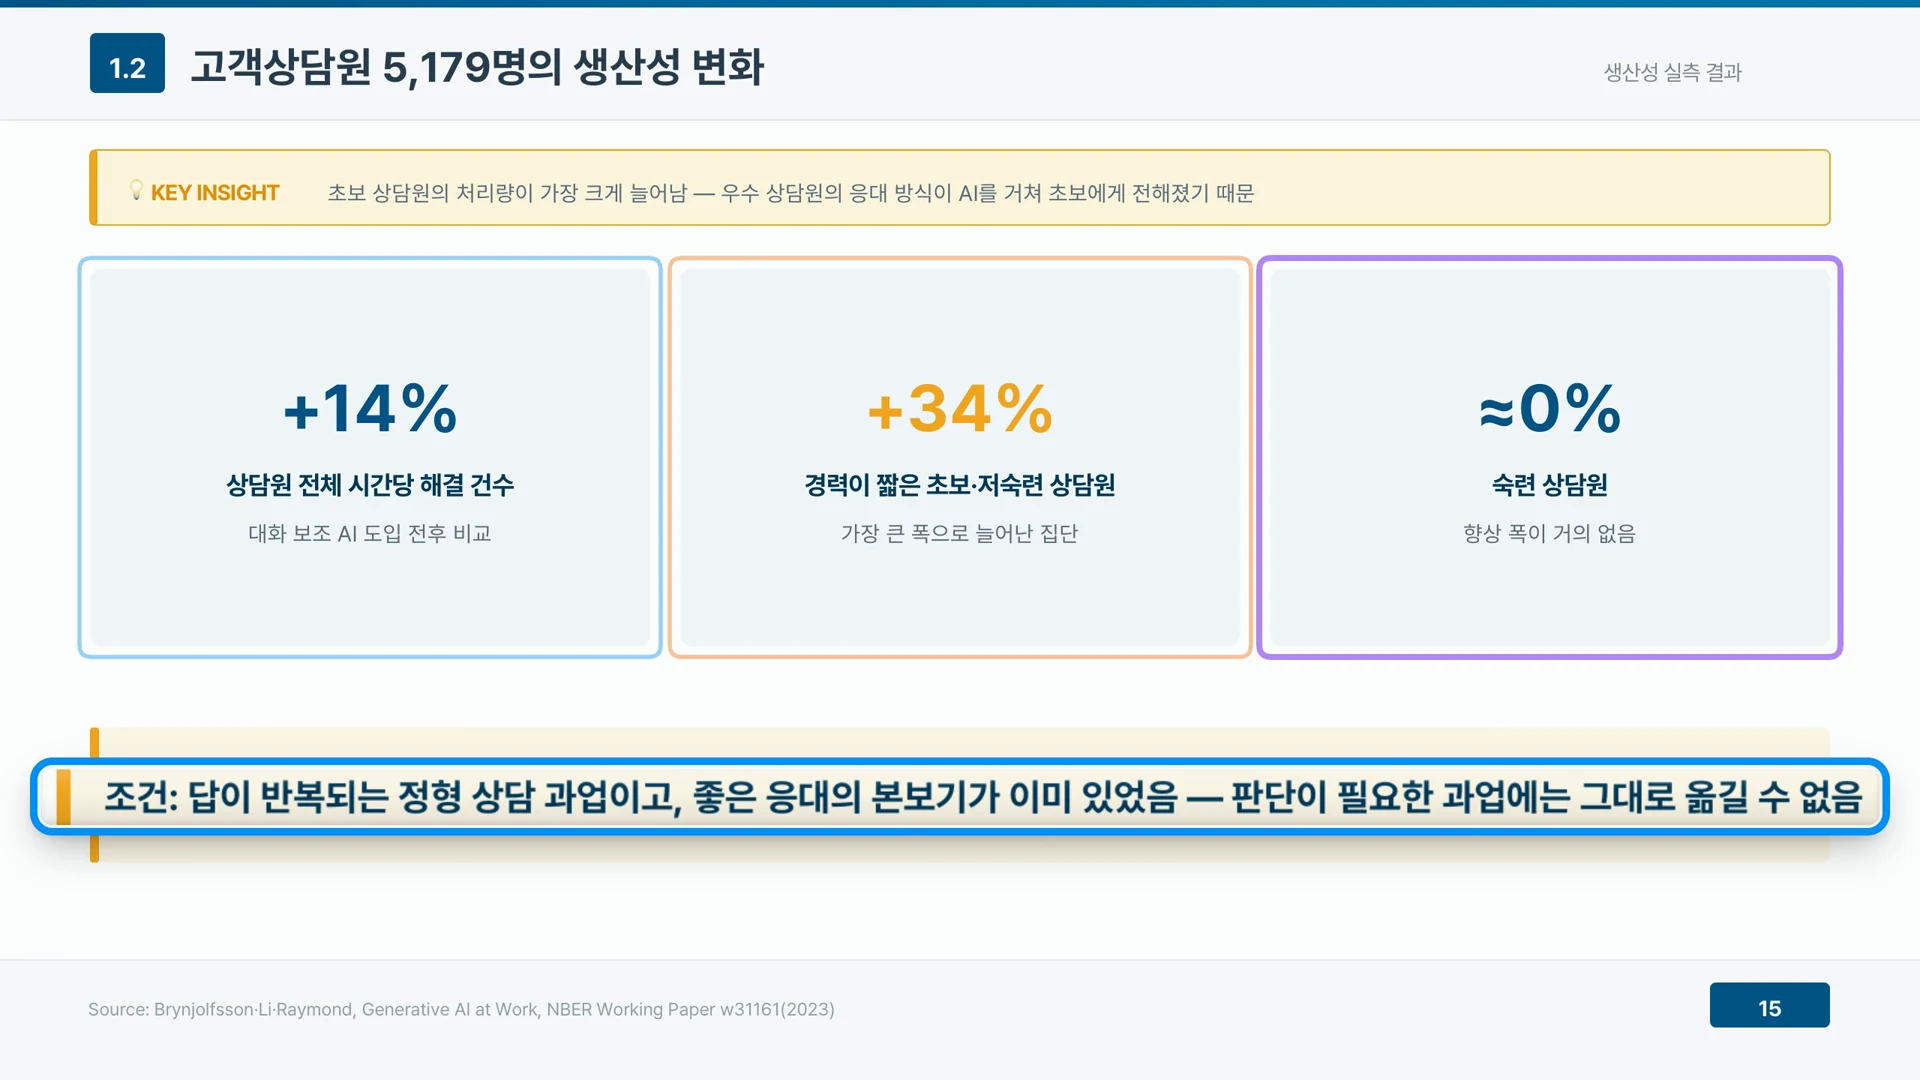
▲ 고객상담원 5,179명 — 초보는 34%, 숙련자는 거의 0% (영상 3:14)
다만 영상은 조건을 분명히 단다. 답이 반복되는 정형 상담이었고, 좋은 응대의 본보기가 이미 있었다. 판단이 필요한 일에서는 다른 결과가 나온다. 그러니 이 숫자를 “깊이 아는 사람이 덜 필요해졌다”로 읽으면 안 된다. 오히려 AI 생산성을 끌어올린 재료는 숙련자의 노하우였다. 도입 효과를 키우려면 조직 안의 우수 사례를 먼저 모으고 정리해야 한다.
이 사례에서 AI 생산성을 만든 것은 모델 성능보다 우수 상담원의 응대 기록이었다. 조직 안에 좋은 응대 기록, 잘 쓴 보고서, 검증된 장애 대응 절차 같은 본보기가 쌓여 있을수록 AI 가 초보에게 전해 줄 내용도 많아진다. 지식을 문서로 남기는 습관이 곧 AI 생산성의 바탕이 되는 셈이다. 본보기가 없는 업무에 AI 만 붙이면 초보가 따라 할 기준 자체가 없다.
체감 속도와 실측 시간의 차이
영상 제목이 된 장면이 여기다. 연구 기관 METR 이 2025년에 공개한 무작위 대조 실험에서 숙련된 오픈소스 개발자 16명이 자기 저장소의 실제 작업을 했다. 작업마다 AI 사용 허용 여부를 무작위로 정했는데, AI 를 허용한 작업이 오히려 19% 더 오래 걸렸다. 그런데 개발자 본인은 20% 빨라졌다고 답했다.
체감과 실측이 반대 방향으로 40%포인트 가까이 벌어졌다. 영상은 새 운동화를 신으면 왠지 빨리 달린 것 같지만 기록을 재 보면 그대로인 상황에 빗댄다. AI 와 대화하며 코드가 빠르게 생성되는 경험은 일이 빨라진다는 인상을 주지만, 그 결과를 읽고 고치고 검증하는 시간까지 더하면 계산이 달라진다.
이 실험의 대상이 초보가 아니라 자기 저장소를 오래 다뤄 온 숙련 개발자였다는 점도 눈여겨볼 대목이다. 앞의 두 연구에서 숙련자의 AI 생산성 효과가 가장 작았던 것과 같은 흐름으로 읽을 수 있다. 이미 속속들이 아는 작업에서는 AI 가 내놓는 제안을 검토하는 비용이 직접 고치는 비용보다 커질 수 있다.
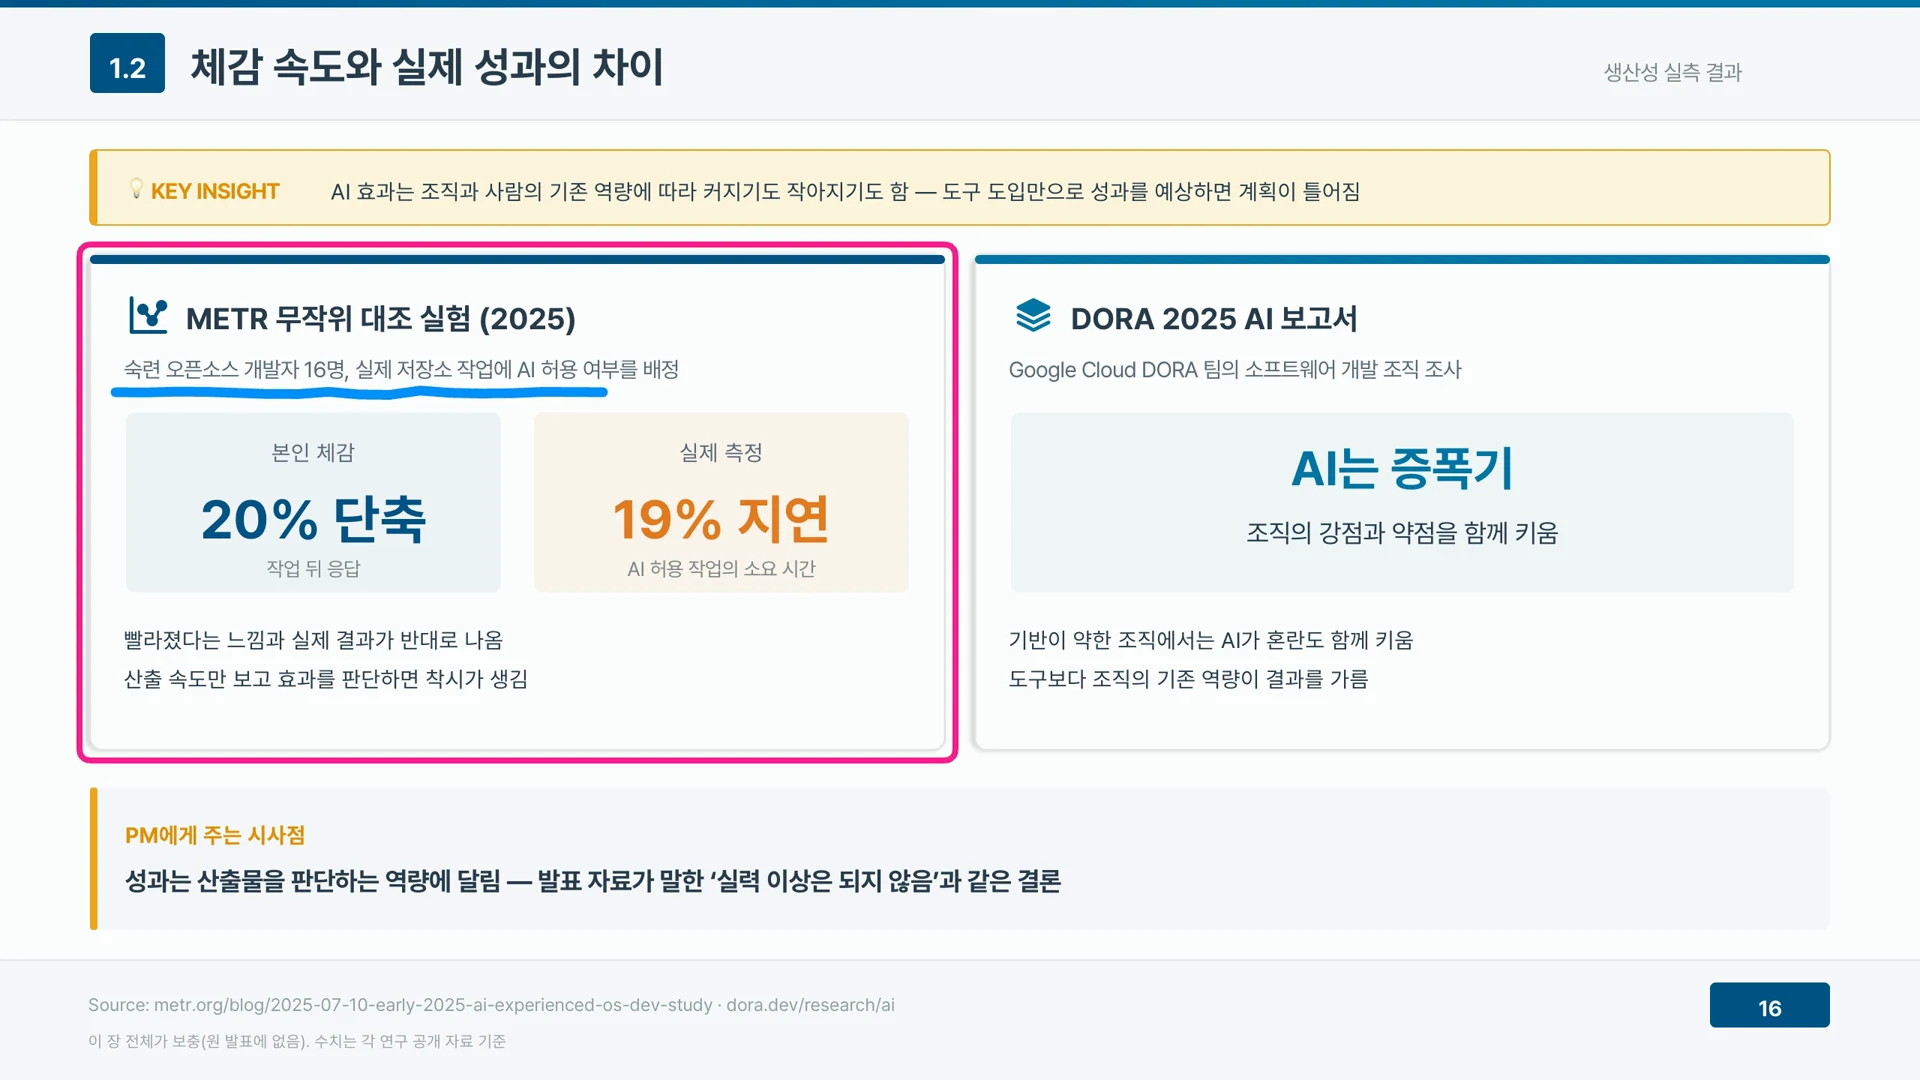
▲ 체감 20% 단축, 실측 19% 지연 — METR 실험과 DORA 의 ‘증폭기’ 관점 (영상 3:36)
같은 화면 오른쪽에는 구글 클라우드 DORA 팀의 관점이 함께 나온다. DORA 는 AI 를 조직의 강점과 약점을 함께 키우는 증폭기로 본다. 효과가 조직과 사람의 기존 역량에 따라 커지기도, 작아지기도 한다는 뜻이다. 영상은 이를 두고 “도구만 들이면 성과가 날 거라 기대하면 계획이 틀어진다”고 정리한다. AI 생산성을 판단할 때 사용자 설문만으로 결론을 내리면 안 되는 까닭이 여기 있다. 처리 시간·결함률 같은 실측 지표를 도입 전부터 함께 재야 한다.
측정이 거창할 필요는 없다. 같은 유형의 작업을 AI 를 쓴 경우와 쓰지 않은 경우로 나눠 몇 주 동안 처리 시간과 수정 횟수를 기록하는 것만으로도 체감과 실측의 차이를 확인할 수 있다. METR 실험이 작업마다 AI 사용 여부를 무작위로 정한 것도 같은 원리다. 비교할 기준선이 없으면 어떤 숫자도 해석할 수 없다.
개인은 빨라졌는데 조직은 아직인 구조
업계 조사는 개인과 조직 사이의 간극을 보여준다. 2025년 구글 DORA 보고서에 따르면 개발 실무자의 90%가 업무에 AI 를 쓴다. 2024년 76%에서 올랐고, 조사 대상은 약 5,000명이었다. 새 코드를 쓰고, 기존 코드를 고치고, 리뷰하고, 문서와 테스트 케이스를 만드는 데 AI 를 쓴다. 도움을 받는 단계를 넘어 함께 일하거나 맡기는 단계로 옮겨 가는 중이다.
그런데 개인 효과는 큰데 조직 성과는 그만큼 오르지 않았다. 결과물을 고객에게 내보내는 처리량은 전년의 감소에서 소폭 증가로 돌아섰지만, 변경 실패와 재작업 같은 불안정성은 늘었다. 한 사람 한 사람의 AI 생산성이 올라도 팀 단위 흐름이 그것을 받아내지 못한 것이다.
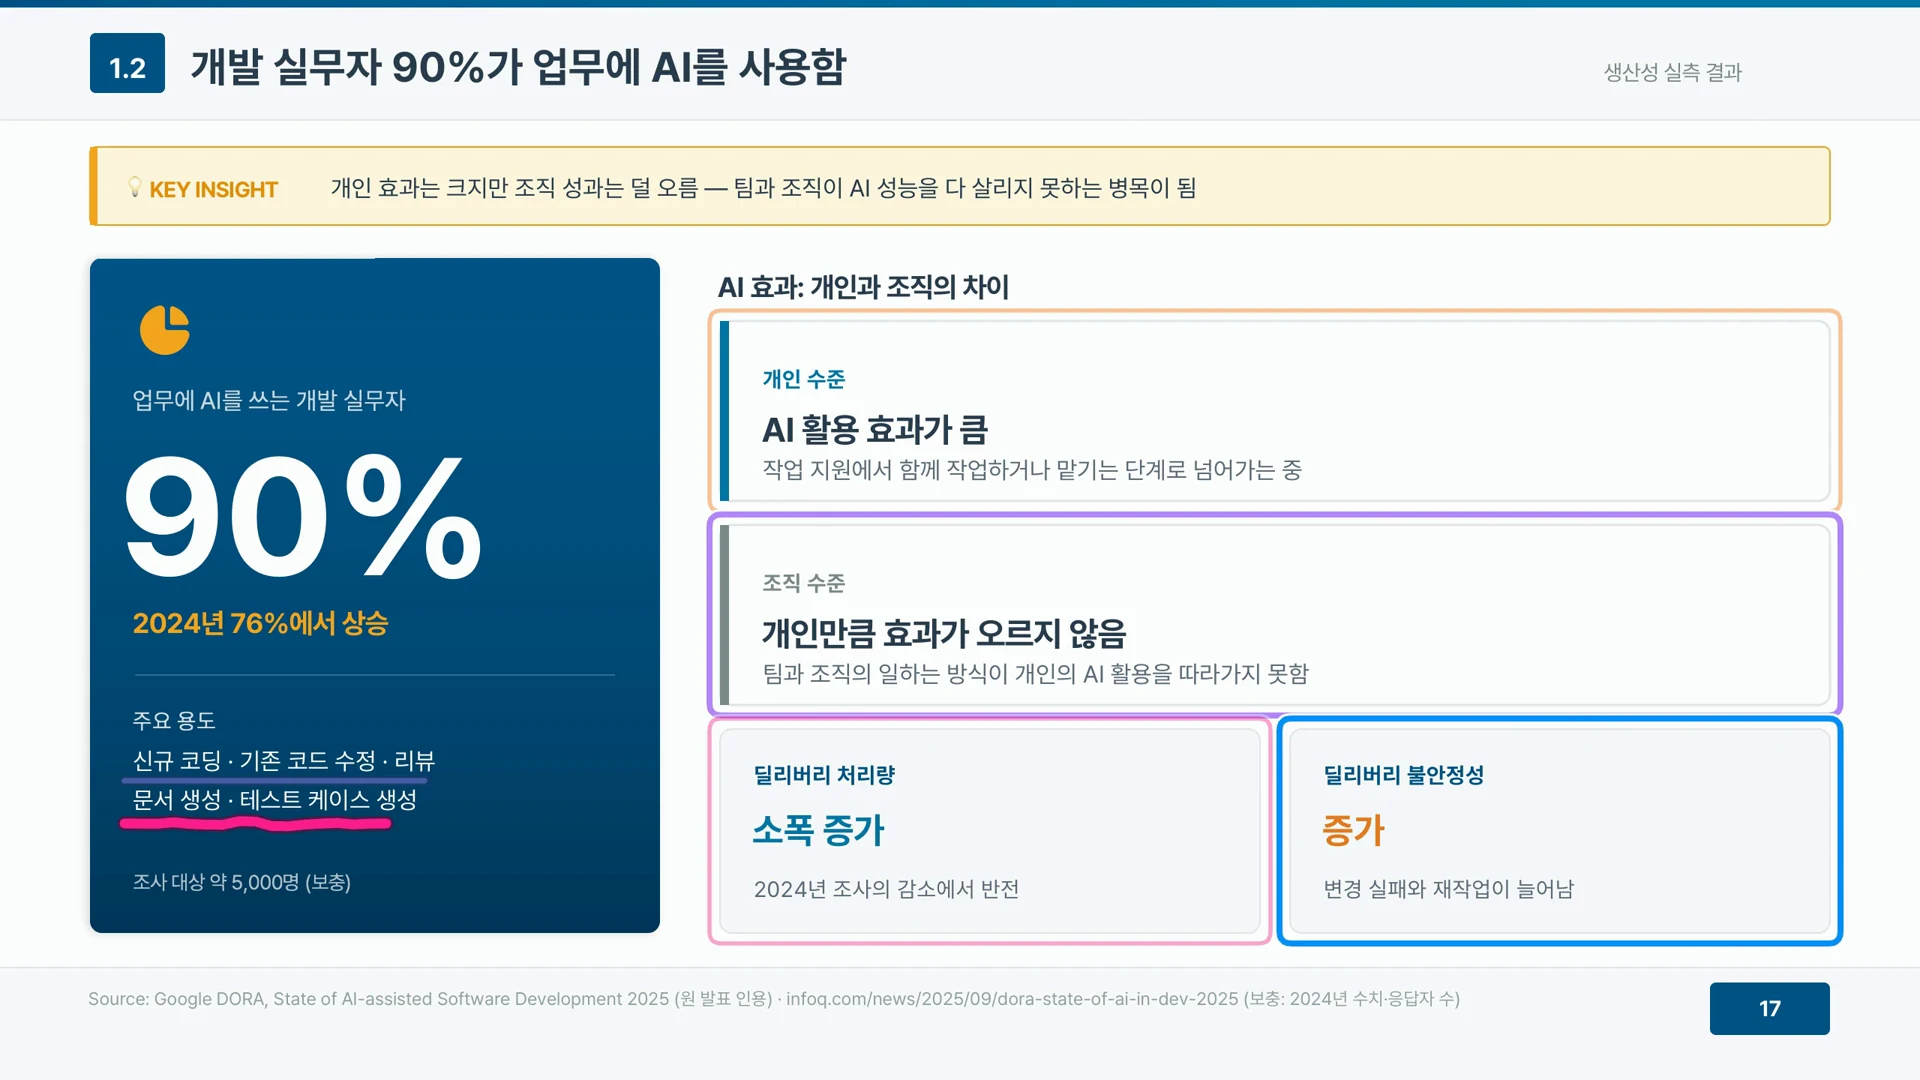
▲ 개발 실무자 90% 가 AI 사용 — 개인은 빨라졌는데 조직은 아직 (영상 4:58)
영상은 이어달리기에 빗댄다. 선수 한 명 한 명은 빨라졌는데 바통 넘기기가 서툰 팀이라는 것이다. 팀과 조직이 AI 성능을 다 살리지 못하는 병목이 되고 있다는 해석이다. 개인이 코드를 두 배로 만들어도 리뷰·테스트·배포 단계가 그대로면 대기열만 길어진다. 조직은 AI 도입과 함께 검토 기준, 협업 순서, 품질 확인 방식을 다시 설계해야 한다.
AI 생산성을 조직 성과로 바꾸려면 측정 단위부터 바꿔야 한다. 한 사람이 하루에 만든 결과물의 양이 아니라, 요청이 들어와 고객에게 전달되기까지 걸린 시간과 그사이 되돌린 변경의 비율을 함께 측정해야 한다. 개인 지표만 보면 성과가 오른 것처럼 보이지만, 팀 지표에서는 불안정성이 먼저 드러난다.
신입 채용의 현관문이 좁아지는 흐름
노동시장에서는 이미 신호가 보인다. 앤트로픽이 2026년 6월 사용자 약 9,700명을 조사했더니, 본인 실직 가능성이 높다고 답한 사람은 약 10%뿐이었다. 속도가 빨라졌다는 응답 86%, 업무 범위가 넓어졌다는 응답 82%도 함께 인용되는데, 영상은 이 두 수치를 일차 출처에서 확인하지 못했다고 밝힌다. 또 응답자가 클로드 개인 계정 사용자라 낙관 쪽으로 치우칠 수 있다는 점도 덧붙인다.
후배 이야기가 되면 답이 달라진다. 응답자 3분의 1 이상이 신입의 1년 안 실직 확률을 60% 이상으로 봤다. 스탠퍼드 연구진은 AI 노출이 큰 직종에서 22~25세 고용이 상대적으로 13% 줄었다고 분석했다. 자기 자리는 안전하다고 느끼면서도 경력 첫 단계는 좁아지고 있다고 보는 것이다. 조사 대상과 방식이 다른 두 결과지만 방향은 같다. 당장 자기 일자리에 대한 불안은 크지 않은데, 경력을 막 시작하는 사람의 자리부터 영향이 나타난다.
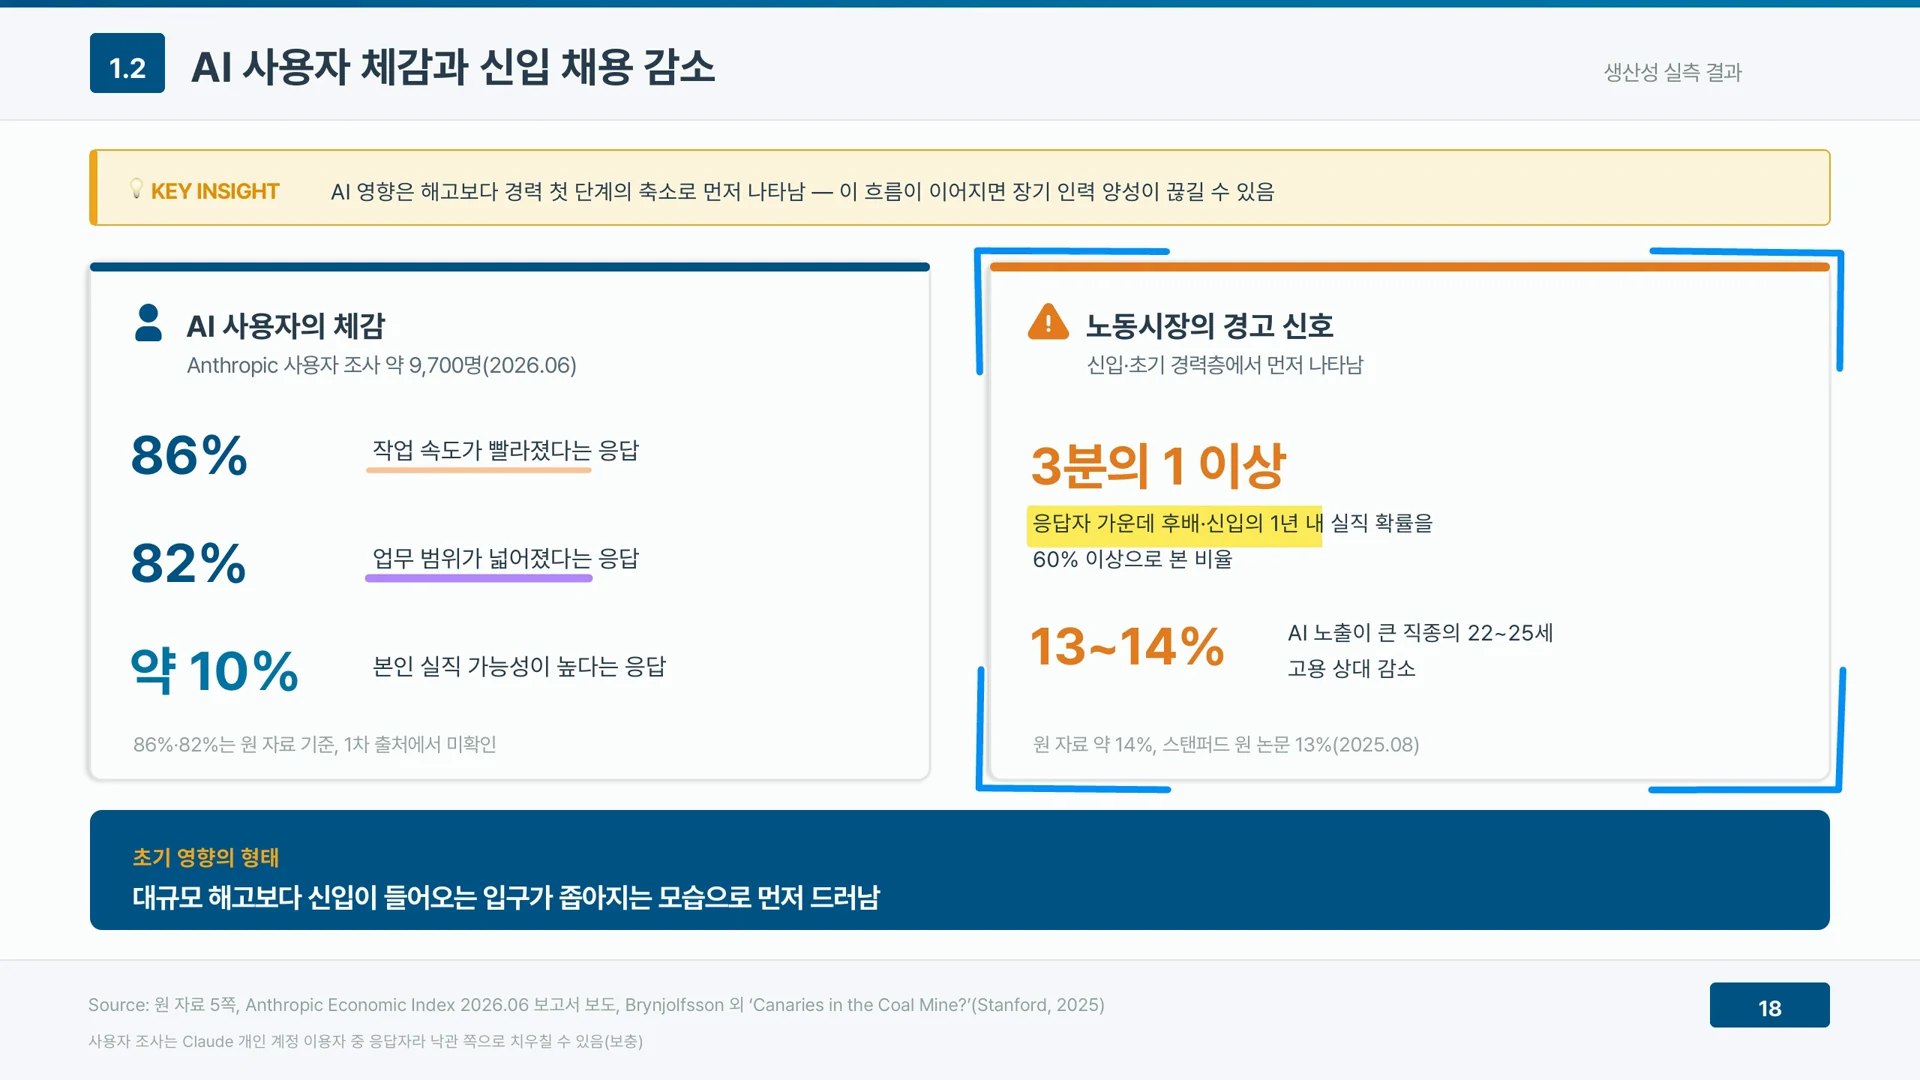
▲ 사용자는 낙관적인데 신입 채용이 먼저 줄어든다 (영상 5:46)
영상은 회사라는 집의 현관문이 점점 좁아지는 모습에 빗댄다. 대규모 해고보다 신입이 들어오는 입구가 먼저 줄어든다. 문제는 이 흐름이 이어질 때다. 앞의 BCG·상담원 실험이 보여줬듯 AI 생산성을 끌어올린 재료는 숙련자의 판단과 노하우였다. 신입이 경험을 쌓을 자리가 줄면, 몇 년 뒤 그 노하우를 가진 사람이 없어진다. 영상은 긴 안목의 인재 양성이 끊길 수 있다고 경고한다. AI 생산성 논의가 효율에만 머물면 이 비용은 보이지 않는다. 인력 계획을 세울 때 AI 로 줄인 신입 업무를 어떤 학습 경로로 대신할지 함께 결정해야 한다.
AI 생산성을 경영 의제로 다뤄야 하는 기준
마지막 장면은 경제 전체로 시야를 넓힌다. 맥킨지는 생성형 AI 의 경제 효과를 다음처럼 추정했다.
| 구분 | 연간 효과 추정 |
|---|---|
| 생성형 AI 새 활용 사례 | 2.6~4.4조 달러 |
| 생성형 AI 업무 생산성 전체 | 6.1~7.9조 달러 |
| 기존 AI·분석 기술 가치 | 11~17.7조 달러 |
| 모두 더한 AI 전체 경제 효과 | 17.1~25.6조 달러 |
규모를 실감하기 위해 영상은 한국 경제와 견준다. 한국은행 집계로 2023년 한국 명목 GDP 는 약 1.7조 달러였다. 업무 생산성 효과만으로도 한국 경제 규모의 네 배 안팎이다. 기존 AI 효과에 생성형 AI 가 15~40%를 더하고, 생산성까지 넣으면 35~70%가 더해진다.
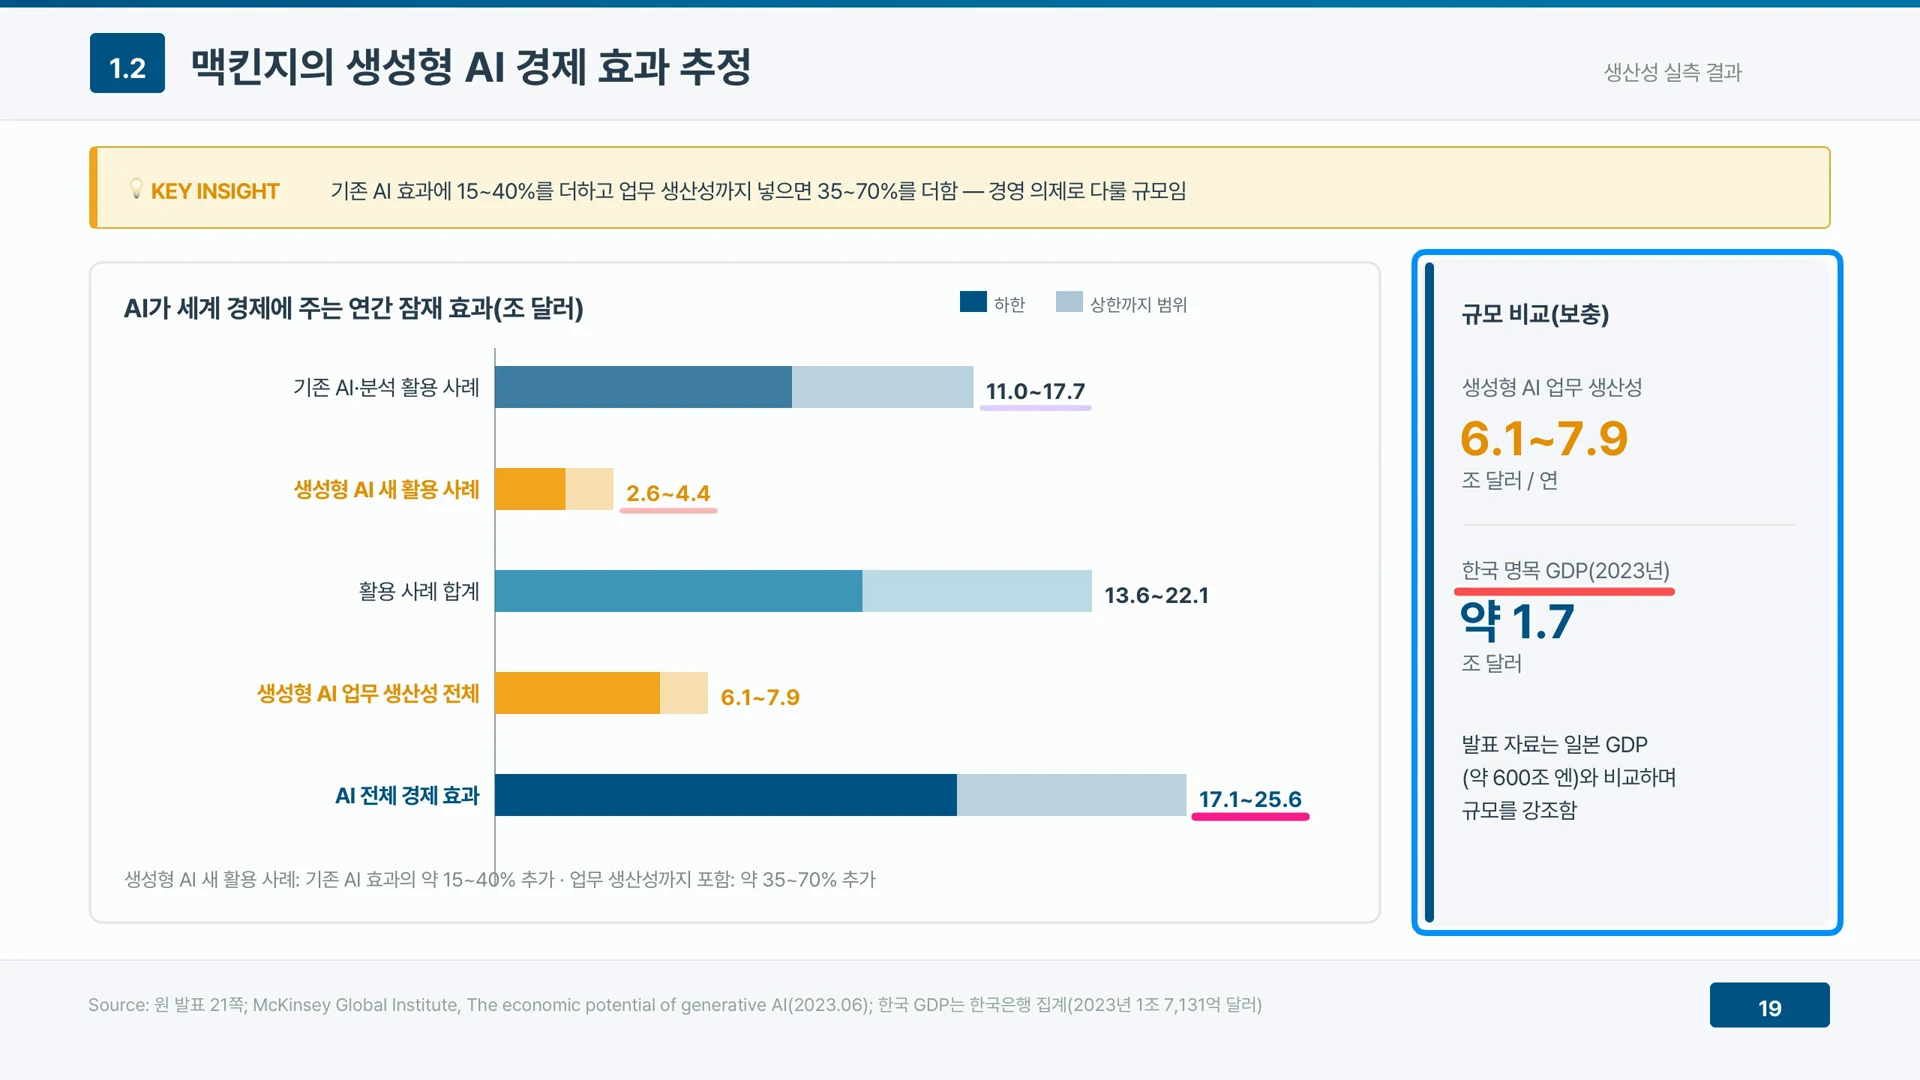
▲ 맥킨지 추정 — 생성형 AI 경제 효과는 한국 GDP 의 네 배 안팎 (영상 6:58)
영상은 이것을 경영 의제로 다뤄야 할 규모라고 정리한다. 동네 가게 매출을 이야기하다가 나라 살림 크기로 단위가 바뀐 셈이다. 이 정도 규모라면 AI 생산성은 개별 부서의 도구 선택이 아니라 전사 전략의 문제가 된다. 앞선 다섯 장면을 함께 놓고 보면 판단 기준이 선다. 과제를 AI 능력 안팎으로 나누고, 숙련자의 본보기를 모으고, 체감 대신 실측으로 재고, 팀의 흐름을 다시 짜고, 신입이 배울 자리를 지키는 것이다.
AI 생산성 수치를 투자 판단에 쓰려면 거시 추정과 현장 실측을 함께 봐야 한다. 거시 숫자는 기회의 크기를, 현장 숫자는 그 기회를 실제로 가져가는 조건을 알려 준다. 둘 중 하나만 보면 기대가 과하거나 투자가 늦어지므로, 두 숫자를 함께 점검해야 한다.
핵심 정리
AI 생산성은 도구가 아니라 과제·사람·조직의 조건이 결정한다.
여섯 갈래의 연구를 나란히 놓으면 공통된 흐름이 보인다. 효과는 기준점이 낮은 사람과 정형화된 과제에서 크고, 숙련자와 판단이 필요한 과제에서는 작거나 거꾸로 나온다. 그리고 개인의 이득은 조직의 흐름을 바꾸지 않으면 성과로 이어지지 않는다.
| 연구 | 대상 | 핵심 숫자 | 조직이 읽어야 할 점 |
|---|---|---|---|
| 하버드·BCG 실험 | 컨설턴트 758명 | 과제 +12.2%, 시간 −25.1%, 품질 +40%, 범위 밖 정답률 −19%p | AI 능력 안팎으로 과제를 먼저 나눈다 |
| 고객상담 연구 | 상담원 5,179명 | 평균 +14%, 초보 +34%, 숙련 ≈0% | 정형 업무와 우수 사례가 있을 때 효과가 크다 |
| METR 무작위 대조 실험 | 숙련 개발자 16명 | 체감 20% 단축, 실측 19% 지연 | 설문 대신 실측 지표로 판단한다 |
| DORA 2025 보고서 | 개발 실무자 약 5,000명 | AI 사용 90%, 조직 불안정성 증가 | 팀 흐름과 검토 방식을 다시 설계한다 |
| 앤트로픽·스탠퍼드 | 사용자 약 9,700명 외 | 22~25세 고용 13% 감소 | 신입의 학습 경로를 따로 지킨다 |
| 맥킨지 추정 | 세계 경제 | 생산성 효과 6.1~7.9조 달러 | 전사 경영 의제로 다룬다 |
자주 묻는 질문
AI 를 쓰면 생산성이 실제로 오르나요?
AI 생산성은 AI 능력 범위 안의 과제에서 오른다. BCG 실험에서 과제 수 12.2%, 속도 25.1%, 품질 40% 이상 개선됐다. 다만 같은 실험에서 AI 능력 밖 과제의 정답률은 19%포인트 떨어졌다. 과제가 AI 에 맞는지 먼저 가려야 효과가 남는다.
AI 효과는 누구에게 가장 크게 나타나나요?
기준 성과가 낮거나 경력이 짧은 사람에게 크다. BCG 실험의 하위 절반은 43%, 상위 절반은 17% 올랐다. 상담원 연구에서도 초보는 34% 늘었고 숙련자는 거의 그대로였다. 우수 사례가 AI 를 거쳐 초보에게 전해진 결과로 해석된다.
개발자가 느끼는 속도와 실제 속도는 왜 다른가요?
METR 실험에서 개발자는 20% 빨라졌다고 느꼈지만 실측은 19% 느렸다. 코드가 빠르게 생성되는 경험이 빠르다는 인상을 남기지만, 결과를 읽고 고치고 검증하는 시간까지 더하면 계산이 달라진다. 그래서 체감 설문보다 처리 시간 같은 실측 지표가 필요하다.
개인 생산성이 올랐는데 조직 성과는 왜 그대로인가요?
팀과 조직의 흐름이 병목이 되기 때문이다. DORA 2025 보고서에서 개발 실무자 90%가 AI 를 쓰지만 처리량은 소폭 증가에 그치고 불안정성은 늘었다. 개인이 더 많이 만들어도 리뷰·테스트·배포 단계가 그대로면 대기열만 길어진다.
AI 가 일자리에 주는 영향은 어디서 먼저 나타나나요?
대규모 해고보다 신입 채용에서 먼저 나타난다. 스탠퍼드 연구진은 AI 노출이 큰 직종에서 22~25세 고용이 상대적으로 13% 줄었다고 분석했다. 신입이 경험을 쌓을 자리가 줄면 장기적으로 숙련 인력을 키우는 경로가 약해질 수 있다.
AI 생산성 효과는 경제적으로 어느 정도 규모인가요?
맥킨지는 생성형 AI 의 업무 생산성 효과를 연 6.1~7.9조 달러로 추정한다. 2023년 한국 명목 GDP 약 1.7조 달러의 네 배 안팎이다. 기존 AI 와 분석 기술까지 더하면 17.1~25.6조 달러로, 전사 경영 의제로 다뤄야 할 규모다.
참고 리소스
- AI 시대 일하는 법 EP.02 원본 영상 — 클라우드네이티브TV
- AI 시대 어떻게 일할 것인가? 발표자료 다운로드 — MSAP.ai
- AI 시대 일 잘하는 사람의 다섯 가지 습관 — MSAP.ai
- AI 시대 엔지니어의 문제 정의 역량 — MSAP.ai
- AX(AI 전환)란 무엇인가 — MSAP.ai
- AX 추진 전략과 로드맵 — MSAP.ai
- AI 도입 로드맵 6단계 — MSAP.ai
- PoC부터 운영까지 AI 도입 실패 7가지 점검 — MSAP.ai
- Navigating the Jagged Technological Frontier — Harvard Business School
- Generative AI at Work — NBER
- Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity — METR
- 2025 State of AI-assisted Software Development — Google Cloud DORA
- Canaries in the Coal Mine — Stanford Digital Economy Lab
- The economic potential of generative AI — McKinsey
다음 단계
AI 생산성은 과제를 어떻게 나누고, 우수 사례를 얼마나 모았고, 팀의 흐름을 어떻게 바꿨는지에 따라 달라집니다. 우리 조직의 AI 도입 효과를 실측 기준으로 점검하려면 아래에서 시작하세요.