- 발표자료 다운로드 — 업무 정의서부터 파일럿 7단계까지 45쪽
- 발표 영상으로 먼저 보기 — AI Agent 도구 시장과 AAS의 위치
- 이 발표자료가 답하는 여섯 가지 질문
- AI Agent 예산은 GPU보다 업무 정의서에 먼저 쓴다
- 스킬은 프론티어 AI가 만들고 매일 실행은 작은 로컬 모델이 맡는다
- 업무 정의서 8항목 중 6항목이 결정적 코드로 바뀐다
- SKILL.md는 명령 한 줄과 금지 사항만 담아 60줄 이내로 쓴다
- 개발 환경과 운영 환경 사이를 넘는 것은 스킬 묶음 하나뿐이다
- 폐쇄망 반입은 여섯 단계를 거치고 해시로 승인 없는 변경을 찾는다
- 합격 판정은 프론티어 AI가 아니라 운영 모델로 내린다
- 결정적 코드로 다시 쓰라는 한 줄 지시로는 확인 게이트가 모델에 남는다
- 활성 3B 급 MoE 모델로 바꾸면 같은 서버에서 초당 토큰이 약 세 배다
- 코드로 옮긴 뒤 남는 세 공백은 훅으로 모델 밖에서 막는다
- CRM 조회는 394초 오답에서 14초 정답으로 바뀌었다
- 영업기회 등록은 진행기가 여덟 단계를 쥐고 사람은 두 곳만 본다
- 스킬 합격선은 도구 호출 3회 이하, 수 분 이내 응답, 정답이다
- 파일럿은 업무 하나와 프로파일 하나로 시작하고 GPU 규모는 마지막에 정한다
- 핵심 정리
- 자주 묻는 질문
- AI 에이전트(AI Agent)란? 정의·종류·사례와 기업 도입 기준
- 참고 리소스
- 자료 다운로드
발표자료 다운로드 — 업무 정의서부터 파일럿 7단계까지 45쪽
전체 45장, PDF로 45쪽이다. 업무 정의서와 그 산출물, 개발·운영 환경 분리와 MCP 제작 절차, 작은 모델용 스킬 작성 지시와 GPU 설계, 스킬 작성 사례와 합격 기준, 남은 한계와 파일럿 도입 순서의 5개 파트로 나뉜다.
사내에서 운영 중인 CRM 조회, 영업기회 등록, 견적 에이전트를 개선 전후로 잰 수치와 공개 모델 자료를 근거로 삼았다. 같은 내용을 문서로 길게 풀어 쓴 업무전문가가 만드는 AI 에이전트 개발 가이드 백서도 함께 공개돼 있다. AAS 도입을 검토하는 IT 의사결정권자와 구축을 맡을 IT 담당자가 함께 볼 수 있도록 전체 발표자료를 PDF로 공개한다.
MSAP.ai 백서 구독하기🔔
새로운 백서 소식을 가장 먼저 만나보세요!
MSAP.ai 가 전하는 AI 기반 운영 인사이트와 최신 백서 소식을 가장 빠르게 받아보실 수 있습니다.
구독해 주시면 더 좋은 콘텐츠로 보답하겠습니다.🙏
발표 영상으로 먼저 보기 — AI Agent 도구 시장과 AAS의 위치
이 발표자료를 녹화한 영상은 아직 없다. 대신 같은 제품을 다룬 클라우드네이티브TV 영상인 AI Agent 오픈소스 관리 도구 편을 소개한다.
이 발표자료가 스킬을 설계하고 시험하는 방법을 다룬다면 이 영상은 도구 시장의 여섯 가지 유형 안에서 AAS가 어디에 서는지를 설명한다. 아래 영상은 이 발표자료의 녹화본이 아니며 MSAP.ai AAS를 소개한 별도 영상이다.
영상에서 다루는 순서는 다음과 같다.
- 만들기와 지켜보기, 운영자와 업무 담당자로 나눈 도구 여섯 가지 구분
- 네 가지 도입 조건을 함께 갖춘 도구가 드문 이유
- 국가 망 보안 기준과 조직 안 설치가 도구 선택에 주는 영향
- AAS가 맞는 조직의 두 가지 조건
AI 에이전트의 정의와 종류부터 정리하려면 AI 에이전트란 무엇인가를 함께 보면 된다.
이 발표자료가 답하는 여섯 가지 질문
- AI Agent 예산은 GPU와 업무 정의 중 어디에 먼저 써야 하는가
- 코딩을 모르는 업무 전문가가 무엇을 써야 스킬이 만들어지는가
- 프론티어 AI로 만들면서 폐쇄망을 그대로 유지할 수 있는가
- 활성 3B 급 작은 모델로도 업무 결과가 나오는가
- 만든 스킬이 쓸 만한지는 무엇으로 판정하는가
- 파일럿은 어떤 업무로 어떤 순서로 시작하는가
AI Agent 예산은 GPU보다 업무 정의서에 먼저 쓴다
모델과 GPU부터 고르면 장비를 설치한 뒤에야 시범 업무를 찾고, 프롬프트를 보강하고, 결과를 재확인하고, 실패 원인을 추적하는 비용이 뒤따른다. 업무 정의를 먼저 하면 첫 결정이 맡길 반복 업무와 정답 기준이 되고, 첫 성과는 스킬 제작 직후 운영 모델 시험으로 바로 측정된다.
답을 만드는 디코드 단계의 지연은 메모리 대역폭이 좌우하므로 장비를 늘려도 모델 호출 횟수는 줄지 않는다. 그래서 GPU 규모는 업무 정의서로 시험한 뒤 정해도 늦지 않다.
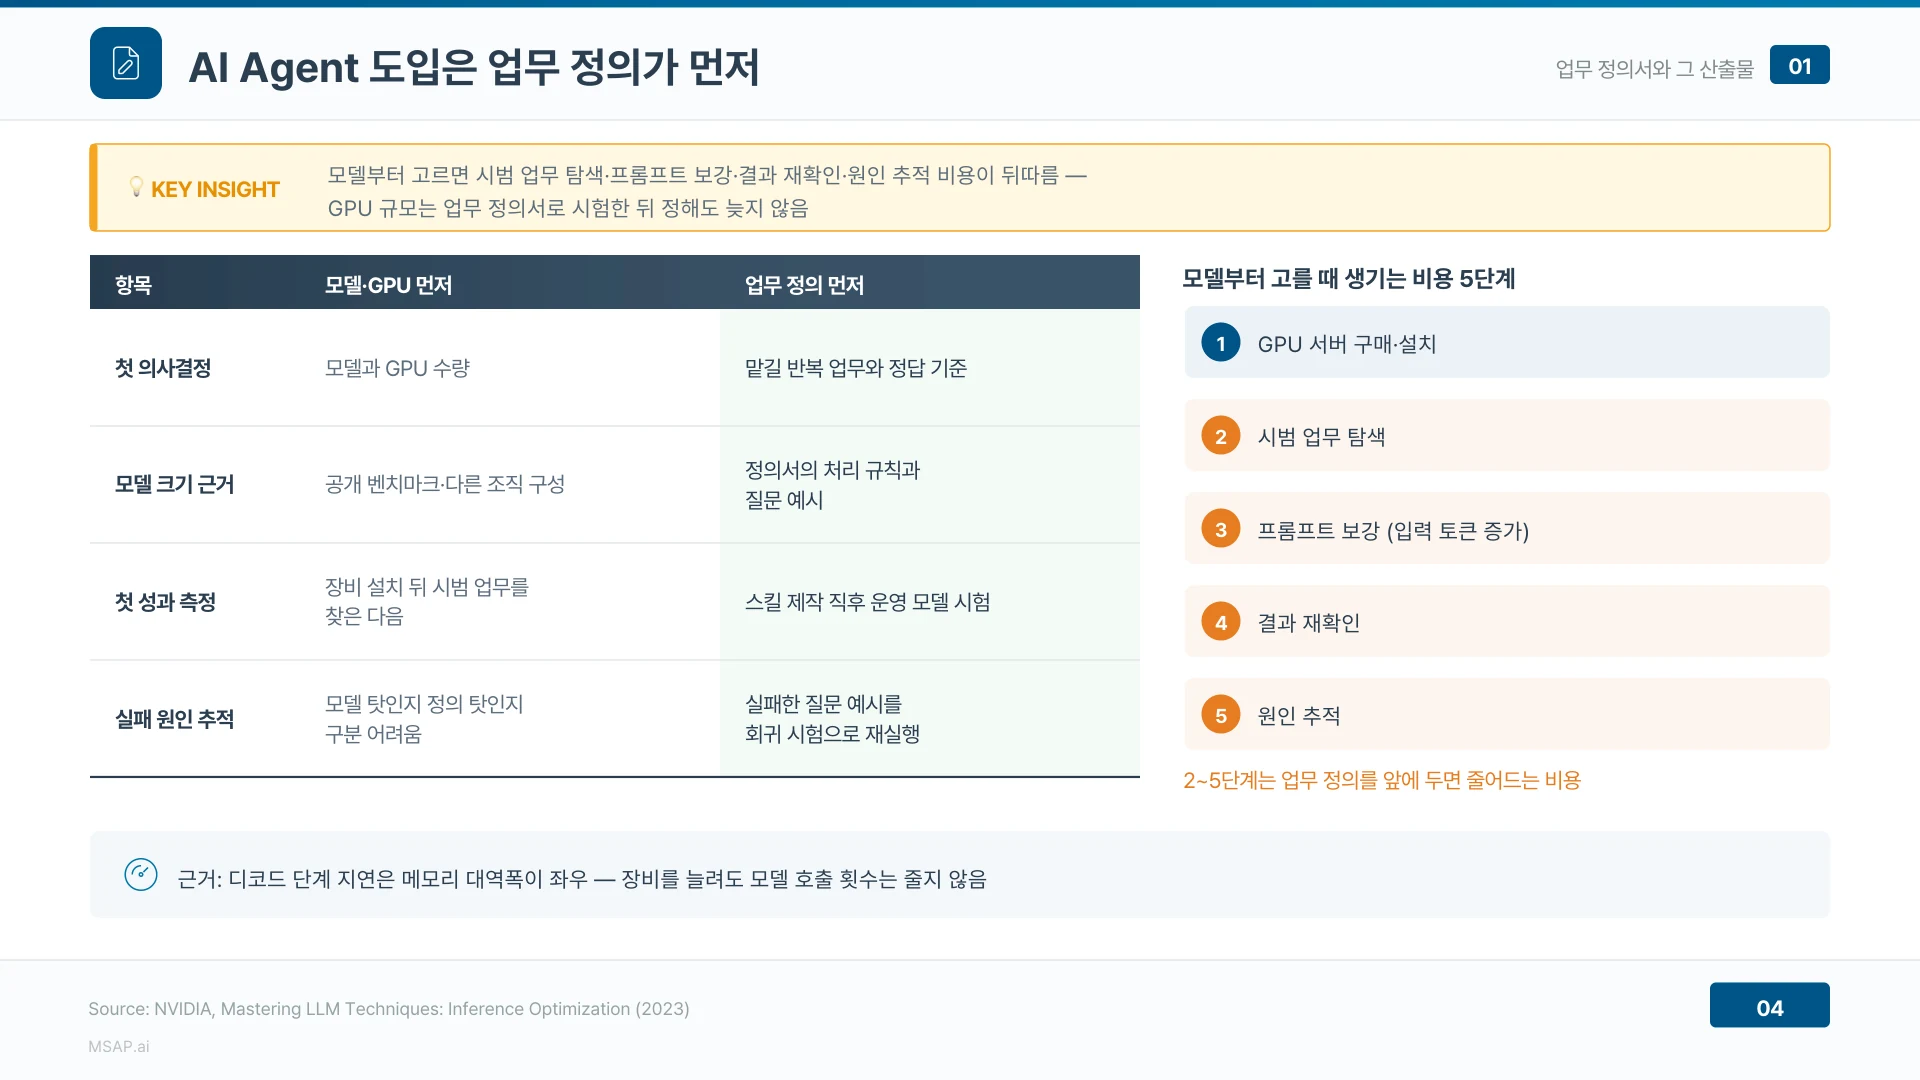
▲ AI Agent 예산은 GPU보다 업무 정의서에 먼저 쓴다 (발표자료 4쪽)
스킬은 프론티어 AI가 만들고 매일 실행은 작은 로컬 모델이 맡는다
스킬을 만드는 일과 매일 실행하는 일은 필요한 능력이 다르다. 인터넷 쪽 개발 환경에서는 업무 전문가가 프론티어 AI와 대화하고, 프론티어 AI는 MCP로 MSAP.ai AAS MCP 서버에 연결해 스킬을 만든다.
폐쇄망 운영 환경에서는 업무 담당자의 요청이 AAS 콘솔과 Hermes 프로파일, LiteLLM 게이트웨이를 거쳐 vLLM의 활성 3B 급 MoE 모델에 닿는다. 두 영역을 잇는 것은 운영 쪽 단방향의 스킬 업로드 하나뿐이다.
NVIDIA 연구진도 범용 대화가 꼭 필요한 곳에만 큰 모델을 쓰고 반복 작업은 작은 모델이 맡는 이종 구성을 자연스러운 형태로 본다. 큰 모델은 코드를 만드는 개발 환경에서 한 번 쓰고, 작은 모델은 그 코드를 매일 실행하는 운영 환경에서 쓰는 배치가 비용과 정확도를 함께 맞춘다.
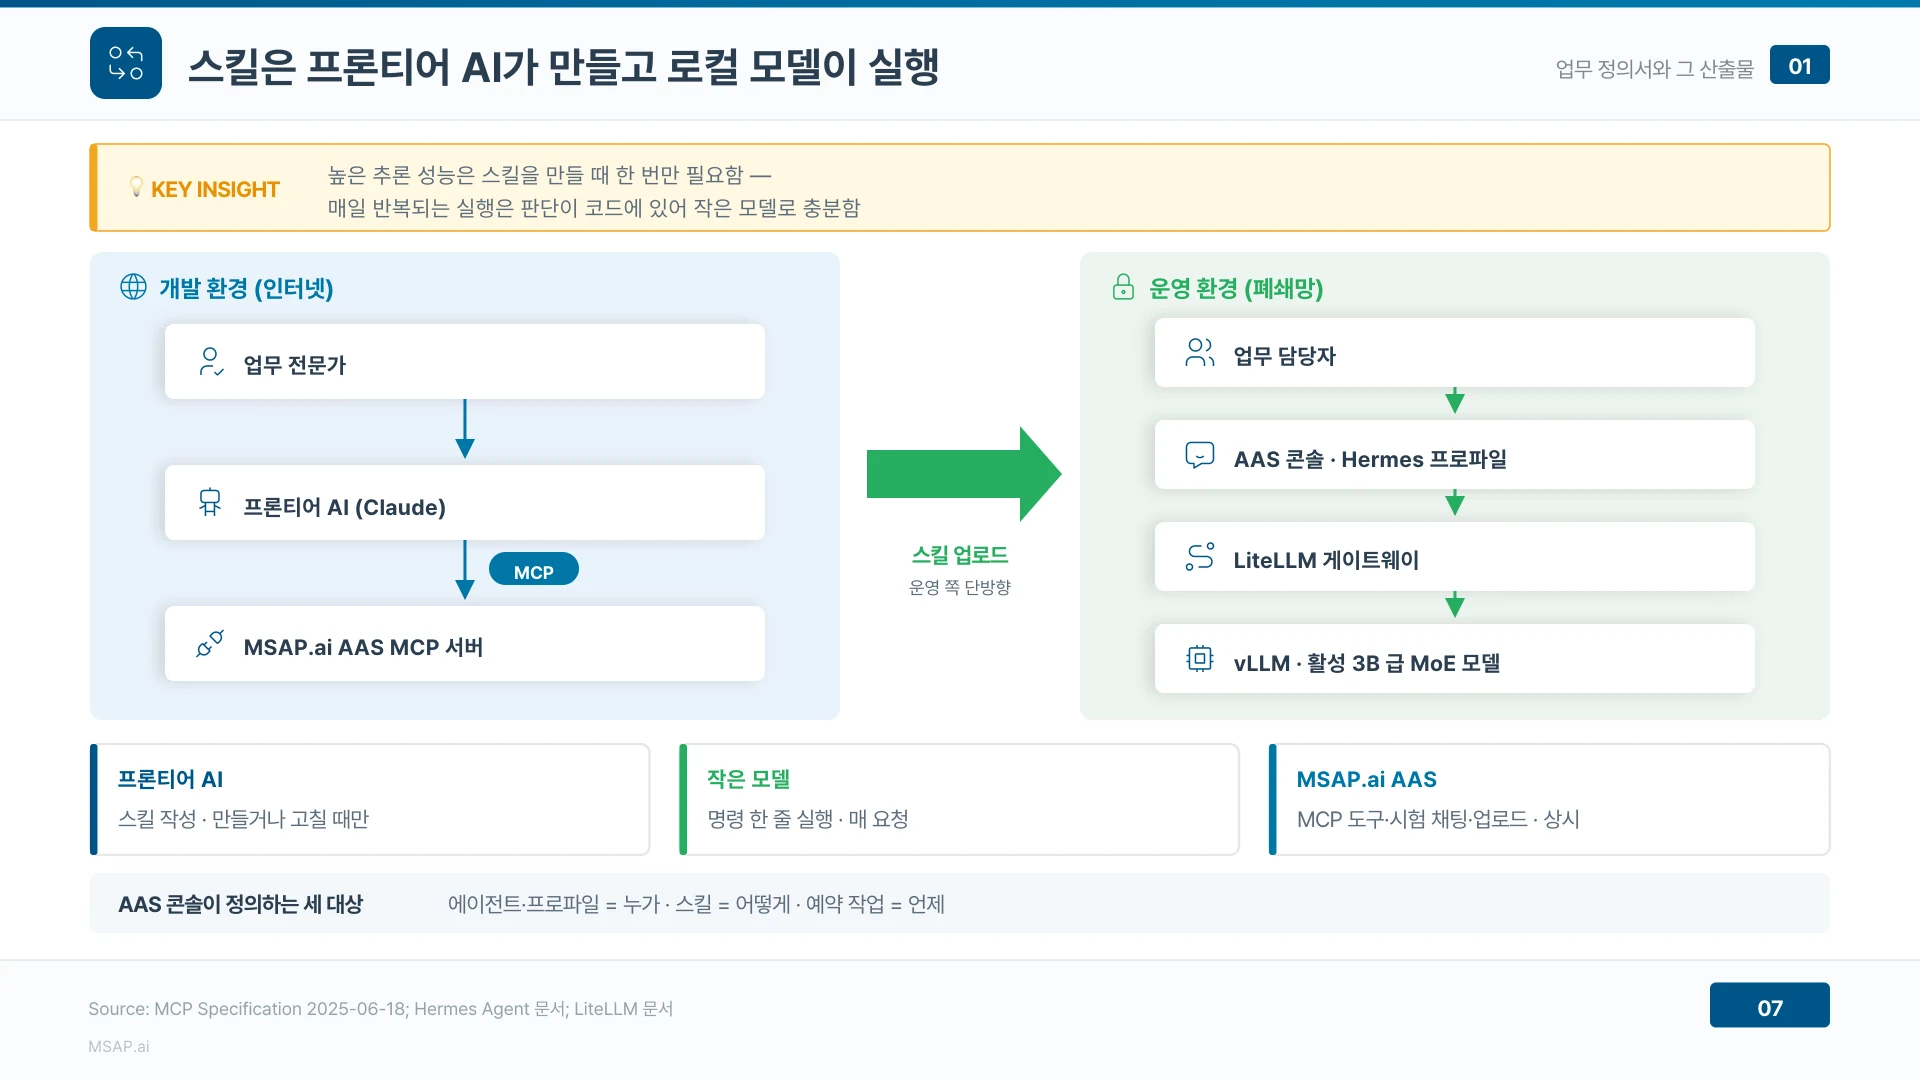
▲ 스킬은 프론티어 AI가 만들고 매일 실행은 작은 로컬 모델이 맡는다 (발표자료 7쪽)
업무 정의서 8항목 중 6항목이 결정적 코드로 바뀐다
업무 문장에 입력값, 처리 규칙, 완료 상태가 다 있어야 코드로 옮길 수 있다. 요즘 진행 중인 큰 건을 알려 달라는 요청은 범위와 기준을 모델이 추측하게 만들지만, 영업 단계가 제안 또는 협상인 영업기회를 예상 금액 큰 순서로 10건이라고 적으면 추측할 곳이 사라진다.
요청 형태는 지시문 해석 규칙표가 되고, 입력값과 처리 규칙, 확인 단계, 완료 상태는 값 추출, 진행, 확인 게이트, 재조회 검증 스크립트가 된다. 질문 예시는 회귀 시험 묶음이 되며 정의서에서 가장 긴 항목이다.
업무 정의서는 프론티어 AI가 스킬을 만들 때 받는 유일한 업무 입력이다. 정의서 항목이 지시문 해석, 결정적 코드, 질문 예시 세 지시와 하나씩 이어지므로, 업무 전문가는 세 지시에 들어갈 재료를 자기 말로 모으기만 하면 된다.
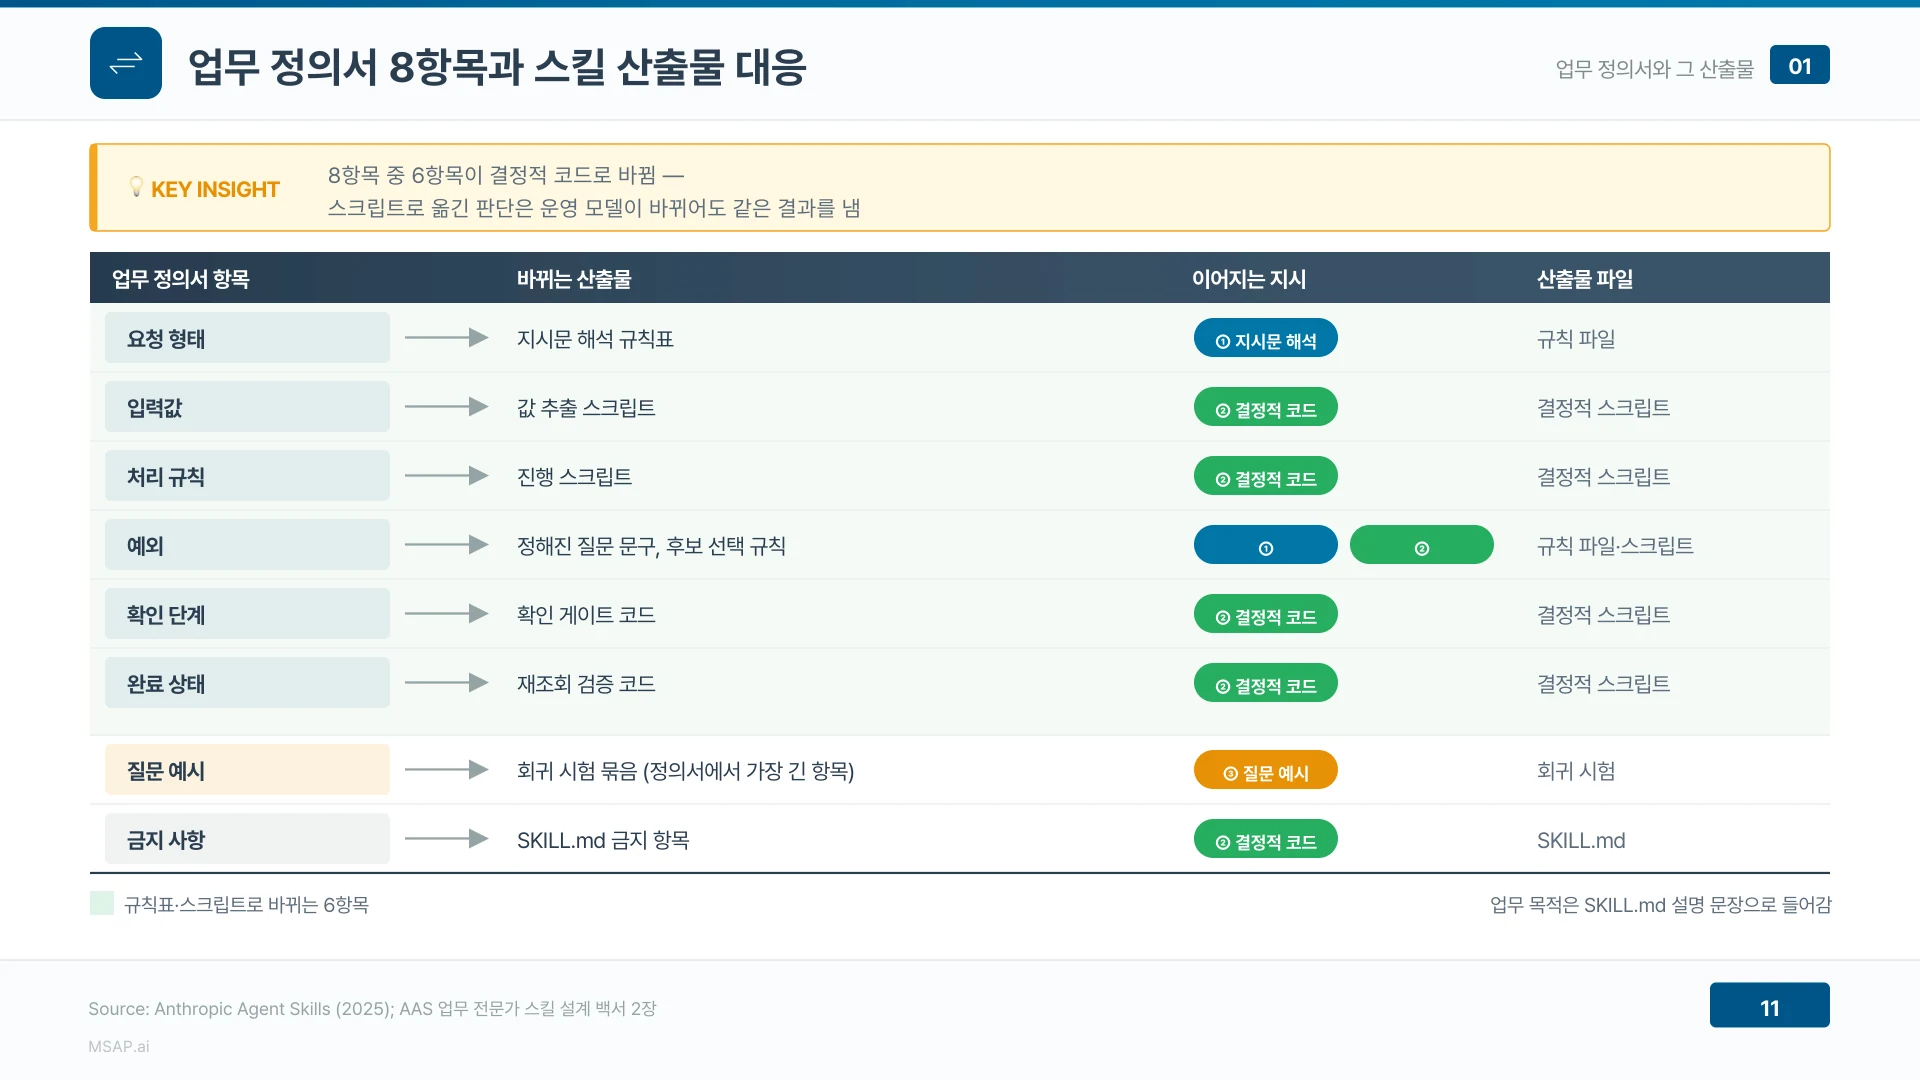
▲ 업무 정의서 8항목 중 6항목이 결정적 코드로 바뀐다 (발표자료 11쪽)
SKILL.md는 명령 한 줄과 금지 사항만 담아 60줄 이내로 쓴다
업무 정의서 한 장은 규칙 파일, 결정적 스크립트, 회귀 시험, 짧은 SKILL.md 네 가지 파일로 바뀐다. 규칙 파일은 스크립트가 읽고, SKILL.md는 운영 모델이 읽는다.
운영 모델은 점진적 공개 3단계로 스킬을 읽는다. 1단계에서 모든 스킬의 이름과 설명을 약 3천 토큰으로 보고, 2단계에서 고른 스킬의 본문을, 3단계에서 필요할 때만 참고 파일을 연다. 그래서 첫 줄 판별 기준을 설명에 직접 적는다.
본문과 규칙 파일을 나눠 두면 운영 중 관리도 쉬워진다. 업무 판단이 대부분 스크립트와 규칙 파일에 있으므로 운영 모델이 SKILL.md를 고쳐 쓰더라도 업무 결과가 바뀌는 범위가 좁고, 원본과 비교해 되돌리기도 쉽다.
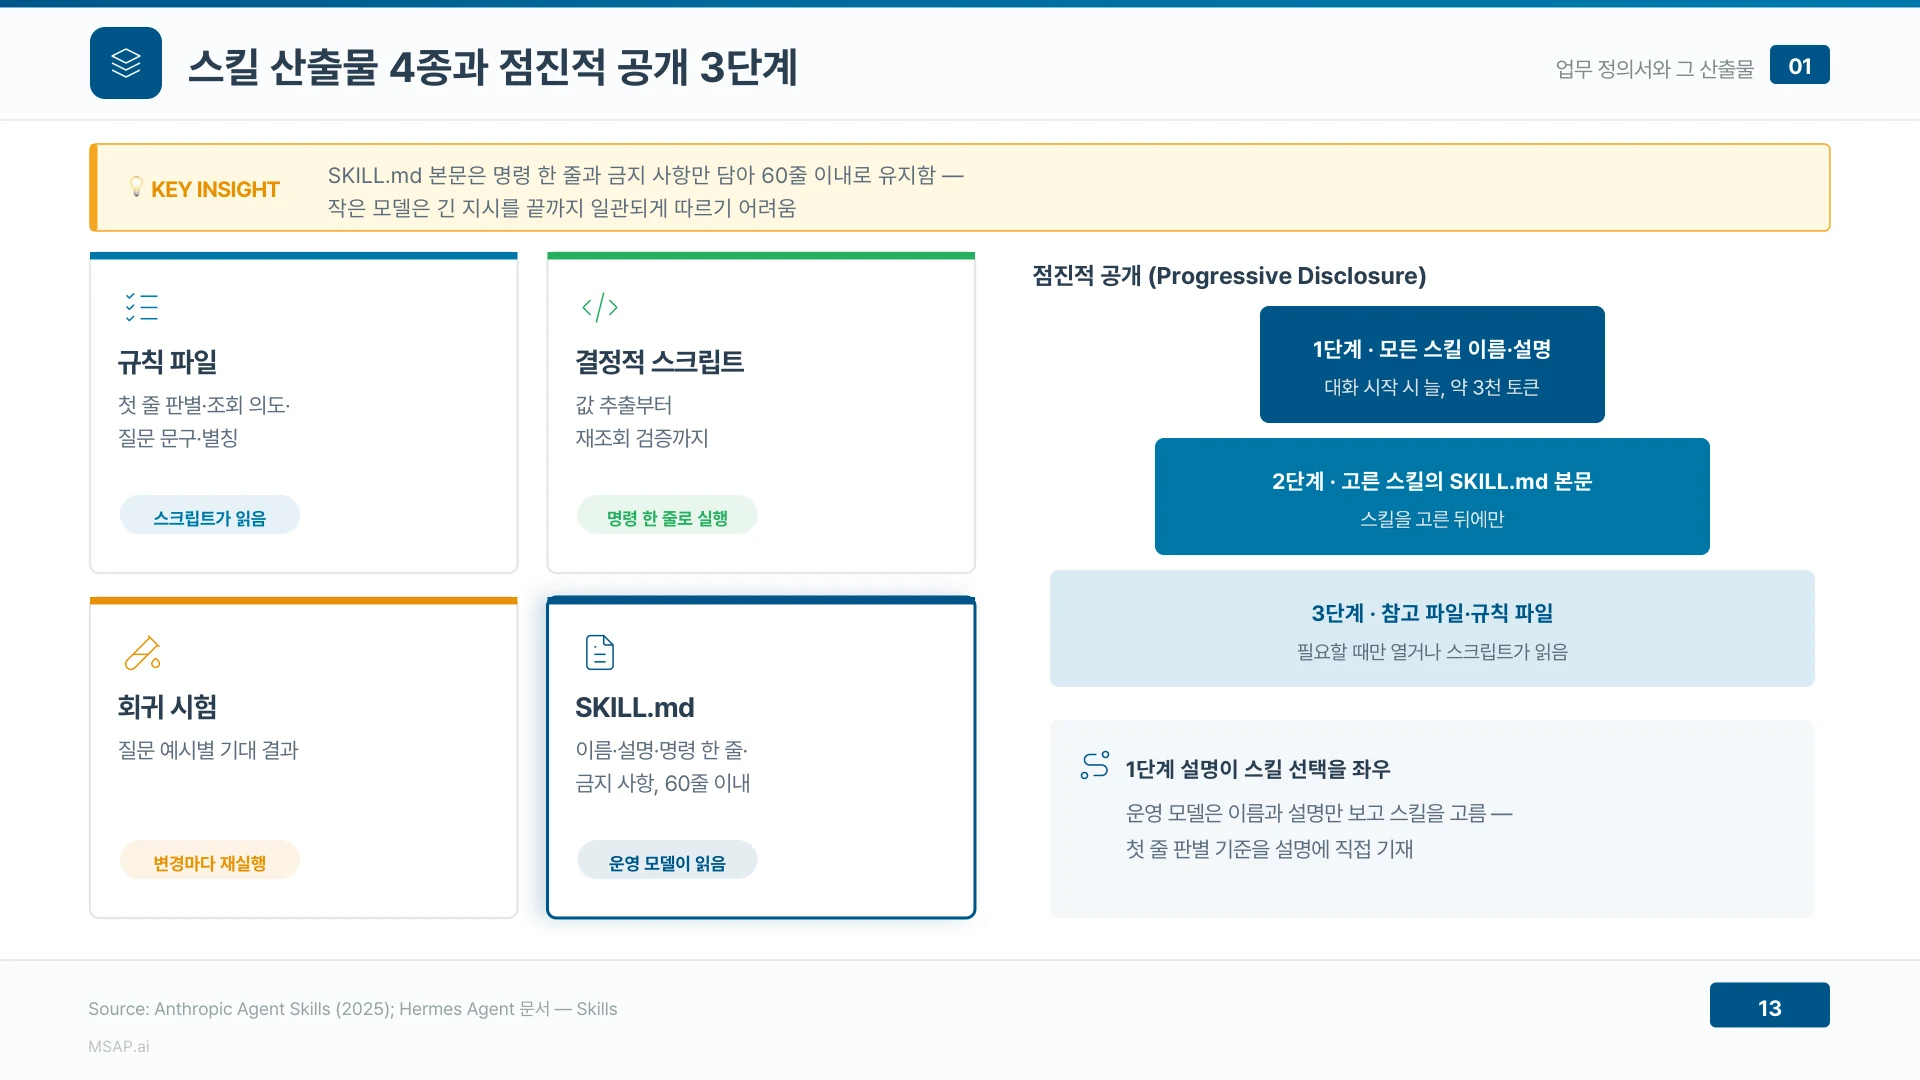
▲ SKILL.md는 명령 한 줄과 금지 사항만 담아 60줄 이내로 쓴다 (발표자료 13쪽)
개발 환경과 운영 환경 사이를 넘는 것은 스킬 묶음 하나뿐이다
개발 환경에는 프론티어 AI와 가짜 값을 담은 비식별 데이터베이스, 목업 인터페이스, 개발용 시험 계정이 있다. 폐쇄망 운영 환경에는 Hermes 프로파일과 LiteLLM, vLLM, 그리고 고객과 금액이 담긴 실데이터와 운영 비밀값이 있다.
경계를 넘는 것은 SKILL.md, 규칙 파일, 결정적 스크립트와 플러그인 훅, 회귀 시험 파일이다. 운영에서 실패한 요청은 고객 이름과 금액을 지운 질문 예시로 바꿔 개발 환경에 되돌리므로 망 분리 정책을 바꿀 필요가 없다.
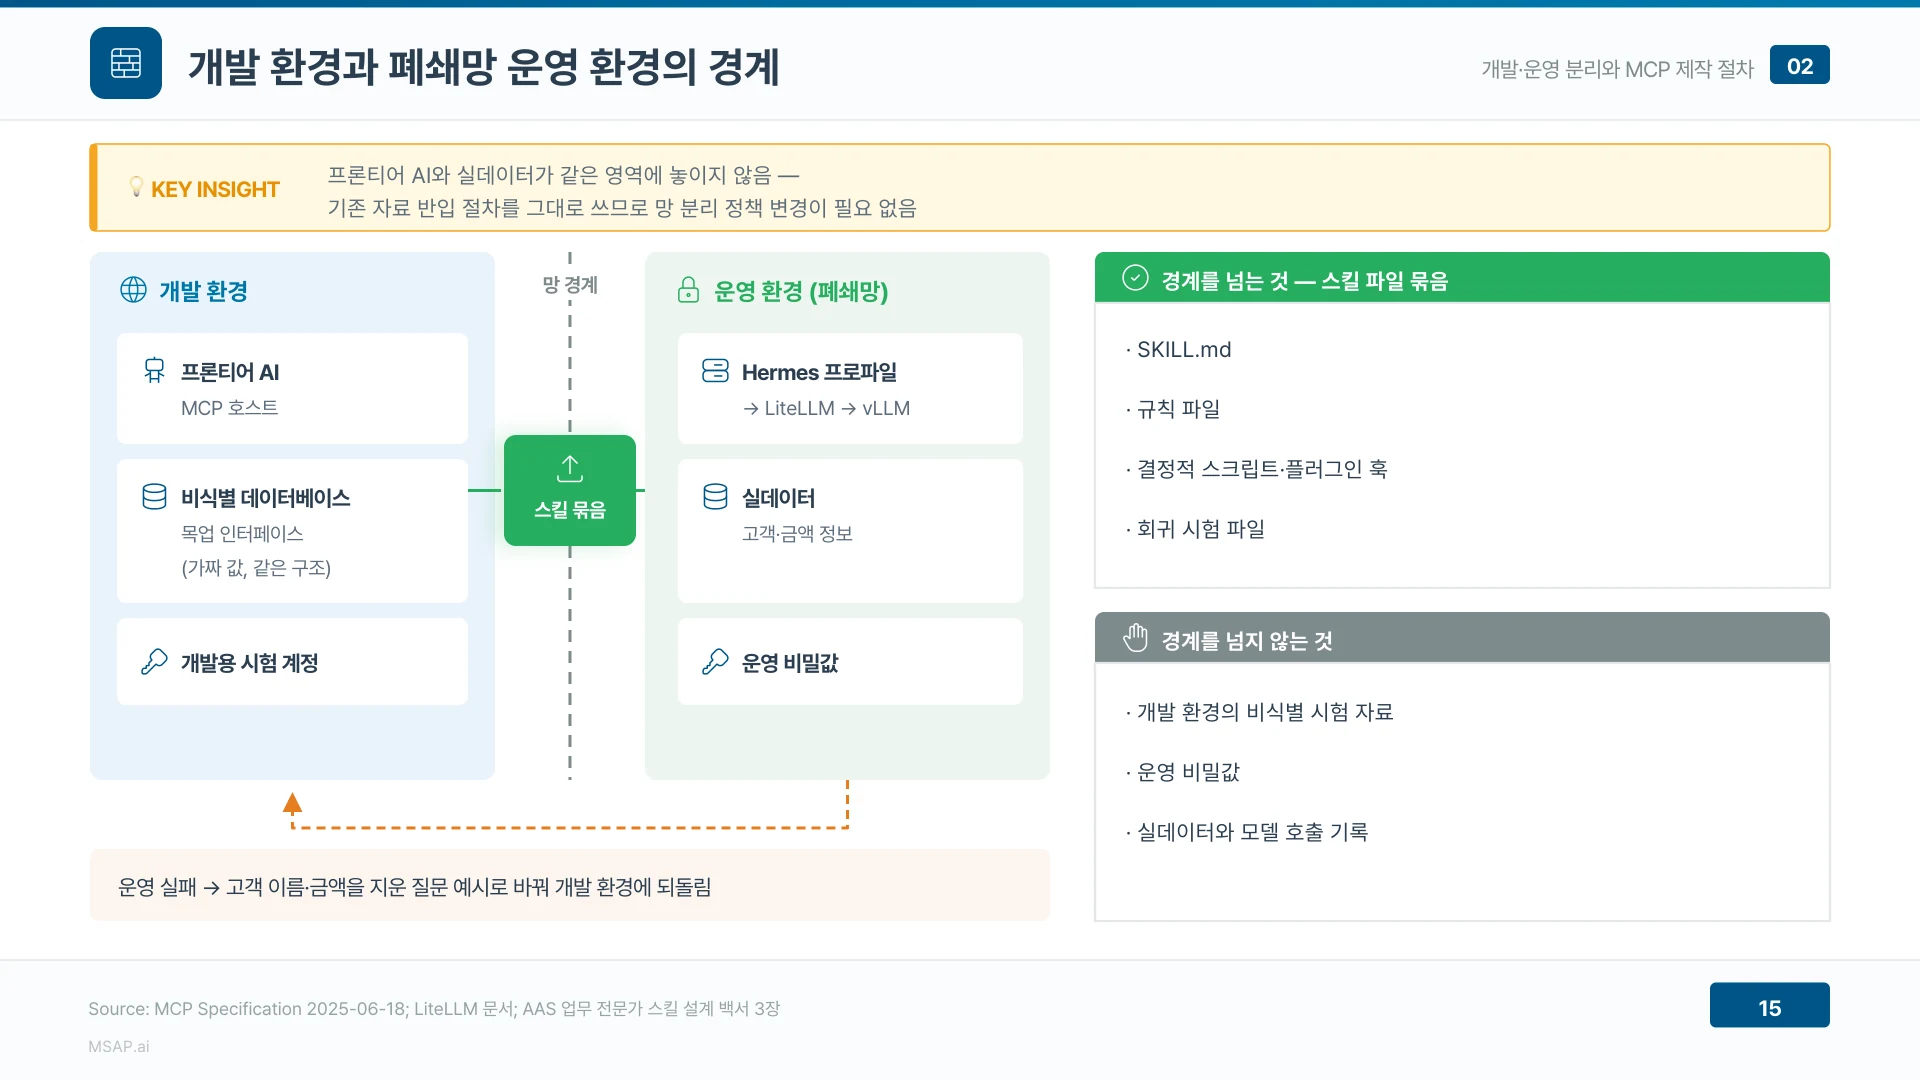
▲ 개발 환경과 운영 환경 사이를 넘는 것은 스킬 묶음 하나뿐이다 (발표자료 15쪽)
폐쇄망 반입은 여섯 단계를 거치고 해시로 승인 없는 변경을 찾는다
완성한 스킬은 업무 전문가의 개발 환경 시험, IT 담당자의 묶음 확정과 판 번호·해시 기록, 보안 담당자의 반입 승인, 업로드와 게시, 설치 보안 검사, 업무 전문가의 운영 재시험 순서로 들어간다.
반입 승인서 해시와 운영 스킬 해시를 대조하면 승인 없는 변경을 찾을 수 있다. 파일럿은 스킬 업로드로 시작하고, 두 번째 부서가 같은 스킬을 쓰기 시작할 때부터 스킬 허브가 적합하다.
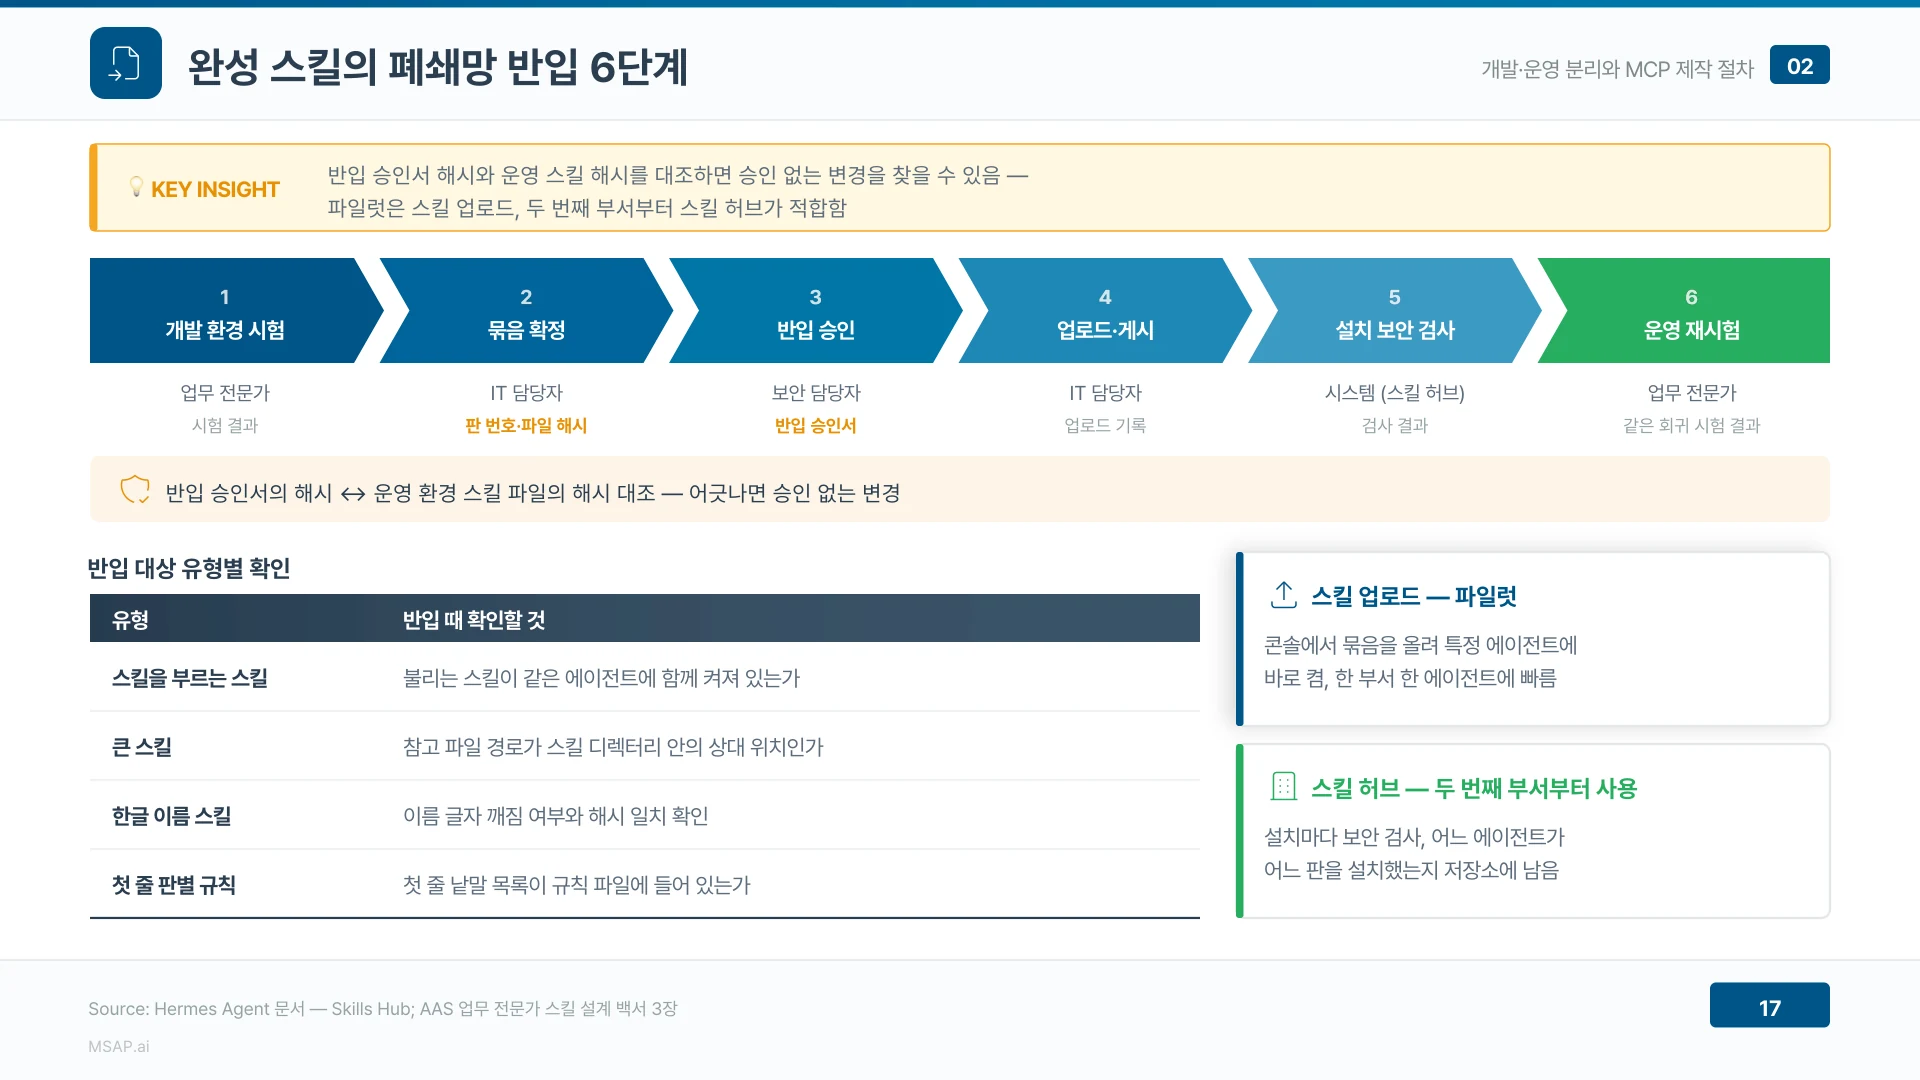
▲ 폐쇄망 반입은 여섯 단계를 거치고 해시로 승인 없는 변경을 찾는다 (발표자료 17쪽)
합격 판정은 프론티어 AI가 아니라 운영 모델로 내린다
프론티어 AI는 긴 SKILL.md를 맥락으로 메우고 확인 게이트도 스스로 지키지만, 운영 모델은 단계를 빠뜨리고 게이트를 건너뛰며 출력을 자기 말로 고쳐 쓴다. 판단을 옮기기 전 운영 모델은 같은 스킬에서 턴당 도구를 11~15회 부르고 191~207초가 걸렸다.
그래서 프론티어 AI 실행 결과는 정답표로만 쓴다. 실패는 지시문 해석, 결정적 코드 부족, 질문 예시 부족으로 나눠 고치고, 고친 뒤에는 회귀 시험 전체를 다시 돌린다.
Anthropic도 에이전트가 쓰는 도구를 설계할 때 여러 예시 입력을 직접 넣어 모델이 어떤 실수를 하는지 확인하고 고치는 과정을 반복하라고 권한다. 스킬을 만드는 모델과 실행하는 모델이 다르므로, 프론티어 모델이 개발 환경에서 정답을 냈다는 사실만으로 반입을 결정하지 않는다.
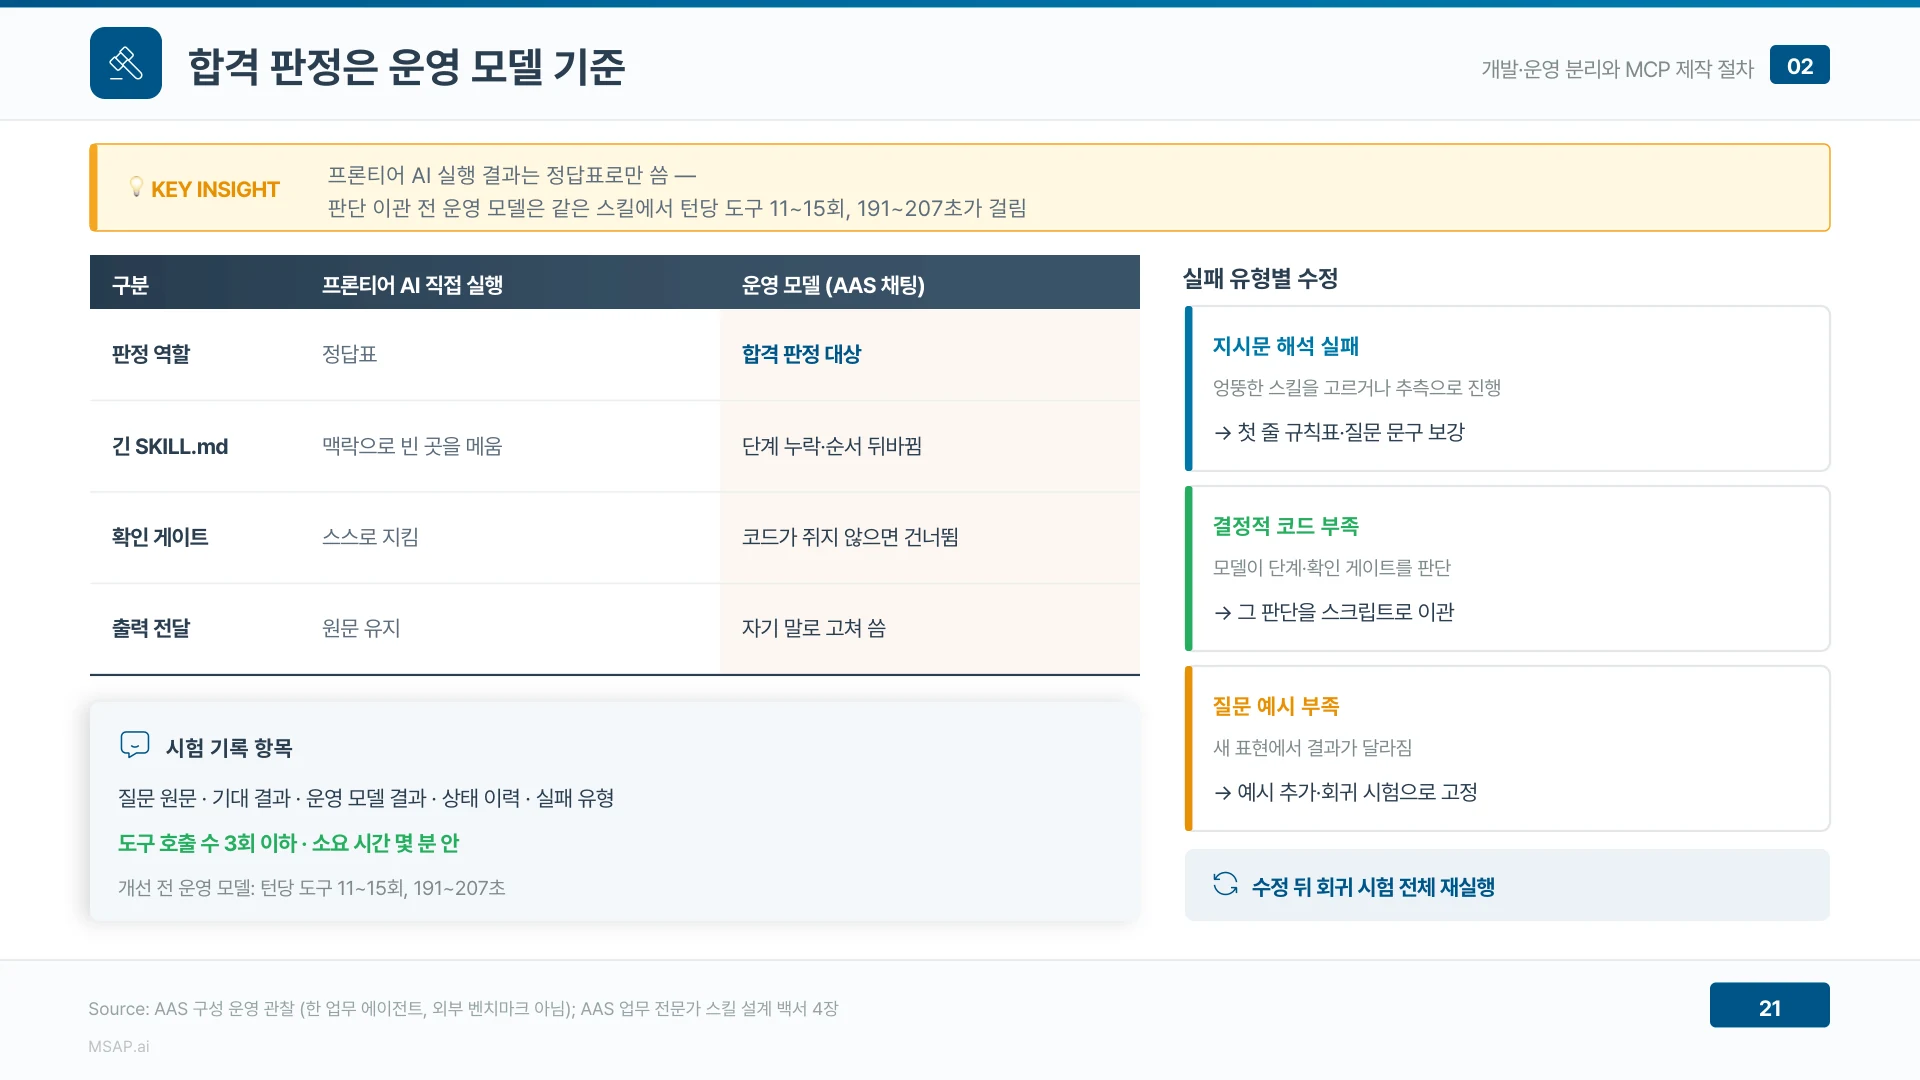
▲ 합격 판정은 프론티어 AI가 아니라 운영 모델로 내린다 (발표자료 21쪽)
결정적 코드로 다시 쓰라는 한 줄 지시로는 확인 게이트가 모델에 남는다
운영 환경과 같은 활성 3B 급 MoE 모델에 그 한 줄만 주었더니 SKILL.md는 약 142줄에서 약 62줄로, 도구 호출은 15회에서 7회로 줄었다. 하지만 확인 게이트와 후보 고르기는 여전히 모델 몫이었다.
이관할 판단을 이름으로 지정해야 승인 없는 쓰기를 막는다. 옮길 판단은 값 추출, 후보 선정, 순서, 확인 게이트, 멱등 쓰기, 재조회 검증 여섯 가지이고, 가장 먼저 옮길 것은 확인 게이트와 쓰기다.
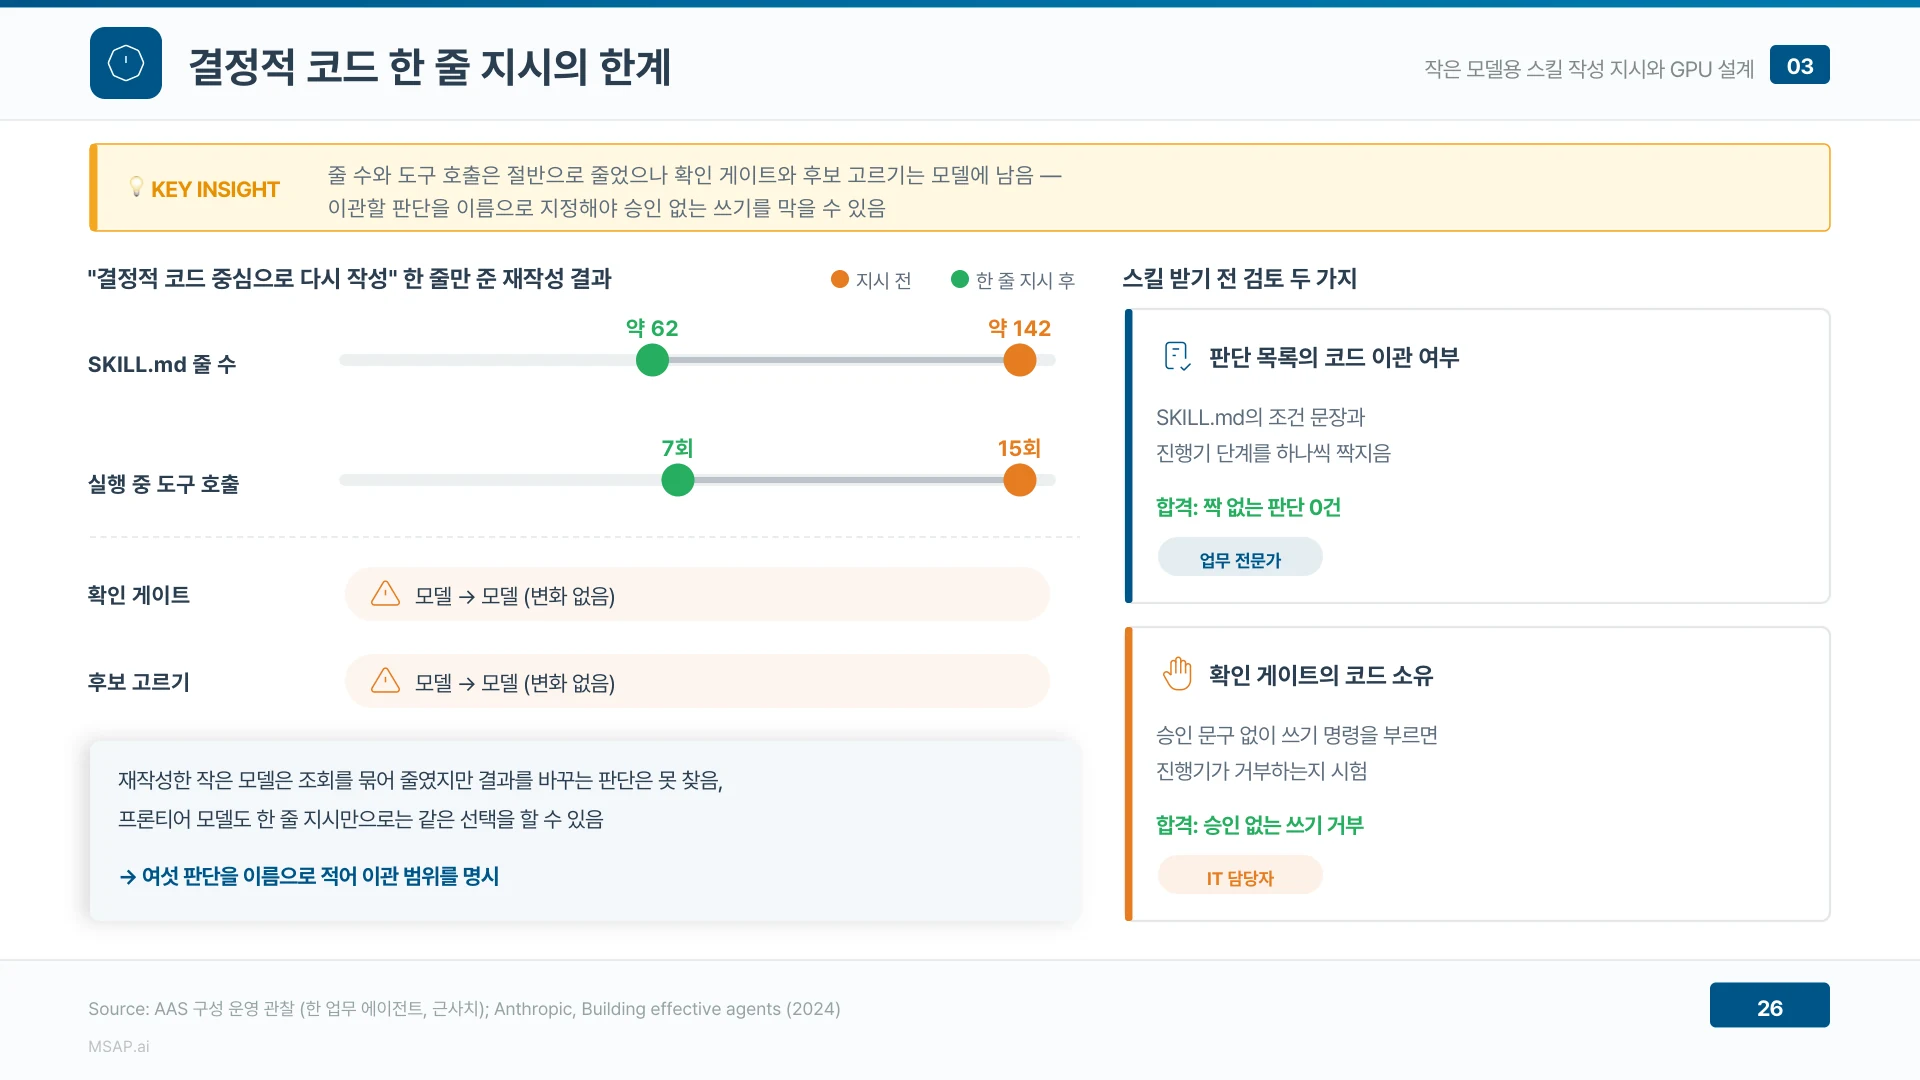
▲ 결정적 코드로 다시 쓰라는 한 줄 지시로는 확인 게이트가 모델에 남는다 (발표자료 26쪽)
활성 3B 급 MoE 모델로 바꾸면 같은 서버에서 초당 토큰이 약 세 배다
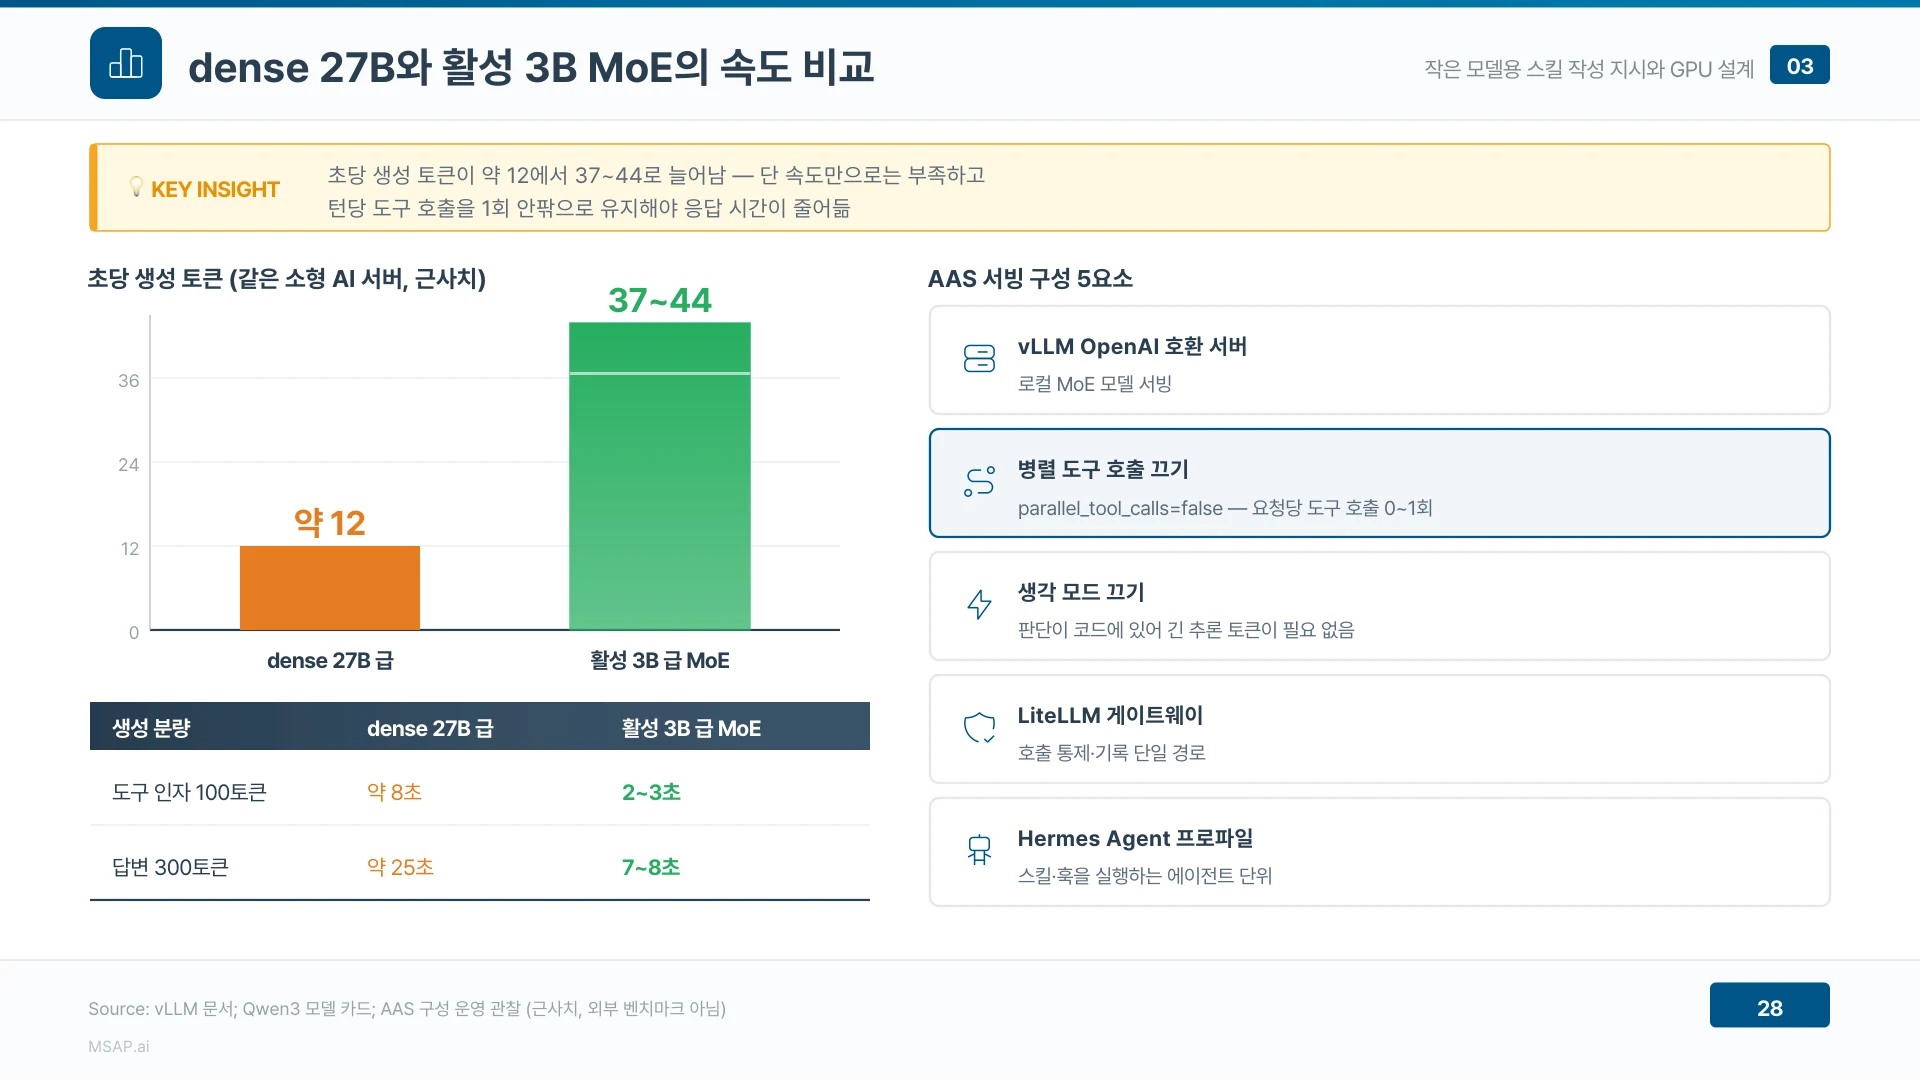
디코드 속도는 토큰마다 메모리에서 읽는 가중치 양이 정한다. Qwen3-30B-A3B는 30.5B 중 3.3B만 토큰마다 읽어 dense 모델의 약 11% 수준이다.
같은 소형 AI 서버에서 dense 27B 급 모델을 활성 3B 급 MoE 모델로 바꾸면 초당 생성 토큰이 약 12에서 37~44로 늘고, 300토큰 답변은 약 25초에서 7~8초로 줄었다. 다만 턴당 도구 호출을 1회 안팎으로 유지해야 응답 시간이 실제로 준다.
▲ 활성 3B 급 MoE 모델로 바꾸면 같은 서버에서 초당 토큰이 약 세 배다 (발표자료 28쪽)
코드로 옮긴 뒤 남는 세 공백은 훅으로 모델 밖에서 막는다
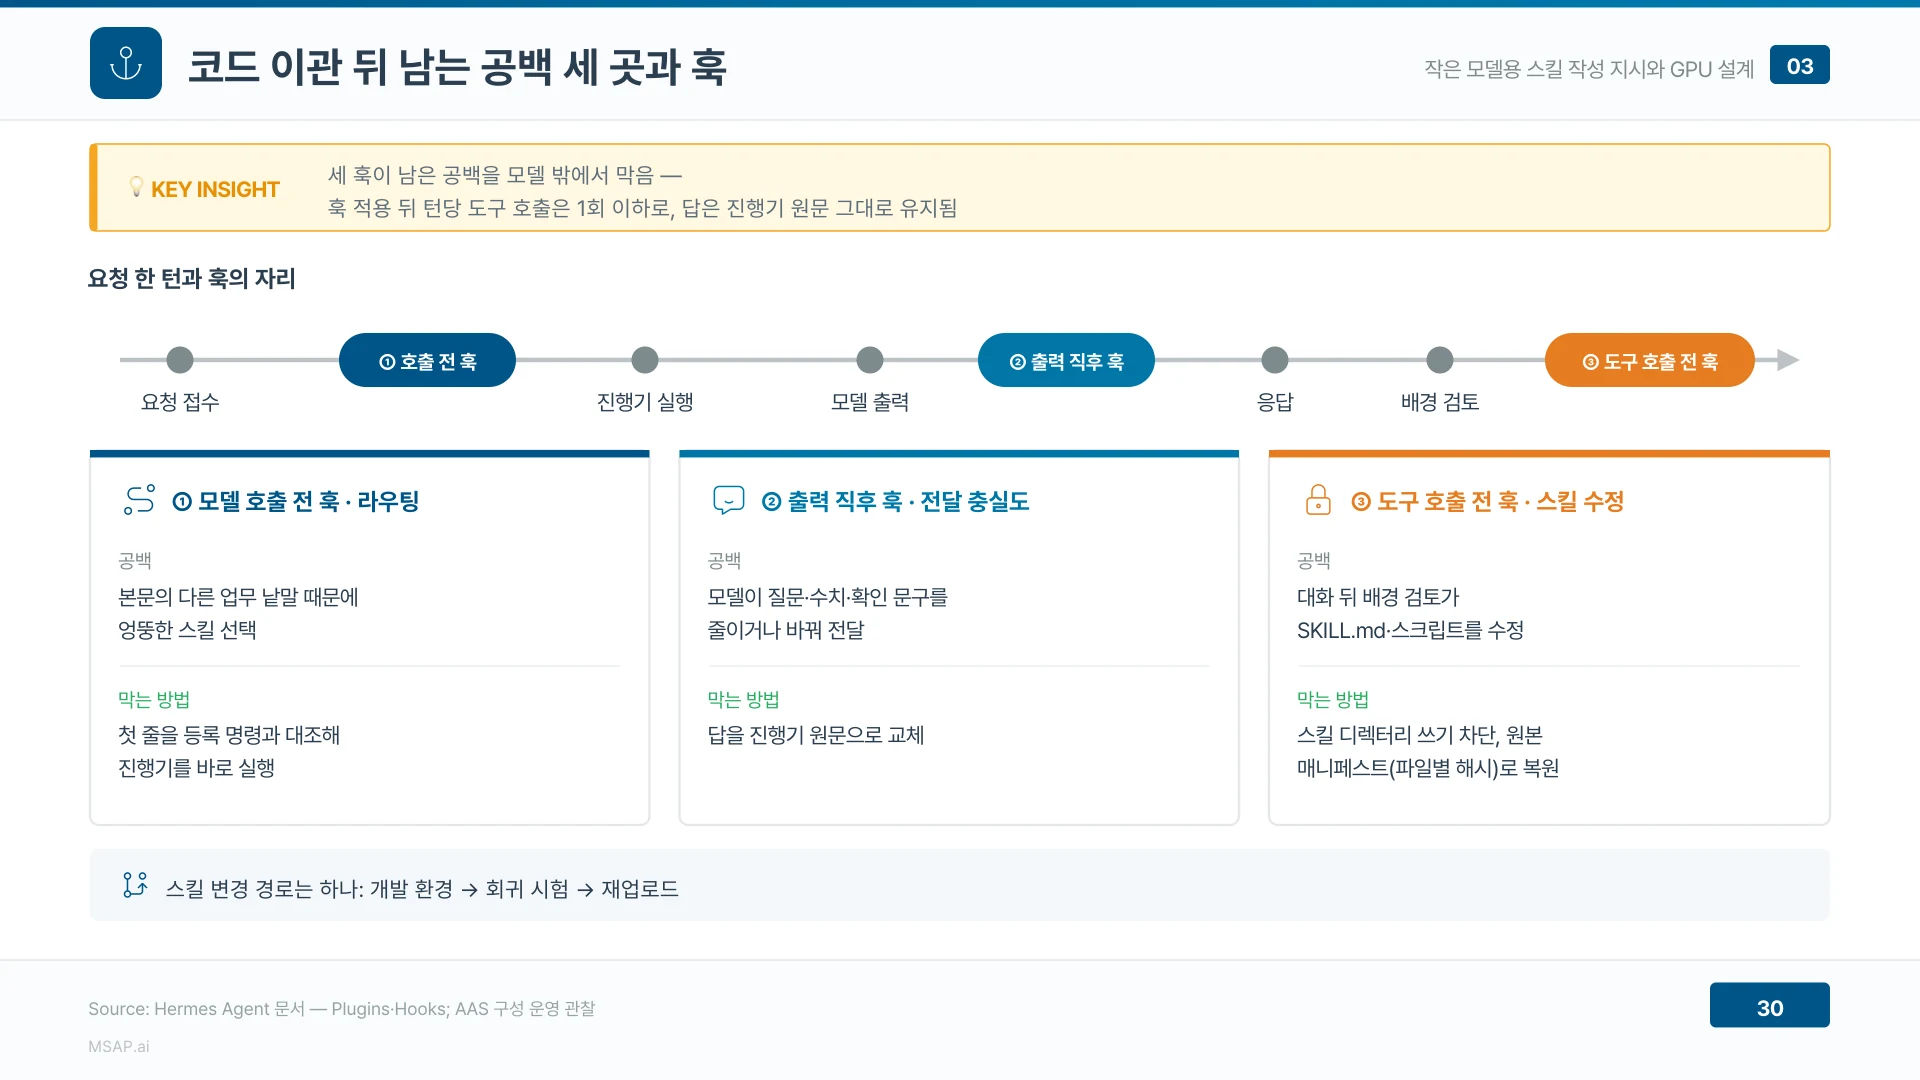
판단을 코드로 옮긴 뒤에도 라우팅, 전달 충실도, 배경 검토의 스킬 수정 세 곳이 남는다. 모델 호출 전 훅은 첫 줄을 등록 명령과 대조해 진행기를 바로 실행하고, 출력 직후 훅은 모델이 줄이거나 바꾼 답을 진행기 원문으로 교체한다.
도구 호출 전 훅은 대화 뒤 배경 검토가 SKILL.md나 스크립트를 고치려 할 때 쓰기를 막고 원본으로 복원한다. 그래서 스킬이 바뀌는 경로는 개발 환경, 회귀 시험, 재업로드 하나로 고정된다.
한 업무 에이전트에서는 운영 중 스킬 수정 시도 3회가 모두 이 훅에 막혔다. 차단과 복원은 스킬을 고치지 말자는 장치가 아니라 고치는 경로를 개발 환경 하나로 모으는 장치이며, 운영에서 드러난 개선점은 개발 환경에서 고쳐 회귀 시험을 다시 통과한 뒤 들여온다.
▲ 코드로 옮긴 뒤 남는 세 공백은 훅으로 모델 밖에서 막는다 (발표자료 30쪽)
CRM 조회는 394초 오답에서 14초 정답으로 바뀌었다
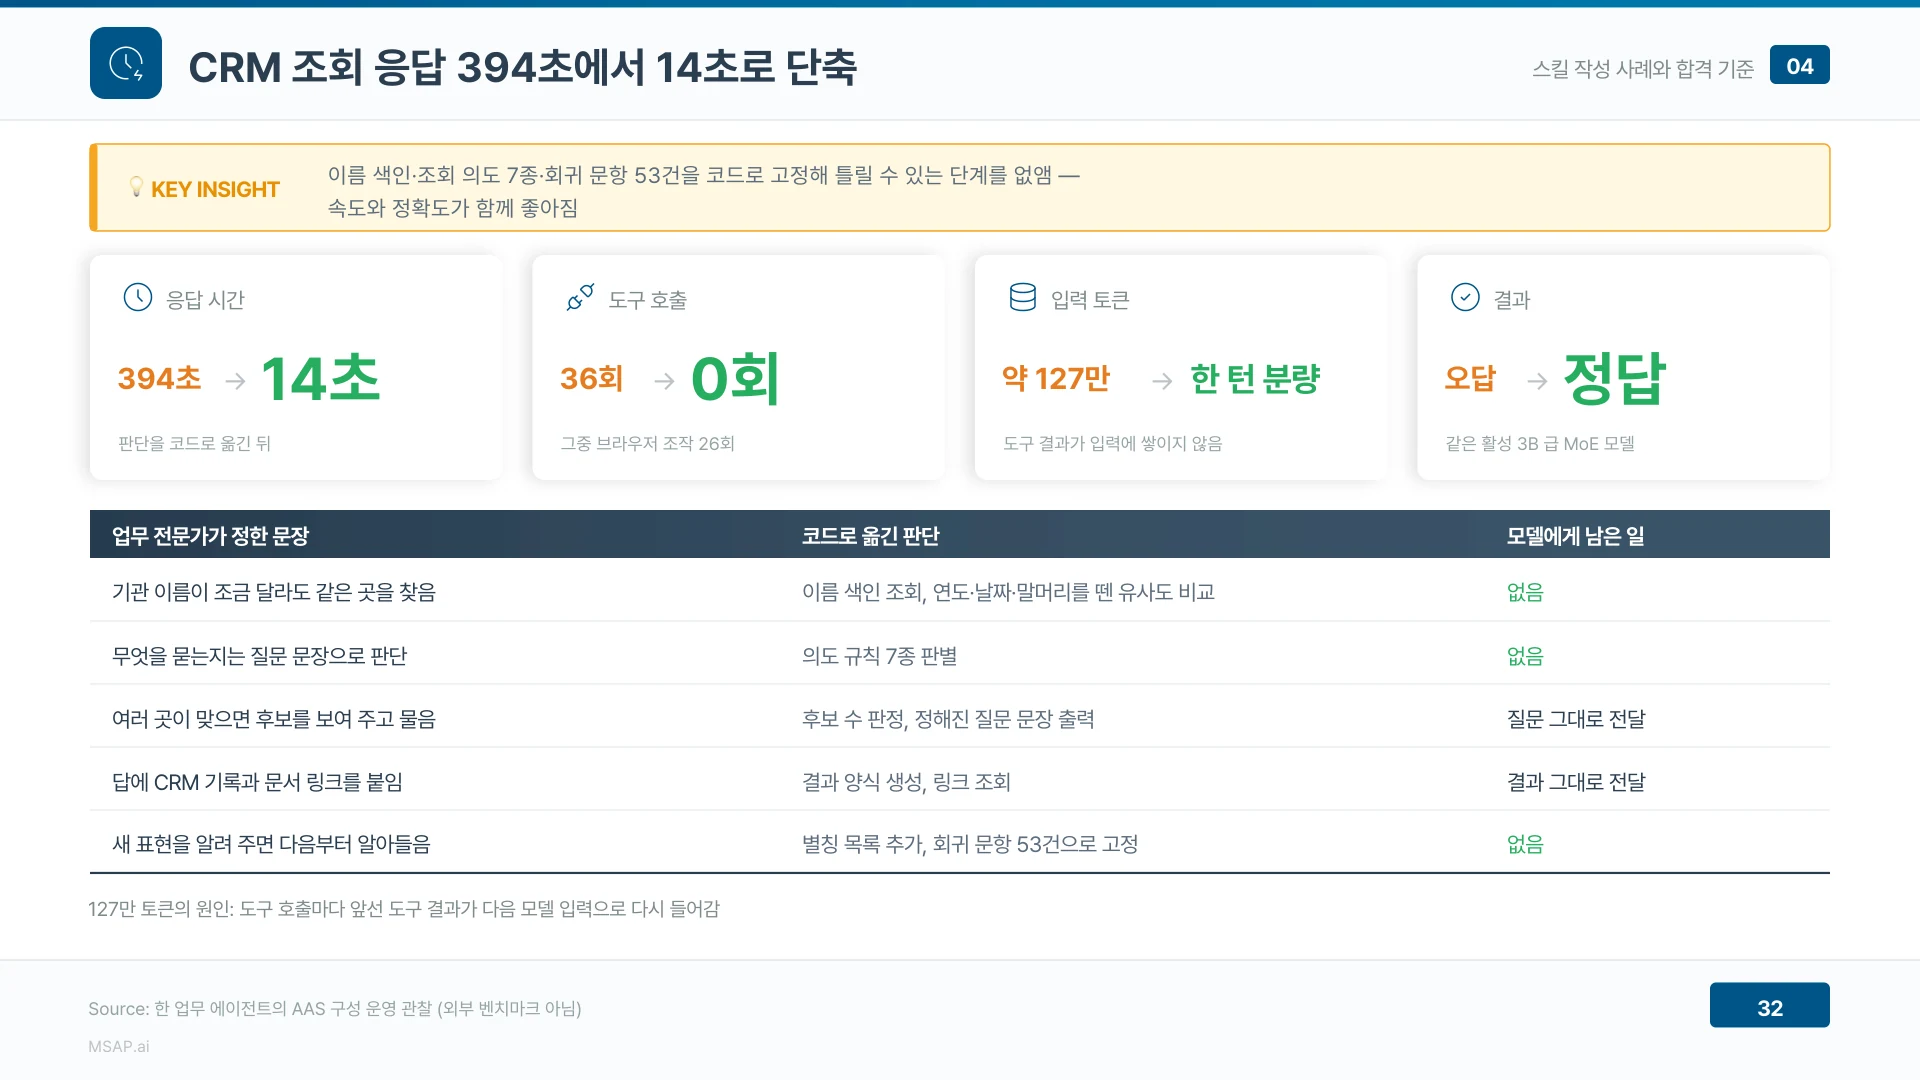
판단을 코드로 옮기자 도구 호출은 브라우저 조작 26회를 포함한 36회에서 0회로 줄었고, 약 127만이던 입력 토큰은 한 턴 분량만 남았다. 127만 토큰의 원인은 도구 호출마다 앞선 결과가 다음 모델 입력으로 다시 들어가는 구조였다.
업무 전문가의 문장을 이름 색인, 조회 의도 7종, 회귀 문항 53건으로 코드에 고정해 틀릴 수 있는 단계를 없앴다. 사례 수치는 한 업무 에이전트에서 관찰한 제품 동작이며 외부 벤치마크가 아니다.
업무 담당자가 말로 정한 견적 규칙이 규칙 파일과 점검 코드, 시험으로 바뀐 과정은 업무 전문가가 만드는 AI Agent와 AI Agent Studio(AAS) 제품 소개에 따로 정리돼 있다.
▲ CRM 조회는 394초 오답에서 14초 정답으로 바뀌었다 (발표자료 32쪽)
영업기회 등록은 진행기가 여덟 단계를 쥐고 사람은 두 곳만 본다
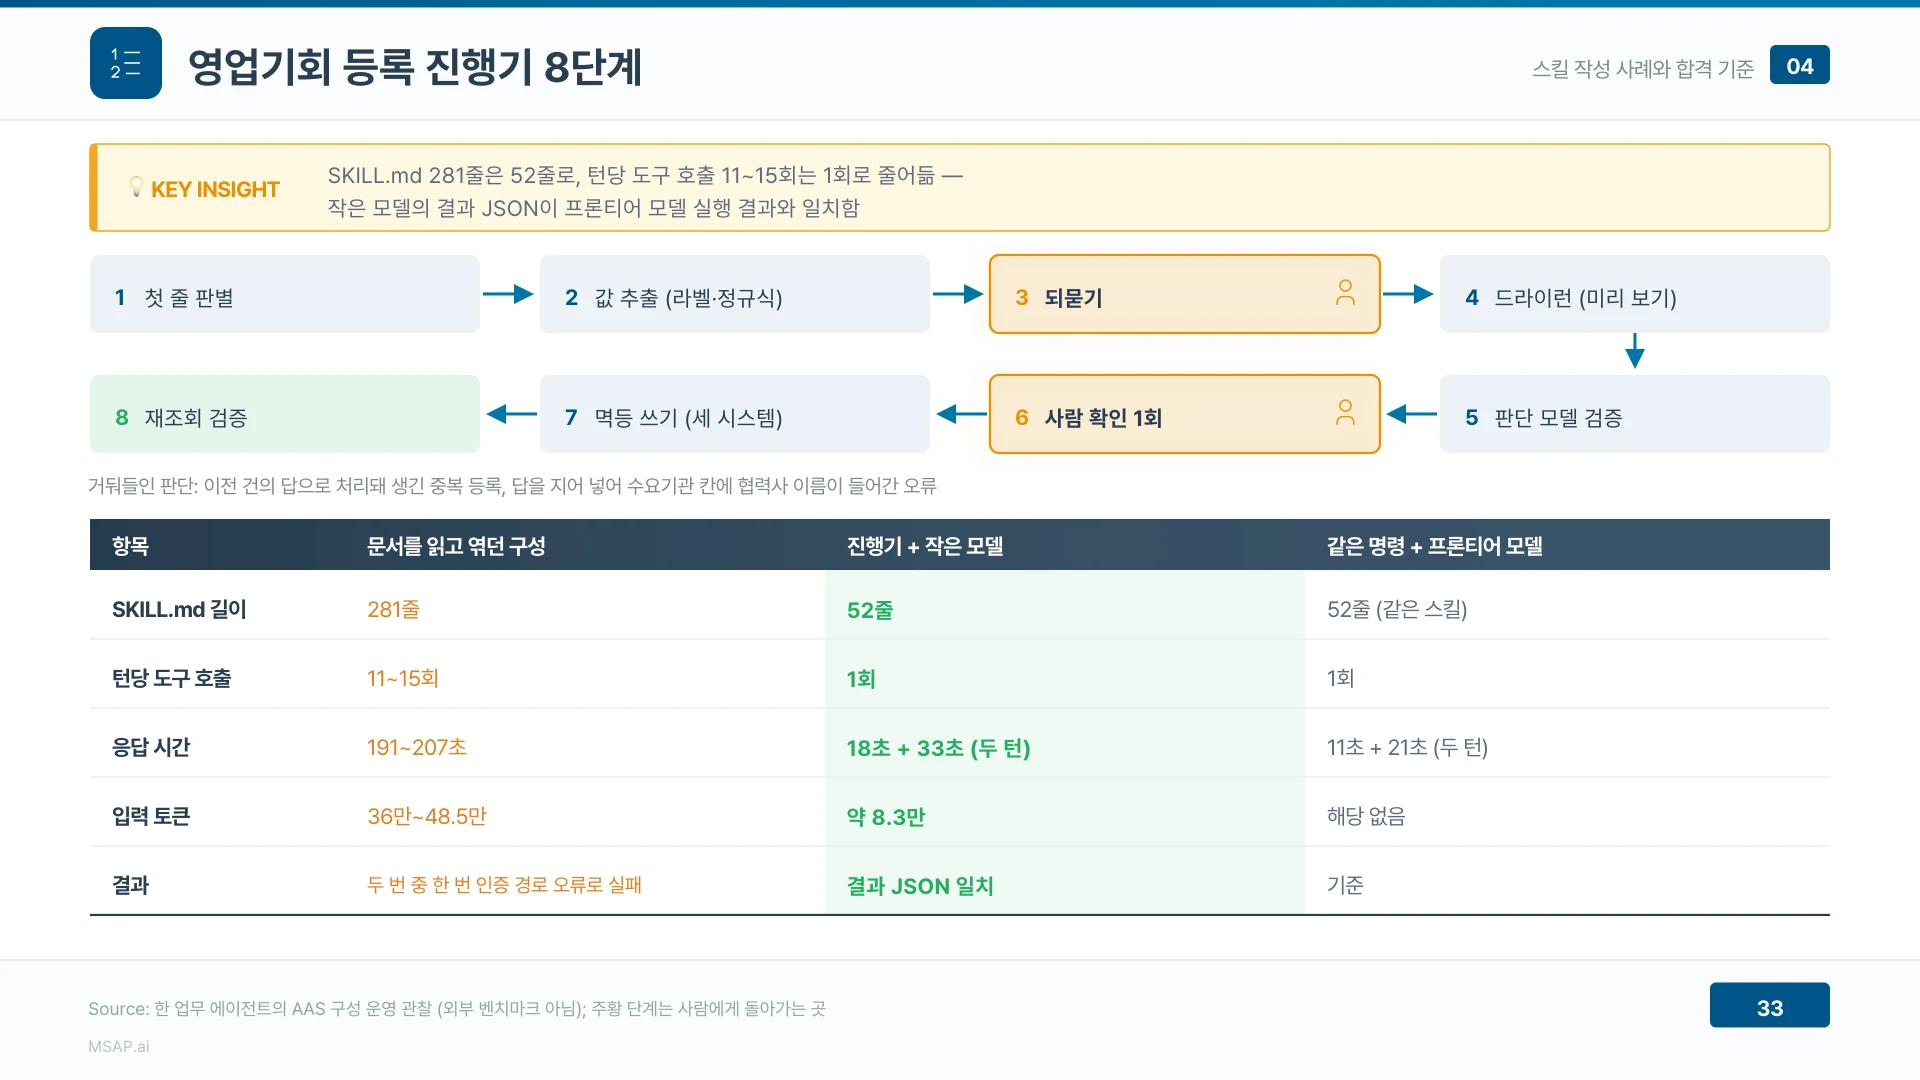
첫 줄 판별, 값 추출, 되묻기, 드라이런, 판단 모델 검증, 사람 확인 1회, 멱등 쓰기, 재조회 검증 순서다. SKILL.md 281줄은 52줄로, 턴당 도구 호출 11~15회는 1회로, 응답 시간 191~207초는 두 턴에 각각 18초와 33초로 줄었다.
작은 모델이 낸 결과 JSON은 같은 명령을 프론티어 모델이 실행한 결과와 일치했다. 이전 건의 답으로 처리돼 생기던 중복 등록 같은 오류도 함께 사라졌다.
▲ 영업기회 등록은 진행기가 여덟 단계를 쥐고 사람은 두 곳만 본다 (발표자료 33쪽)
스킬 합격선은 도구 호출 3회 이하, 수 분 이내 응답, 정답이다
측정은 준비, 입력, 관찰, 대조, 반복 다섯 단계로 하고, 같은 요청을 두세 번 다시 넣어 결과가 같은지까지 본다. CRM 조회와 영업기회 등록은 개선 전 불합격, 개선 후 합격이었다.
세 지표 모두 AAS 채팅 화면에서 읽을 수 있어 업무 전문가가 스크립트를 열지 않고도 합격 여부를 판정한다. 스킬 변경과 운영 모델 교체도 같은 질문 예시 묶음을 다시 돌려 통과해야 반영한다.
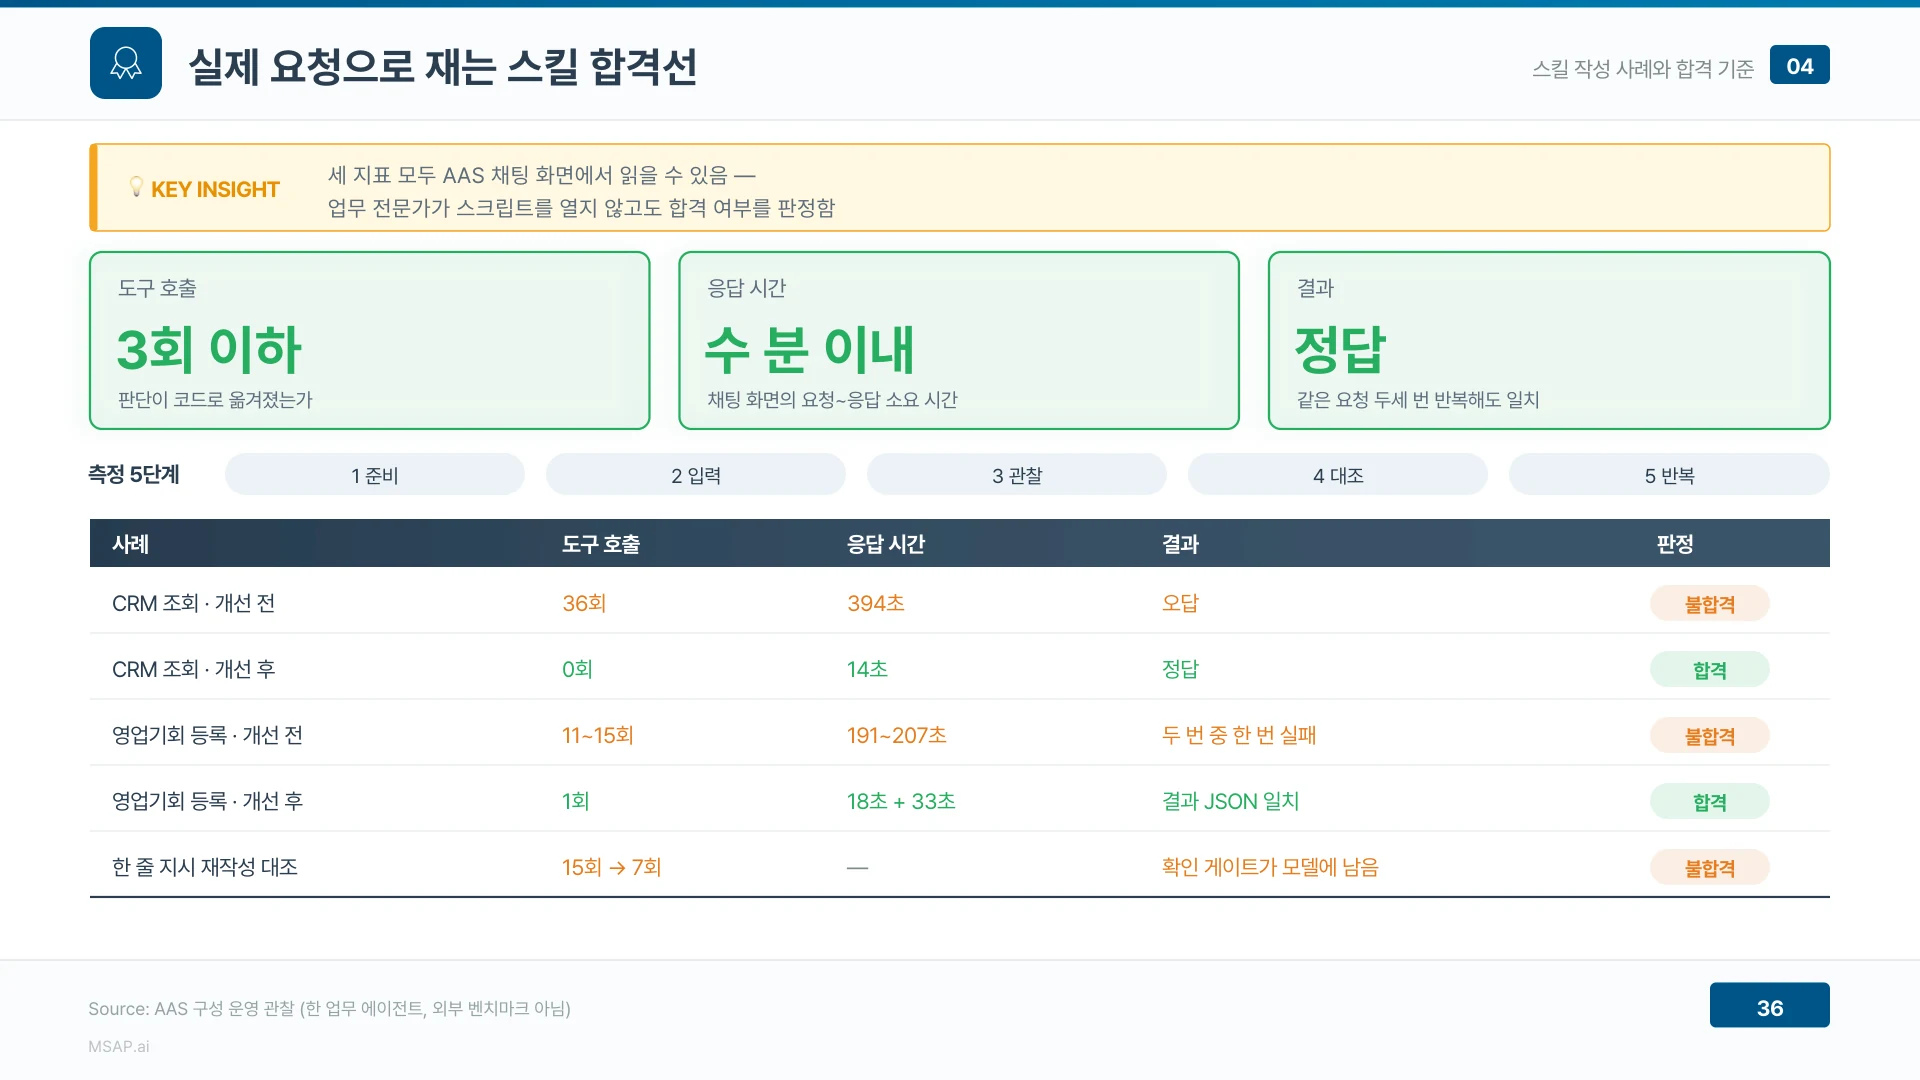
▲ 스킬 합격선은 도구 호출 3회 이하, 수 분 이내 응답, 정답이다 (발표자료 36쪽)
파일럿은 업무 하나와 프로파일 하나로 시작하고 GPU 규모는 마지막에 정한다
파일럿 업무는 반복 빈도, 규칙 명시 가능성, 데이터 반출 제한, 결과 판정 가능성, 쓰기 영향 범위, 업무 전문가 확보 여섯 항목을 모두 통과한 것으로 고른다. 사내 규정 범용 상담이나 여러 로그를 엮는 장애 원인 분석은 맞지 않는다.
순서는 대상 업무 선정, 업무 정의서 작성, 개발 환경 구성, 스킬 제작과 드라이런, 합격선 확인, 스킬 업로드 반입, 운영 측정과 부서 확산 일곱 단계다. 첫 결정은 부서 반복 업무 하나와 업무 전문가 지정이다.
후보 업무가 여럿이라면 설계·운영·보안 기준으로 먼저 걸러 볼 수 있다. 그 기준은 AI Agent 업무 적용 판단 기준 12가지 발표자료에 정리돼 있다.
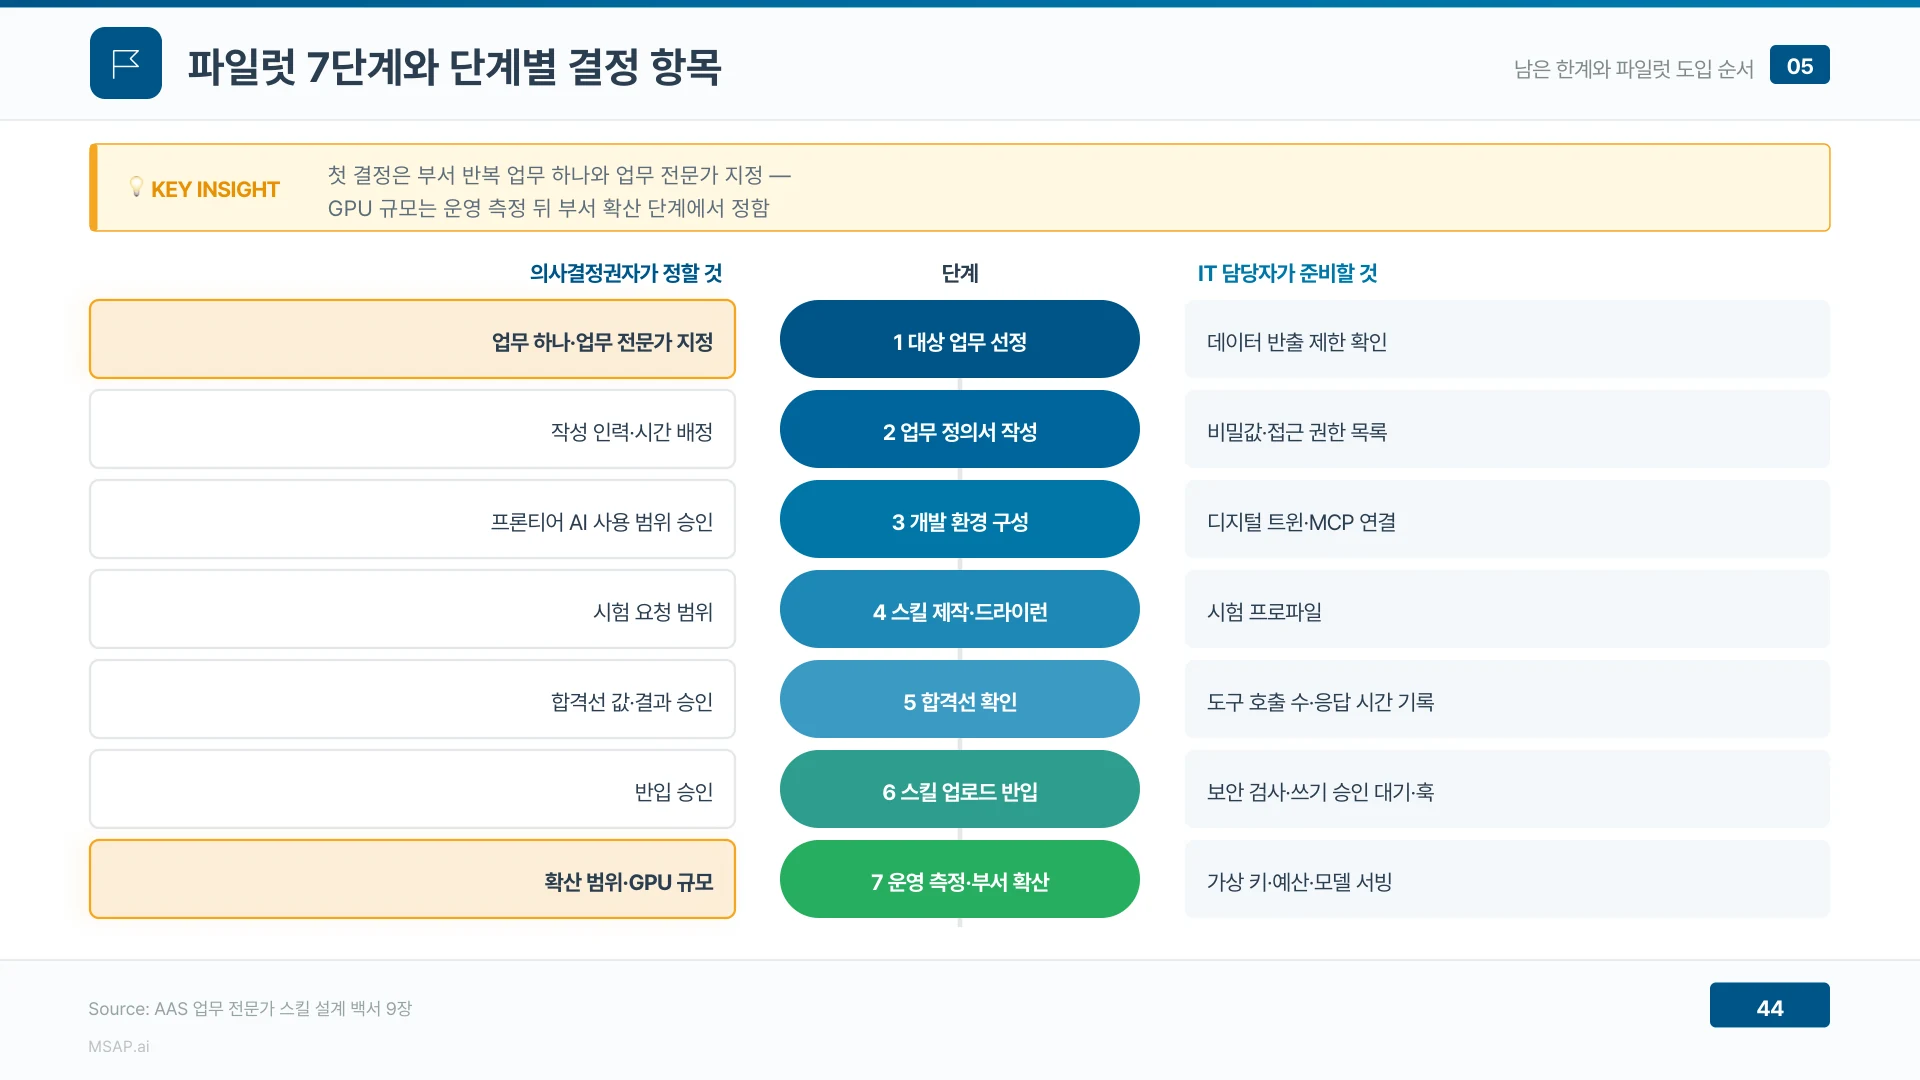
▲ 파일럿은 업무 하나와 프로파일 하나로 시작하고 GPU 규모는 마지막에 정한다 (발표자료 44쪽)
핵심 정리
| 파트 | 이 발표자료에서 확인할 것 |
|---|---|
| 업무 정의서 | 정의 우선 원칙, 정의서 8항목, 스킬 산출물 4종과 점진적 공개 3단계 |
| 개발·운영 분리 | 경계를 넘는 스킬 묶음, 디지털 트윈 7항목, 반입 6단계, LiteLLM 보안 점검 9항목 |
| 작성 지시와 GPU | 지시문 해석·결정적 코드·질문 예시 세 지시, MoE 속도 비교, 훅 세 가지 |
| 사례와 합격 기준 | CRM 조회, 영업기회 등록, 견적 판정, 보안 공지 설계안, 합격선 세 지표 |
| 한계와 파일럿 | 작은 모델이 약한 업무 유형, 스킬 자가 수정 위험, 선정 점검표와 7단계 |
| 역할 | 맡는 일 | 맡지 않는 일 |
|---|---|---|
| 업무 전문가 | 판단 규칙, 예외, 정답 판정, 질문 예시 작성 | 코드와 시험 작성 |
| 프론티어 AI | 규칙 파일, 결정적 스크립트, 회귀 시험, SKILL.md 작성 | 운영 실데이터 처리 |
| 운영 로컬 모델 | 요청을 받아 진행기 명령 한 줄 실행과 원문 전달 | 업무 판단 |
| IT 담당자 | 모델 서빙, 게이트웨이, 접근 권한, 반입 관리 | 업무 규칙 결정 |
| 사례 | 개선 전 | 개선 후 |
|---|---|---|
| CRM 조회 | 394초, 도구 호출 36회, 오답 | 14초, 도구 호출 0회, 정답 |
| 영업기회 등록 | SKILL.md 281줄, 턴당 11~15회, 191~207초 | 52줄, 턴당 1회, 18초와 33초 |
| 서빙 모델 교체 | dense 27B 급 초당 약 12토큰 | 활성 3B 급 MoE 초당 37~44토큰 |
자주 묻는 질문
AI Agent 도입은 GPU 구매부터 해야 하는가
아니다. 업무 정의서로 질문 예시를 먼저 시험하고 GPU 규모는 운영 측정 뒤 부서 확산 단계에서 정한다. 디코드 지연은 메모리 대역폭이 좌우해 장비를 늘려도 모델 호출 횟수는 줄지 않는다.
코딩을 모르는 업무 전문가도 스킬을 만들 수 있는가
만들 수 있다. 업무 전문가는 판단 규칙, 예외 처리, 사람 확인 단계, 정답 판정을 문장으로 쓰고 코드와 시험은 프론티어 AI가 작성한다. 선정 기준은 코딩 경험이 아니라 그 업무의 예외와 정답을 가장 많이 아는가다.
프론티어 AI를 쓰면 폐쇄망 정책이 깨지지 않는가
깨지지 않는다. 프론티어 AI는 가짜 값을 담은 개발 환경에서만 일하고 운영 환경으로 넘어가는 것은 스킬 파일 묶음 하나뿐이다. 실데이터와 운영 비밀값, 모델 호출 기록은 경계를 넘지 않는다.
작은 로컬 모델로도 업무 결과가 나오는가
판단을 코드로 옮기면 나온다. 영업기회 등록은 턴당 도구 호출 1회, 두 턴 18초와 33초로 처리됐고 결과 JSON이 프론티어 모델 실행 결과와 일치했다.
스킬이 쓸 만한지는 어떻게 판정하는가
실제 요청에서 도구 호출 3회 이하, 수 분 이내 응답, 정답 세 가지로 판정한다. 같은 요청을 두세 번 다시 넣어 결과가 같은지도 보고, 판정은 운영 모델 기준으로 내린다.
운영 중에 에이전트가 스킬을 스스로 고치면 어떻게 되는가
확인 게이트가 사라질 수 있어 막아야 한다. 쓰기 승인 대기, 수정 차단 훅, 원본 복원 같은 운영 설정 여섯 항목으로 변경 경로를 개발 환경 하나로 고정한다.
파일럿에 맞지 않는 업무는 무엇인가
매번 판단이 달라지는 업무와 범용 상담, 여러 로그를 엮는 장애 원인 분석이다. 연 1~2회 하는 업무도 정의서와 시험을 쓰는 노력이 회수되지 않아 맞지 않는다.
참고 리소스
MSAP.ai 자료
- AI 에이전트란? 정의·종류·사례와 기업 도입 기준
- 코딩을 모르는 업무전문가가 만드는 AI 에이전트 개발 가이드 백서
- 업무전문가가 만드는 AI 에이전트, 오픈소스 AAS 소개 백서
- 업무 전문가가 만드는 AI 에이전트와 AI Agent Studio(AAS) 제품 소개
- AI Agent Studio(AAS) 플랫폼 백서
- Hermes Agent 소개 구조, 기능, 도입 로드맵
- AI 에이전트 런타임 구조 분석, 실행 결과 검증부터 코어와 스킬까지
- AI 에이전트 도입 조건, 제품 기능과 조직 역량을 나누는 기준
외부 공개 자료