- 백서 다운로드 — 업무 정의서부터 파일럿 결정까지
- 영상으로 먼저 보기
- 이 백서가 답하는 7가지 질문
- GPU 예산보다 업무 정의가 먼저인 이유
- 업무 전문가가 쓰는 업무 정의서 한 장의 구조
- 만드는 곳과 일하는 곳을 망 경계로 나누는 방식
- 고객·금액 자료가 밖으로 나가지 않는 게이트웨이 구조
- 프론티어 AI를 MCP로 연결해 스킬을 만드는 순서
- 작은 모델이 같은 결과를 내게 하는 세 가지 지시 방식
- 보급형 GPU의 응답 시간을 바꾸는 두 가지 조건
- 판단은 코드, 모델은 한 줄 실행으로 나누는 역할 기준
- 코드로 옮긴 뒤 남는 공백 세 곳을 훅으로 막는 방법
- 영업 업무 스킬 세 건으로 본 전후 효과
- 실행 모델 기준의 합격선과 결과 검증 흐름
- 남은 한계와 부서 업무 하나로 시작하는 파일럿 순서
- 핵심 정리
- 자주 묻는 질문
- AI 에이전트(AI Agent)란? 정의·종류·사례와 기업 도입 기준
- 참고 리소스
- 자료 다운로드
백서 다운로드 — 업무 정의서부터 파일럿 결정까지
AI Agent 스킬 설계 백서는 9개 장으로 구성됩니다. 1–3장은 도입 출발점이 GPU가 아니라 업무 정의라는 관점, 업무 전문가가 쓰는 업무 정의서, 만드는 곳과 일하는 곳의 분리를 다룹니다. 4–6장은 프론티어 AI를 MCP로 MSAP.ai AAS에 연결해 스킬을 만드는 절차, 작은 모델이 같은 결과를 내게 하는 세 가지 지시, 보급형 GPU에서 쓸 만한 속도를 내는 설계를 정리합니다. 7–9장은 영업 업무 사례, 합격선과 운영, 남은 한계와 파일럿 순서를 담았습니다. 제품의 정의와 도입 순서는 앞서 공개한 업무 전문가가 만드는 AI Agent 백서에서 다뤘고, 이번 백서는 그 위에서 스킬을 어떻게 설계하는지에 집중합니다.
사례의 수치는 한 업무 에이전트를 운영하며 관찰한 값이고 외부 벤치마크가 아니라는 점도 장마다 밝혔습니다. 아래 버튼을 누르면 AI Agent 스킬 설계 백서 110쪽을 PDF 한 파일로 받을 수 있습니다.
MSAP.ai 백서 구독하기🔔
새로운 백서 소식을 가장 먼저 만나보세요!
MSAP.ai 가 전하는 AI 기반 운영 인사이트와 최신 백서 소식을 가장 빠르게 받아보실 수 있습니다.
구독해 주시면 더 좋은 콘텐츠로 보답하겠습니다.🙏
영상으로 먼저 보기
클라우드네이티브TV의 「AI Agent 오픈소스 관리 도구 – AI Agent Studio」 영상은 이 백서의 해설 영상이 아니라 같은 AAS 시리즈의 다른 편으로, 스킬이 올라가 일하는 콘솔 화면을 보여 줍니다.
백서가 다루는 업무 정의서와 스킬 설계 원칙을 읽기 전에 화면 구성을 익혀 두면 장마다 나오는 기능을 떠올리기 쉽습니다. 영상은 이 백서의 해설이 아니라 같은 제품의 화면 소개 편입니다.
이 백서가 답하는 7가지 질문
도입을 검토하는 조직이 실제로 묻는 질문 일곱 가지에 차례로 답합니다.
- AI Agent 예산을 GPU보다 업무 정의에 먼저 써야 하는 이유는 무엇인가
- 코딩을 모르는 업무 전문가는 어떤 문장으로 업무를 정의해야 하는가
- 폐쇄망 조직은 프론티어 AI를 어디서 쓰고 스킬을 어떻게 들여오는가
- 프론티어 AI에게 무엇을 적어야 작은 모델이 같은 결과를 내는가
- 고가 GPU를 늘리지 않고도 쓸 만한 응답 속도가 나오는가
- 만든 스킬이 쓸 만한지는 무엇으로 판정하는가
- 우리 조직은 어떤 업무 하나로 파일럿을 시작해야 하는가
GPU 예산보다 업무 정의가 먼저인 이유
AI Agent 스킬 설계의 출발점은 모델과 장비가 아니라 업무 정의입니다. 모델과 GPU를 먼저 고르면 무엇을 시킬지와 무엇이 정답인지 정해지지 않은 채 비용부터 생기고, 장비를 들인 뒤에야 시범 업무를 찾고 프롬프트를 덧붙이게 됩니다. 그사이 요청마다 입력 토큰 소비가 늘고 같은 질문에도 답이 달라져 담당자가 결과를 다시 확인합니다. 백서는 스킬을 만드는 일과 매일 실행하는 일을 나눕니다. 만드는 일은 스킬마다 한 번이면 되지만 높은 추론 능력이 필요해 프론티어 AI(현재 가장 높은 추론 성능을 내는 상용 대형 모델)가 맡고, 실행은 판단이 코드에 들어 있으므로 조직 안의 작은 모델로 충분합니다.
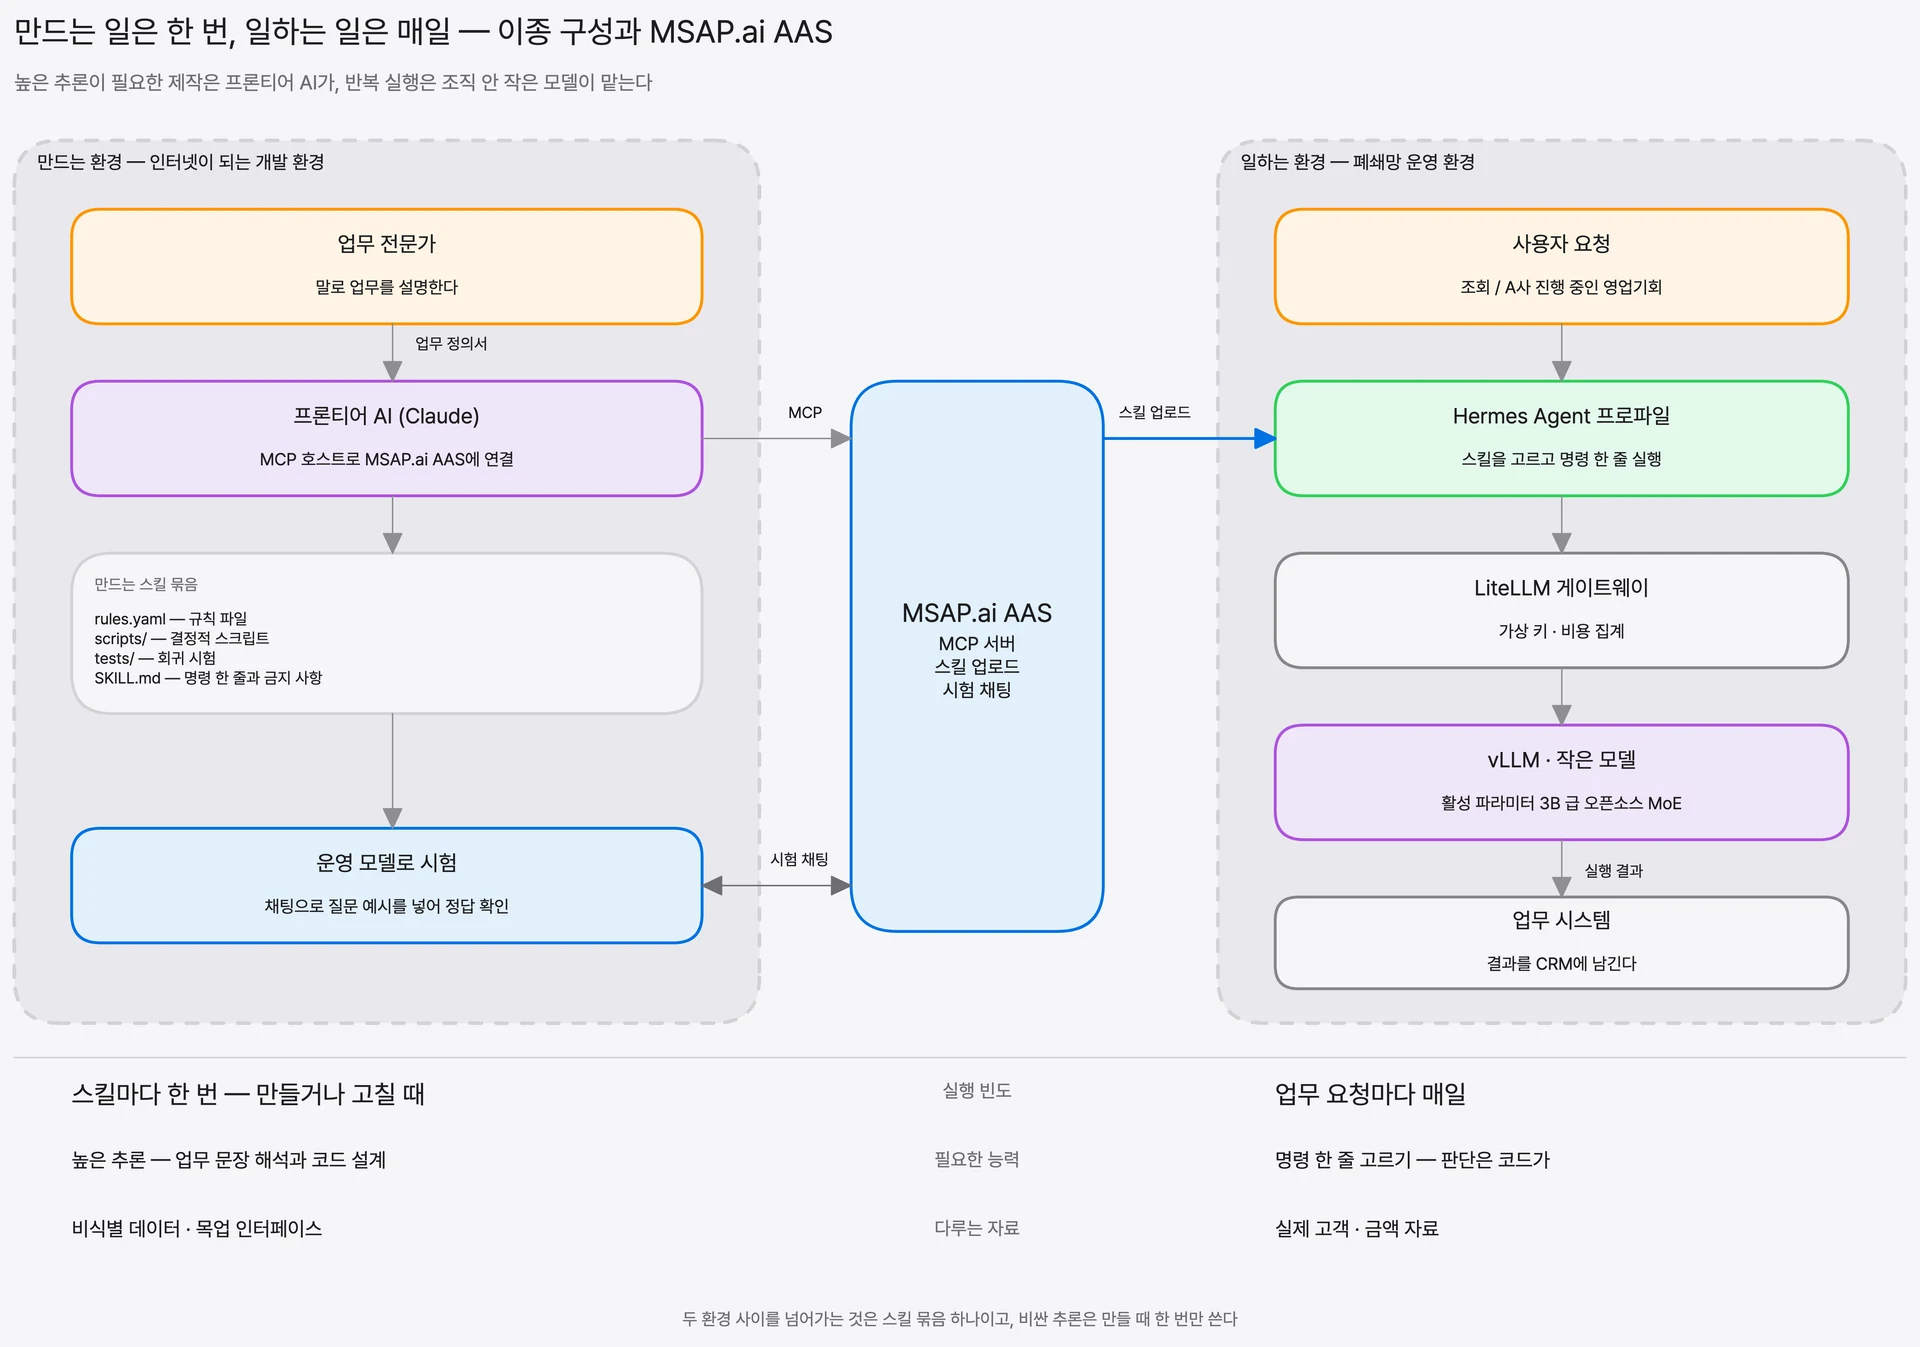
▲ 만드는 환경의 프론티어 AI와 일하는 환경의 작은 모델을 MSAP.ai AAS가 잇는 이종 구성 (백서 11쪽)
그림은 만드는 환경에서 한 번 만든 스킬이 운영 환경에서 요청마다 실행되는 이종 구성을 보여 줍니다.
그래서 업무 전문가가 스킬 작성을 맡을 수 있는지는 코딩 역량이 아니라 지시문 해석, 결정적 코드, 질문 예시를 담은 업무 정의서를 쓸 수 있는지로 판단합니다. 예산을 먼저 배정할 대상도 업무를 정의하는 시간과 그 정의를 스킬로 바꾸는 설계 작업이며, 운영 모델의 크기와 GPU 규모는 그 뒤에 정해도 늦지 않습니다.
업무 전문가가 쓰는 업무 정의서 한 장의 구조
AI Agent 스킬 설계에서 판단 기준을 가장 정확히 아는 사람은 개발자가 아니라 업무 전문가(코드를 쓰지 않아도 판단 기준과 예외를 가장 잘 아는 현업 담당자)입니다. 업무 전문가는 업무 정의서 한 장을 채우고, 프론티어 AI는 그 문장을 규칙 파일, 결정적 스크립트, 회귀 시험, 짧은 SKILL.md로 옮깁니다. 문장에 입력값, 처리 규칙, 완료 상태가 모두 있어야 코드로 옮겨지고, 하나라도 빠지면 운영 모델이 그 부분을 매번 추측합니다.
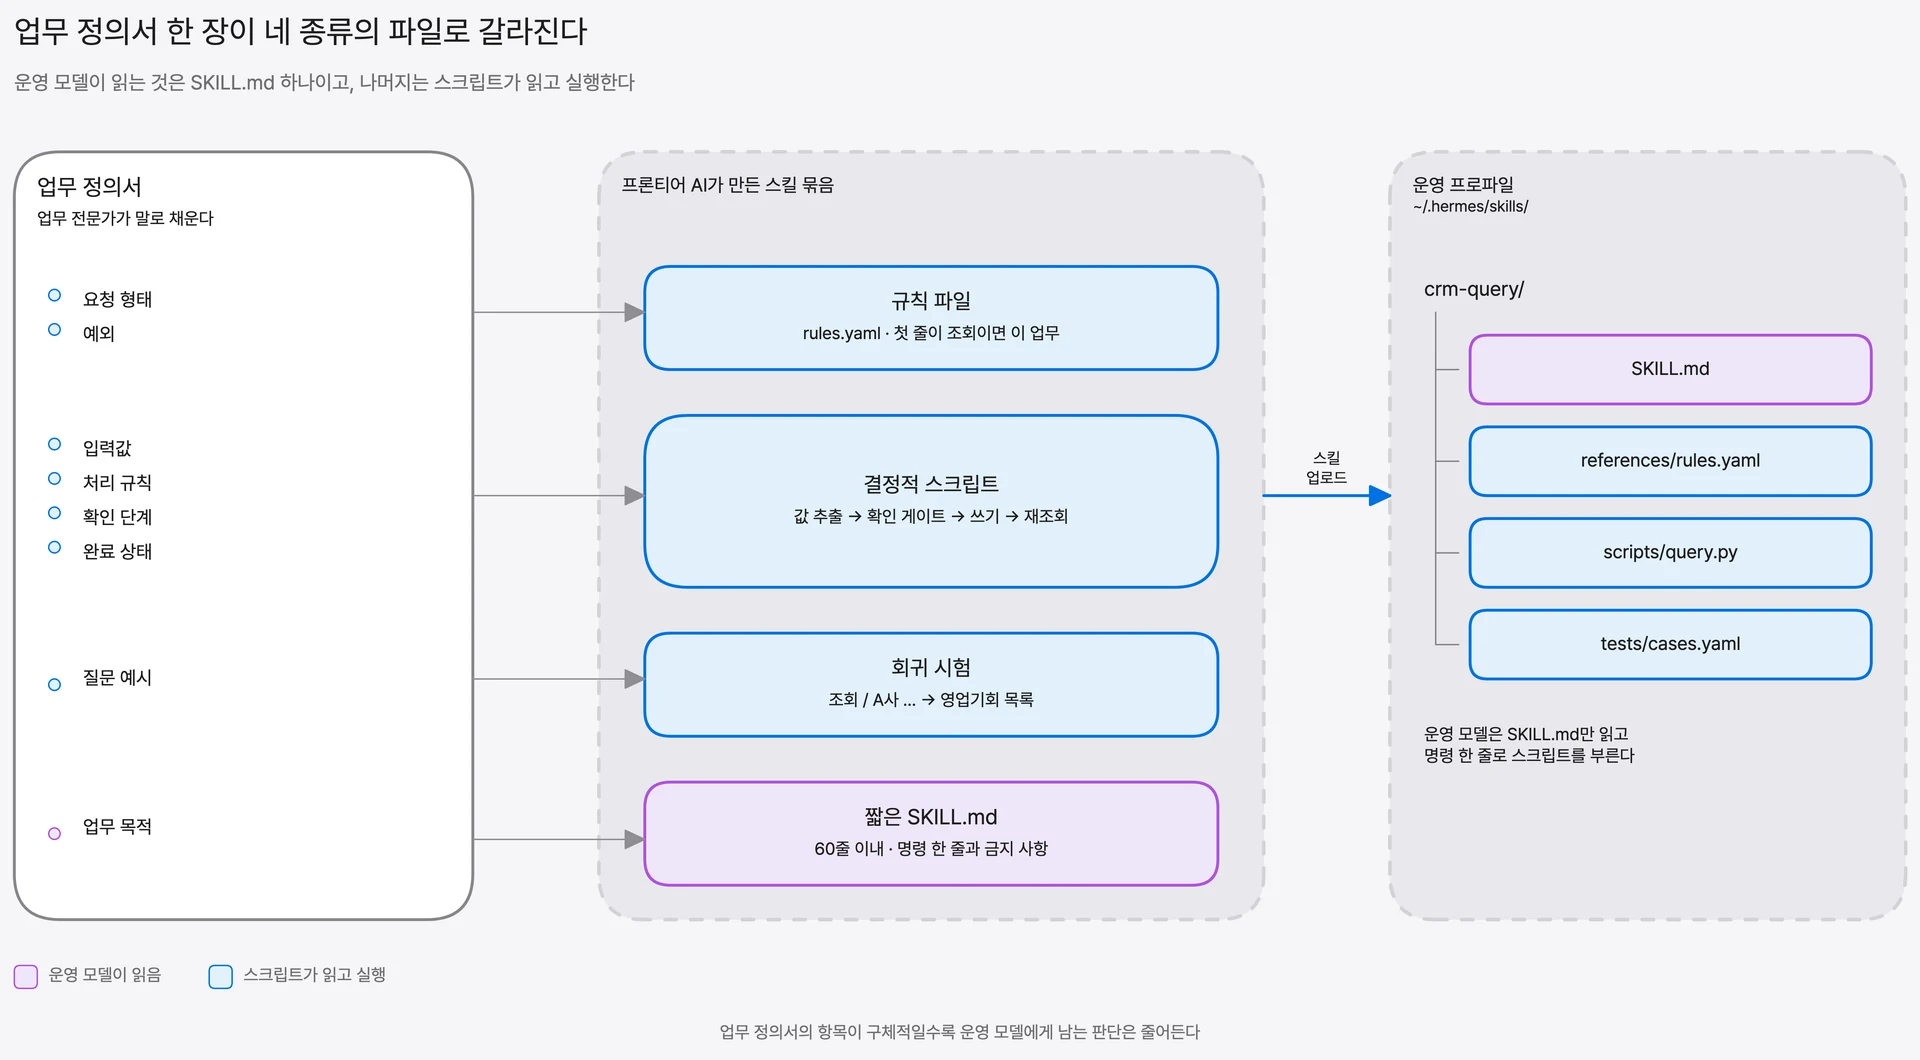
▲ 업무 전문가의 업무 정의서 항목이 규칙 파일, 결정적 스크립트, 회귀 시험, 짧은 SKILL.md로 바뀌어 운영 프로파일에 배치되는 흐름 (백서 22쪽)
| 업무 정의서 항목 | 바뀌는 산출물 | 이어지는 지시 |
|---|---|---|
| 요청 형태 | 지시문 해석 규칙표 | 지시문 해석 |
| 입력값·처리 규칙·예외 | 값 추출·진행 스크립트 | 결정적 코드 |
| 확인 단계·완료 상태 | 확인 게이트·재조회 검증 코드 | 결정적 코드 |
| 질문 예시 | 회귀 시험 묶음 | 질문 예시 |
| 금지 사항 | SKILL.md 금지 항목 | 결정적 코드 |
여덟 항목 가운데 여섯 항목이 코드로 바뀌고, SKILL.md에는 명령 한 줄과 금지 사항 정도만 남습니다. 분량이 가장 많아야 할 항목은 질문 예시입니다.
이미 정리해 둔 업무 표준 문서가 있다면 그 문서가 업무 정의서의 재료가 됩니다. 그래서 도입 검토 항목은 개발 인력이 있는가보다 업무 규칙이 문장으로 정리돼 있는가에 가깝습니다.
만드는 곳과 일하는 곳을 망 경계로 나누는 방식
폐쇄망 조직은 고객 정보와 금액 자료를 외부 AI 서비스로 보낼 수 없으므로, 백서는 개발 환경과 운영 환경을 망 경계로 나눕니다. 인터넷이 되는 개발 환경에서는 프론티어 AI가 비식별 데이터베이스와 목업 인터페이스로 만든 디지털 트윈(운영 시스템과 같은 모양의 개발용 복제 환경)을 상대로 스킬을 만들고 시험합니다. 두 환경을 잇는 것은 운영 쪽으로만 향하는 스킬 업로드 하나입니다. 반입은 개발 환경 시험, 묶음 확정, 반입 승인, 업로드, 설치 검사, 운영 재시험의 여섯 단계로 기록을 남기므로, 보안 담당자는 운영 스킬의 파일 해시를 승인서와 대조해 승인되지 않은 변경을 찾을 수 있습니다.
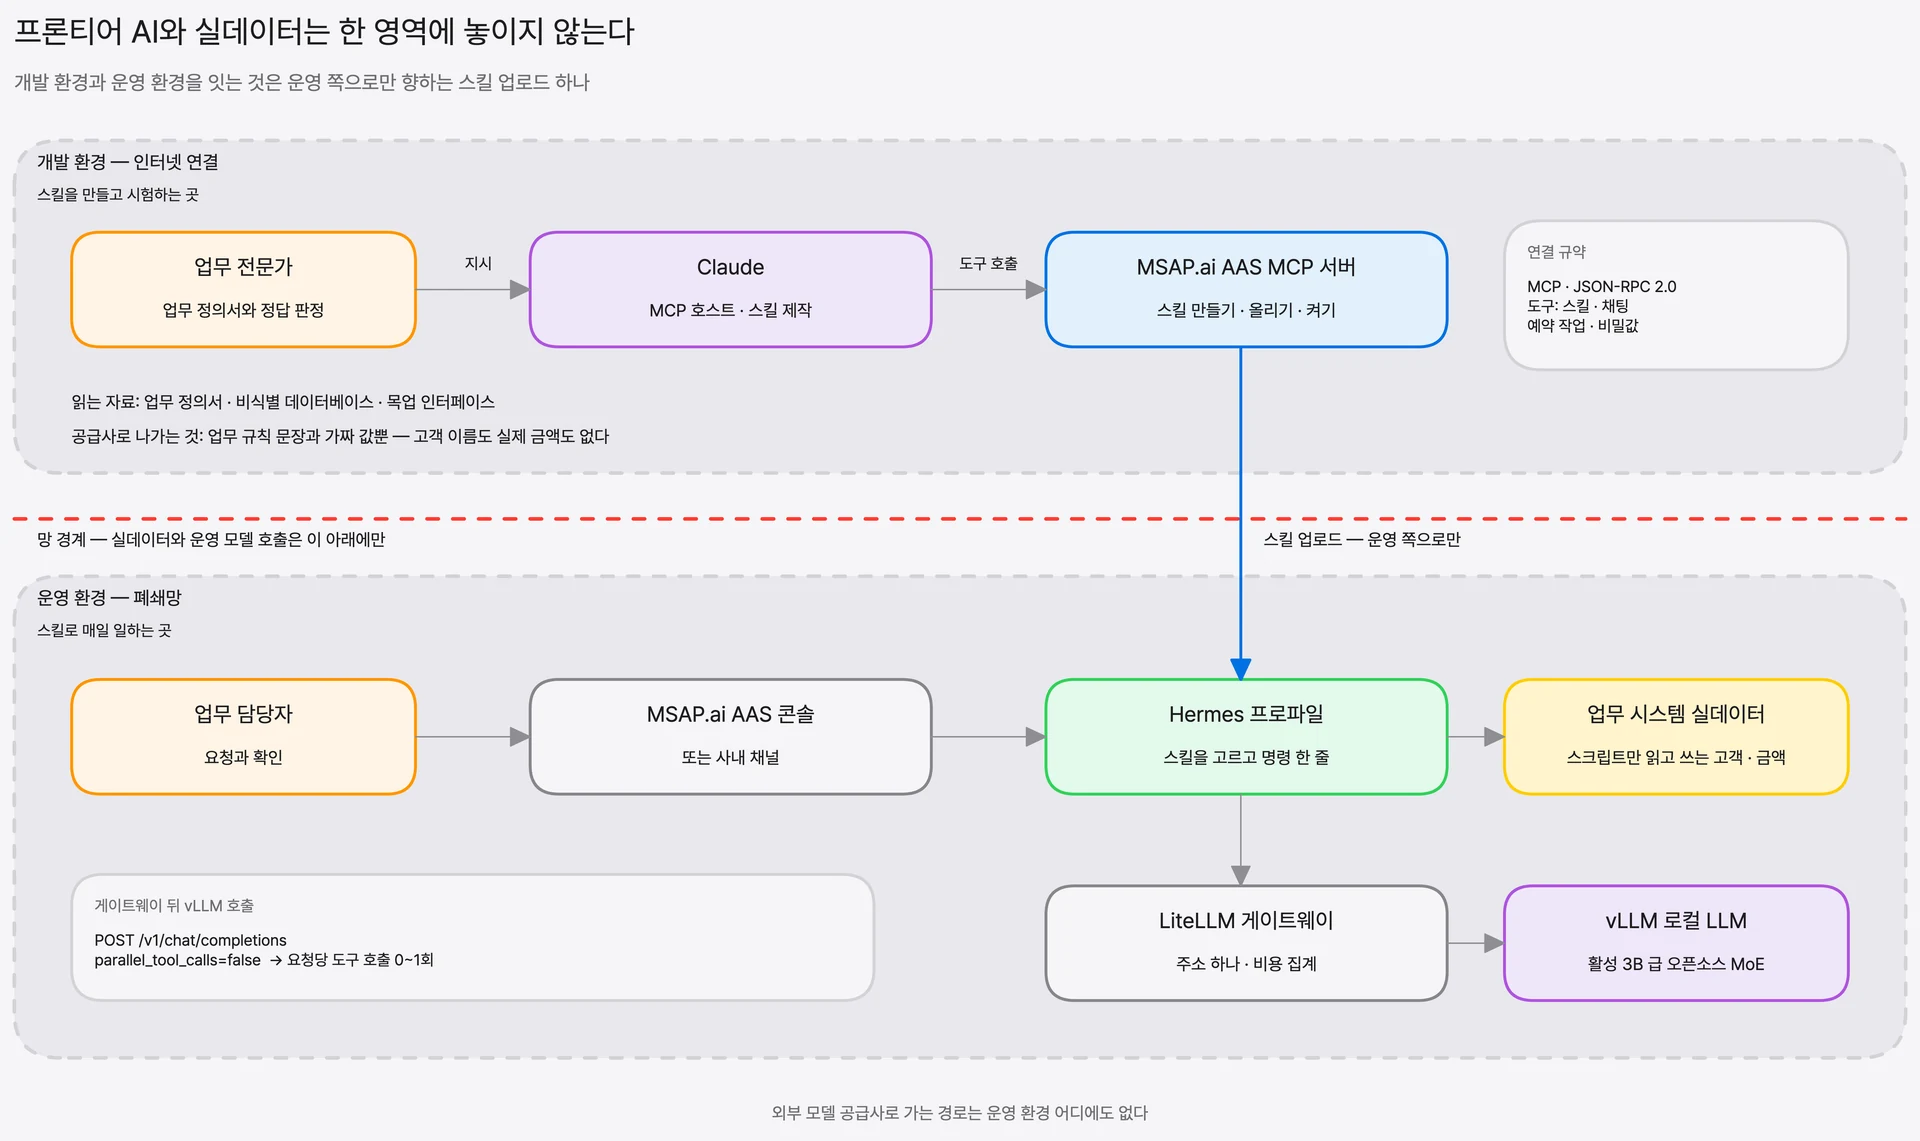
▲ 개발 환경과 운영 환경의 AI Agent 구성 (백서 26쪽)
고객·금액 자료가 밖으로 나가지 않는 게이트웨이 구조
운영 환경의 모든 모델 호출은 OpenAI 호환 사내 게이트웨이 LiteLLM 한 곳을 거쳐 vLLM으로 서빙하는 로컬 LLM에 닿습니다. 호출이 한 곳으로 모이면 보안 부서는 어떤 에이전트가 어떤 모델을 얼마나 불렀는지를 그 자리에서 보고, 외부로 가는 경로가 없다는 사실도 게이트웨이 설정으로 확인합니다. 가상 키로 부서와 사용자마다 모델, 예산, 호출 한도를 나눌 수 있어 비용 통제와 감사 추적이 같은 자리에서 이뤄집니다. AI Agent 스킬 설계가 보안 검토를 통과하는 근거가 이 구조입니다.
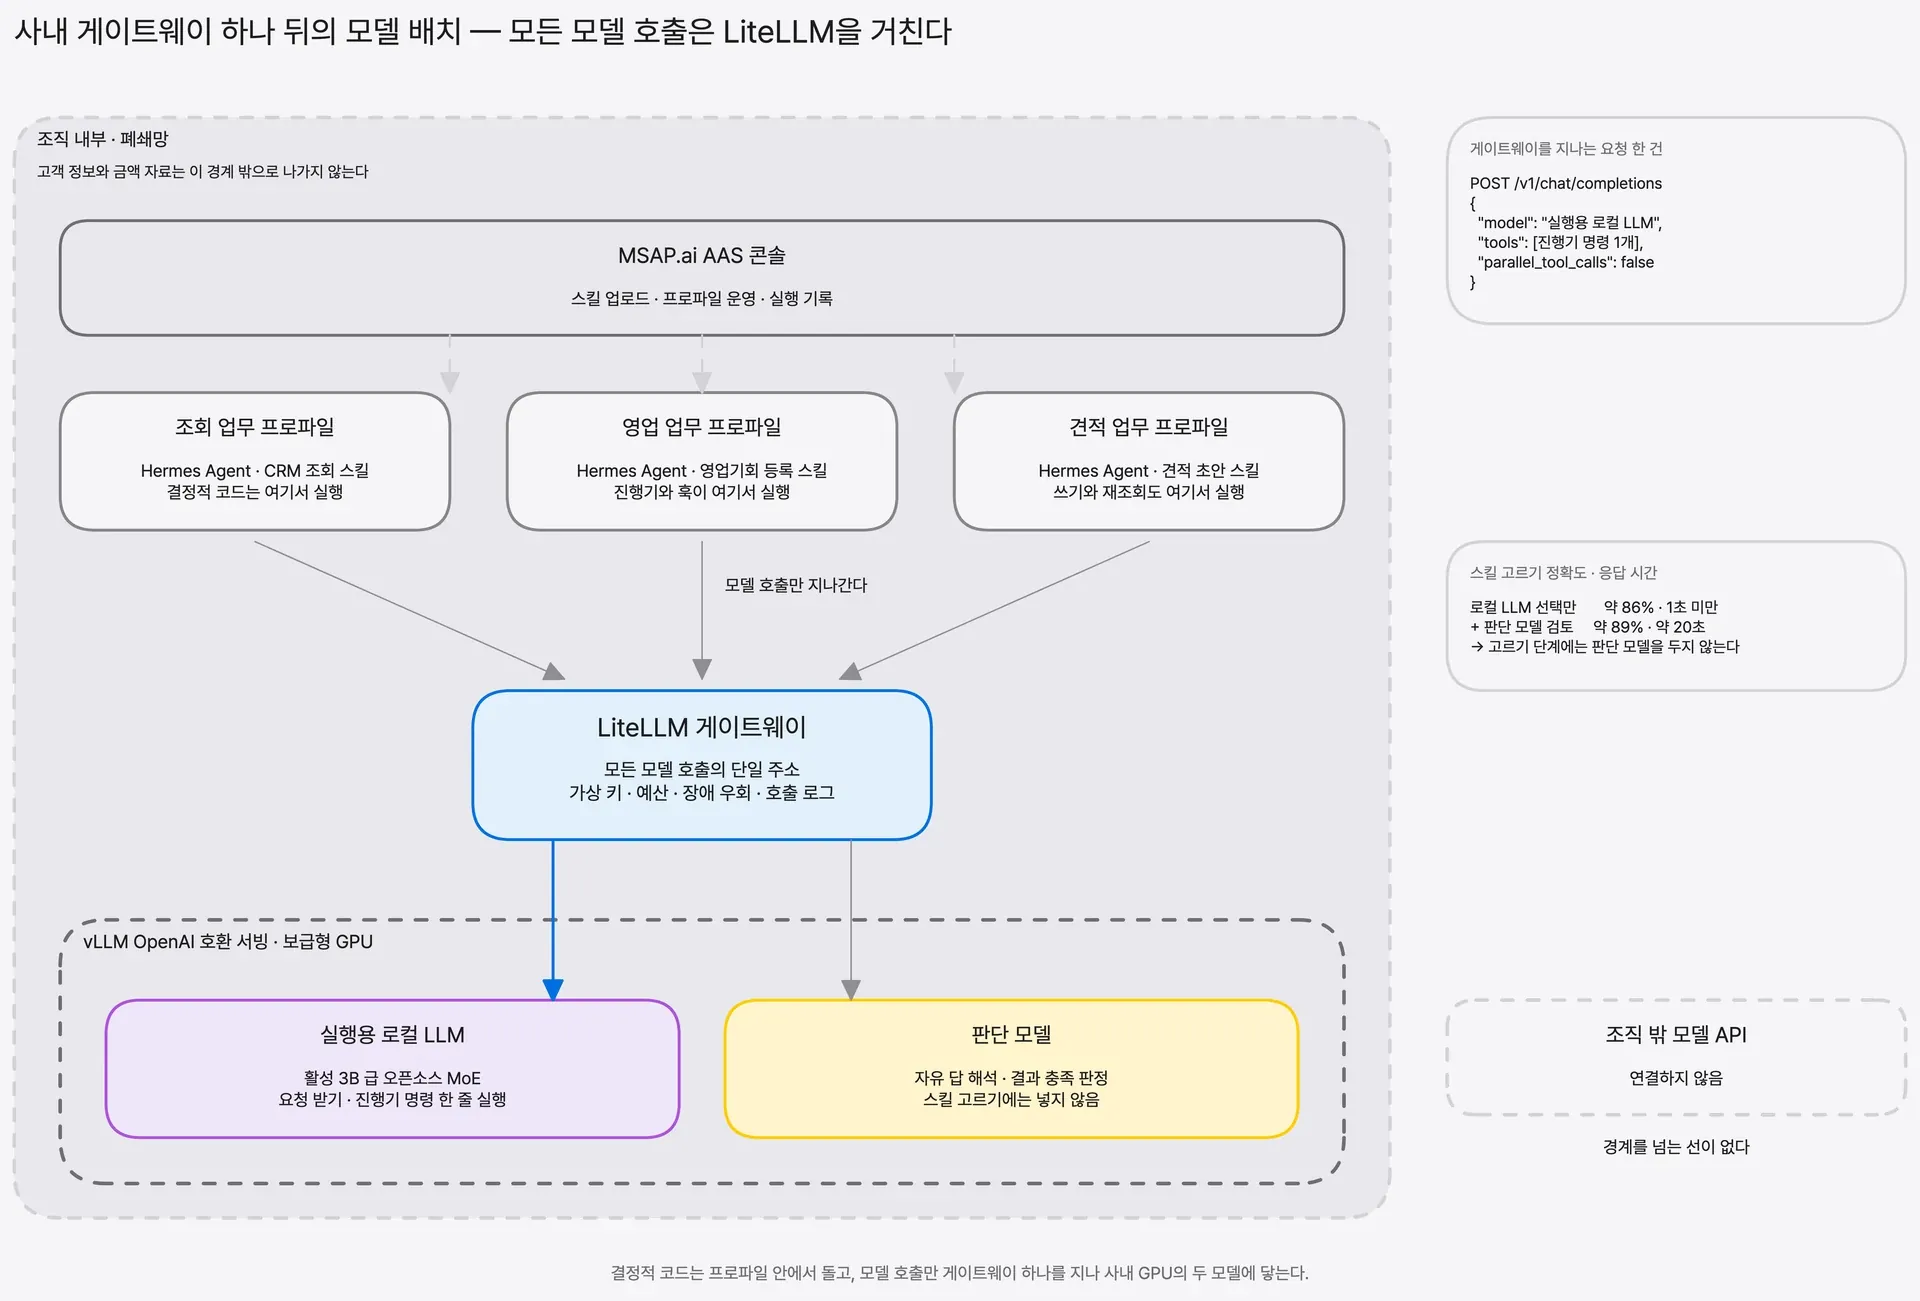
▲ 사내 게이트웨이 하나 뒤의 모델 배치 — 모든 모델 호출은 LiteLLM을 거친다 (백서 67쪽)
그림은 업무 에이전트 세 곳의 호출이 게이트웨이 하나 뒤에서 실행 모델과 판단 모델로 나뉘는 배치입니다.
프론티어 AI를 MCP로 연결해 스킬을 만드는 순서
MCP(Model Context Protocol, AI 애플리케이션이 외부 도구를 같은 규약으로 부르는 개방형 표준)에서 프론티어 AI는 호스트, MSAP.ai AAS는 서버를 맡습니다. 그래서 AI Agent 스킬 설계의 제작 단계에서 업무 전문가는 대화창 하나에서 스킬 생성, 업로드, 활성화, 시험 요청까지 이어 갑니다. 순서는 업무 정의서 제시, 규칙·스크립트·시험 생성, 짧은 SKILL.md 확정, 등록과 활성화입니다. 시험은 프론티어 AI가 MSAP.ai AAS 채팅으로 운영 모델에 실제 요청을 보내 받은 응답으로 판정합니다. 프론티어 AI가 자기 환경에서 잘 돌렸다는 사실은 작은 모델에서도 같은 결과가 나온다는 보장이 아니기 때문입니다.
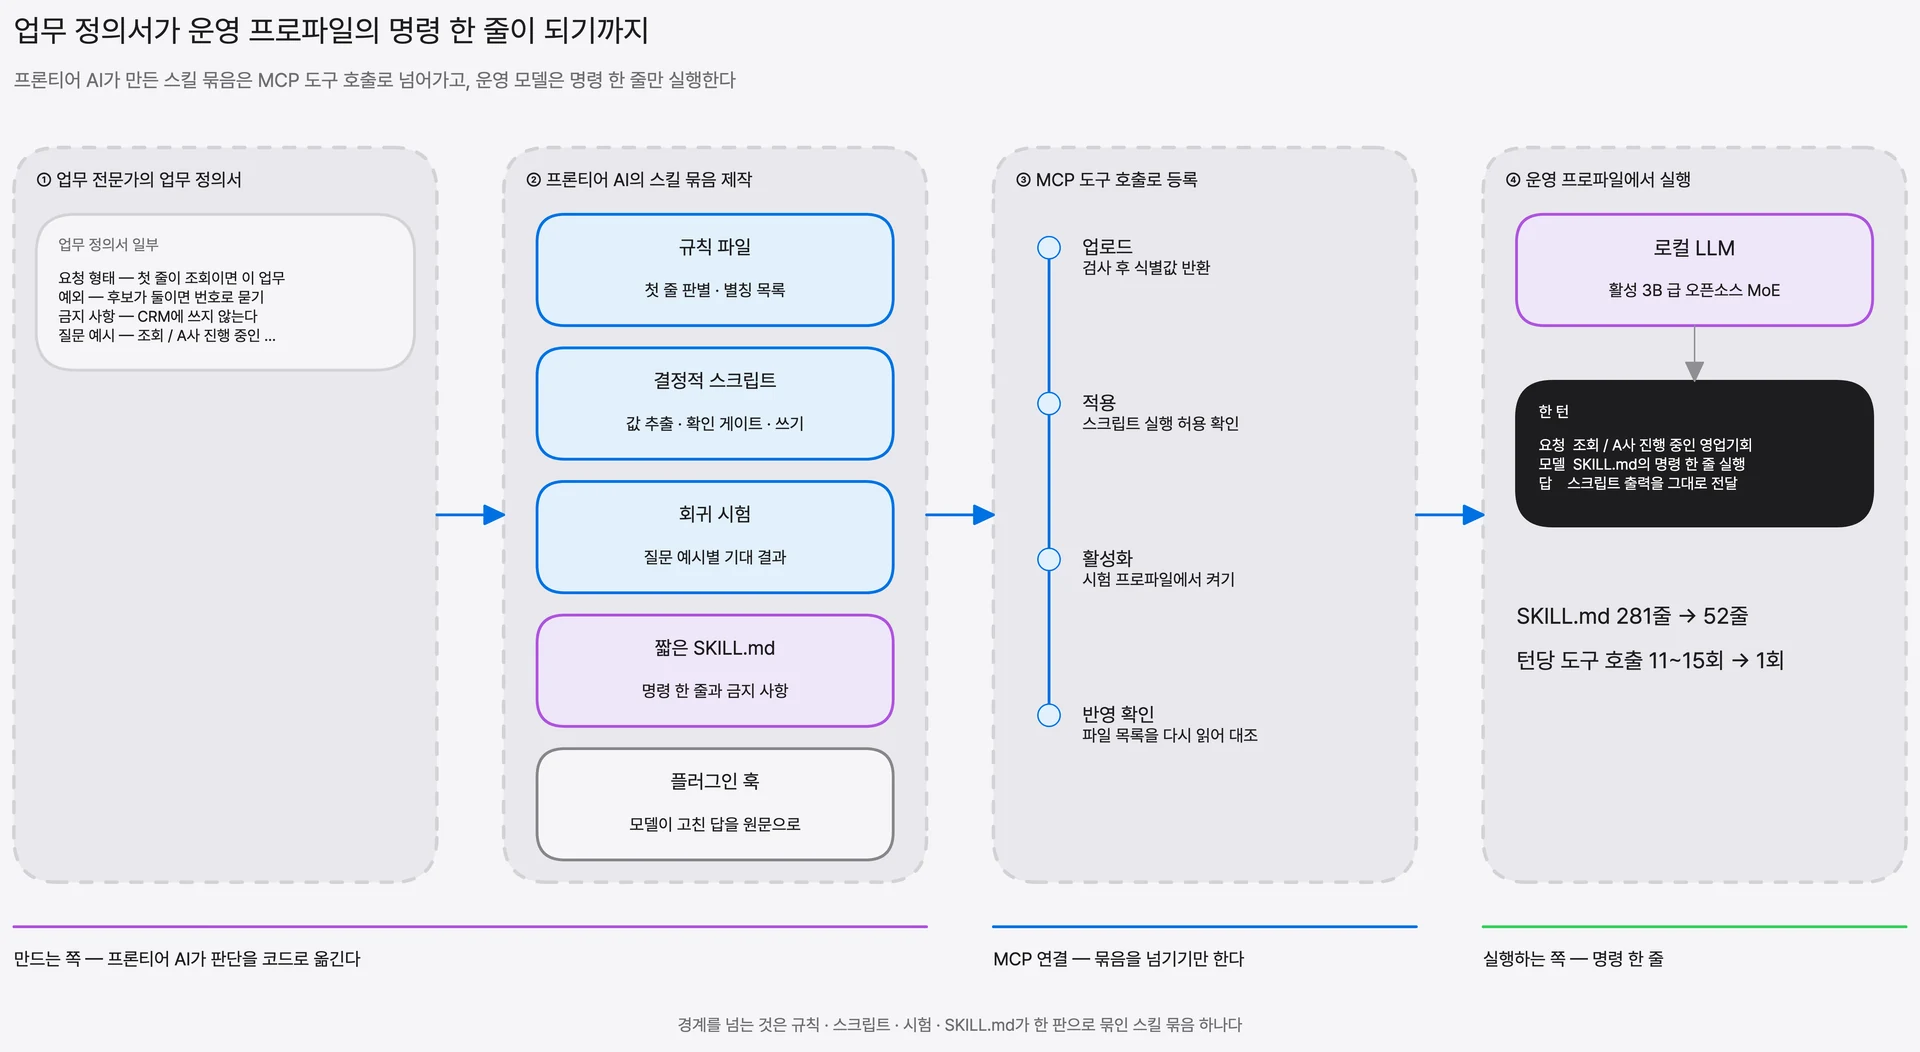
▲ 프론티어 AI가 만든 스킬 묶음이 MCP를 거쳐 운영 프로파일로 전달되는 순서 (백서 40쪽)
제작 반복 동안 도구 호출이 수십 번 일어나므로 MCP 명세가 요구하는 사용자 동의와 비밀값 분리 보관을 처음부터 지켜야 반입 승인을 받을 수 있습니다.
작은 모델이 같은 결과를 내게 하는 세 가지 지시 방식
프론티어 AI는 따로 지시받지 않으면 자기 수준에서 읽기 쉬운 스킬을 만들고, 그런 스킬은 긴 설명을 읽고 도구를 엮는 일을 작은 모델에 넘깁니다. AI Agent 스킬 설계에서 프론티어 AI에게 꼭 적어야 할 지시는 셋입니다.
- 지시문 해석: 요청 첫 줄로 부를 명령을 코드가 고르고, 판별할 수 없으면 정해진 질문을 출력한 뒤 멈춥니다.
- 결정적 코드: 값 추출, 후보 선정, 확인 게이트, 쓰기, 재조회 검증을 스크립트로 옮깁니다.
- 질문 예시: 실제 요청의 여러 꼴과 기대 결과를 묶어 회귀 시험으로 고정합니다.
「결정적 코드로 작성하라」는 한 줄만 준 대조에서는 SKILL.md가 142줄에서 62줄로 줄었지만 확인 게이트와 모호한 값 판단은 모델 몫으로 남았습니다. 그래서 스킬을 받는 쪽은 판단 목록이 코드로 옮겨졌는지, 확인 게이트를 코드가 쥐는지를 점검해야 합니다.
보급형 GPU의 응답 시간을 바꾸는 두 가지 조건
토큰을 하나씩 만드는 디코드 단계는 계산보다 메모리에서 가중치를 옮기는 속도가 지연을 정합니다. 그래서 장비 등급보다 토큰마다 읽는 파라미터 수가 중요하고, 이 값을 줄인 구조가 MoE(전문가 혼합, 요청마다 일부 전문가만 계산하는 모델 구조)입니다. 공개 모델 Qwen3-30B-A3B는 전체 30.5B 가운데 3.3B만 활성화합니다. 같은 소형 AI 서버에서 모델 구조만 바꾼 관찰값은 아래와 같습니다.
| 항목 | dense 27B 급 | 활성 3B 급 MoE |
|---|---|---|
| 초당 생성 토큰(근사치) | 약 12토큰 | 약 37~44토큰 |
| 300토큰 답변 생성(어림) | 약 25초 | 약 7~8초 |
한 업무 에이전트를 운영하며 관찰한 근사치이며 장비, 양자화, 동시 요청 수에 따라 달라집니다. 다만 도구를 15번 부르는 스킬은 MoE로 바꿔도 디코드에만 40초 안팎이 남으므로, MoE 전환과 호출 횟수를 1회 안팎으로 줄이는 설계가 함께 있어야 사람이 기다릴 수 있는 응답 시간이 나옵니다.
판단은 코드, 모델은 한 줄 실행으로 나누는 역할 기준
백서의 설계 원칙은 판단은 코드, 모델은 한 줄 실행입니다. 라우팅, 값 추출, 확인 게이트, 멱등 쓰기, 재조회는 결정적 코드가 맡고, 로컬 LLM은 사람의 말을 받아 명령 한 줄을 실행하는 입구가 됩니다. 판단 모델(결과가 요청을 충족했는지 판정하는 별도 모델)은 시간을 들인 만큼 이득이 큰 자리에만 둡니다. 스킬 고르기에 판단 모델을 더하자 정확도는 약 86%에서 89%로 올랐지만 응답 시간이 1초 미만에서 약 20초로 늘었습니다. 그래서 고르기에는 넣지 않고, 결과 충족 판정에만 씁니다.
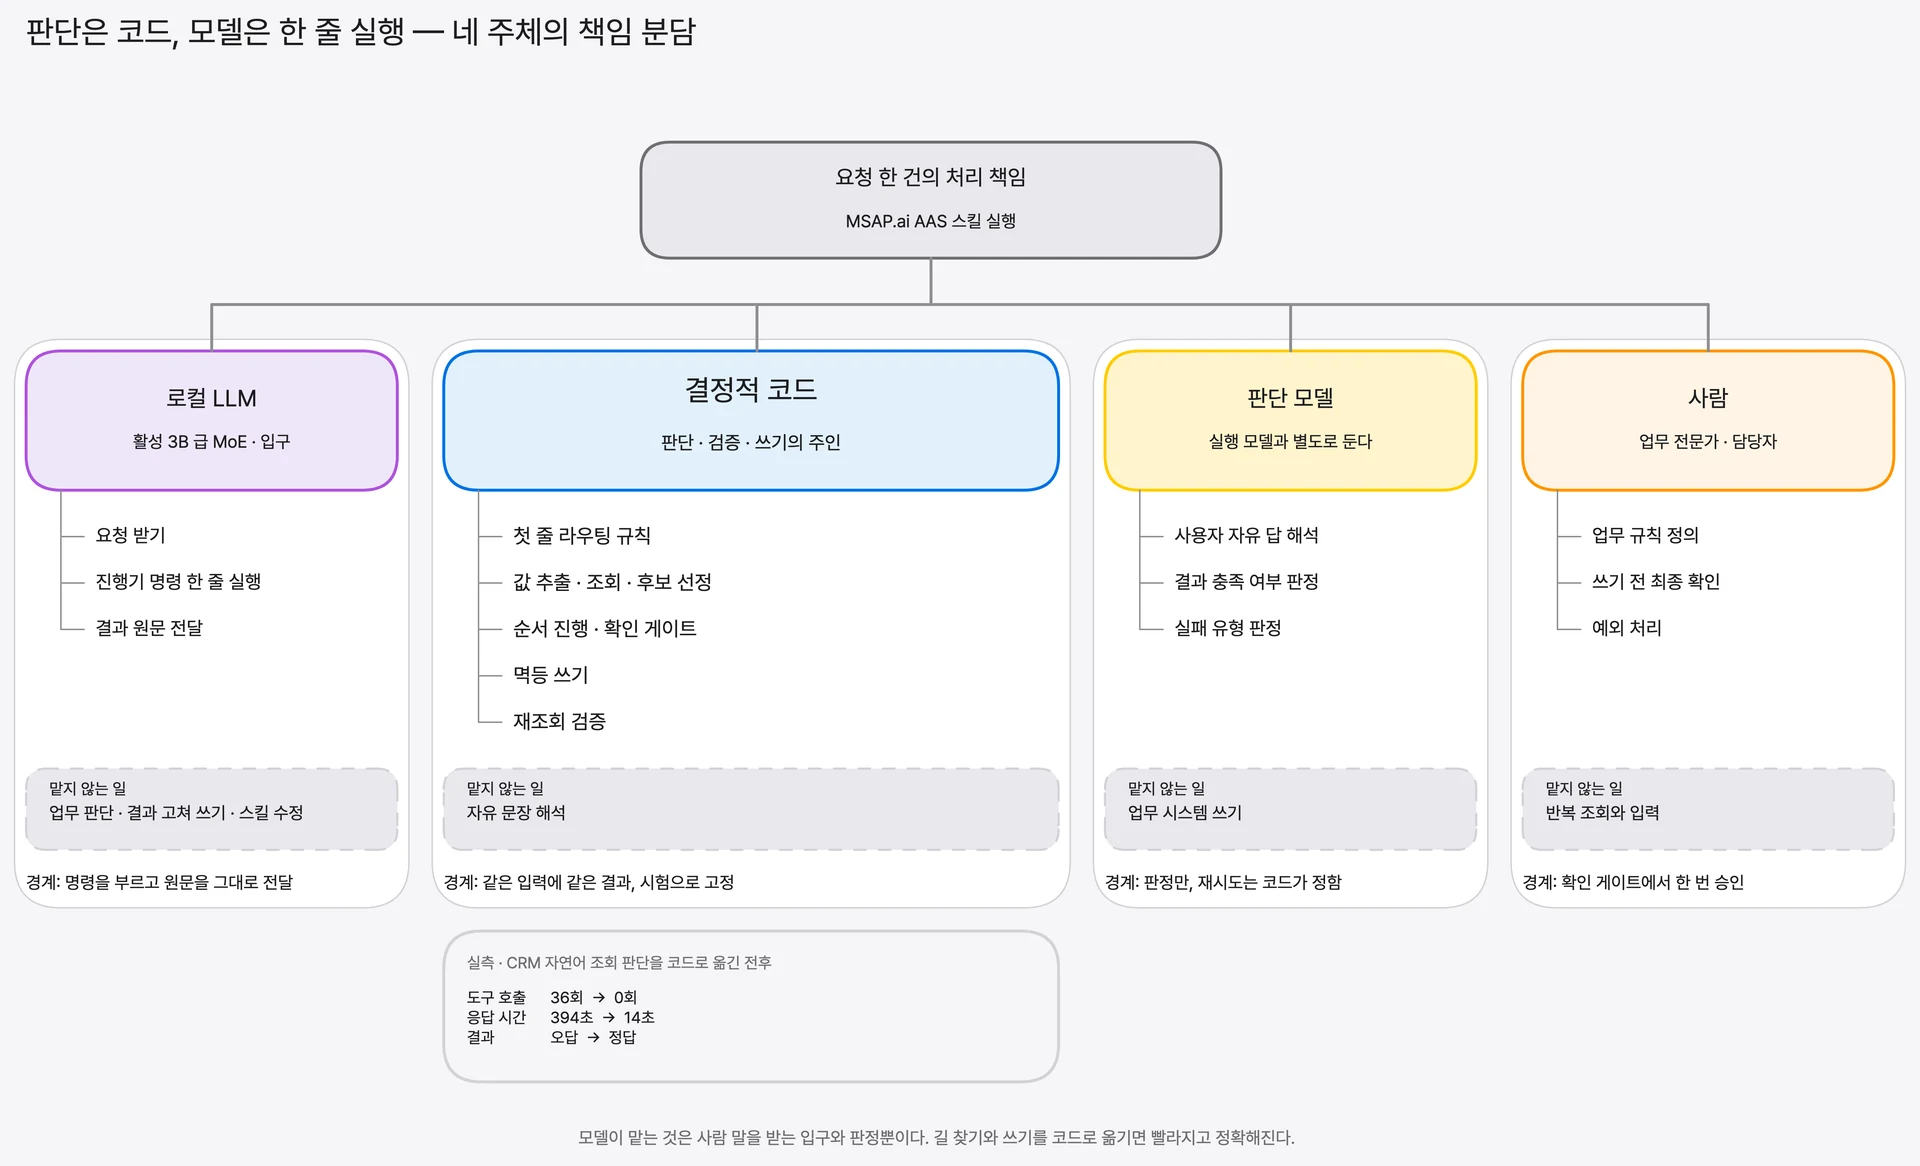
▲ 판단은 코드, 모델은 한 줄 실행 — 코드·로컬 LLM·판단 모델·사람이 맡는 일 (백서 65쪽)
사람은 규칙 정의와 쓰기 전 최종 확인을 맡고, 업무 책임도 사람에게 남습니다.
코드로 옮긴 뒤 남는 공백 세 곳을 훅으로 막는 방법
판단을 코드로 옮긴 스킬도 실행 모델이 작으면 세 곳에서 어긋납니다. 맞지 않는 스킬로 들어가는 라우팅, 진행기가 만든 문구를 모델이 고쳐 쓰는 전달 충실도, 대화가 끝난 뒤 배경 검토에서 모델이 스킬 파일을 고치는 자가 수정입니다. 마지막 문제는 에이전트가 스킬을 스스로 만들고 고치게 하는 오픈소스 Hermes Agent의 절차 기억 기능에서 나옵니다. MSAP.ai AAS는 이 세 공백을 모델 호출 전, 도구 호출 전, 출력 직후에 실행되는 플러그인 훅으로 막습니다.
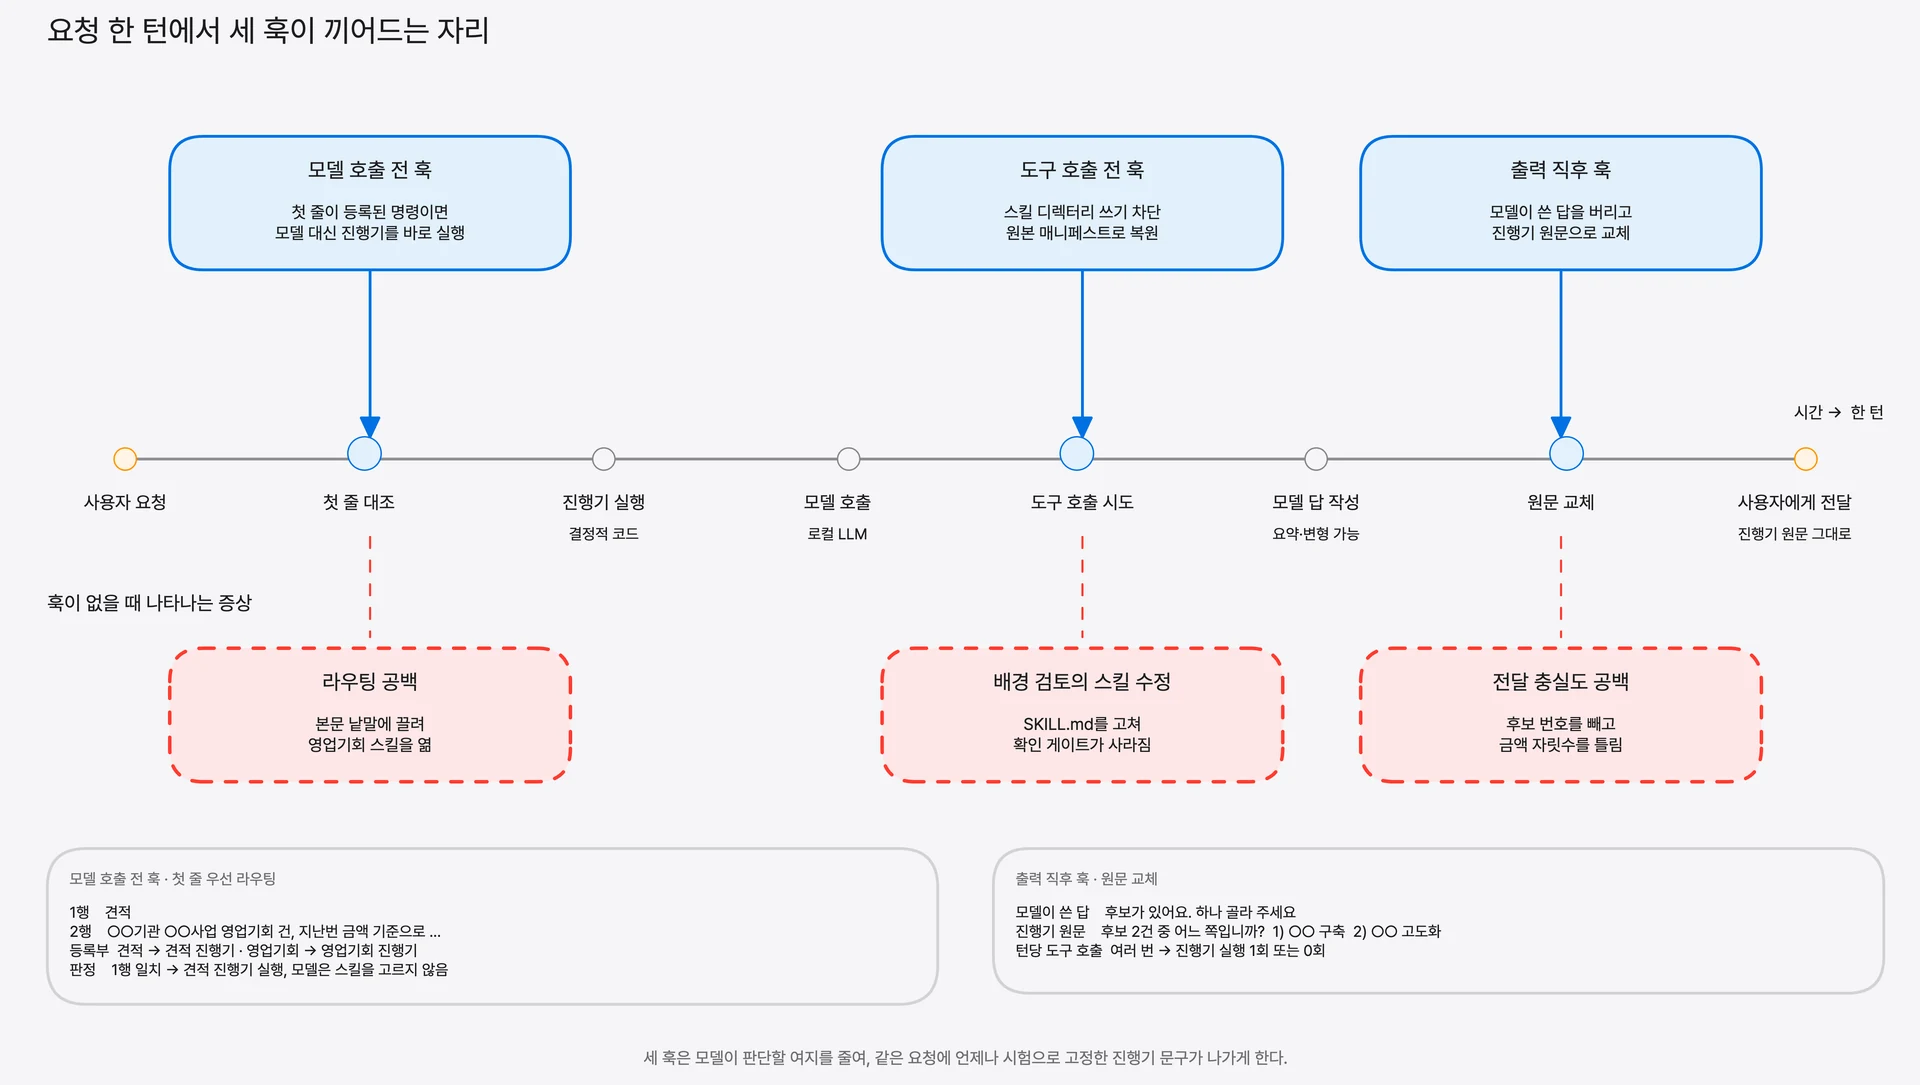
▲ 요청 한 턴에서 모델 호출 전·도구 호출 전·출력 직후 훅이 하는 일 (백서 68쪽)
그림은 요청 한 턴의 시간축에서 세 훅이 진행기 실행, 스킬 수정 차단, 원문 교체를 맡는 자리를 보여 줍니다.
차단과 복원은 스킬을 고치지 말자는 장치가 아니라 고치는 경로를 개발 환경 하나로 모으는 장치입니다. 운영에서 드러난 개선점은 개발 환경에서 프론티어 AI와 함께 고치고 회귀 시험을 다시 통과한 뒤 스킬 업로드로 들여오므로, 운영 환경에는 시험을 통과한 판본 하나만 남습니다.
영업 업무 스킬 세 건으로 본 전후 효과
백서 7장은 업무 전문가가 정의하고 프론티어 AI가 만든 영업 업무 스킬 세 건을 따라갑니다. 세 업무 모두 작은 모델에게 스킬 문서만 주었을 때는 몇 분씩 걸리고 결과가 틀렸으며, 판단을 코드로 옮긴 뒤에야 속도와 정확도가 함께 좋아졌습니다.
| 업무 | 스킬 문서만 준 구성 | 판단을 코드로 옮긴 구성 |
|---|---|---|
| CRM 자연어 조회 | 394초, 도구 호출 36회, 오답 | 14초, 도구 호출 0회, 정답 |
| 영업기회 등록 | SKILL.md 281줄, 턴당 11~15회 | 52줄, 턴당 1회, 결과 JSON 일치 |
| 견적 초안 판정 | 4B 급 판단 모델 12건 중 7건 | 판단 모델 12건 모두 정확, 약 3초 |
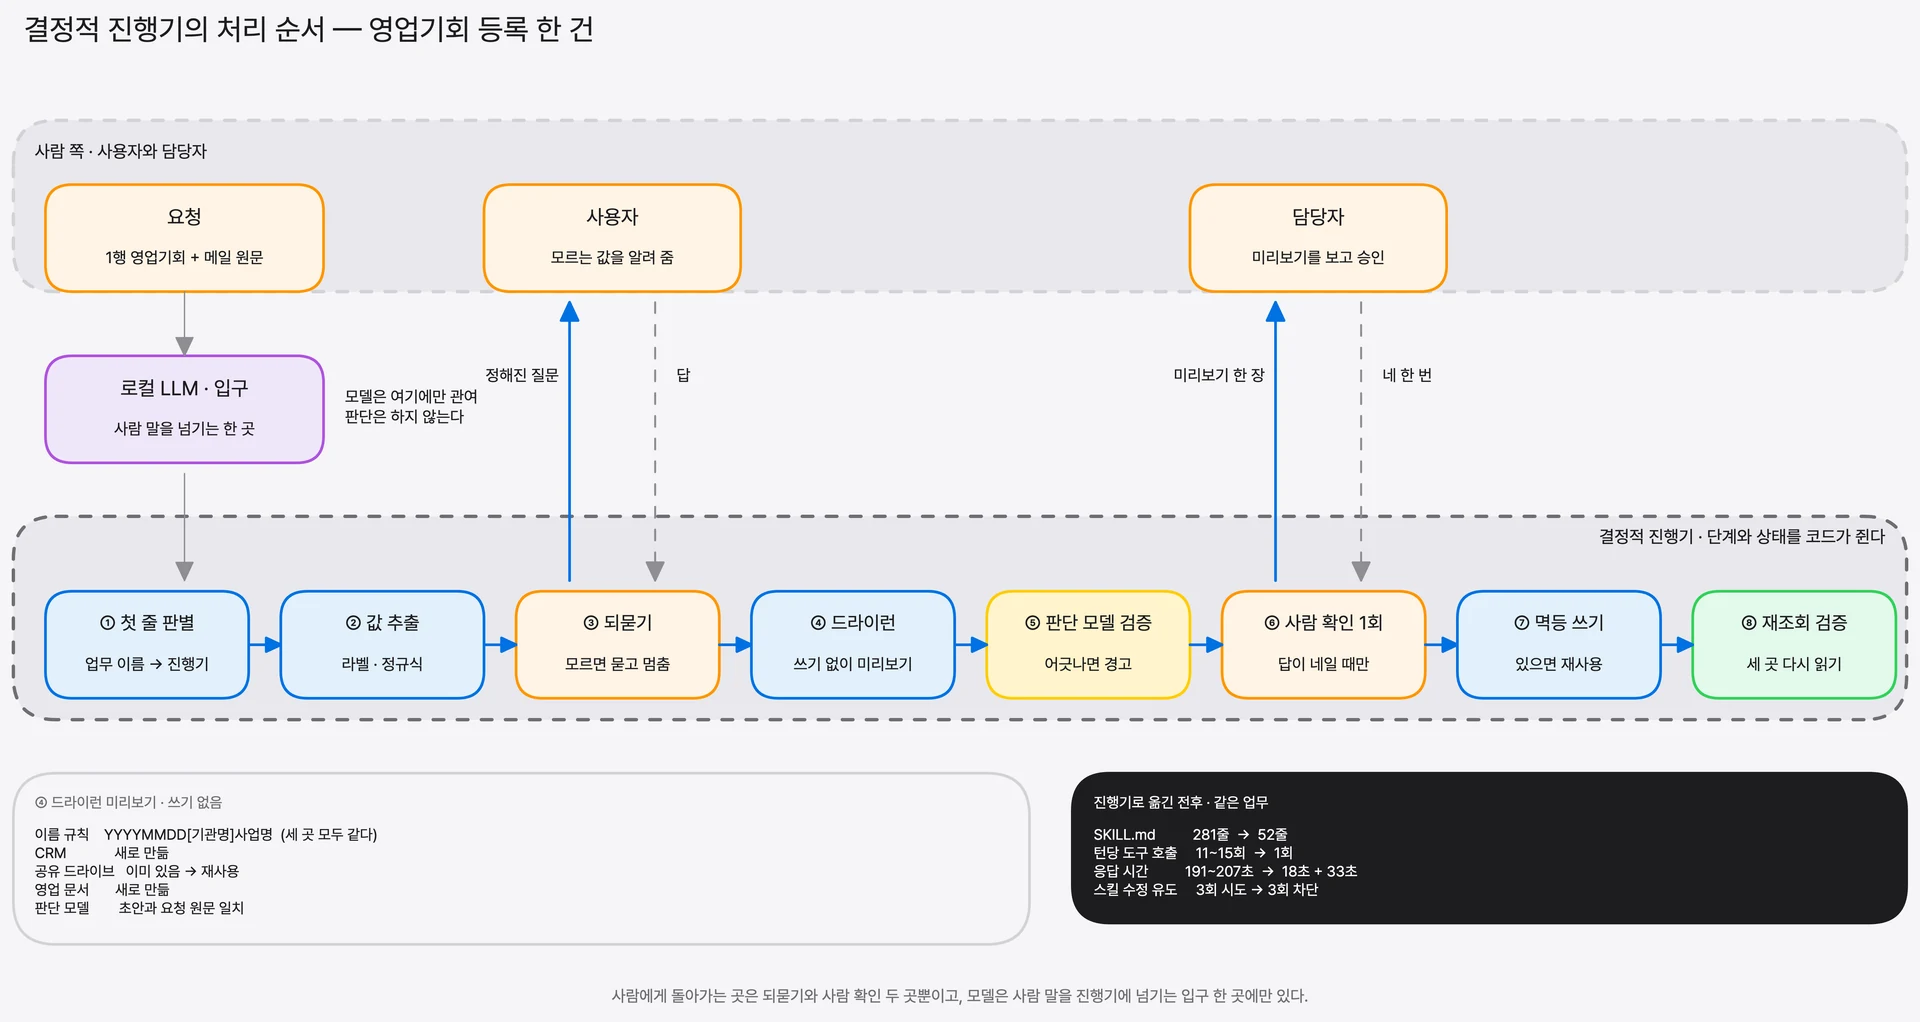
▲ 결정적 진행기의 처리 순서 — 첫 줄 판별부터 재조회 검증까지 (백서 74쪽)
영업기회 등록에서는 작은 모델이 실행한 결과 JSON이 프론티어 모델이 같은 명령을 실행한 결과와 한 글자도 다르지 않았습니다. 이 수치는 한 에이전트에서 관찰한 제품 동작이므로 조직마다 자기 업무로 다시 재야 합니다.
실행 모델 기준의 합격선과 결과 검증 흐름
AI Agent 스킬 설계의 합격 여부는 개발 환경이 아니라 실제 운영 모델에 실제 요청 문장을 넣은 결과로 판정합니다. 백서가 권하는 합격선은 도구 호출 3회 이하, 수 분 이내 응답, 정답의 세 조건이며, 세 값 모두 채팅 화면에서 읽을 수 있어 업무 전문가가 코드 없이 판정합니다. 운영 중에는 코드가 먼저 실행해 실제 생성 여부를 재조회하고, 판단 모델이 충족 여부를 판정한 뒤, 코드가 재시도 1회나 사람 이관을 고릅니다. 모델이나 업무 규칙이 바뀌면 질문 예시 회귀 시험을 다시 돌려 결과가 같은지 확인합니다.
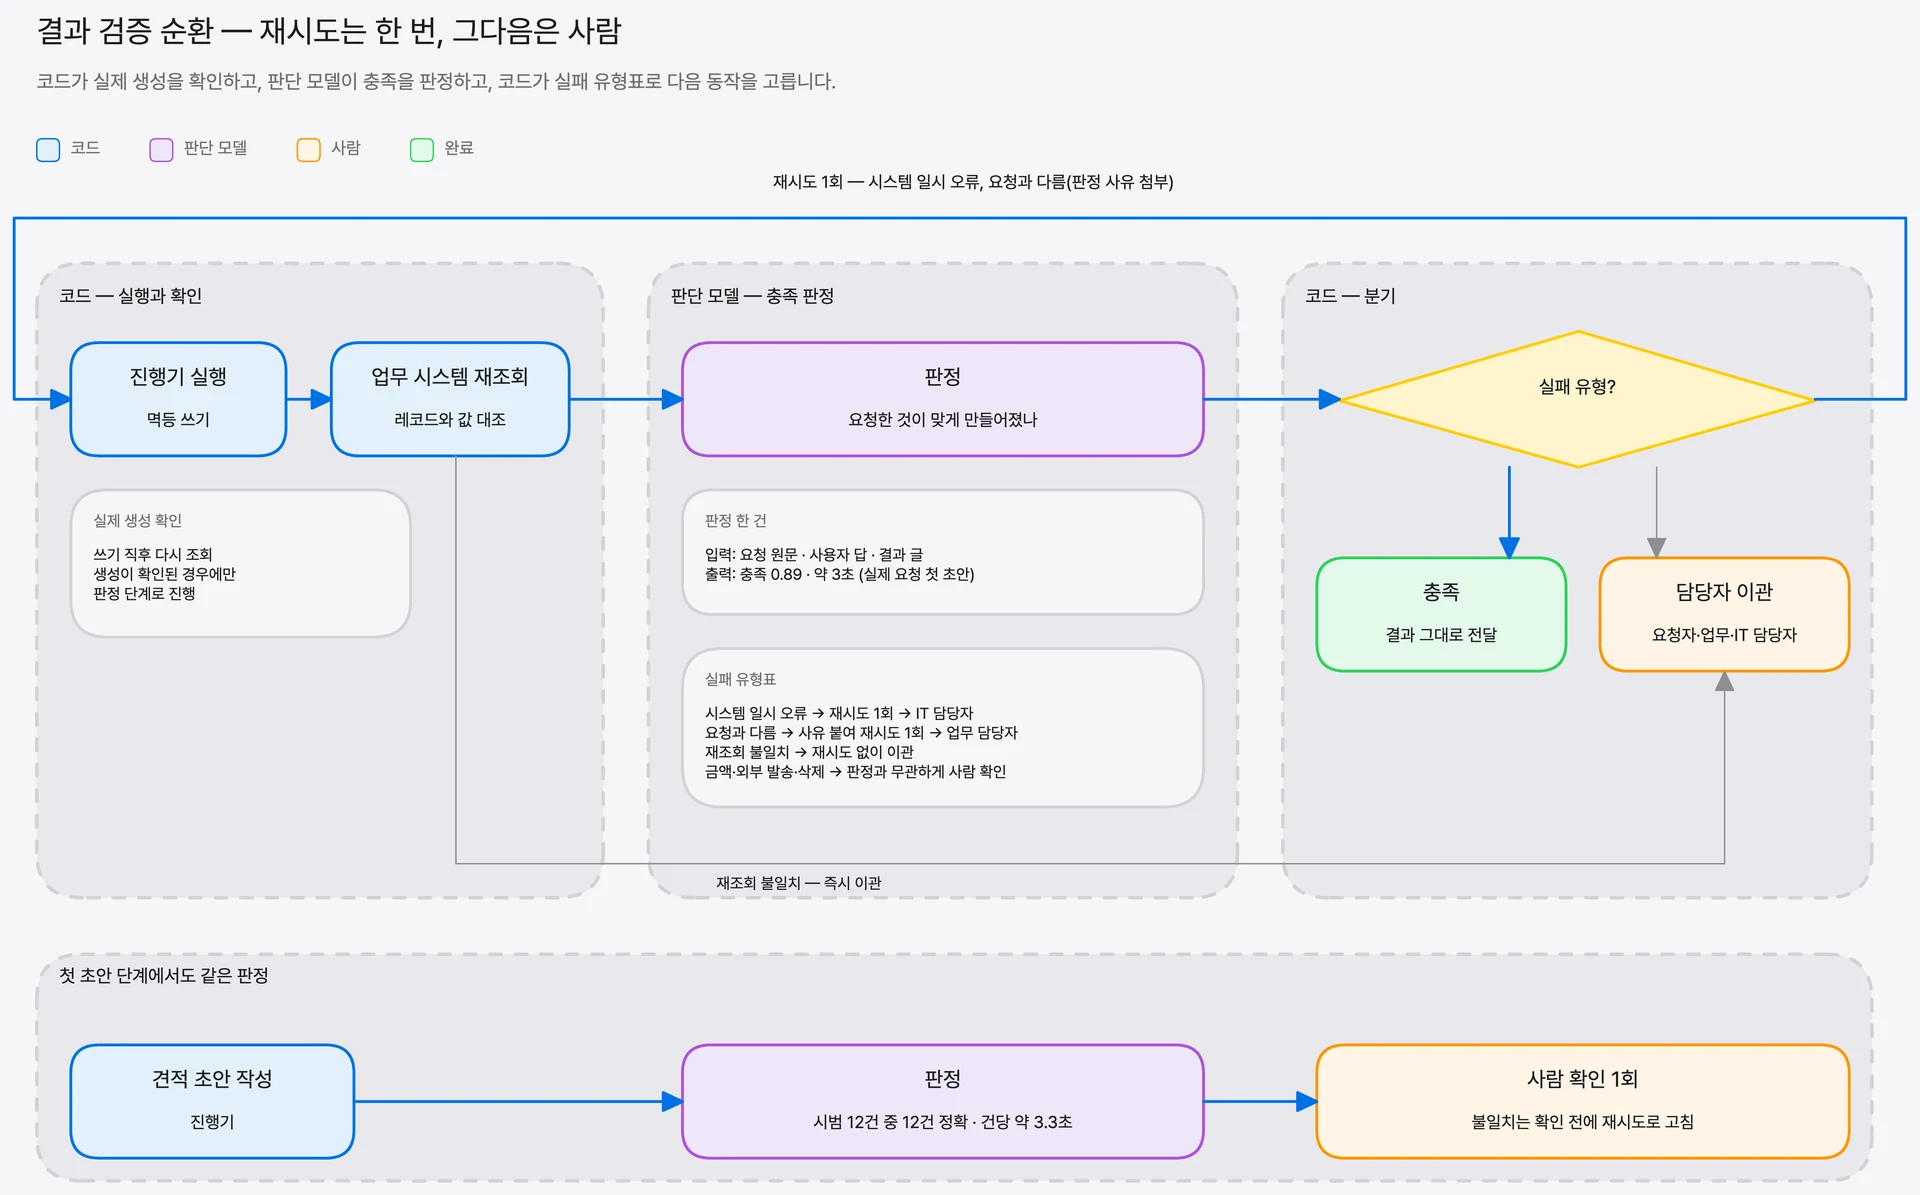
▲ 검증 순환도 — 코드 실행·실제 생성 확인, 판단 모델 판정, 재시도 1회 또는 사람 이관 (백서 85쪽)
업무가 바뀌어도 스킬 파일을 운영 환경에서 직접 고치지 않습니다. 업무와 정답의 정본은 업무 전문가가 쓴 업무 정의서와 질문 예시 묶음이므로, 정의서부터 고친 뒤 제작과 시험을 다시 거칩니다.
남은 한계와 부서 업무 하나로 시작하는 파일럿 순서
작은 모델에 아직 어려운 영역은 모호한 요청, 범용 대화, 코드로 옮기지 못한 판단입니다. 작은 모델이 에이전트 호출 대부분에 충분하다는 대표 근거도 NVIDIA 연구진의 입장 논문이라 실험 증명과 구분해 읽어야 합니다. 첫 파일럿은 반복 빈도, 규칙 명시 가능성, 결과 판정 가능성, 데이터 반출 제한을 점검해 「예」가 가장 많은 업무 하나로 고르고, 같은 점수라면 쓰기가 없는 조회 업무가 유리합니다. 순서는 업무 정의서 작성, 개발 환경 구성, 스킬 제작과 합격선 확인, 스킬 업로드 반입, 운영 측정과 부서 확산이며, GPU 규모는 업무 측정 뒤에 정합니다.
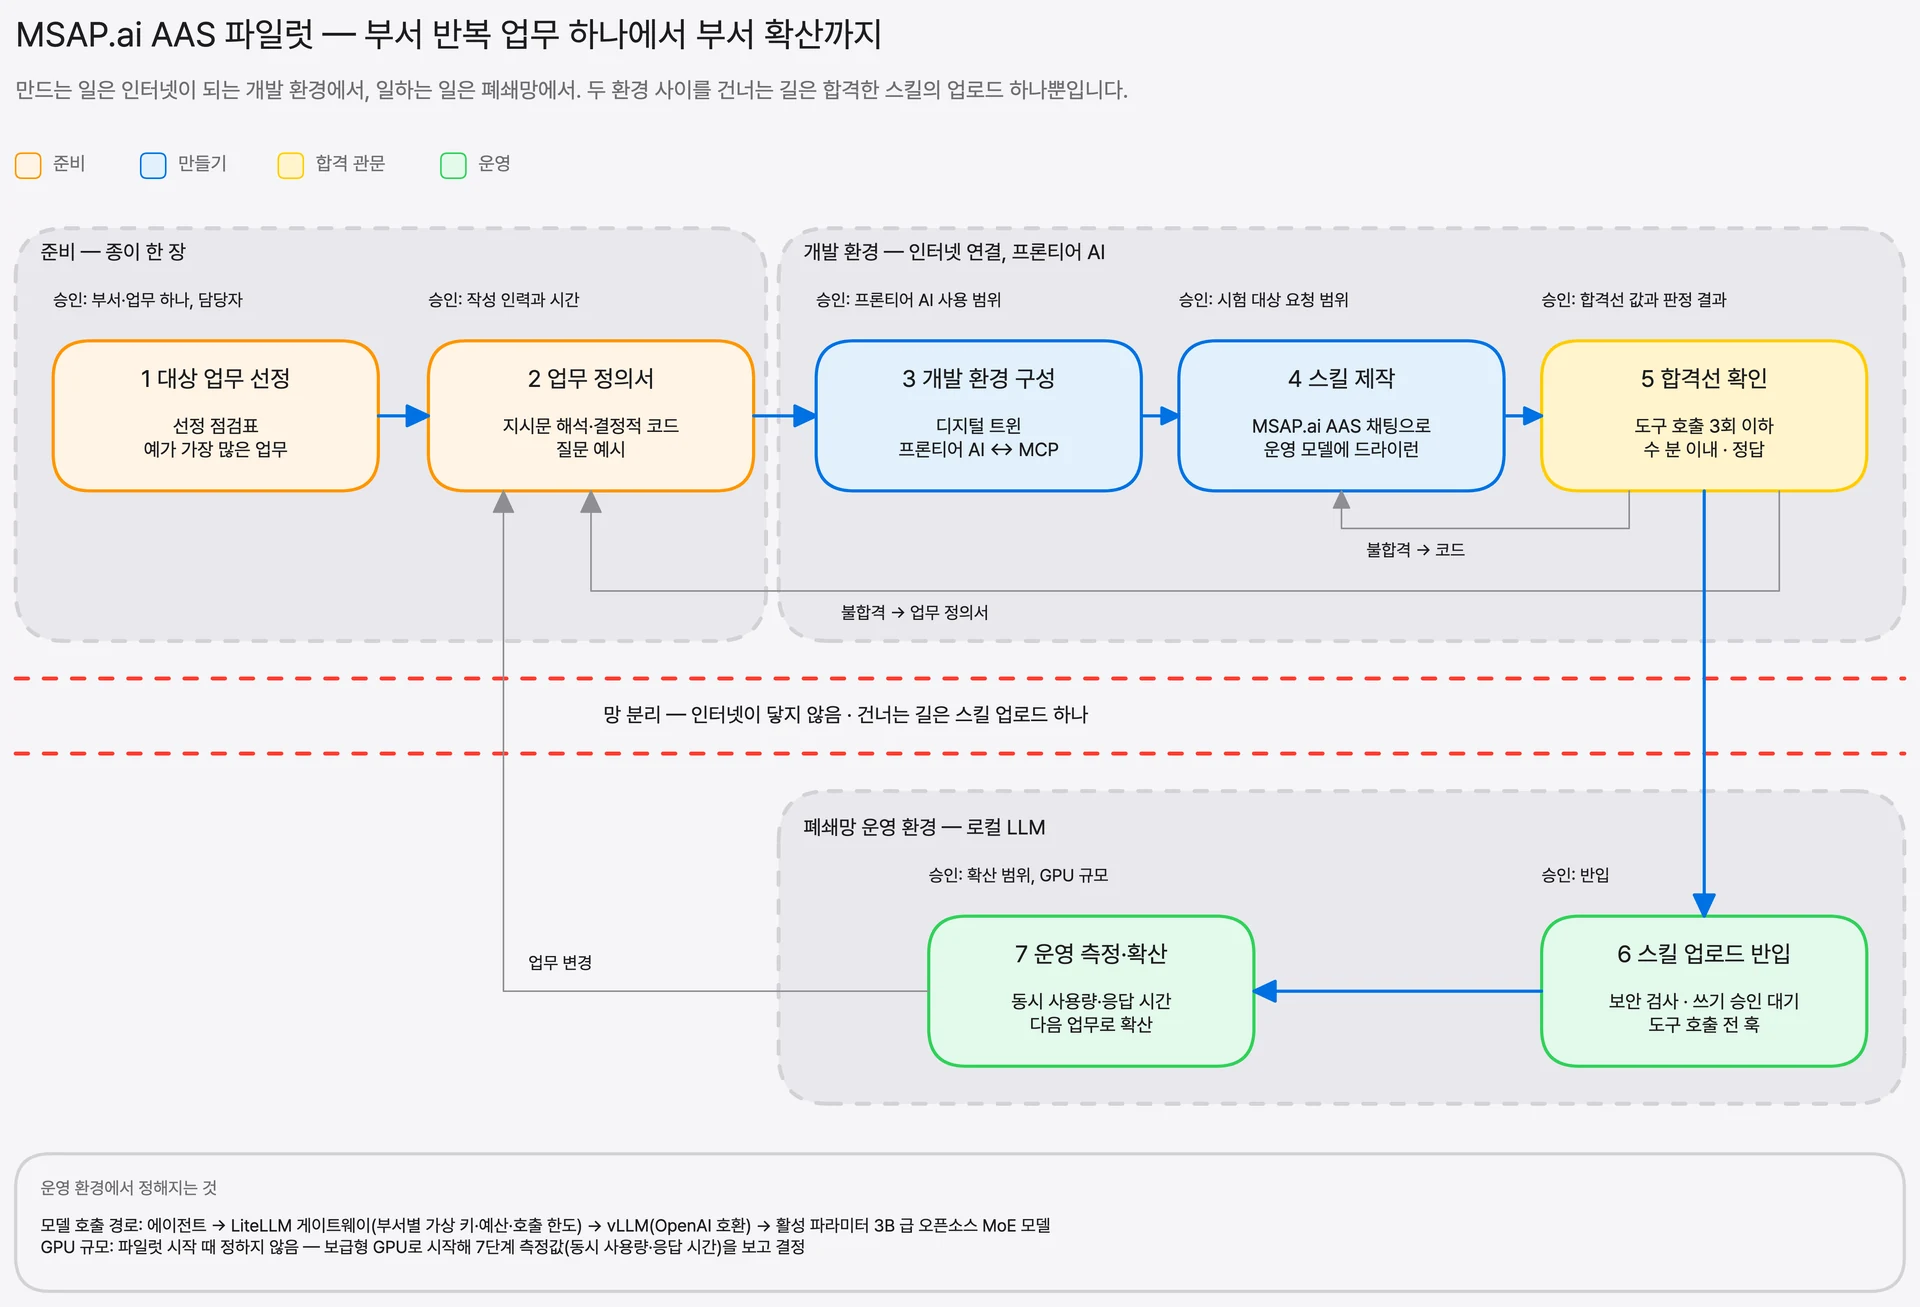
▲ 부서 반복 업무 하나로 시작해 부서 확산까지 이어지는 MSAP.ai AAS 파일럿 단계 (백서 101쪽)
AI Agent에 맡길 업무를 설계, 운영, 보안 관점에서 함께 따져 보려면 AI 에이전트 업무 적용 판단 기준 — 설계·운영·보안 12가지 발표자료를 같이 읽어 볼 만합니다.
핵심 정리
- AI Agent 스킬 설계의 출발점은 GPU가 아니라 업무 전문가가 쓰는 업무 정의서입니다.
- 업무 정의서 여덟 항목 가운데 여섯 항목이 결정적 코드로 바뀝니다.
- 프론티어 AI는 MCP로 MSAP.ai AAS에 연결해 스킬을 만들고, 폐쇄망으로는 스킬 업로드 하나만 넘어갑니다.
- 작은 모델에는 지시문 해석, 결정적 코드, 질문 예시의 세 가지 지시가 필요합니다.
- CRM 조회는 판단을 코드로 옮긴 뒤 394초 오답에서 14초 정답이 됐습니다.
- 합격선은 실제 운영 모델 기준으로 도구 호출 3회 이하, 수 분 이내 응답, 정답입니다.
자주 묻는 질문
AI Agent 스킬 설계란 무엇인가요?
업무 판단을 코드와 시험으로 옮겨 작은 모델도 같은 결과를 내게 만드는 스킬 제작 방법입니다. 스킬은 SKILL.md 지시문, 스크립트, 참고 파일을 한 디렉터리에 묶은 업무 단위입니다.
코딩을 모르는 업무 전문가도 스킬을 만들 수 있나요?
업무 전문가는 판단 기준을 말로 정하고 코드는 프론티어 AI가 씁니다. 업무 전문가는 업무 정의서와 질문 예시를 쓰고, 결과가 정답인지 판정하는 역할을 맡습니다.
프론티어 AI를 쓰면 고객 자료가 밖으로 나가지 않나요?
프론티어 AI는 비식별 자료만 있는 개발 환경에서만 스킬을 만듭니다. 운영 환경으로는 스킬 업로드 하나만 넘어가고, 고객과 금액 자료는 사내 게이트웨이 뒤의 로컬 LLM에서만 처리됩니다.
작은 모델로도 업무 결과가 정확한가요?
판단을 결정적 코드로 옮긴 반복 업무라면 작은 모델로도 같은 결과가 나옵니다. 백서의 영업기회 등록 사례에서 작은 모델과 프론티어 모델의 결과 JSON이 같았습니다.
고가 GPU를 추가로 사야 하나요?
먼저 업무 정의와 스킬 설계로 호출 횟수를 줄이고, GPU 규모는 측정 뒤에 정합니다. 활성 3B 급 MoE 모델과 요청당 도구 호출 1회 안팎의 스킬이면 보급형 GPU에서도 수 분 이내 응답을 냅니다.
만든 스킬이 쓸 만한지는 어떻게 판정하나요?
실제 운영 모델에 실제 요청을 넣어 도구 호출 수, 응답 시간, 정답 여부를 봅니다. 백서는 도구 호출 3회 이하, 수 분 이내 응답, 정답을 합격선 예시로 제시합니다.
첫 파일럿 업무는 어떻게 고르나요?
반복 빈도, 규칙 명시 가능성, 결과 판정 가능성, 데이터 반출 제한을 점검해 고릅니다. 「예」가 가장 많은 업무 하나를 정하고, 같은 점수라면 쓰기가 없는 조회 업무부터 시작합니다.
참고 리소스
- AI 에이전트(AI Agent)란? 정의·종류·사례와 기업 도입 기준
- 업무 전문가가 만드는 AI Agent — AAS 백서
- 업무 전문가가 만드는 AI Agent와 AI Agent Studio(AAS) 제품 소개
- MCP(Model Context Protocol)란 무엇인가
- AI Agent를 위한 LLM 게이트웨이 — LiteLLM 도입 가이드
- vLLM이란? LLM 추론 속도를 높이는 오픈소스 엔진
- 프라이빗 sLLM — 데이터 주권과 TCO
- Anthropic, Building effective agents
- Anthropic, Equipping agents for the real world with Agent Skills
- Model Context Protocol 명세 2025-06-18
- Small Language Models are the Future of Agentic AI
- NVIDIA, Mastering LLM Techniques: Inference Optimization
- Hermes Agent 문서 — Skills