TL;DR — 판단형 AI 제브(Jev)를 도입하기 전에는 창업진의 경력, 투자 규모, 커뮤니티 반응, 벤치마크 수치를 같은 무게로 믿지 말고 확정·보도·미확인으로 나눠 TypeSafe AI 신뢰성 검증을 해야 합니다. 공식 확인은 4,000만 달러 시드 하나뿐이고, 속도·비용 수치도 작은 가상 데이터에서 나온 값이라 자사 업무 문장으로 다시 재야 합니다.
2026년 프로덕션 운영 환경에서 판단 호출을 맡길 새 모델을 고르는 의사결정권자와 담당자라면, 왜 이 모델을 믿어도 되는지와 어떻게 근거를 따질지를 도입 전에 정리해 두는 편이 안전합니다. 이 글은 클라우드네이티브TV가 공개한 영상 ‘판단형 AI Jev, TypeSafe AI의 창업 배경과 LLM 과의 차별성'(약 9분 30초)을 캡처 8장과 함께 주장 단위로 풀어, 영상을 보지 않은 독자도 TypeSafe AI 신뢰성 검증의 순서와 기준을 얻어 가도록 정리했습니다. 영상은 회사 소개와 창업진, 연혁, 투자, 커뮤니티, 제삼자 벤치마크, 발표자의 직접 검증까지 아홉 장면을 따라가며 어디까지가 확인된 사실인지를 계속 구분합니다. 이 글도 그 구분을 그대로 따릅니다.
영상으로 먼저 보기: 제브 신뢰성 검증이 필요한 배경
영상은 “새 식당에 가기 전에 주방장 이력과 음식 맛을 따로 확인하는 것과 같다”는 비유로 시작합니다. 판단 전용 AI 모델 제브를 만든 TypeSafe AI가 누구이고, 투자는 얼마나 받았는지, 그리고 성능 수치를 어디까지 믿을 수 있는지를 따로따로 확인하자는 제안입니다. 창립자의 경력이나 투자 규모만으로는 새 모델의 신뢰성이 증명되지 않기 때문입니다.
영상에서 다루는 순서는 다음과 같습니다.
이 영상이 답하는 8가지 질문 정리
TypeSafe AI 신뢰성 검증에 관한 영상의 설명을 질문으로 바꾸면 여덟 가지입니다. 아래 여덟 개 절이 이 순서대로 답합니다.
- 제브는 어떤 모델 분류에 속하고 무엇이 공식 수치인가?
- 창업진의 경력은 왜 성능의 근거가 되지 못하는가?
- 닷새 만에 유통 채널 세 곳에 오른 과정에서 무엇을 읽어야 하는가?
- 투자 정보는 어떤 기준으로 나눠 읽어야 하는가?
- 커뮤니티 프로젝트는 무엇의 증거인가?
- 별 수가 빠르게 늘면 품질도 검증된 것인가?
- 제삼자 벤치마크는 속도·비용·정확도를 어떻게 보여 주는가?
- 발표자의 직접 검증에서 드러난 한계는 무엇인가?
제브가 시스템 원 모델 분류에 속하는 이유
TypeSafe AI는 9월 15일 제브를 공개했고, 같은 날 4,000만 달러 규모의 시드 투자를 함께 발표했습니다. 현행 모델은 jev-1.13.0이고, 공식 종단 응답 시간은 70~500밀리초입니다. 영상은 곧바로 단서를 붙입니다. 이 응답 시간은 회사가 스스로 평가한 값이라는 것입니다. 공식 수치와 제삼자가 잰 수치를 같은 줄에 놓지 않는 것이 TypeSafe AI 신뢰성 검증의 첫 번째 규칙입니다.
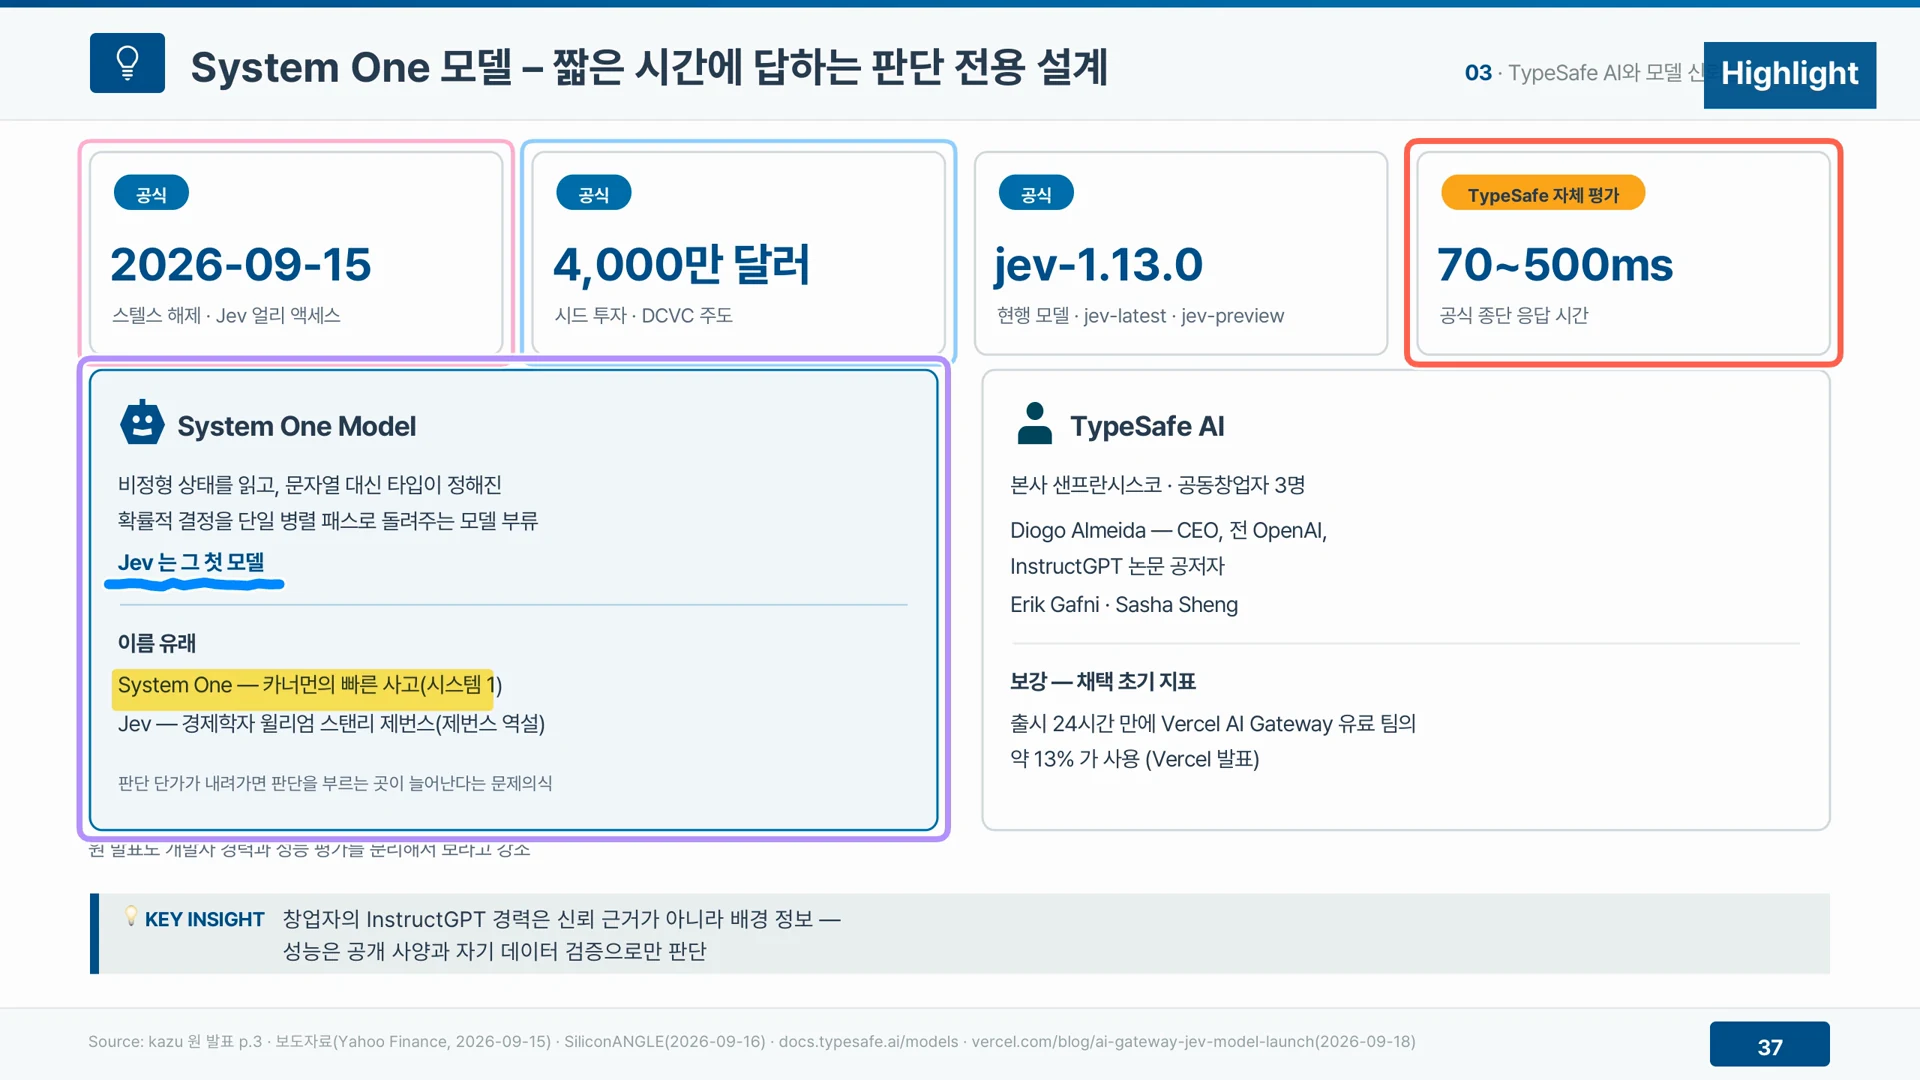
▲ 시스템 원 모델의 첫 주자, 제브 (영상 0:41)
캡처 위쪽 네 칸은 공개일 2026-09-15, 시드 4,000만 달러, 현행 모델 jev-1.13.0, 응답 시간 70~500ms를 보여 주고, 모두 공식 발표에서 가져온 값입니다. 마지막 칸에만 ‘TypeSafe 자체 평가’라는 꼬리표가 붙어 있습니다. 아래 왼쪽 카드는 제브가 속한 모델 분류인 시스템 원 모델을 설명하는데, 이름은 카너먼의 빠른 사고에서 따왔고 짧은 시간에 답하는 판단 전용 설계라는 뜻을 담고 있습니다. 제브라는 이름은 경제학자 제번스에서 왔습니다.
영상은 여기서 한 가지를 분리합니다. 창립자가 유명한 인공지능 논문의 공저자라는 이야기가 자주 나오지만, 경력은 배경 정보일 뿐 성능의 근거가 아니라는 것입니다. 요리사의 수상 경력이 오늘 나온 음식 맛을 보증하지 못하는 것과 같습니다. 그래서 이 영상의 나머지는 배경 정보와 성능 근거를 번갈아 따로 놓고 확인하는 구성입니다.
이 절의 결론은 단순합니다. 제브는 짧은 시간에 답하는 판단 전용 모델이고, 도입 검토에 쓸 수 있는 공식 수치는 공개일과 시드 금액, 현행 버전 같은 사실 정보에 한정됩니다. 응답 시간 70~500밀리초는 참고값이지 검증된 값이 아닙니다.
창업진의 경력이 성능의 근거가 되지 못하는 이유
공동창업자는 세 명입니다. 대표인 디오구 알메이다는 구글 브레인을 거쳐 오픈에이아이 포스트 트레이닝 팀에서 약 4년 일하며 RLHF, InstructGPT, ChatGPT 작업에 참여했습니다. 기술 책임자 에릭 가프니는 바이오 에이아이 회사 라벨을 함께 세운 연쇄 창업자이고, 운영 책임자 사샤 솅은 메타 FAIR의 연구 엔지니어 출신입니다. 화려한 이력이지만 영상은 학력과 퇴사 사유가 공개 자료에서 확인되지 않았다는 점도 함께 적어 둡니다.
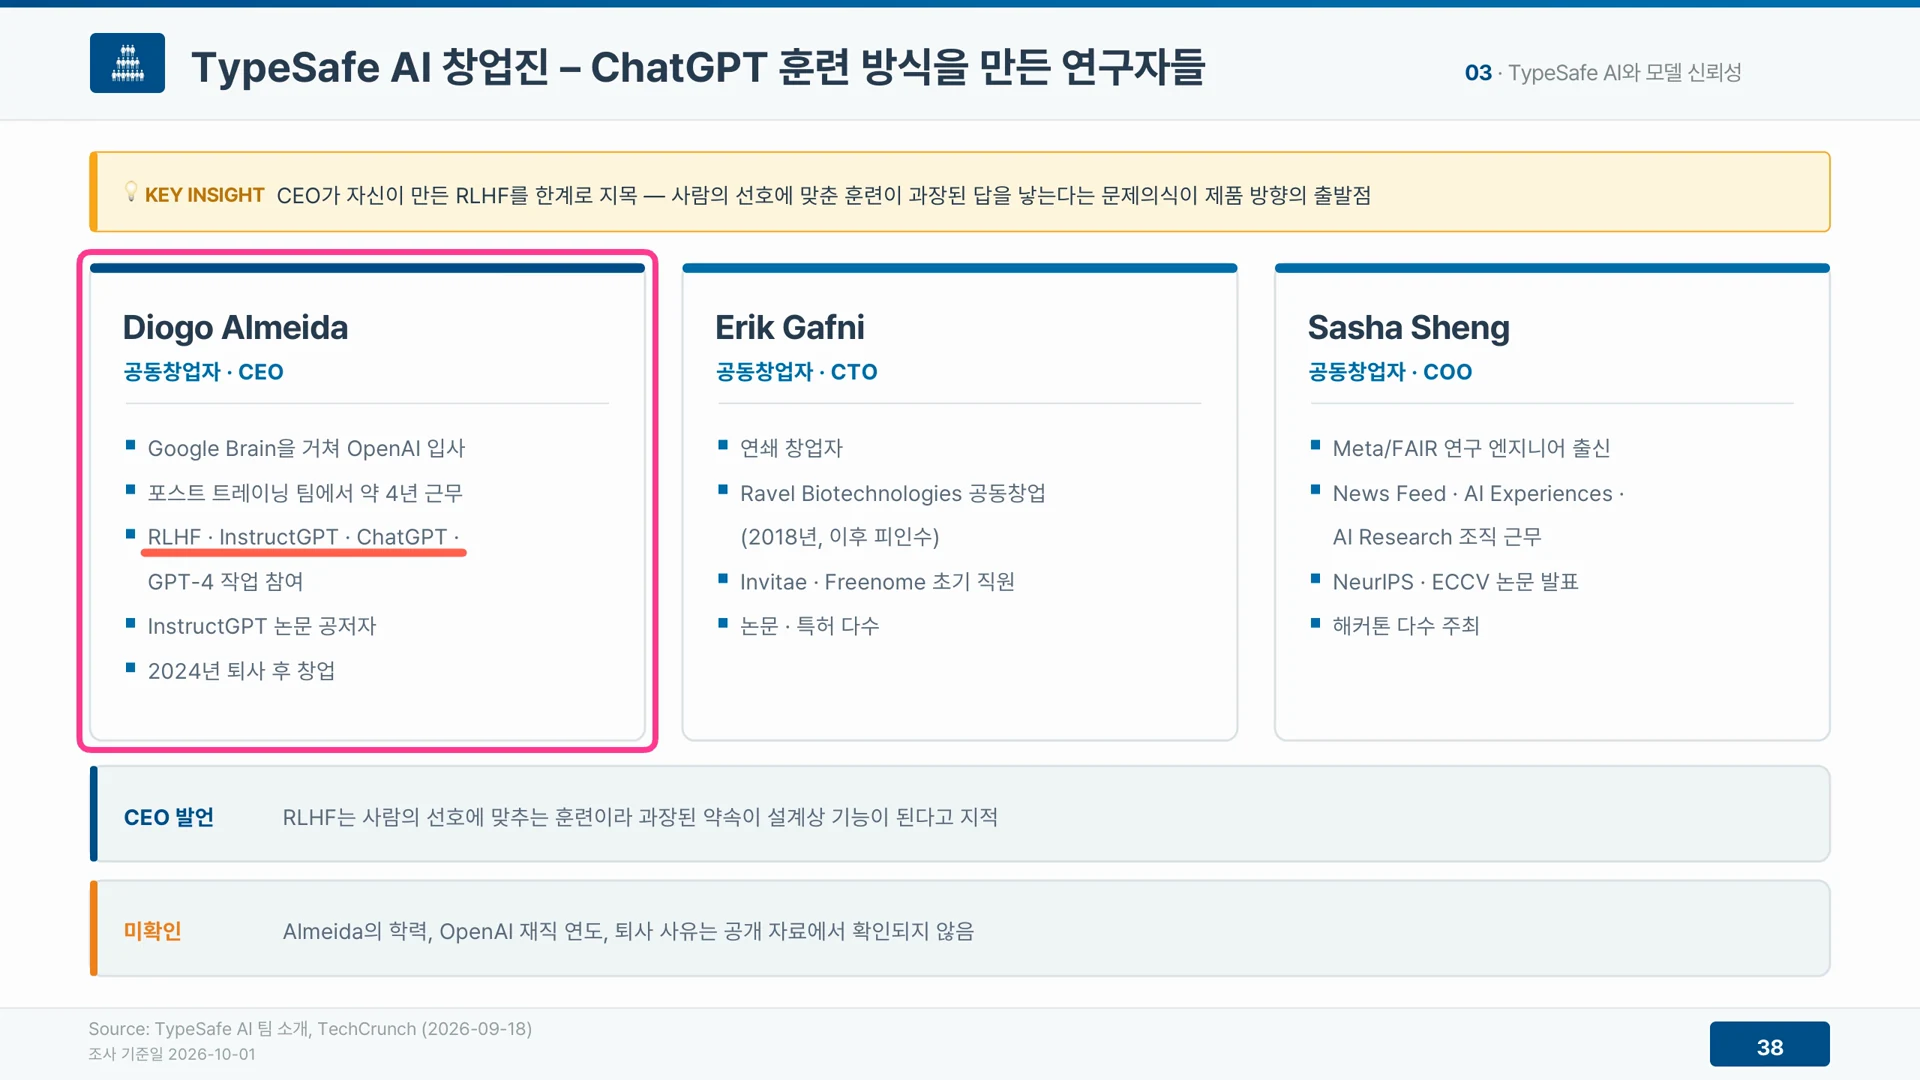
▲ 공동창업자 세 명의 이력 (영상 2:56)
캡처 위쪽 노란 띠는 이 장면의 핵심을 한 줄로 요약합니다. 대표가 자신이 만든 RLHF를 한계로 지목했고, 사람의 선호에 맞춘 훈련이 과장된 답을 낳는다는 문제의식이 제품 방향의 출발점이라는 내용입니다. 세 카드에는 각자의 이력이 정리되어 있고, 대표 카드 아래에는 이 문제의식을 담은 발언이 따로 표시됩니다.
여기서 읽을 점은 두 가지입니다. 첫째, 사람의 평가를 받아 모델을 길들이는 강화학습을 직접 해 본 연구자가 그 방식의 한계를 말한다는 점은 제품 방향을 이해하는 데 도움이 됩니다. 둘째, 그것이 제브가 실제로 더 정확하다는 증거는 아닙니다. 영상은 이를 손님 입맛에만 맞추다 보면 음식이 점점 달고 짜지는 것에 빗댑니다. 문제의식은 설계의 이유를 설명할 뿐, 결과의 품질은 별도로 재야 합니다.
의사결정권자에게 이 구분은 실무적입니다. 창업진 이력은 이 팀이 어떤 문제를 풀려는지, 곧 신뢰할 만한 방향 설정을 했는지를 가늠하는 자료입니다. 반면 도입 판단은 우리 업무 문장에서 나온 정확도로 해야 합니다. 두 질문을 한 장의 표에 섞으면 TypeSafe AI 신뢰성 검증의 기준이 흐려집니다.
2년 스텔스 뒤 닷새 만에 유통 채널 세 곳에 오른 과정
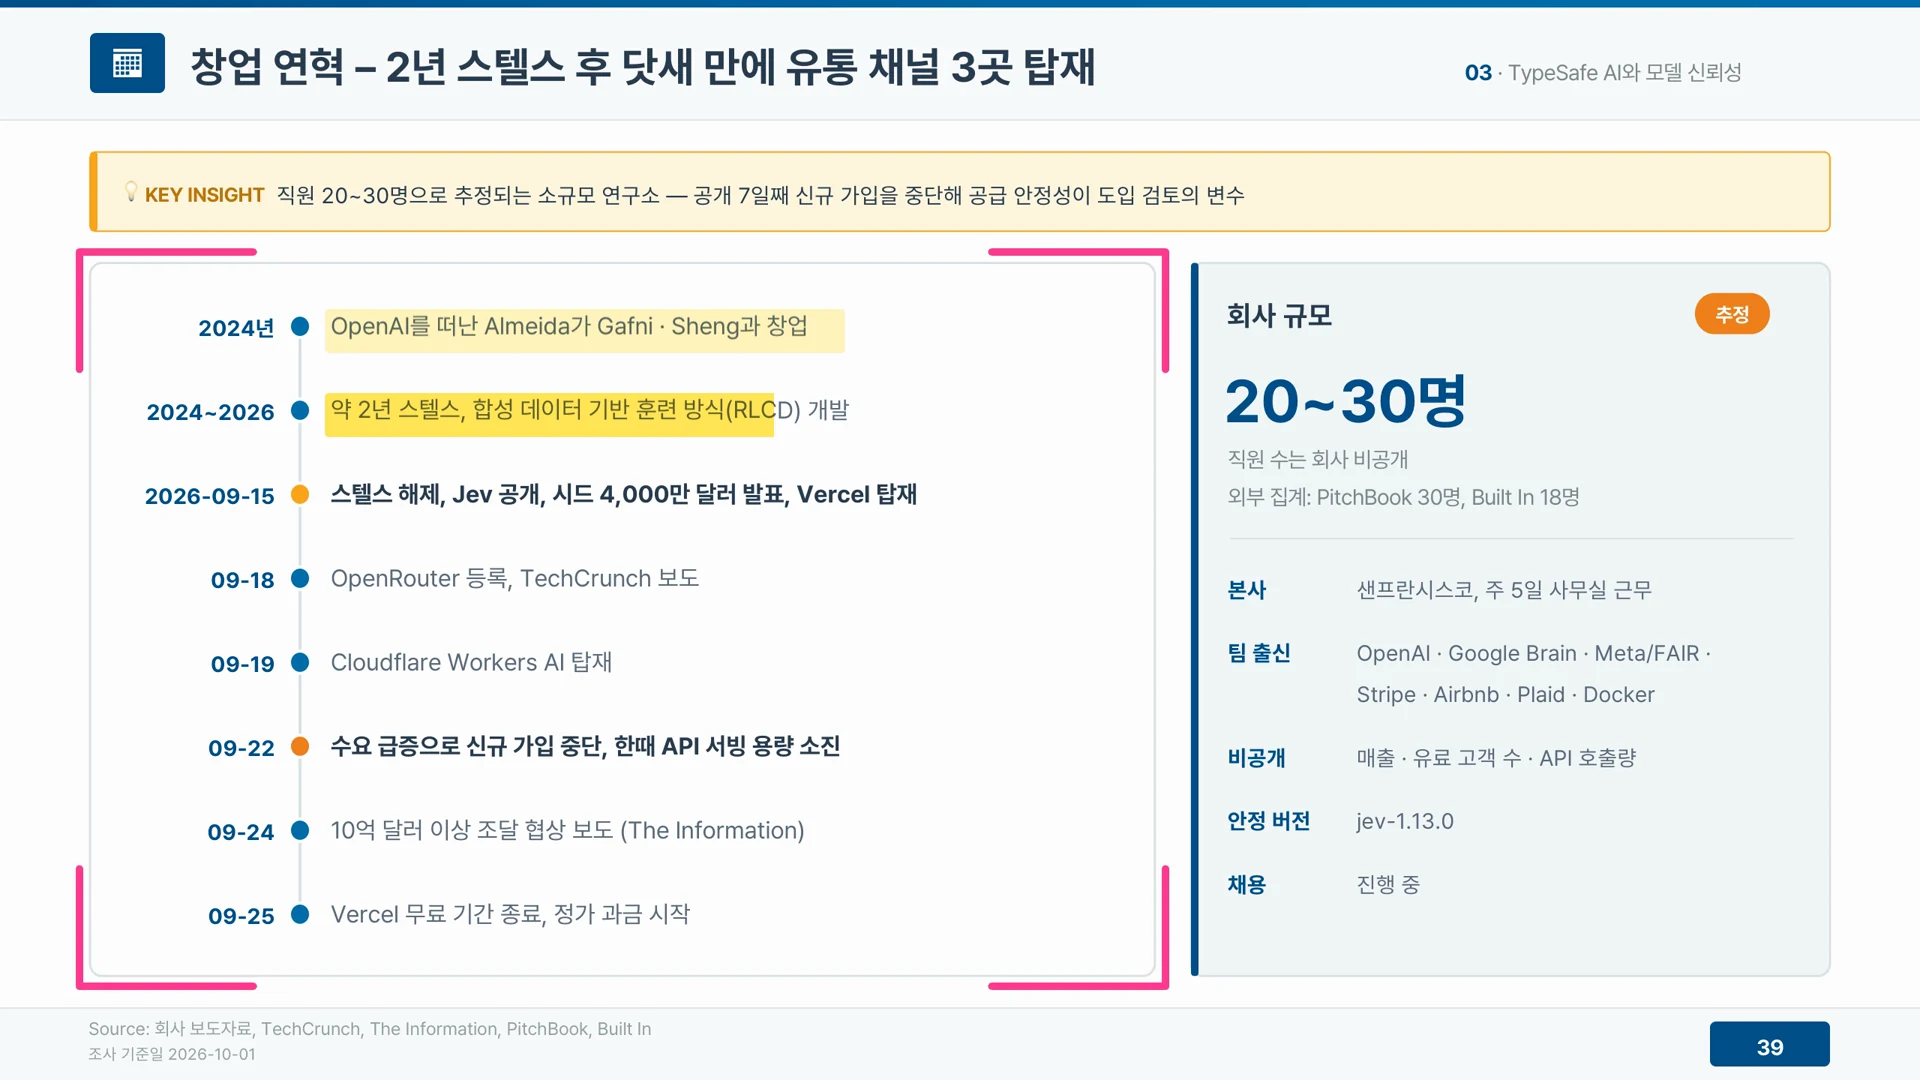
연혁은 간단합니다. 알메이다가 오픈에이아이를 떠나 가프니, 솅과 함께 2024년에 회사를 세웠고, 이후 약 2년 동안 외부에 알리지 않고 합성 데이터 기반 훈련 방식인 RLCD를 개발했습니다. 9월 15일 모델 공개와 시드 투자 발표가 같은 날 이뤄졌고, 같은 날 버셀에 올라갔습니다. 18일에는 오픈라우터, 19일에는 클라우드플레어에 올라 닷새 만에 유통 채널 세 곳에 들어갔습니다.
▲ 2년 스텔스에서 닷새 만의 유통까지 (영상 3:50)
캡처 오른쪽에는 회사 규모와 연혁이 표로 정리되어 있습니다. 직원 수는 회사가 공개하지 않았고, 외부 집계는 핏북이 30명, 빌트인이 18명으로 달라서 영상은 20~30명 규모의 소규모 연구소로 추정합니다. 매출과 유료 고객 수도 공개되지 않았습니다. 영상은 새로 나온 과자가 닷새 만에 편의점 세 곳에 깔린 것에 이 속도를 빗댑니다.
눈여겨볼 대목은 22일입니다. 수요가 몰려 신규 가입을 멈췄다는 기록입니다. 영상은 이를 관심의 증거로 읽으면서 동시에 공급 안정성이 도입 검토의 변수라고 지적합니다. 인기가 있다는 사실과 안정적으로 쓸 수 있다는 사실은 다른 질문이기 때문입니다. 작은 팀이 갑자기 늘어난 수요를 얼마나 감당하는지는 운영 환경에서 서비스 수준을 약속받아야 확인할 수 있습니다.
정리하면 연혁에서 얻을 사실은 세 가지입니다. 공개 시점, 유통 채널 세 곳, 가입 중단입니다. 직원 수와 매출은 추정이거나 비공개이므로 근거 자리에 올리지 않는 것이 TypeSafe AI 신뢰성 검증의 기본입니다.
투자 정보를 확정·보도·미확인으로 나눠 읽는 기준
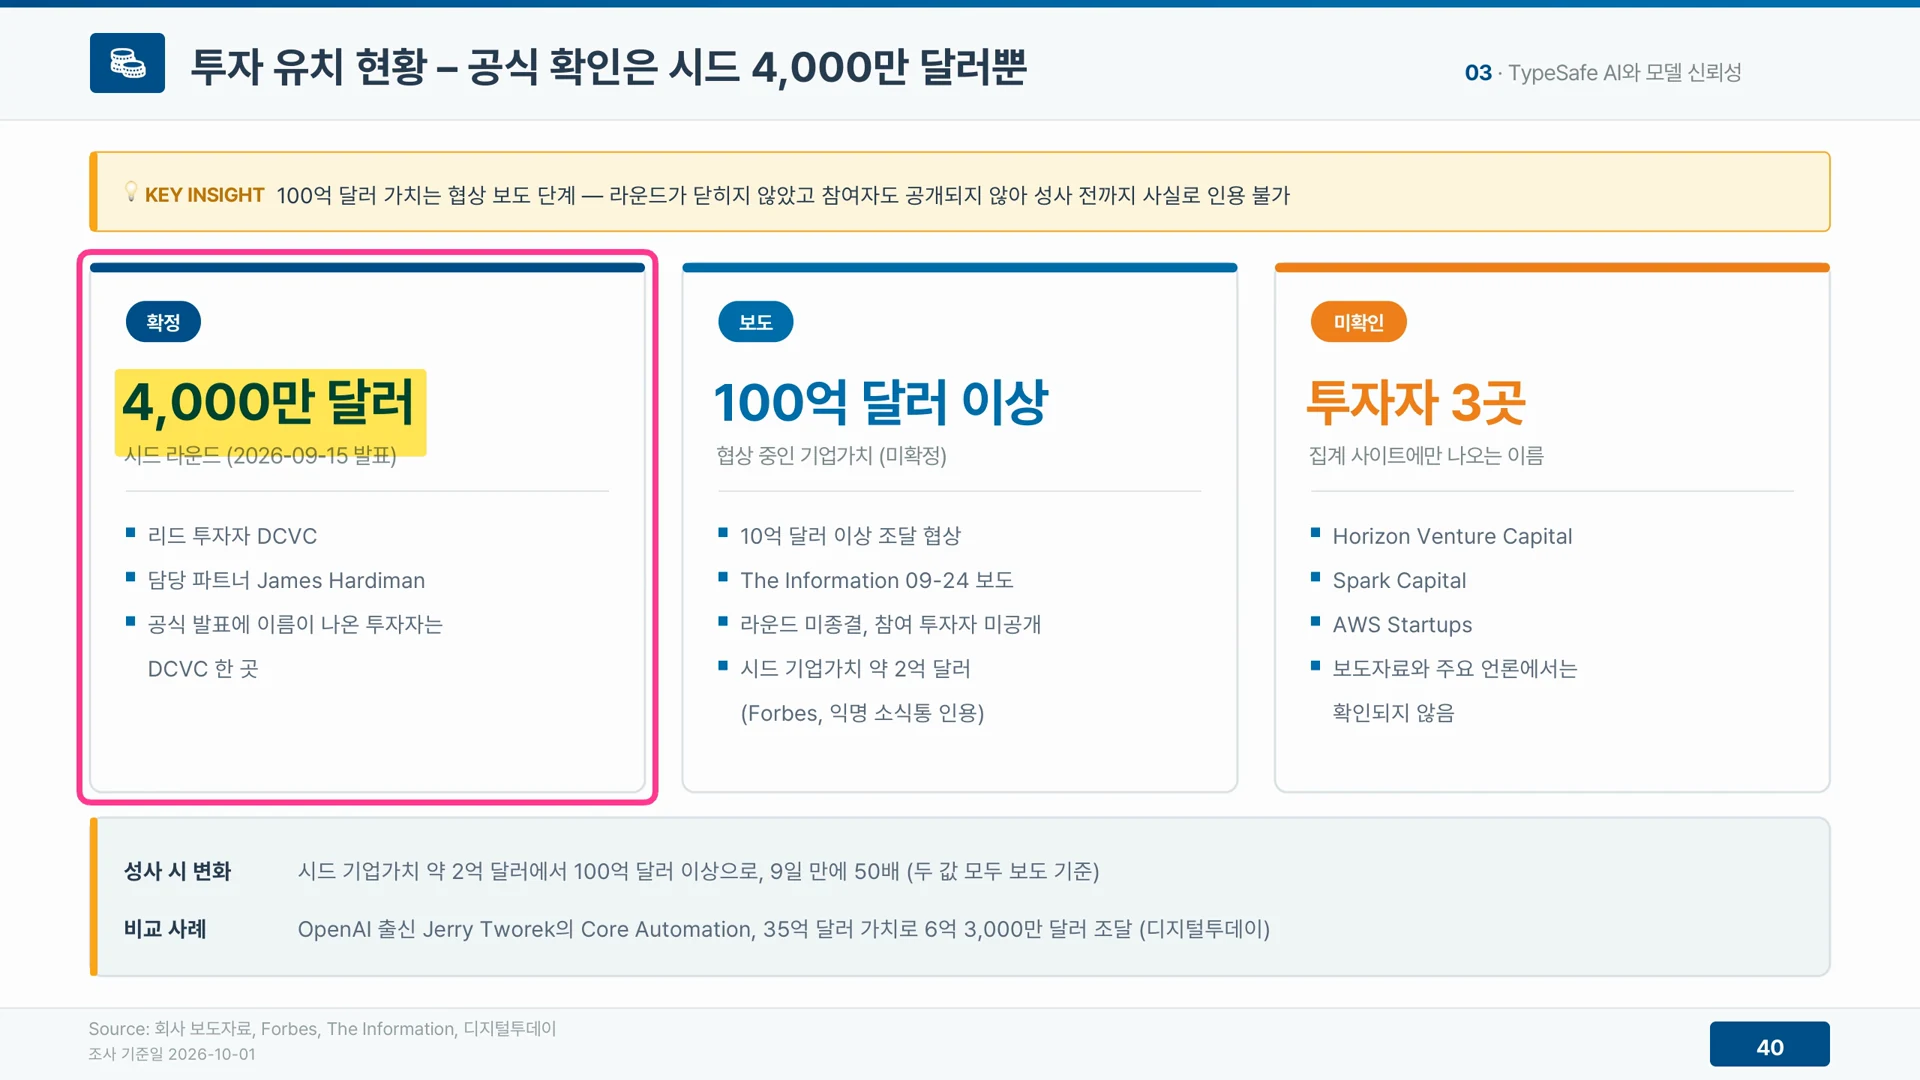
투자 현황은 검증 수준을 세 단계로 나눠 보아야 합니다. 영상은 확정된 것, 보도된 것, 확인되지 않은 것의 세 칸을 나란히 놓습니다. 확정된 것은 시드 4,000만 달러 하나이고, 투자를 이끈 곳은 디씨브이씨입니다. 공식 발표에 이름이 나온 투자자도 이 한 곳뿐입니다.
▲ 확정된 시드와 보도 단계의 라운드 (영상 4:41)
캡처 왼쪽 칸은 확정 단계로 4,000만 달러, 2026-09-15 발표, 리드 투자자 디씨브이씨를 담고 있습니다. 가운데 칸은 보도 단계로 기업 가치 100억 달러 이상, 10억 달러 넘는 조달이라는 내용입니다. 이는 9월 24일 더 인포메이션의 보도이고 아직 협상 단계입니다. 시드 당시 기업 가치 2억 달러라는 수치도 포브스가 익명 소식통을 인용한 것입니다. 오른쪽 칸은 미확인 단계로, 일부 집계 사이트가 적은 투자자 세 곳은 보도자료에서 확인되지 않습니다.
| 단계 | 내용 | 인용 방식 |
|---|---|---|
| 확정 | 시드 4,000만 달러, 리드 디씨브이씨 | 사실로 인용 가능 |
| 보도 | 100억 달러 이상 가치, 10억 달러 넘는 조달 | 출처와 협상 단계를 함께 표기 |
| 미확인 | 집계 사이트가 적은 투자자 세 곳 | 인용하지 않음 |
영상의 결론은 분명합니다. 100억 달러라는 숫자는 라운드가 닫히기 전까지 사실로 인용하면 안 됩니다. 참여자도 공개되지 않았고 협상이 끝나지 않았기 때문입니다. 의사결정 문서에 이 수치를 넣어야 한다면 출처와 단계를 함께 적어야 하며, 확정 항목과 같은 표에 두는 것은 피해야 합니다.
투자 규모는 회사가 당장 문을 닫지 않을 가능성을 보여 줄 뿐, 모델의 품질을 보여 주지는 않습니다. 이 구분은 공급자 선정에서 자주 무너집니다. 큰 투자 보도가 곧 기술 검증으로 읽히기 쉽기 때문입니다.
커뮤니티 프로젝트가 관심의 증거일 뿐인 이유
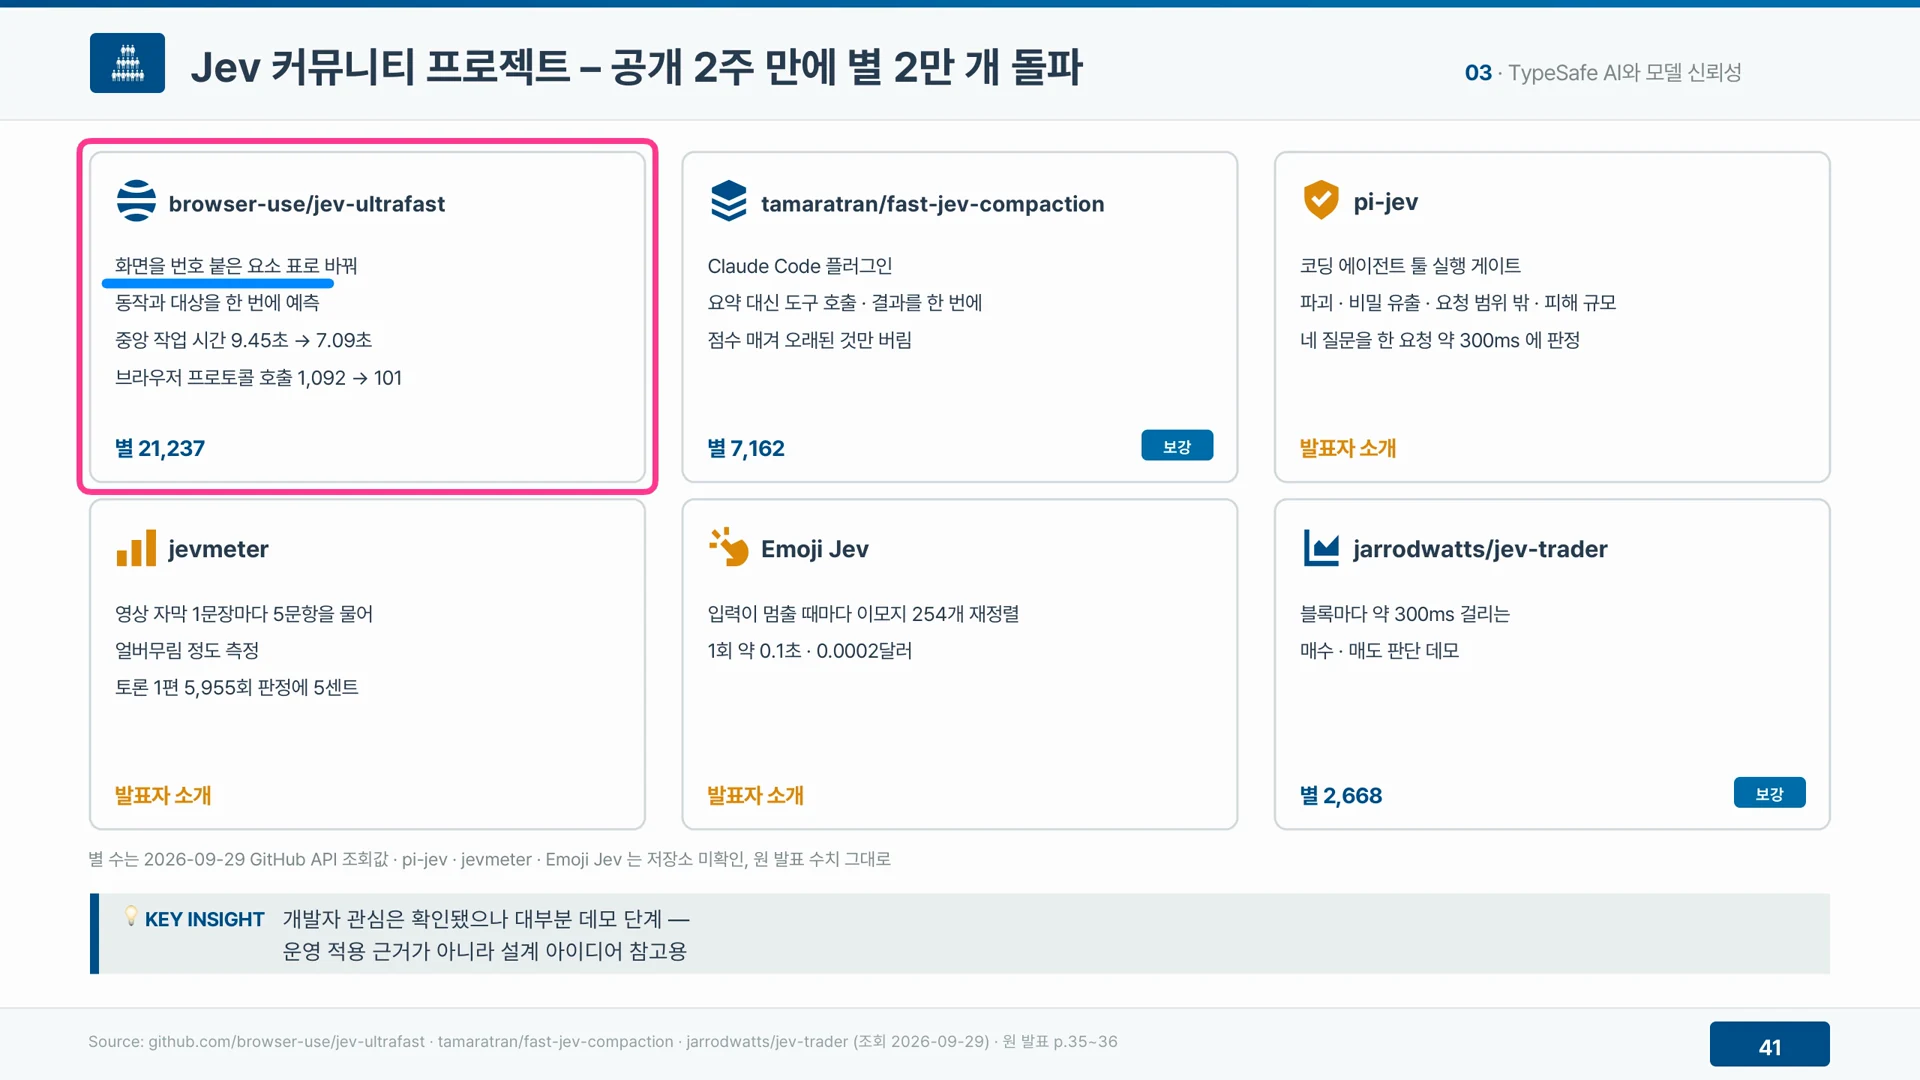
공개 두 주 만에 커뮤니티 프로젝트가 여럿 나왔습니다. 가장 눈에 띄는 것은 브라우저를 대신 조작해 주는 프로젝트로, 화면을 번호 붙은 요소 표로 바꿔 다음 동작과 대상을 한 번에 예측합니다. 중앙 작업 시간을 9.45초에서 7.09초로 줄였고, 브라우저 프로토콜 호출은 1,092회에서 101회로 줄었으며, 별은 2만 개를 넘었습니다.
▲ 커뮤니티 프로젝트와 별 수 (영상 5:36)
캡처에는 여섯 개 프로젝트 카드가 있습니다. 브라우저 조작 외에 코딩 도구의 문맥을 압축하는 플러그인, 매수·매도를 판단하는 트레이딩 데모, 도구 실행을 걸러 주는 게이트, 자막 분석, 이모지 정렬 사례가 보입니다. 영상은 이 가운데 일부는 원 발표자가 소개한 것이라 저장소 단위로 확인하지 못한 항목이 있다고 구분합니다.
영상의 해석은 신중합니다. 영화 예고편이 화제가 됐다고 본편의 완성도까지 보증되지는 않는다는 비유입니다. 관심은 확인됐지만 대부분 데모 단계이므로 운영 근거보다 설계 아이디어로 참고하라는 것이 결론입니다. 이 프로젝트들이 보여 주는 설계, 곧 화면을 요소 표로 바꿔 짧은 판단을 반복하는 방식은 도입 검토자가 가져갈 만한 힌트입니다. 다만 숫자 하나하나는 해당 프로젝트의 조건에서 나온 값입니다.
여기서 TypeSafe AI 신뢰성 검증에 쓸 수 있는 점은 사용 사례의 유형입니다. 커뮤니티가 어떤 자리에 제브를 쓰는지 보면, 우리 업무에서 어떤 판단 호출부터 시험할지 후보를 잡을 수 있습니다.
별 수 증가를 품질 근거로 읽으면 안 되는 이유
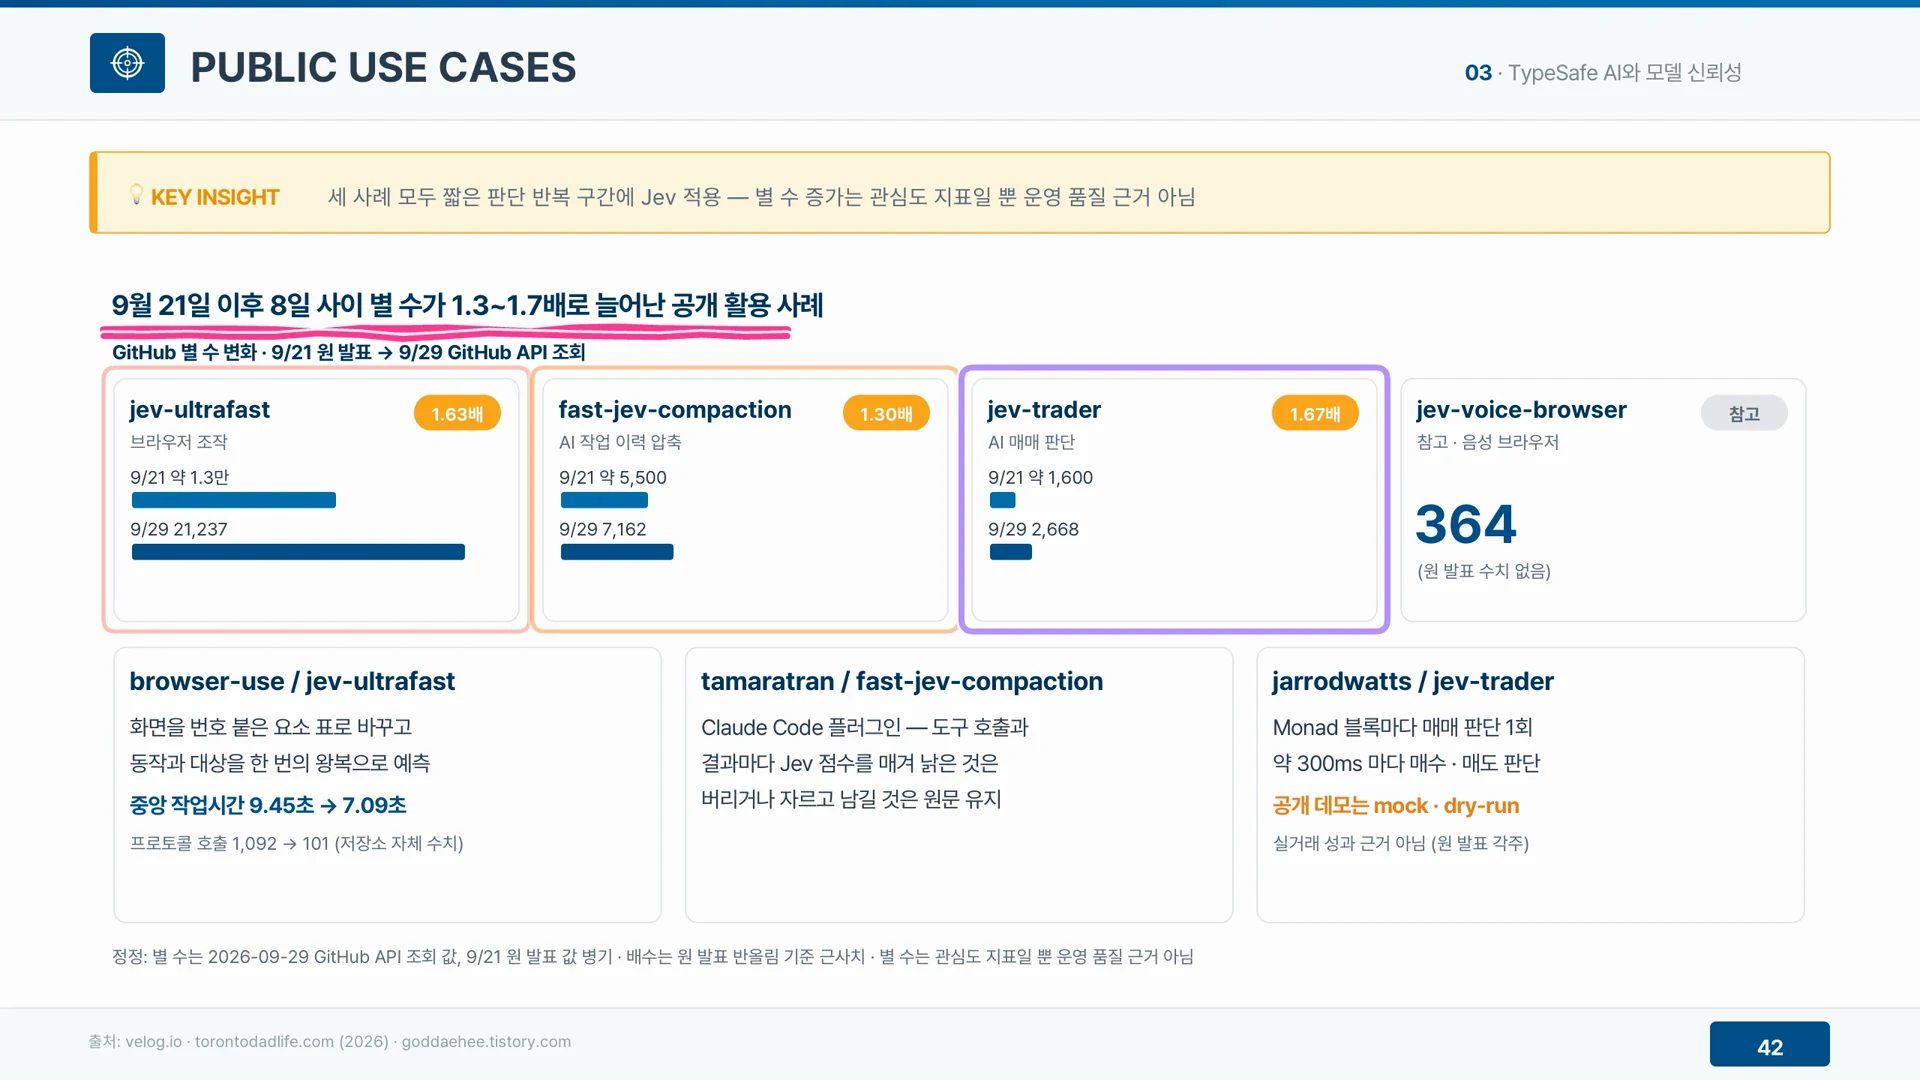
영상은 별 수의 변화를 구체적으로 추적합니다. 원 발표가 9월 21일에 소개한 저장소 세 곳의 별 수를 9월 29일에 다시 조회했습니다. 브라우저 조작용은 약 1만 3천 개에서 21,237개로, 작업 이력 압축용은 7,162개로, 매매 판단용은 2,668개로 늘었습니다. 여드레 사이에 1.3배에서 1.7배가 된 것입니다.
▲ 여드레 사이 1.3배에서 1.7배 (영상 6:57)
캡처 위쪽 노란 띠는 세 사례가 모두 짧은 판단을 여러 번 반복하는 구간에 제브를 적용하며, 별 수 증가는 관심도 지표일 뿐 운영 품질의 근거가 아니라고 요약합니다. 막대 그래프는 9월 21일 값과 9월 29일 값을 겹쳐 보여 주고, 아래 카드들은 각 저장소가 어떤 판단을 반복하는지 적어 둡니다.
세 사례의 공통점은 짧은 판단의 반복입니다. 한 번의 판단은 가볍지만 호출 횟수가 많아지면 지연과 비용이 쌓이므로, 그런 자리에서 제브 같은 모델의 장점이 드러납니다. 반대로 긴 글을 써야 하거나 복합 추론이 필요한 자리는 이 사례들이 말해 주지 않습니다.
영상은 두 가지를 분명히 해 둡니다. 첫째, 식당 앞에 줄이 길다고 맛이 보장되지는 않는 것과 같아서 별 수는 관심도일 뿐입니다. 둘째, 매매 판단용 공개 데모는 모의 거래입니다. 실제 자금이 오가는 운영 사례가 아니라는 뜻이므로, 이 사례를 근거로 금융 업무에 적용해도 된다고 읽으면 안 됩니다.
제삼자 벤치마크가 보여 준 속도·비용·정확도를 읽는 방식
공식 수치 대신 제삼자가 잰 결과를 보면 어떨까요. 영상이 소개하는 실험은 리뷰 한 건에서 다섯 개 항목을 판정하는 작업이고, 비교 상대는 지피티 5.6 루나입니다. 제브는 약 2.4배 빨랐고 약 4.8배 저렴했으며, 정답률은 루나가 1퍼센트포인트 높았습니다. 시험 점수를 조금 더 받으려고 시간과 돈을 몇 배 더 쓰는 셈이라고 영상은 풀이합니다.
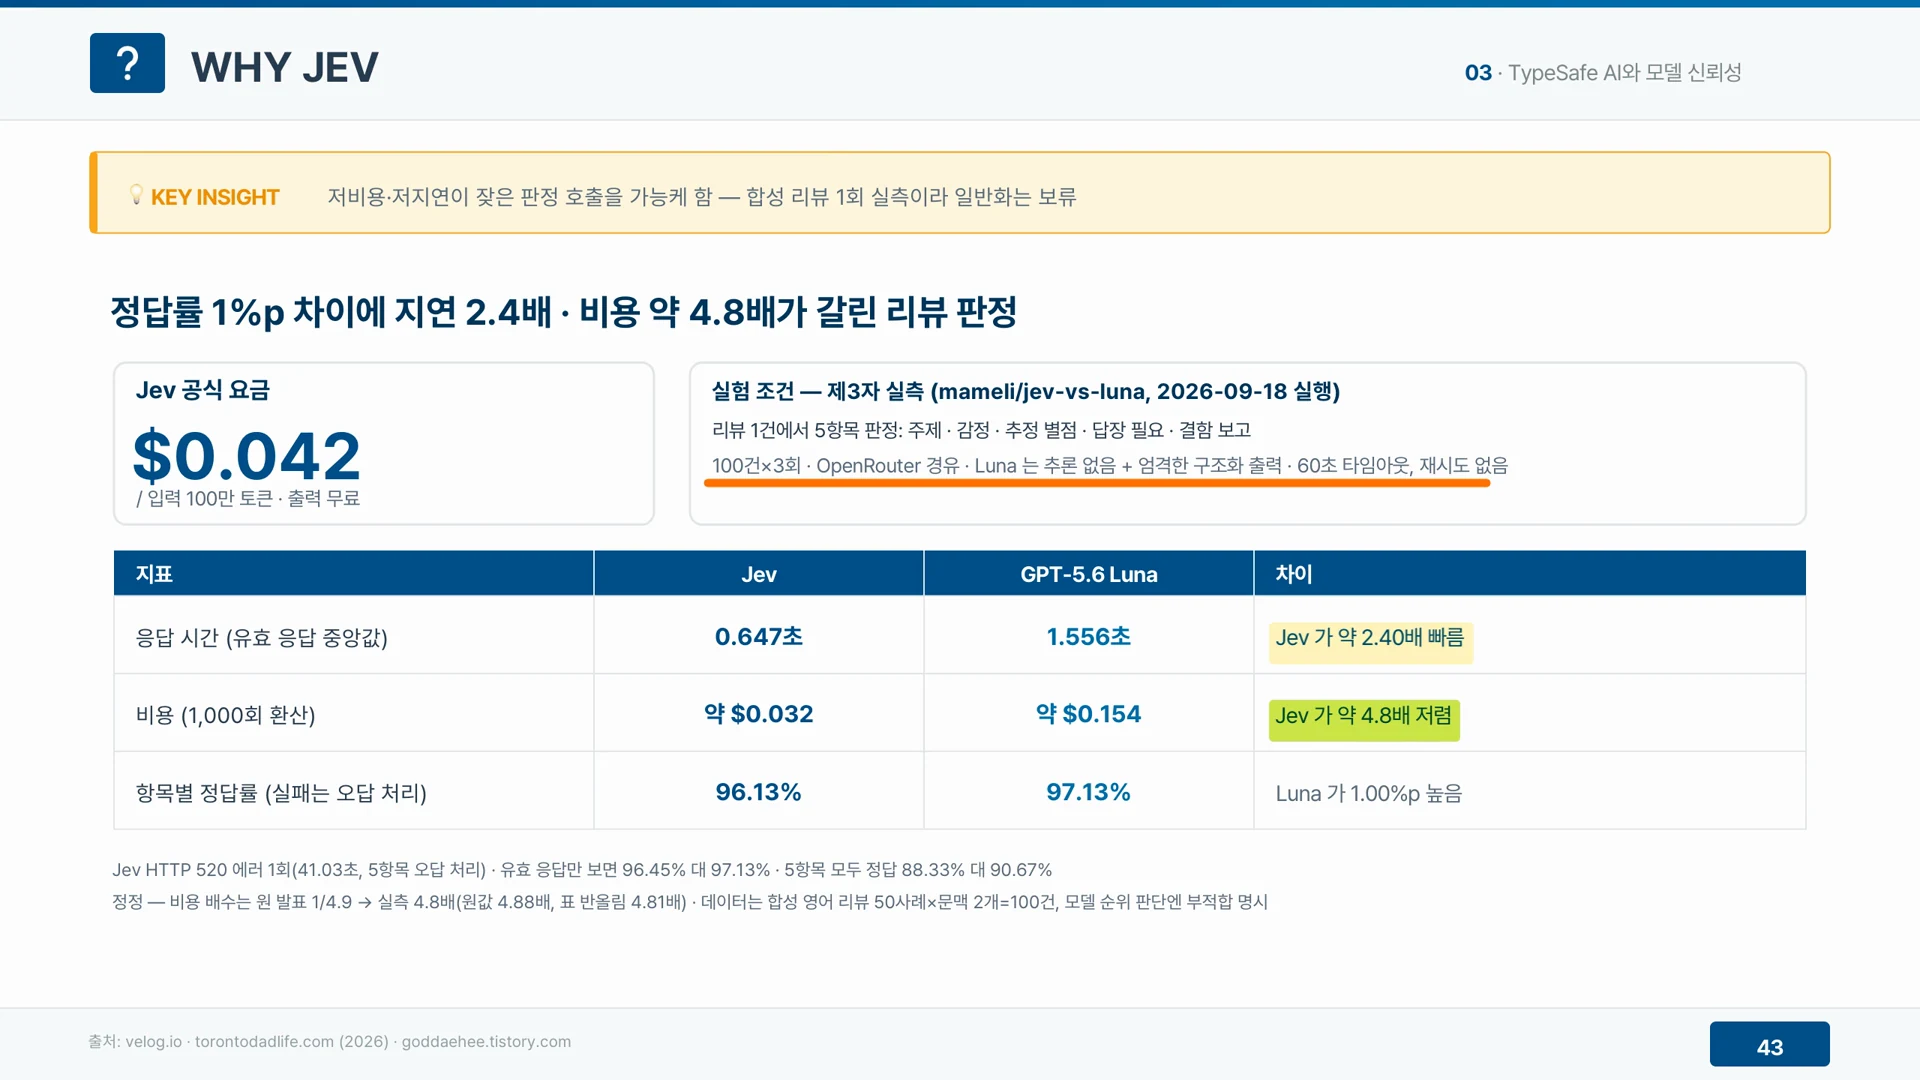
▲ 제삼자 벤치마크의 속도·비용·정답률 (영상 7:48)
캡처 위쪽에는 제브의 공식 요금이 입력 100만 토큰당 0.042달러, 출력은 무료로 표시되어 있고, 아래 표는 두 모델의 소요 시간과 비용, 정답률을 나란히 보여 줍니다. 표 오른쪽에는 제브가 지연에서 약 2.4배, 비용에서 약 4.8배 앞선다는 요약이 있습니다.
영상은 여기서 두 가지를 바로잡습니다. 비용 배수는 원 발표에 약 4.9분의 1로 적혀 있었지만, 표의 반올림 값으로 계산하면 4.81배, 저장소 원값으로는 4.88배라서 이 영상에서는 약 4.8배로 표기했습니다. 또 원 발표는 사람이 쓴 리뷰라고 했는데, 저장소를 확인해 보니 합성 리뷰 100건에 라벨만 사람이 붙인 것이었습니다. 한 번 돌린 결과이므로 우리 데이터로 다시 재기 전에는 일반화하지 않는 편이 안전합니다.
이 장면은 TypeSafe AI 신뢰성 검증이 어떻게 이뤄져야 하는지 보여 주는 좋은 예입니다. 수치를 인용하기 전에 원 자료를 열어 보고, 맞지 않는 부분을 바로잡고, 그래도 남는 한계를 같이 적습니다. 정확도가 1퍼센트포인트 낮은 대신 지연과 비용이 몇 배 줄어드는 교환이 우리 업무에서도 성립하는지가 실제 의사결정 질문입니다.
직접 검증에서 드러난 경계 사례의 한계와 한국어 검증 기준
마지막 장면은 발표자가 네 가지 세트로 손수 정확도를 확인한 결과입니다. 일반 5분류 42건은 모두 일치했고, 회의록 문장 분류 12건도 모두 맞았습니다. 그런데 경계를 애매하게 만든 5분류 18건에서는 16건만 일치해 일치율 88.9%였고, 답장이 필요한지 가리는 세트는 기준 자체에 따라 결과가 달라졌습니다.
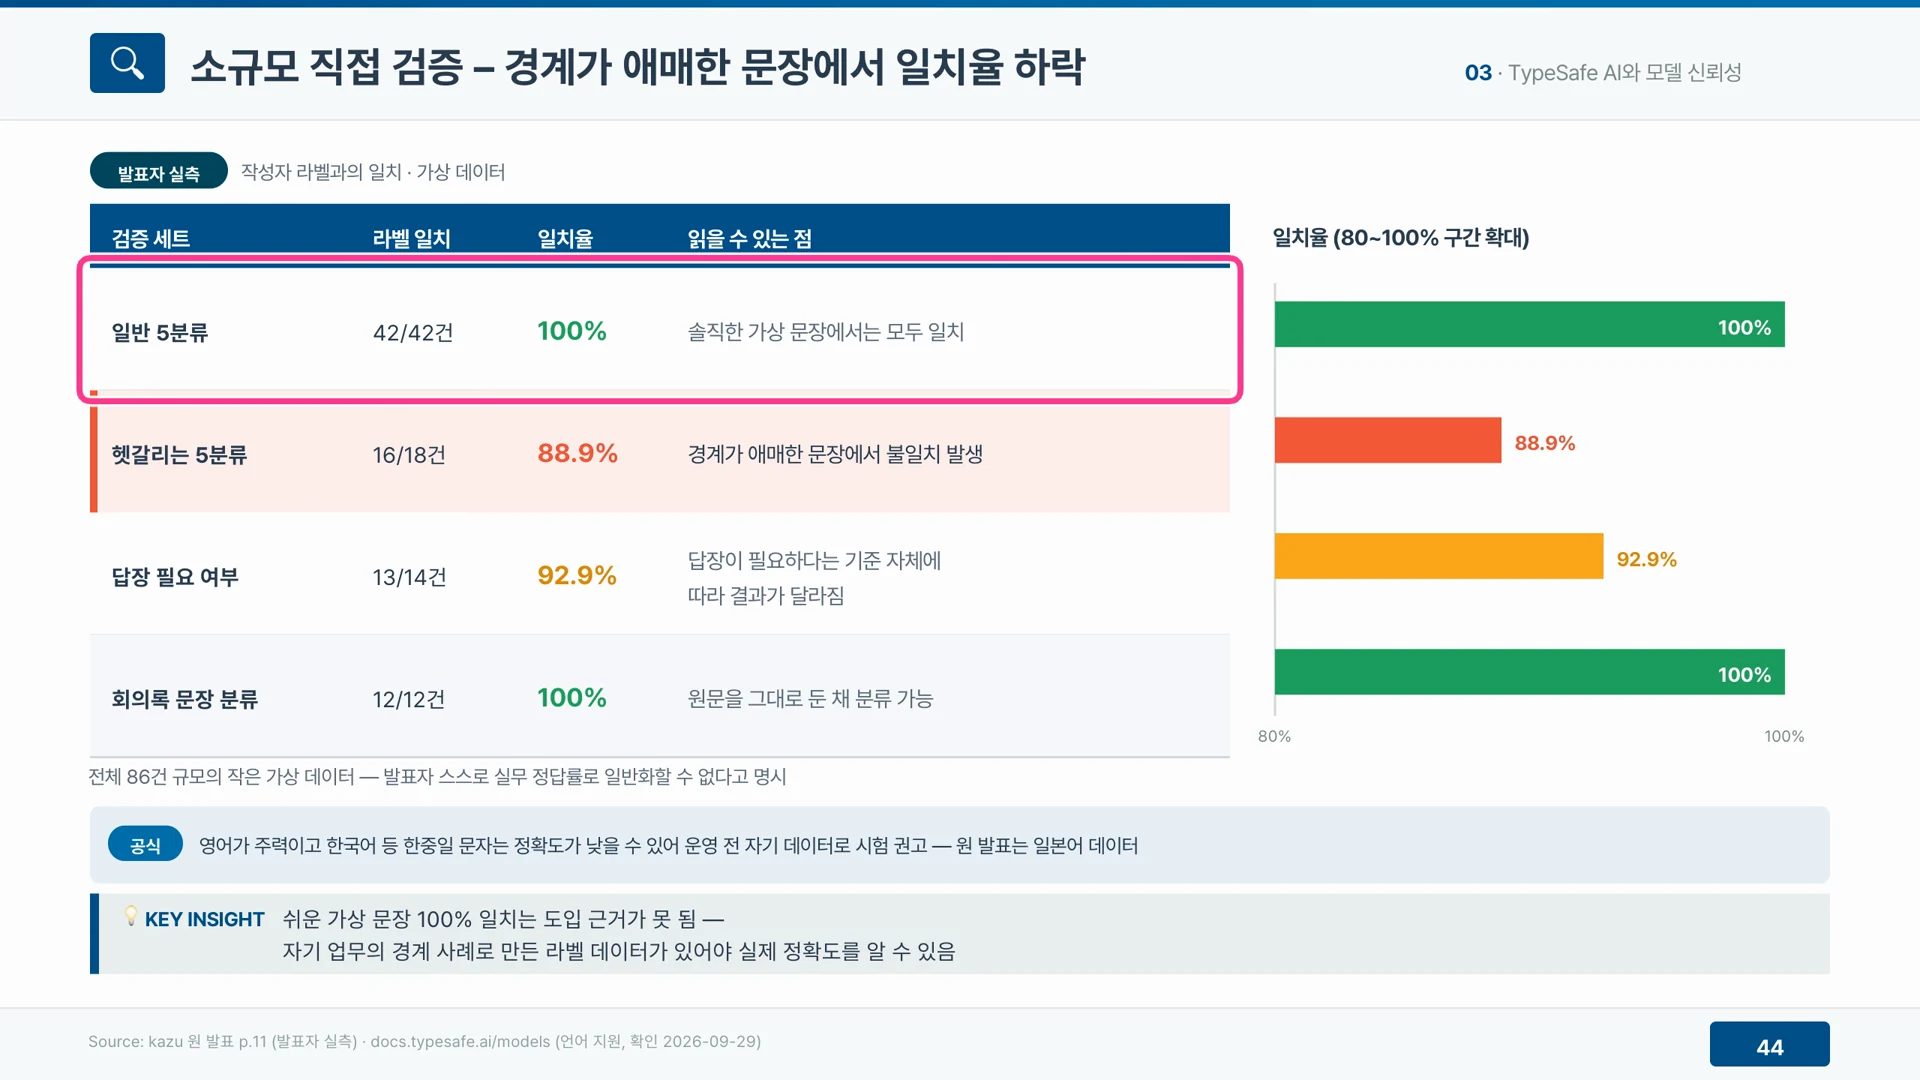
▲ 직접 검증에서 드러난 경계 사례의 한계 (영상 8:18)
캡처 표는 검증 세트별 라벨 일치 건수와 일치율을 보여 줍니다. 일반 5분류 42/42건(100%), 헷갈리는 5분류 16/18건(88.9%), 답장 필요 여부 13/14건(92.9%), 회의록 문장 분류 12/12건(100%)입니다. 오른쪽 막대 그래프는 80~100% 구간에서 이 비율을 시각화하고, 아래 띠는 쉬운 세트에서는 모두 맞았지만 경계 사례에서 틈이 생겼다고 요약합니다.
전체는 86건의 작은 가상 데이터이고, 발표자 스스로 일반화할 수 없다고 적었습니다. 쉬운 연습 문제를 다 맞혔다고 실전 점수를 장담할 수 없는 것과 같습니다. 여기에 공식 문서가 밝힌 한계가 더해집니다. 한국어 같은 한중일 문자는 정확도가 영어보다 낮을 수 있다는 것입니다.
그래서 영상의 마지막 권고는 명확합니다. 우리 업무의 경계 사례로 라벨 데이터를 만들어 직접 재야 한다는 것입니다. 한국어 업무에 쓸 계획이라면 이 검증은 선택이 아니라 도입 전에 먼저 점검해야 한다고 보는 조건입니다. 쉬운 문장보다 담당자끼리도 의견이 갈리는 애매한 문장을 일부러 섞는 것이 핵심이며, 그 세트의 일치율이 도입 판단의 기준선이 됩니다.
핵심 정리
영상의 메시지를 한 문장으로 줄이면, 경력·투자·관심·벤치마크는 각각 다른 질문에 답하므로 따로 확인해야 한다는 것입니다. 아래 표가 각 근거의 확인 수준과 도입 판단에서의 쓰임을 정리합니다.
| 근거 | 확인된 내용 | 확인 수준 | 도입 판단에서의 쓰임 |
|---|---|---|---|
| 창업진 경력 | 오픈에이아이 출신, RLHF 한계 인식 | 공개 자료 | 설계 방향 이해(성능 근거 아님) |
| 연혁 | 9월 15일 공개, 닷새 만에 3곳 탑재, 22일 가입 중단 | 공식·기록 | 공급 안정성 점검 |
| 투자 | 시드 4,000만 달러, 리드 디씨브이씨 | 확정 | 회사 존속 가능성 참고 |
| 기업 가치 100억 달러 | 협상 단계 보도 | 보도 | 사실로 인용 금지 |
| 커뮤니티 | 별 2만 개, 8일간 1.3~1.7배 증가 | 관측 | 사용 유형 힌트(품질 근거 아님) |
| 제삼자 벤치마크 | 2.4배 빠름, 4.8배 저렴, 정답률 1%p 낮음 | 1회 실측 | 재현 시험의 출발점 |
| 직접 검증 | 경계 사례 16/18건, 88.9% | 소규모 가상 | 한국어 자체 시험 필요 |
도입을 검토하는 팀은 위 표의 마지막 두 줄을 자사 데이터로 다시 채워야 한다는 점을 기억하면 됩니다. 라벨 데이터를 만들 때는 쉬운 문장과 경계 문장을 함께 넣고, 속도와 비용도 같은 조건에서 직접 측정해야 합니다.
자주 묻는 질문
TypeSafe AI 신뢰성 검증은 무엇부터 해야 하나요?
경력·투자·관심·벤치마크를 각각 다른 질문으로 나눠 확정·보도·미확인 단계를 먼저 가르는 일부터 시작합니다. 영상은 창업진 이력과 투자 규모만으로는 모델의 신뢰성이 증명되지 않는다고 말하고, 성능은 별도의 근거로 따지라고 권합니다.
제브는 어떤 모델이고 공식 수치는 무엇인가요?
TypeSafe AI가 9월 15일 공개한 시스템 원 모델의 첫 번째 모델로, 현행 버전은 jev-1.13.0입니다. 공식 응답 시간은 70~500밀리초이지만 회사가 스스로 평가한 값이라고 영상은 단서를 붙입니다.
공식 확인된 투자는 얼마인가요?
디씨브이씨가 이끈 4,000만 달러 시드 하나뿐이고, 100억 달러 가치는 협상 단계의 보도입니다. 영상은 라운드가 닫히기 전까지 이 숫자를 사실로 인용하면 안 된다고 말하며, 집계 사이트가 적은 다른 투자자도 보도자료에서 확인되지 않는다고 덧붙입니다.
GitHub 별 수가 늘면 품질이 검증된 것인가요?
아니요. 별 수는 관심도 지표일 뿐 운영 품질의 근거가 아닙니다. 영상은 소개 8일 만에 세 저장소의 별 수가 1.3배에서 1.7배로 늘었다는 사실을 보여 주면서도, 식당 앞에 줄이 길다고 맛이 보장되지는 않는다고 말합니다. 매매 판단용 데모는 모의 거래이기도 합니다.
제삼자 벤치마크에서 제브는 얼마나 빠르고 저렴했나요?
리뷰 판정 실험에서 약 2.4배 빠르고 약 4.8배 저렴했지만 정답률은 비교 모델이 1%p 높았습니다. 다만 합성 리뷰 100건에 라벨만 사람이 붙인 1회 실측이라, 우리 데이터로 다시 재기 전에는 일반화하지 않는 편이 안전하다고 영상은 정리합니다.
경계가 애매한 문장에서는 정확도가 어땠나요?
발표자의 직접 검증에서 경계 사례 18건 중 16건이 일치해 88.9%였습니다. 쉬운 5분류 42건과 회의록 분류 12건은 모두 맞았지만 전체 86건의 작은 가상 데이터라 일반화할 수 없고, 한국어 같은 한중일 문자는 영어보다 정확도가 낮을 수 있다고 공식 문서가 밝힙니다.
도입 전에 우리 팀은 무엇을 직접 해 봐야 하나요?
우리 업무의 경계 사례로 라벨 데이터를 만들어 정확도와 지연, 비용을 같은 조건에서 직접 재야 합니다. 영상의 마지막 권고이며, 한국어 업무라면 쉬운 문장보다 담당자끼리도 의견이 갈리는 애매한 문장을 일부러 섞는 것이 핵심입니다.
참고 리소스
- 원 영상 — 판단형 AI Jev, TypeSafe AI의 창업 배경과 LLM 과의 차별성 (클라우드네이티브TV)
- 판단전용 AI 모델 Jev 입문 발표 자료 — MSAP.ai
- AI 에이전트란 무엇인가 — MSAP.ai
- MSAP.ai 솔루션 문의
- MSAP.ai 홈페이지
- MSAP.ai AI 카테고리
- MSAP.ai 제품 소개
- 판단만 전문인 AI 모델 제브 입문 영상 — 클라우드네이티브TV
- Training language models to follow instructions with human feedback (InstructGPT 논문)
- Deep reinforcement learning from human preferences (RLHF 논문)
- DCVC 공식 사이트
- browser-use GitHub 저장소
- OpenRouter 공식 사이트
- Vercel 공식 사이트
- Cloudflare 공식 사이트
다음 단계
새 AI 모델을 어떤 판단 업무부터 시험하고 어떤 기준으로 도입을 결정할지는 업무 문장과 승인 절차에 따라 달라집니다. 우리 환경에 맞는 AI 에이전트 구조와 검증 방식을 함께 검토하려면 아래에서 시작하세요.