발표자료 다운로드 — 정수 요청에서 속성 선언으로
GPU 할당을 바꾼다는 말은 스케줄러가 보는 정보를 바꾼다는 뜻이다. device plugin 모델에서 스케줄러는 A100 80GB와 T4 16GB를 똑같이 1로 본다. DRA에서는 제품명과 메모리 용량과 MIG 프로파일과 NVLink 묶음이 전부 API 오브젝트에 올라와 있고, 워크로드는 조건을 적기만 한다.
전체 37장, PDF로 37쪽이다. 0부는 MIG와 Time-Slicing과 DRA를 아파트·자동차 시간제·렌터카 비유로 먼저 잡고, 1부는 기존 방식이 무엇을 표현하지 못했는지를 정수 요청·유휴 용량·수동 배치 순서로 짚는다. 2부는 resource.k8s.io 오브젝트 네 개와 CEL 선택 조건, 스케줄러가 기록하는 할당 흐름을 다룬다. 3부는 전용 할당과 Time-slicing과 MPS와 MIG의 격리 차이를, 4부는 플랫폼별 지원 현황과 공존 제약과 장애 대응을 다룬다. 5부는 부록으로 드라이버 내부 동작과 CDI 주입 경로까지 따라간다.
내부 검토 자료나 팀 스터디 자료로 그대로 쓸 수 있도록 별도 가공 없이 원본 구성 그대로 공개한다.
MSAP.ai 백서 구독하기🔔
새로운 백서 소식을 가장 먼저 만나보세요!
MSAP.ai 가 전하는 AI 기반 운영 인사이트와 최신 백서 소식을 가장 빠르게 받아보실 수 있습니다.
구독해 주시면 더 좋은 콘텐츠로 보답하겠습니다.🙏
발표 영상으로 먼저 보기
슬라이드만 보면 DRA가 기존 방식과 무엇이 다른지가 잘 잡히지 않는다. GPU를 개수로만 세던 시절에 무엇이 막혔는지를 먼저 보면 나머지가 순서대로 이어진다.
영상을 먼저 보면 이 발표자료의 논지 흐름이 한 번에 잡힌다.
영상에서 다루는 순서는 다음과 같다.
- 정수 요청 하나로는 적을 수 없는 네 가지 요구
- 예약한 GPU가 유휴로 남는 스케줄링 비효율
- nodeSelector와 taint로 메워 온 수동 배치의 비용
- 속성 기반 요청으로 넘어갈 때 달라지는 것
GPU 자원이 모자란 것과 GPU 자원을 못 쓰는 것은 다른 문제다. 이 구분은 LLM 도입이 실패하는 이유는 GPU가 부족해서가 아니다에서 도입 관점으로 먼저 정리했다.
이 발표자료가 답하는 일곱 가지 질문
GPU 클러스터 운영 회의에서 반복해서 나오는 질문을 기준으로 슬라이드를 배치했다.
- DRA는 device plugin과 무엇이 다른가
- ResourceClaim과 ResourceClaimTemplate은 언제 갈라 쓰는가
- CEL 선택 조건으로 어디까지 표현할 수 있는가
- Time-slicing과 MPS와 MIG 가운데 무엇을 골라야 하는가
- device plugin을 쓰는 노드와 섞어 쓸 수 있는가
- 우리 클러스터 버전과 드라이버로 지금 도입할 수 있는가
- 파드가 Pending에 멈추면 어디부터 보는가
GPU 한 장을 나눠 쓰는 세 가지 방식
MIG는 GPU를 하드웨어 수준에서 쪼개 독립된 인스턴스로 만든다. 아파트를 방 단위로 나누는 것과 같다. Time-Slicing은 같은 GPU를 시간으로 돌려 쓴다. 자동차를 시간제로 나눠 타는 쪽에 가깝다. DRA는 나누는 기술이 아니라 배정하는 체계다. 빌렸다가 반납하는 렌터카 창구에 해당한다. 셋을 같은 층위에 놓고 비교하면 논의가 엉킨다.
렌터카 비유를 한 단계 더 밀면 DRA의 동작 순서가 그대로 나온다. 차량 등록이 ResourceSlice, 예약이 ResourceClaim, 배차가 Allocation, 인도가 NodePrepare, 반납이 Deallocate다. 다섯 단계가 모두 API 오브젝트로 남기 때문에 지금 어느 칸에서 멈췄는지를 사람이 아니라 클러스터에 물어볼 수 있다. device plugin 모델에는 예약과 반납에 해당하는 단계가 아예 없었고, 그것이 DRA가 새로 만든 자리다.
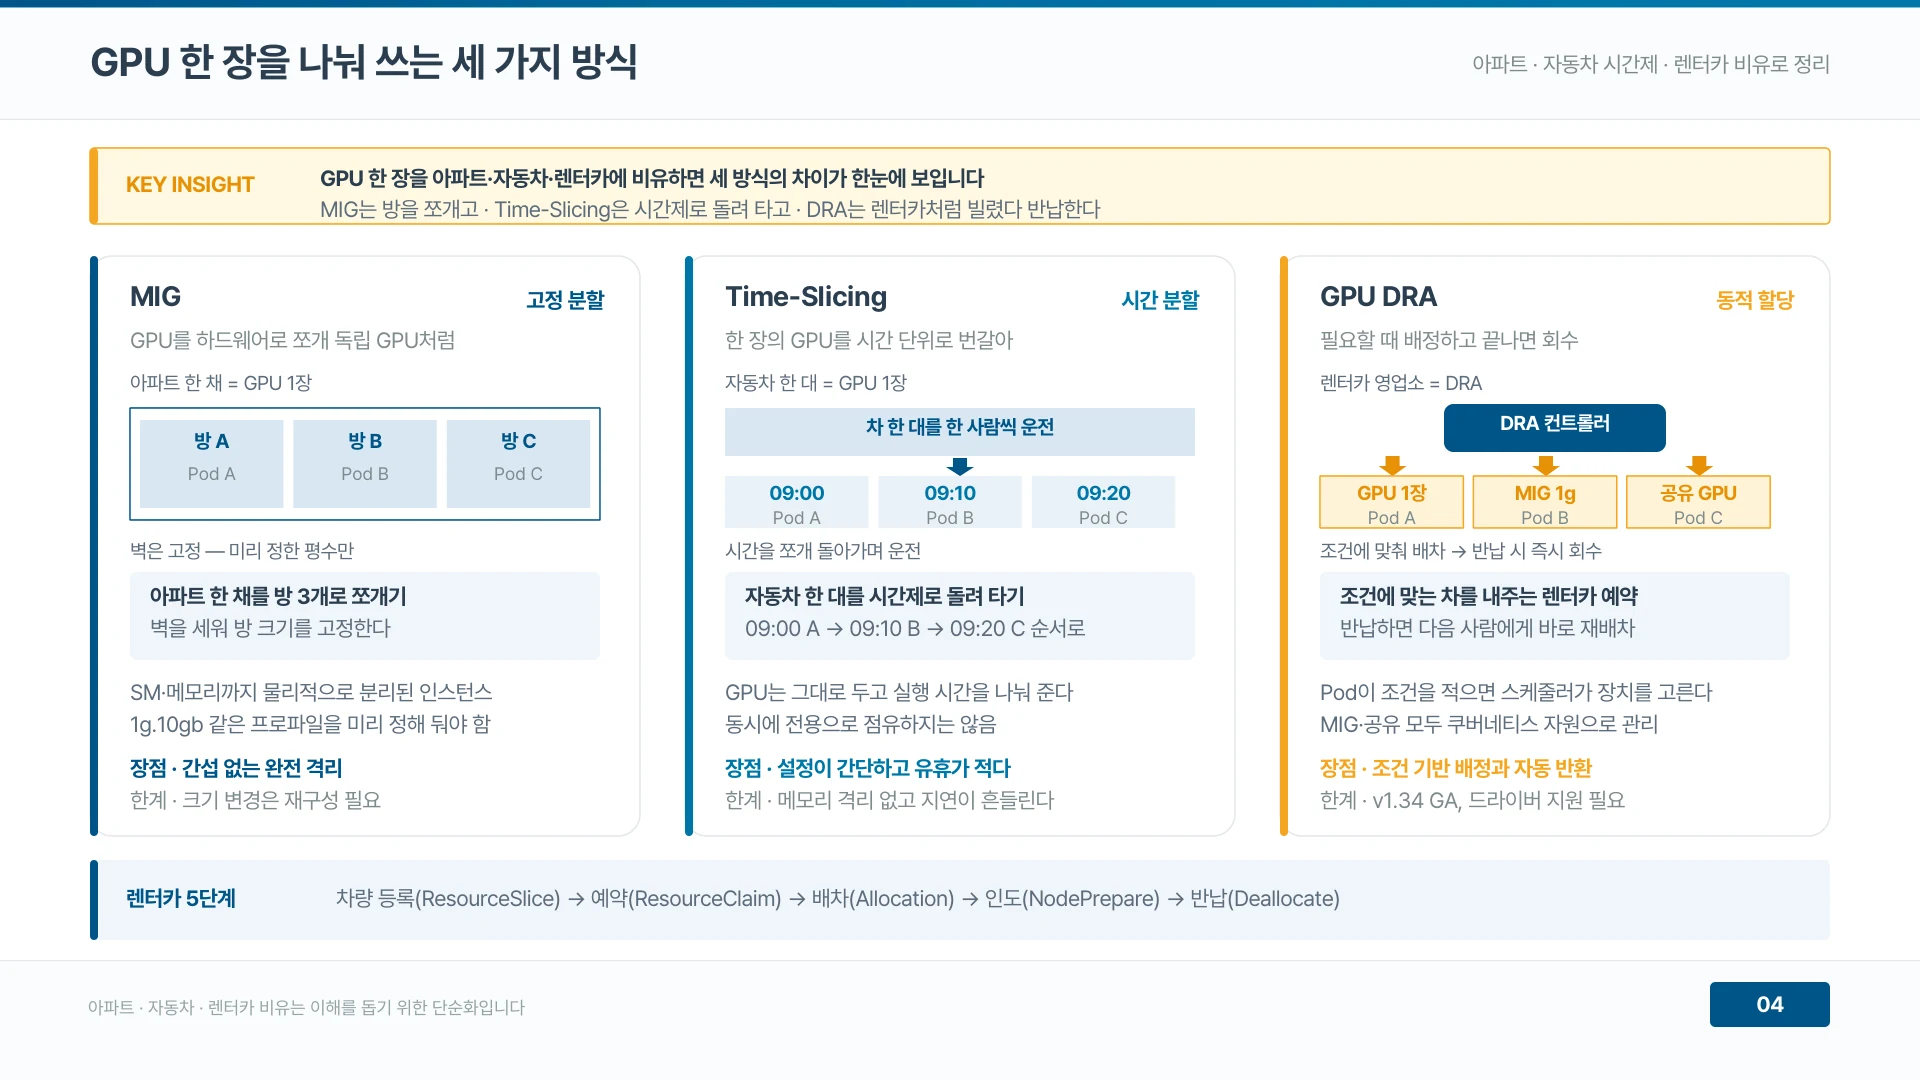
▲ MIG는 GPU를 쪼개고 Time-Slicing은 시간을 나누며 DRA는 빌렸다 반납한다 (발표자료 4쪽)
정수 요청으로는 어떤 GPU인지 적을 수 없다
device plugin 모델에서 파드가 GPU를 요청하는 방법은 nvidia.com/gpu: 1 같은 정수 하나뿐이다. 스케줄러는 A100 80GB와 T4 16GB를 똑같이 나눌 수 없는 한 단위로 본다. 그래서 메모리 40GB 이상, MIG 1g.10gb 프로파일, 두 파드의 명시적 공유, GPU와 NIC의 연결 구조 같은 요구를 어디에도 적을 수 없다. MIG는 프로파일마다 리소스 이름을 미리 정의하는 우회책이 있었고, Time-slicing의 복제본 슬롯은 용량 보장이 아니라 접근 권한일 뿐이었다.
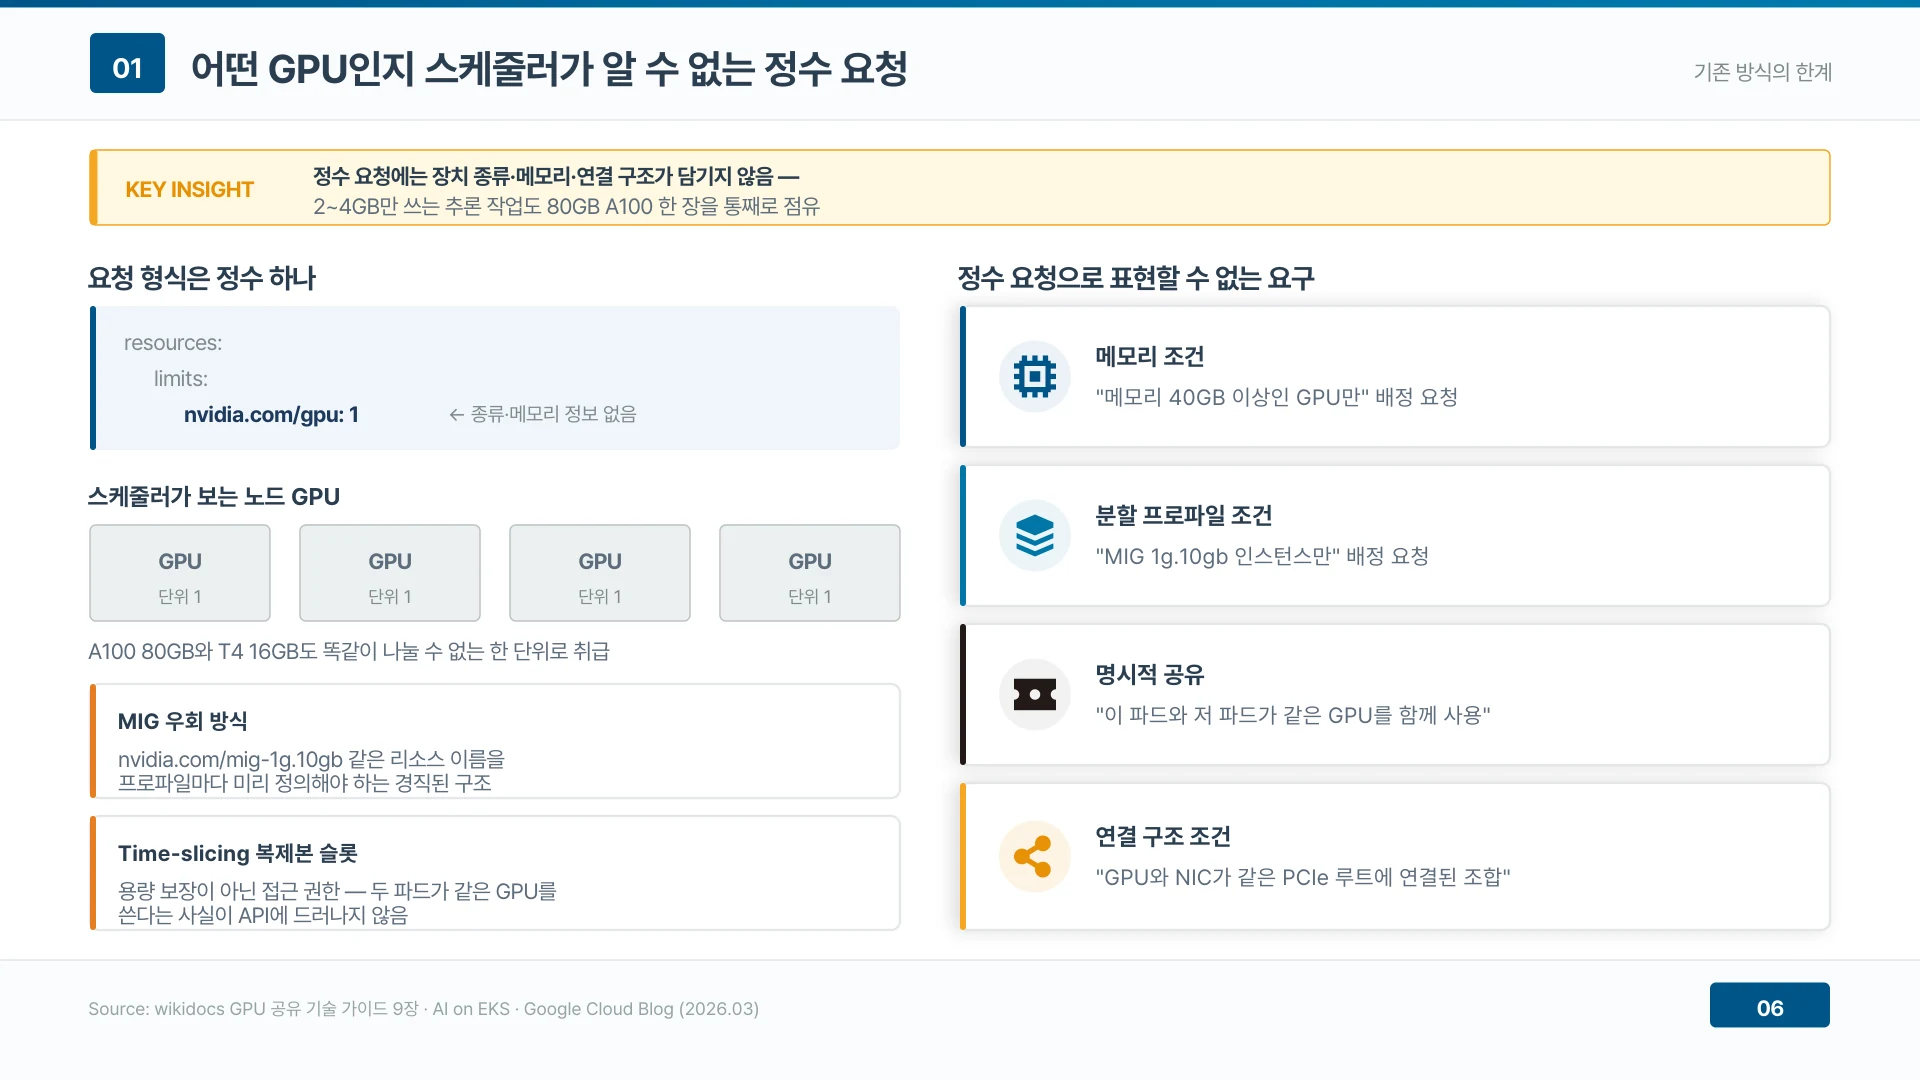
▲ 정수 요청 하나에는 장치 종류도 메모리도 연결 구조도 담기지 않는다 (발표자료 6쪽)
예약한 GPU가 유휴로 남는다
AWS는 수요가 높은 AI 클러스터에서도 GPU 활용률이 40% 미만인 경우가 흔하다고 설명한다. saaro가 인용한 Cast AI 2026 연구는 운영 클러스터에서 실제로 쓰이는 GPU 자원을 평균 5%로 보고했다. 두 수치는 측정 대상과 방법이 달라 한 축에 놓고 비교할 수 없지만, 가리키는 원인은 같다. 할당 단위가 GPU 한 장이라는 점이다. 그 결과가 큐 기아와 자원 단편화, 토폴로지 무인식, 과다 프로비저닝 네 가지 증상으로 드러난다.
수치를 읽을 때 한 가지를 더 본다. GPU 활용률은 수집기가 읽을 수 있는 값만으로 계산된다. DCGM 계열 수집기는 전용 프레임버퍼를 가진 분리형 GPU를 전제로 기본값을 정해 두었고, 통합 메모리를 쓰는 장비나 프로세스별 사용률을 아직 노출하지 않는 플랫폼에서는 그 칸이 빈 채로 집계된다. NVIDIA가 아직 제공하지 않는다고 밝힌 질의는 수집기를 다른 제품으로 바꿔도 채워지지 않으므로, 어떤 필드를 무엇으로 대신할지부터 정해야 한다. 그래서 활용률이 낮다는 보고를 받으면 숫자보다 측정 대상과 수집 경로를 먼저 확인해야 하고, 할당 방식을 바꾸기 전에 무엇을 재고 있었는지부터 고정해 두어야 한다.
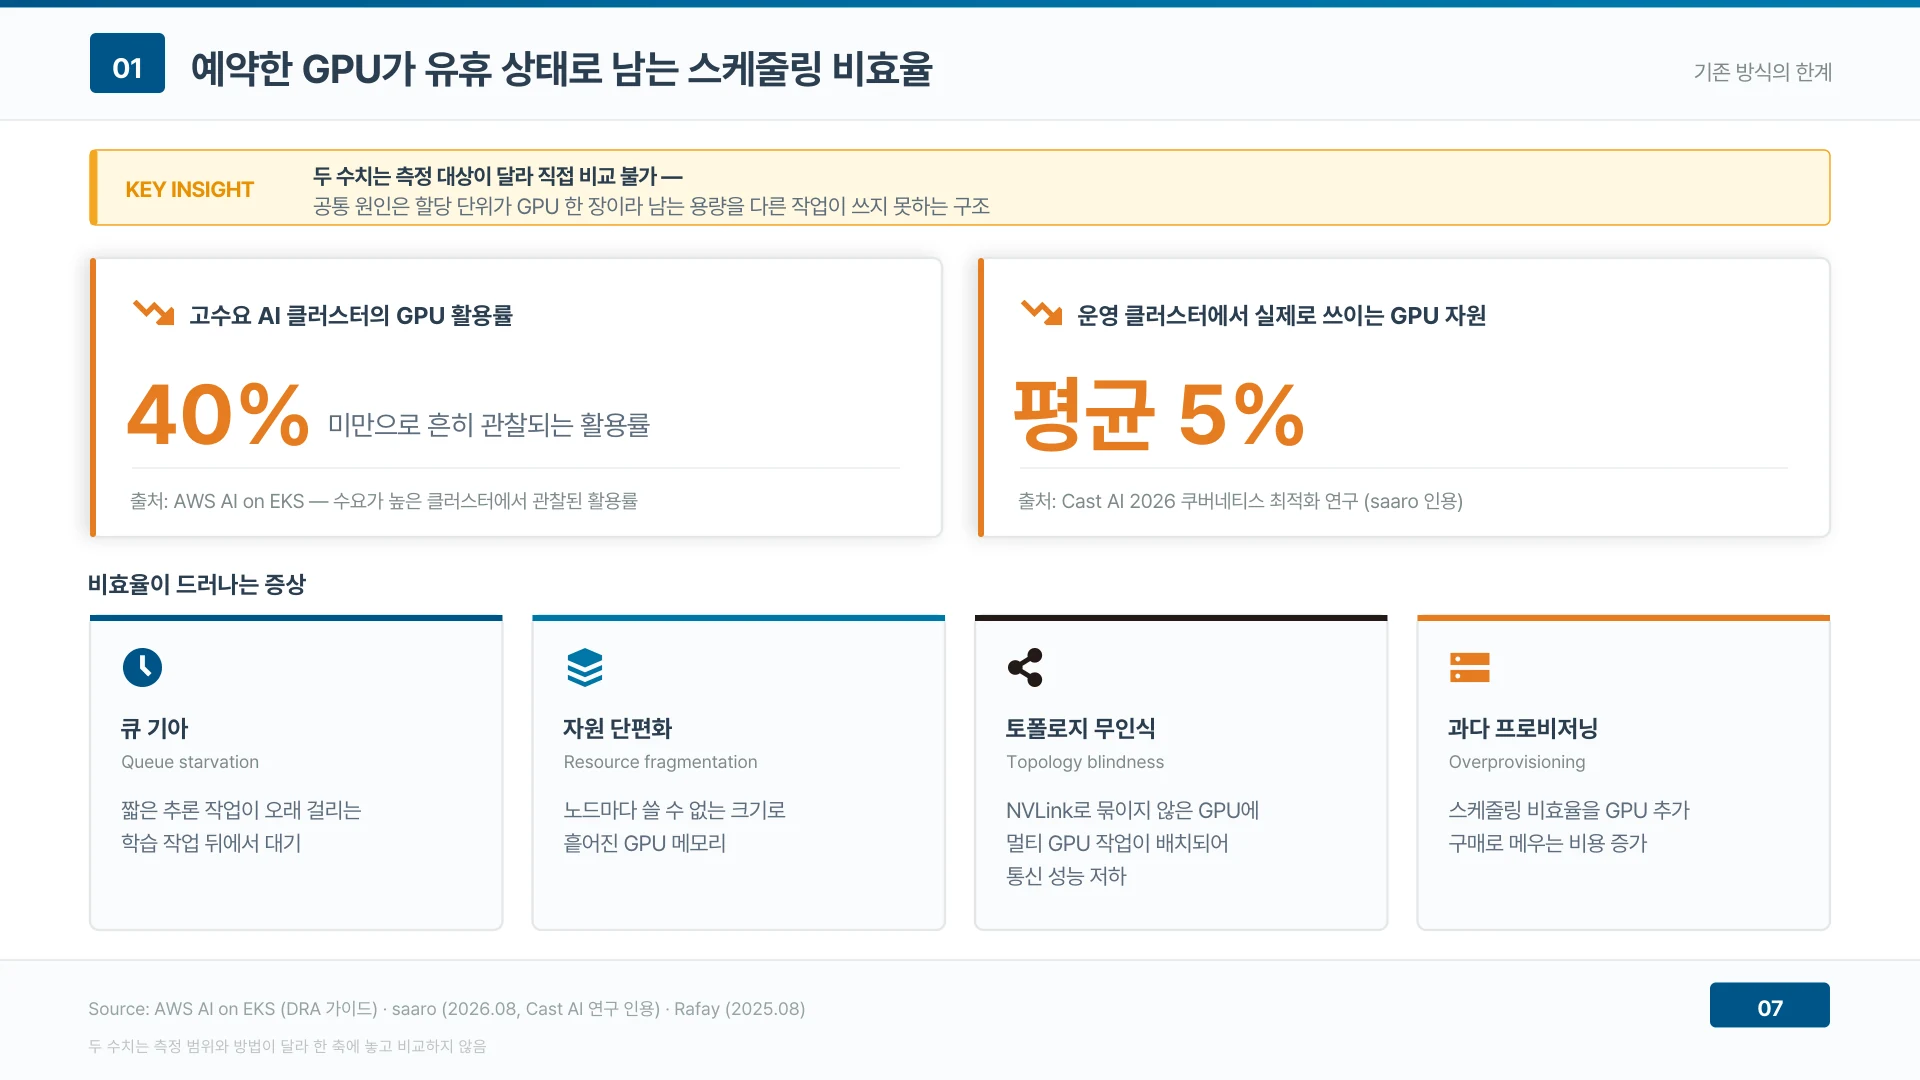
▲ 할당 단위가 GPU 한 장이라 예약한 카드가 유휴로 남는다 (발표자료 7쪽)
노드 라벨에 기대는 수동 배치
운영자는 이 한계를 매니페스트로 메워 왔다. nodeSelector로 GPU 노드 그룹을 지정하고, affinity로 인스턴스 후보를 나열하고, taint와 toleration으로 일반 파드를 막고, 필요하면 웹훅이나 스케줄러 확장까지 붙인다. 네 겹을 모두 맞춰야 원하는 GPU 노드에 닿는다. 문제는 GPU 구성 정보가 팀별 배포 파일에 중복으로 기록된다는 점이다. 장비를 증설하거나 교체할 때마다 여러 팀의 매니페스트를 함께 고쳐야 한다.
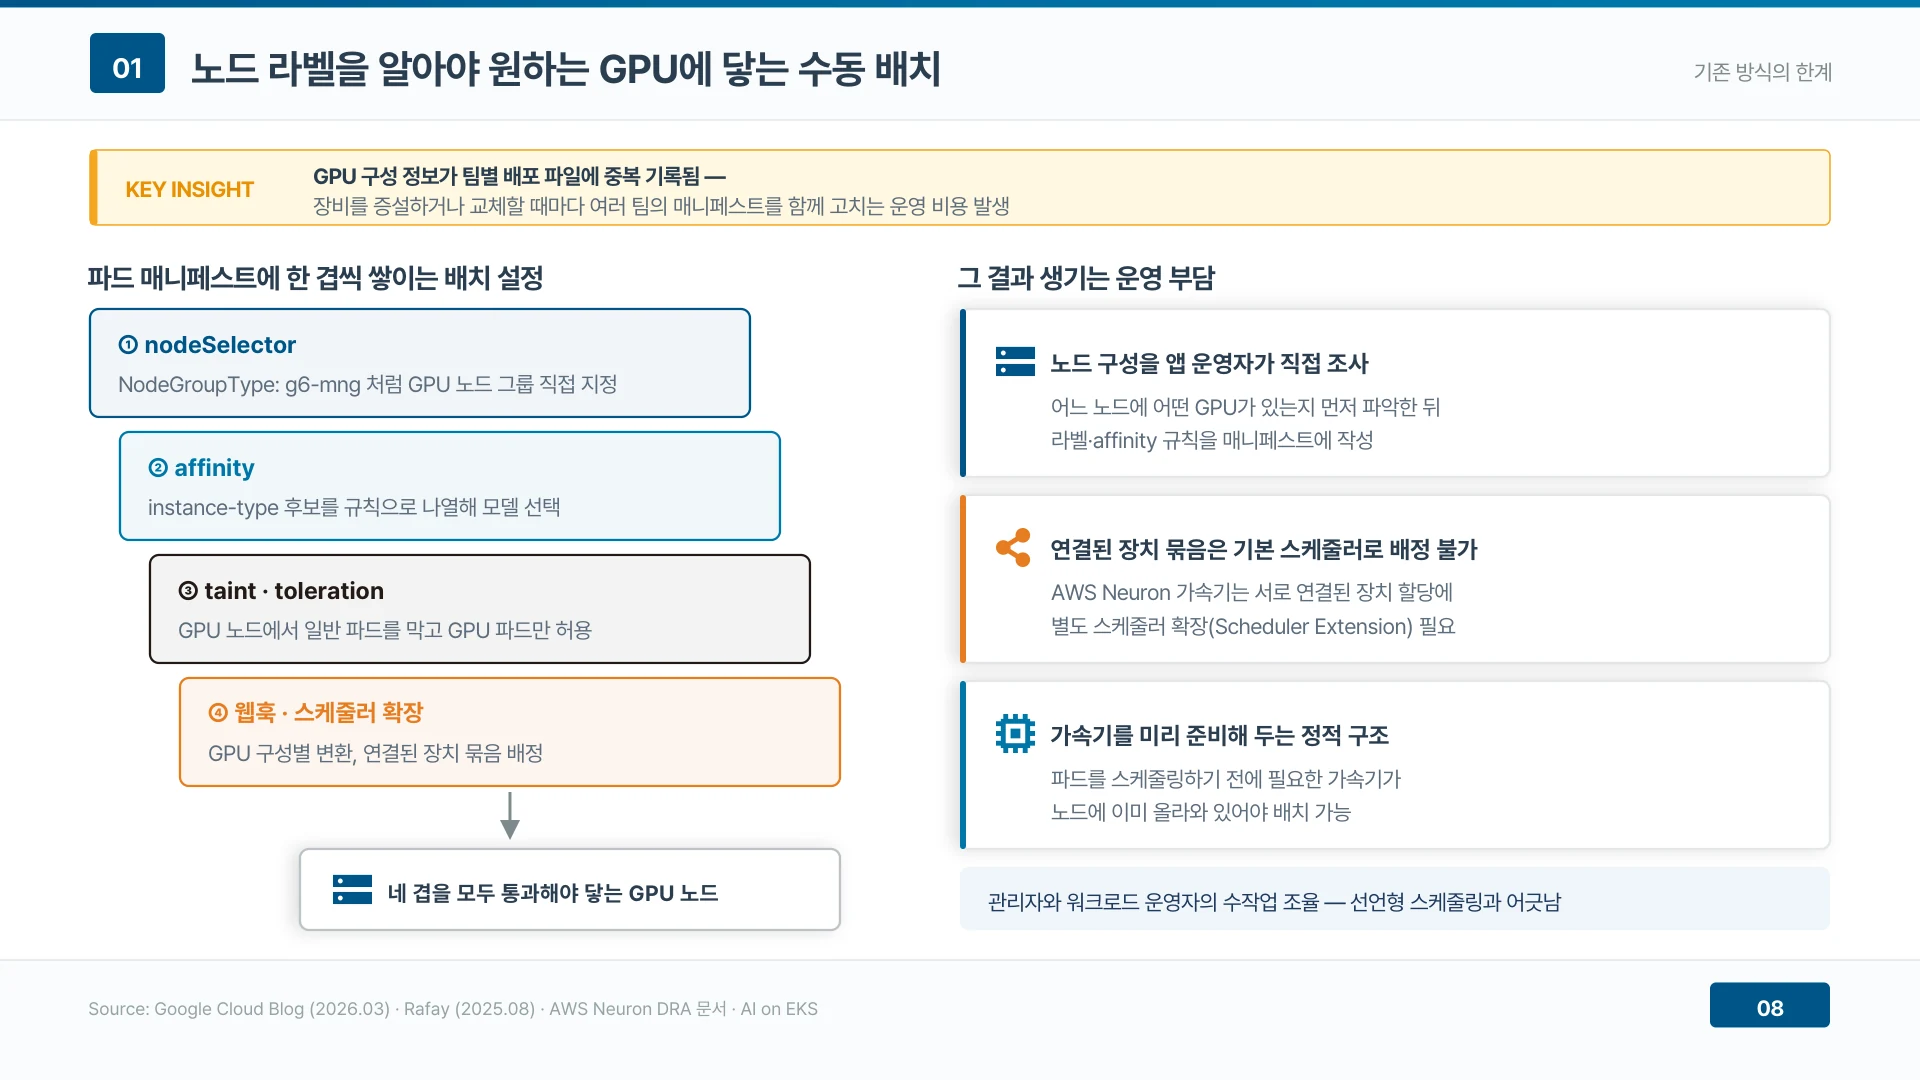
▲ GPU 구성 정보가 팀별 배포 파일에 중복으로 기록된다 (발표자료 8쪽)
DRA는 PersistentVolume 모델을 그대로 옮겨 왔다
DRA는 새 개념처럼 보이지만 구조는 스토리지의 PersistentVolume 모델과 거의 같다. StorageClass는 DeviceClass, PersistentVolumeClaim은 ResourceClaim, volumeClaimTemplates는 ResourceClaimTemplate, PersistentVolume은 ResourceSlice에 대응한다. 만드는 주체도 나뉜다. ResourceSlice는 드라이버가 노드별로 게시하고, DeviceClass는 드라이버와 관리자가, ResourceClaim과 템플릿은 워크로드 운영자가 작성한다. PVC를 써 본 운영자라면 학습 비용이 크지 않고, 요청과 재고가 분리되어 있어 워크로드는 노드 구성을 몰라도 조건에 맞는 장치를 받는다.
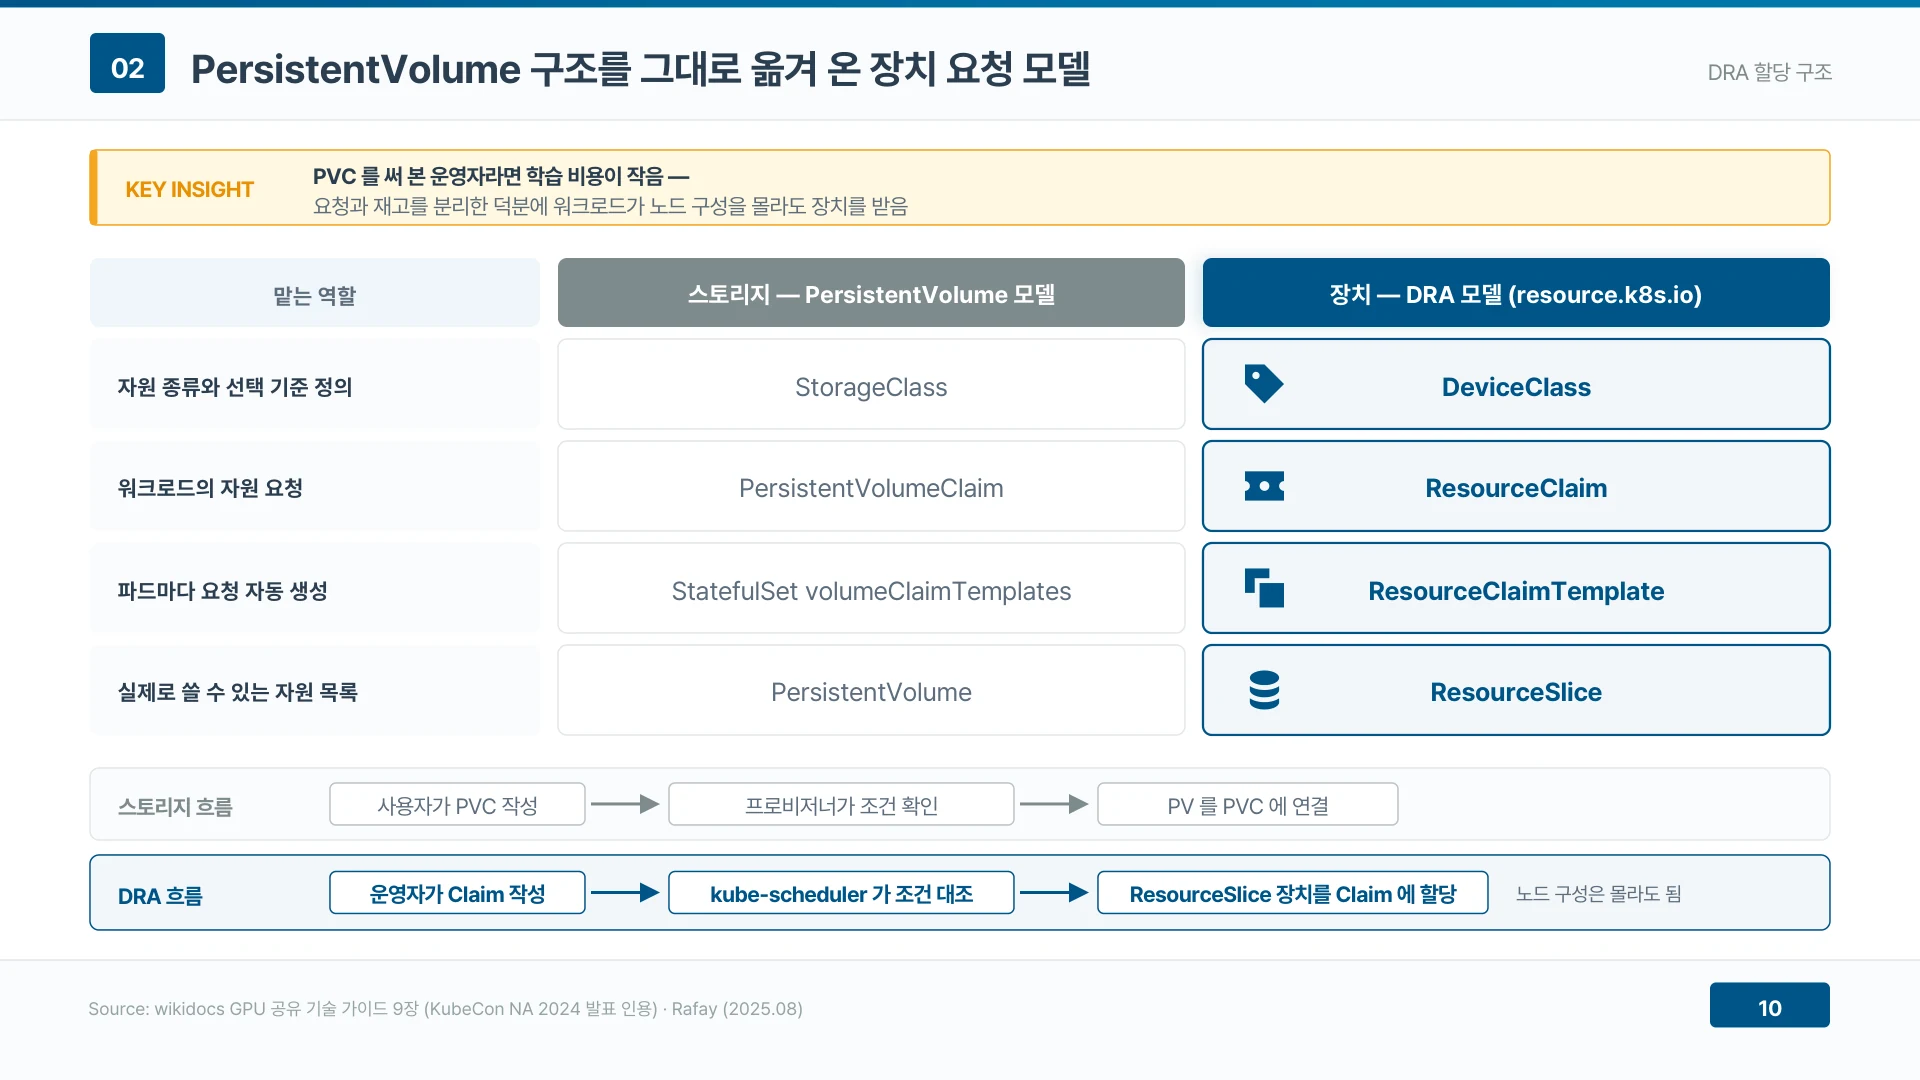
▲ DeviceClass와 ResourceClaim은 StorageClass와 PVC를 그대로 옮겨 온 구조다 (발표자료 10쪽)
CEL로 장치 속성을 직접 고른다
요청 안에서 어떤 장치를 원하는지는 CEL 표현식으로 적는다. 속성 조건으로 MIG 프로파일이나 제품명을 비교하고, 용량 조건으로 GPU 메모리 하한을 걸고, 두 조건을 한 식으로 묶을 수도 있다. 장치 사이 조건인 constraints의 matchAttribute를 쓰면 서로 연결된 가속기 네 개처럼 묶음 단위로 요청한다. 덕분에 세대가 섞인 장비도 하나의 스케줄링 영역으로 운영할 수 있고, 장비를 늘려도 워크로드 매니페스트를 고칠 필요가 없다.
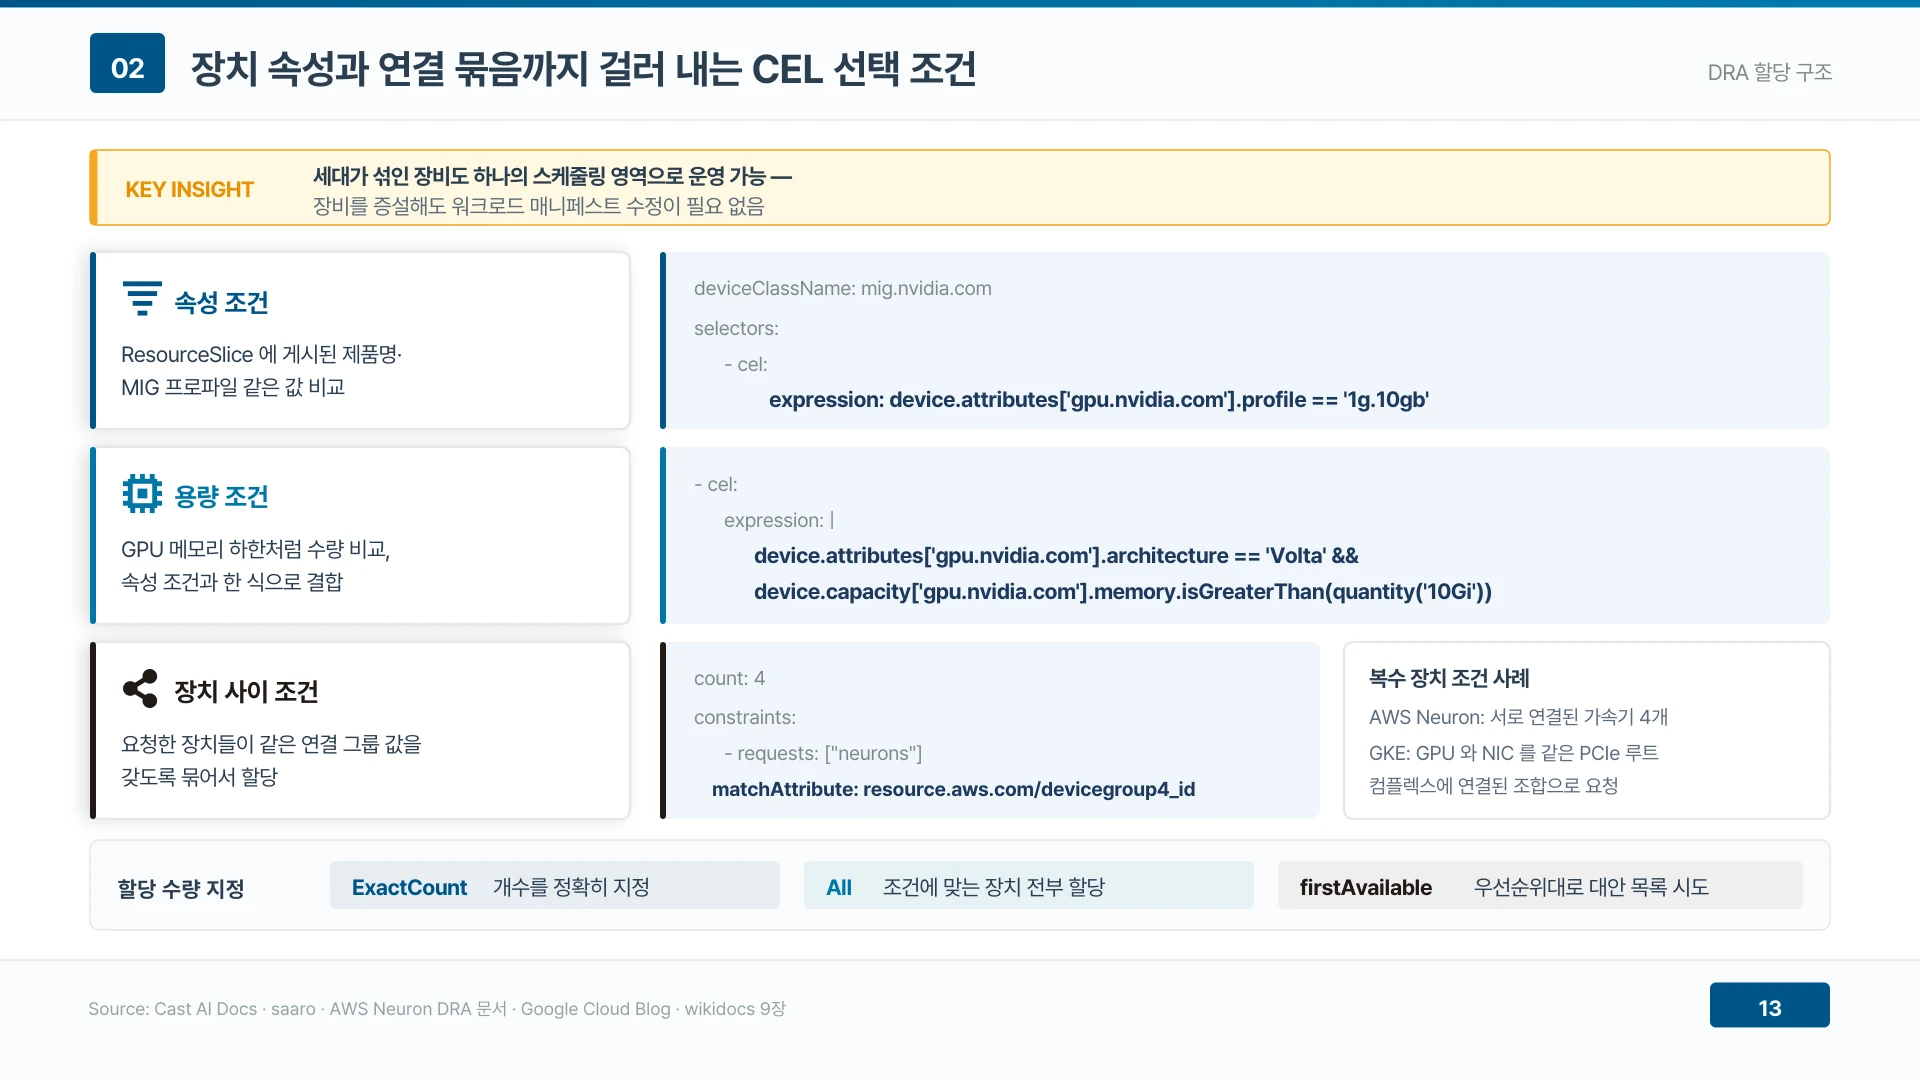
▲ CEL 선택 조건은 속성과 용량과 장치 사이 연결까지 걸러 낸다 (발표자료 13쪽)
스케줄러가 Claim에 결과를 기록한 뒤 노드로 넘긴다
할당은 다섯 단계로 진행된다. 드라이버가 ResourceSlice를 게시하고, 템플릿을 참조한 경우 resourceclaim-controller가 Claim을 만들고, 스케줄러가 조건에 맞는 미할당 장치를 first-fit으로 고르고, 결과를 ResourceClaim의 status.allocation에 기록하고, 선택된 노드의 kubelet과 드라이버가 장치를 준비해 컨테이너에 연결한다. 할당 결과가 API 오브젝트에 남기 때문에 장애가 나면 ResourceClaim 상태만 보고도 어느 단계에서 멈췄는지 추적할 수 있다. 주의할 점이 하나 있다. spec.nodeName을 직접 지정하면 스케줄러를 건너뛰어 파드가 멈추므로, 특정 노드가 필요할 때는 nodeSelector를 써야 한다.
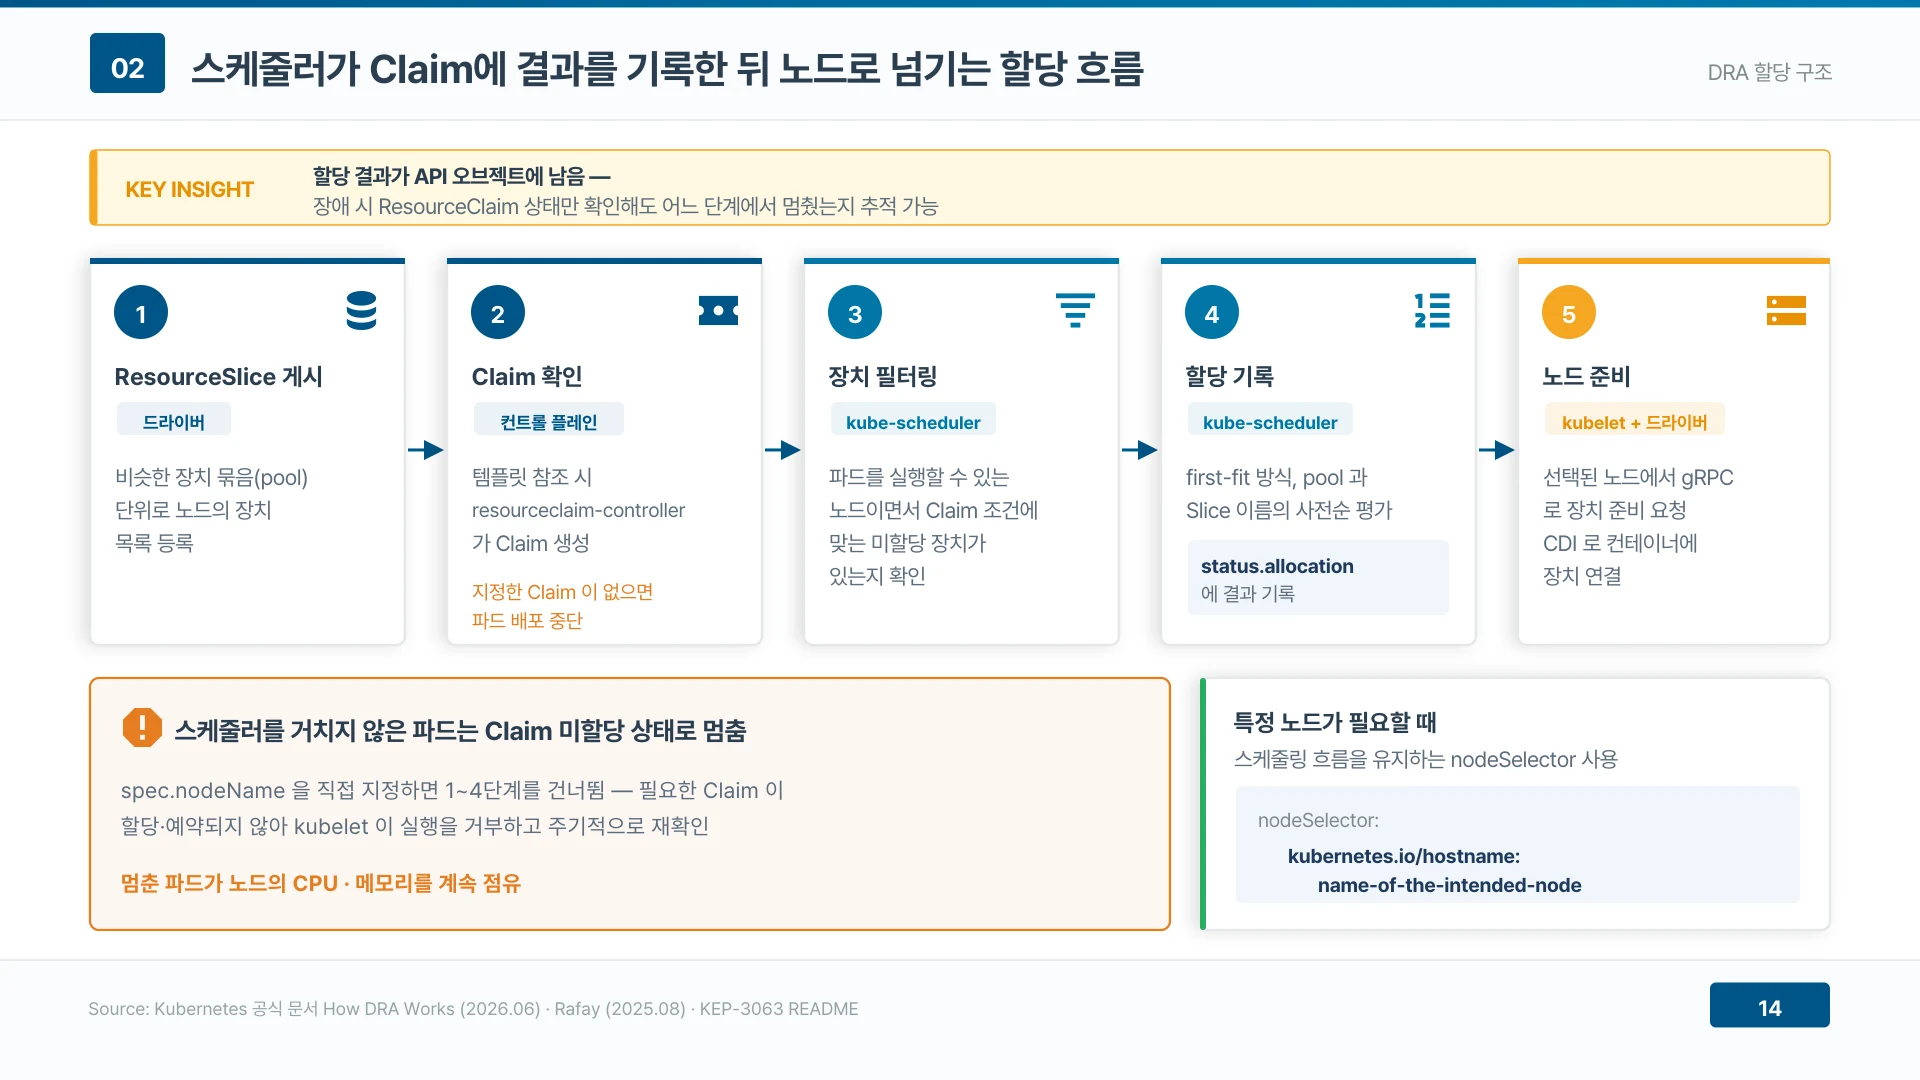
▲ 스케줄러가 고른 결과가 ResourceClaim에 남아 어디서 멈췄는지 추적된다 (발표자료 14쪽)
구조화 파라미터로 갈아탄 이유는 오토스케일러였다
DRA는 v1.26에서 드라이버 컨트롤러와 스케줄러가 협상하는 KEP-3063 방식으로 출발했지만, v1.32에서 그 방식이 철회되고 구조화 파라미터가 기준이 되었다. 이후 v1.34에서 GA와 기본 활성화에 도달했고, v1.35에서는 쿠버네티스 AI Conformance의 첫 필수 요건이 되었다. 철회 이유의 핵심은 오토스케일러다. 파라미터가 불투명하면 Cluster Autoscaler가 노드를 늘렸을 때의 효과를 계산할 수 없고, 그러면 GPU 노드 자동 확장이 성립하지 않는다. 일부 자료는 v1.35를 GA로 적지만 이 발표자료는 공식 블로그 기준인 v1.34를 따른다.
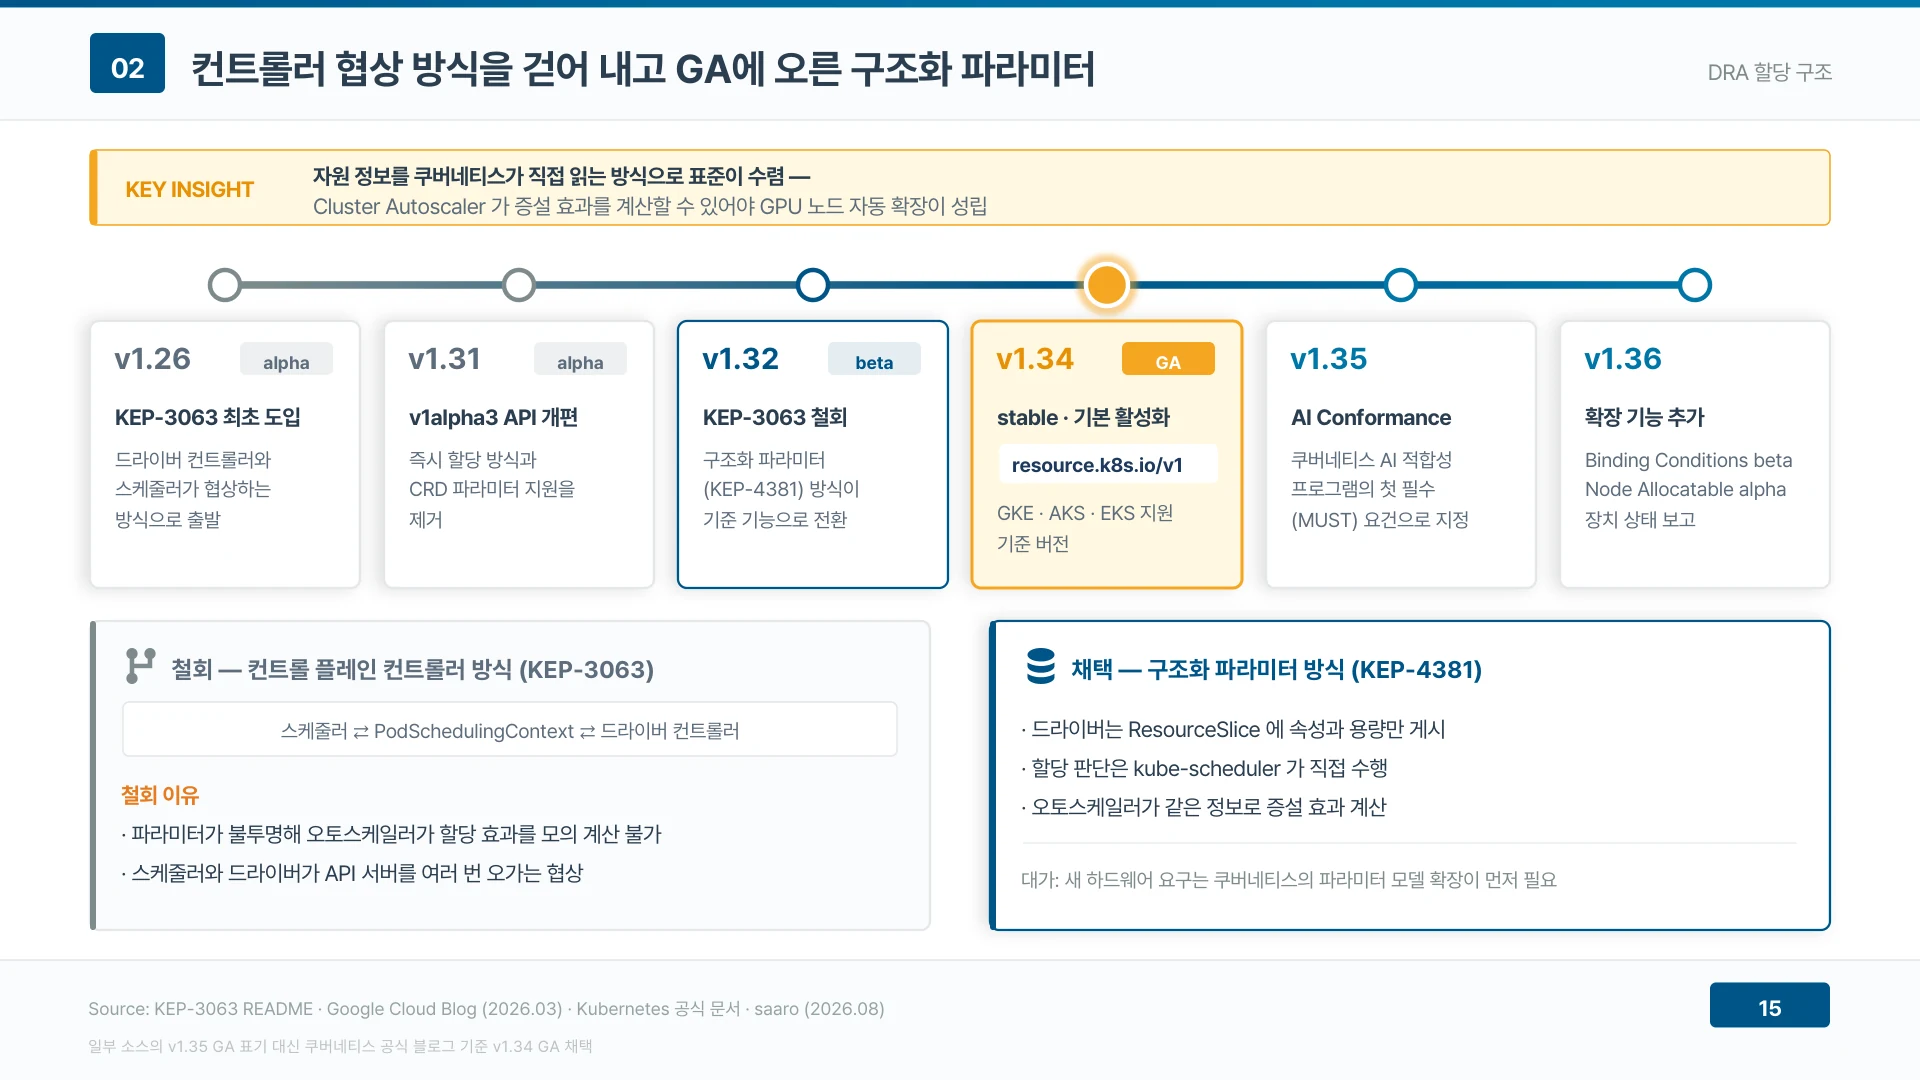
▲ 컨트롤러 협상 방식을 걷어 내고 구조화 파라미터로 v1.34 GA에 올랐다 (발표자료 15쪽)
공유 방식을 Claim마다 다르게 정한다
device plugin은 클러스터 전역 ConfigMap으로 공유 방식을 고정했다. DRA는 ResourceClaim의 config 항목에 요청마다 GpuConfig를 지정한다. 그래서 한 클러스터 안에서 추론은 MPS로, 개발 환경은 Time-slicing으로 섞어 쓸 수 있다. 격리 수준은 기술마다 다르다. 전용 할당은 완전히 격리되지만 활용률이 가장 낮고, Time-slicing은 메모리와 장애 격리가 없어 한 작업의 메모리 고갈이 같은 장치의 다른 작업을 멈추게 할 수 있다. MPS는 프로세스별 메모리를 나누고 병렬로 실행하며, MIG는 하드웨어 수준에서 장애까지 격리한다. 다만 MPS는 드라이버의 MPSSupport 기능을 켜야 하고, 같은 GPU를 공유하는 복제본은 같은 노드에 있어야 한다.
| 공유 방식 | 동시 실행 | 메모리 격리 | 장애 격리 | DRA에서 고르는 자리 | 맞는 워크로드 |
|---|---|---|---|---|---|
| 전용 할당 | 없음 | 완전 | 완전 | ResourceClaimTemplate | 분산 학습, 성능 보장이 필요한 배치 |
| Time-slicing | 순차 | 없음 | 없음 | ResourceClaim의 GpuConfig | 개발·실험 환경 |
| MPS | 병렬 | 프로세스별 분리 | 부분 | ResourceClaim의 GpuConfig | 소형 추론 서비스 다수 |
| MIG | 병렬 | 하드웨어 분리 | 완전 | CEL 프로파일 조건 | 운영 추론, 테넌트 분리 |
표를 세로로 읽으면 선택이 단순해진다. 격리가 필요하면 위에서, 밀도가 필요하면 아래에서 고른다.
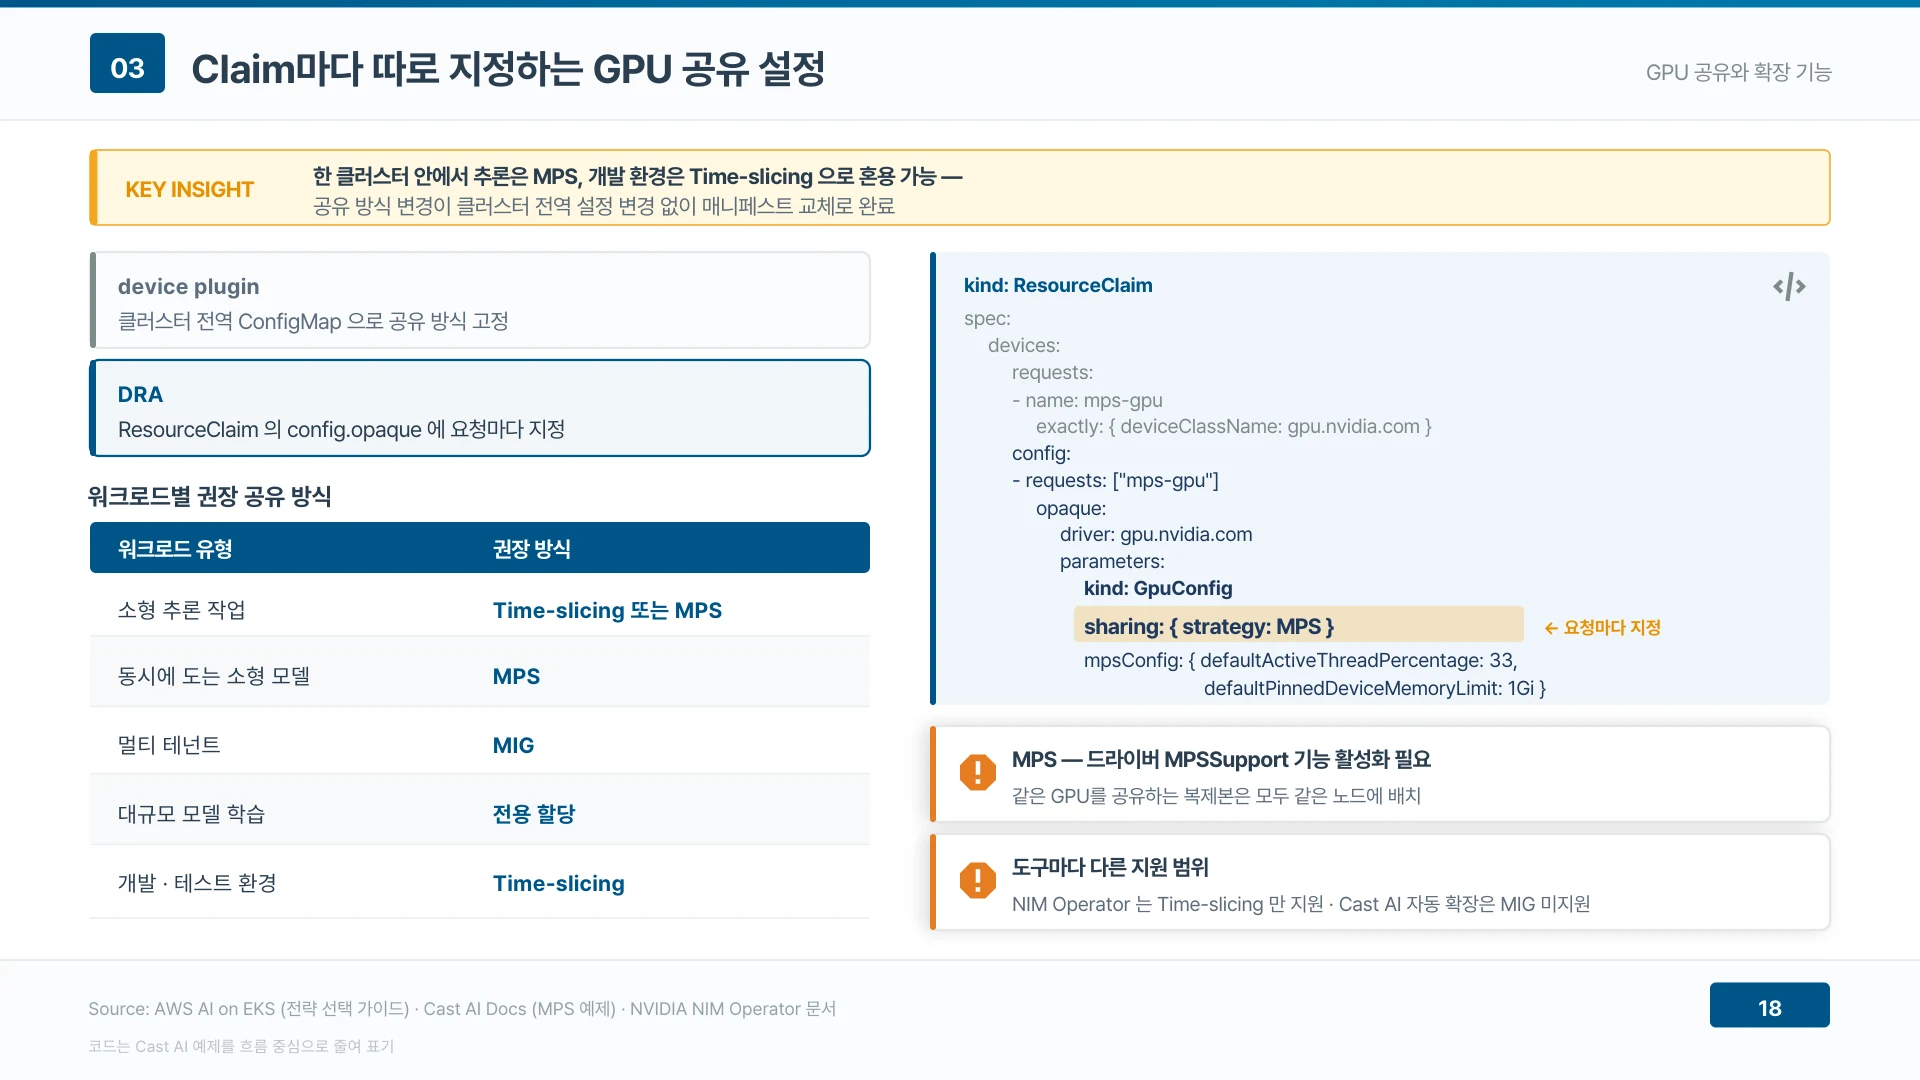
▲ 공유 방식을 Claim마다 지정해 추론은 MPS, 개발은 Time-slicing으로 섞는다 (발표자료 18쪽)
NVLink와 PCIe 연결 구조를 배치에 반영한다
공유만큼 중요한 것이 연결 구조다. NVIDIA ComputeDomain은 NVLink와 IMEX로 묶인 GPU 그룹을 하나의 요청 대상으로 다루고, AWS Neuron은 devicegroup 속성으로 서로 연결된 가속기 묶음을 요청한다. GPU와 NIC을 같은 PCIe 루트에 연결된 조합으로 요청하면 분산 학습의 지연을 줄일 수 있다. AWS 문서에 따르면 EC2 P6e-GB200 UltraServer는 DRA가 필수이고 device plugin 방식으로는 동작하지 않는다. GB200 계열 도입 계획이 있다면 DRA 전환이 선행 조건이다.
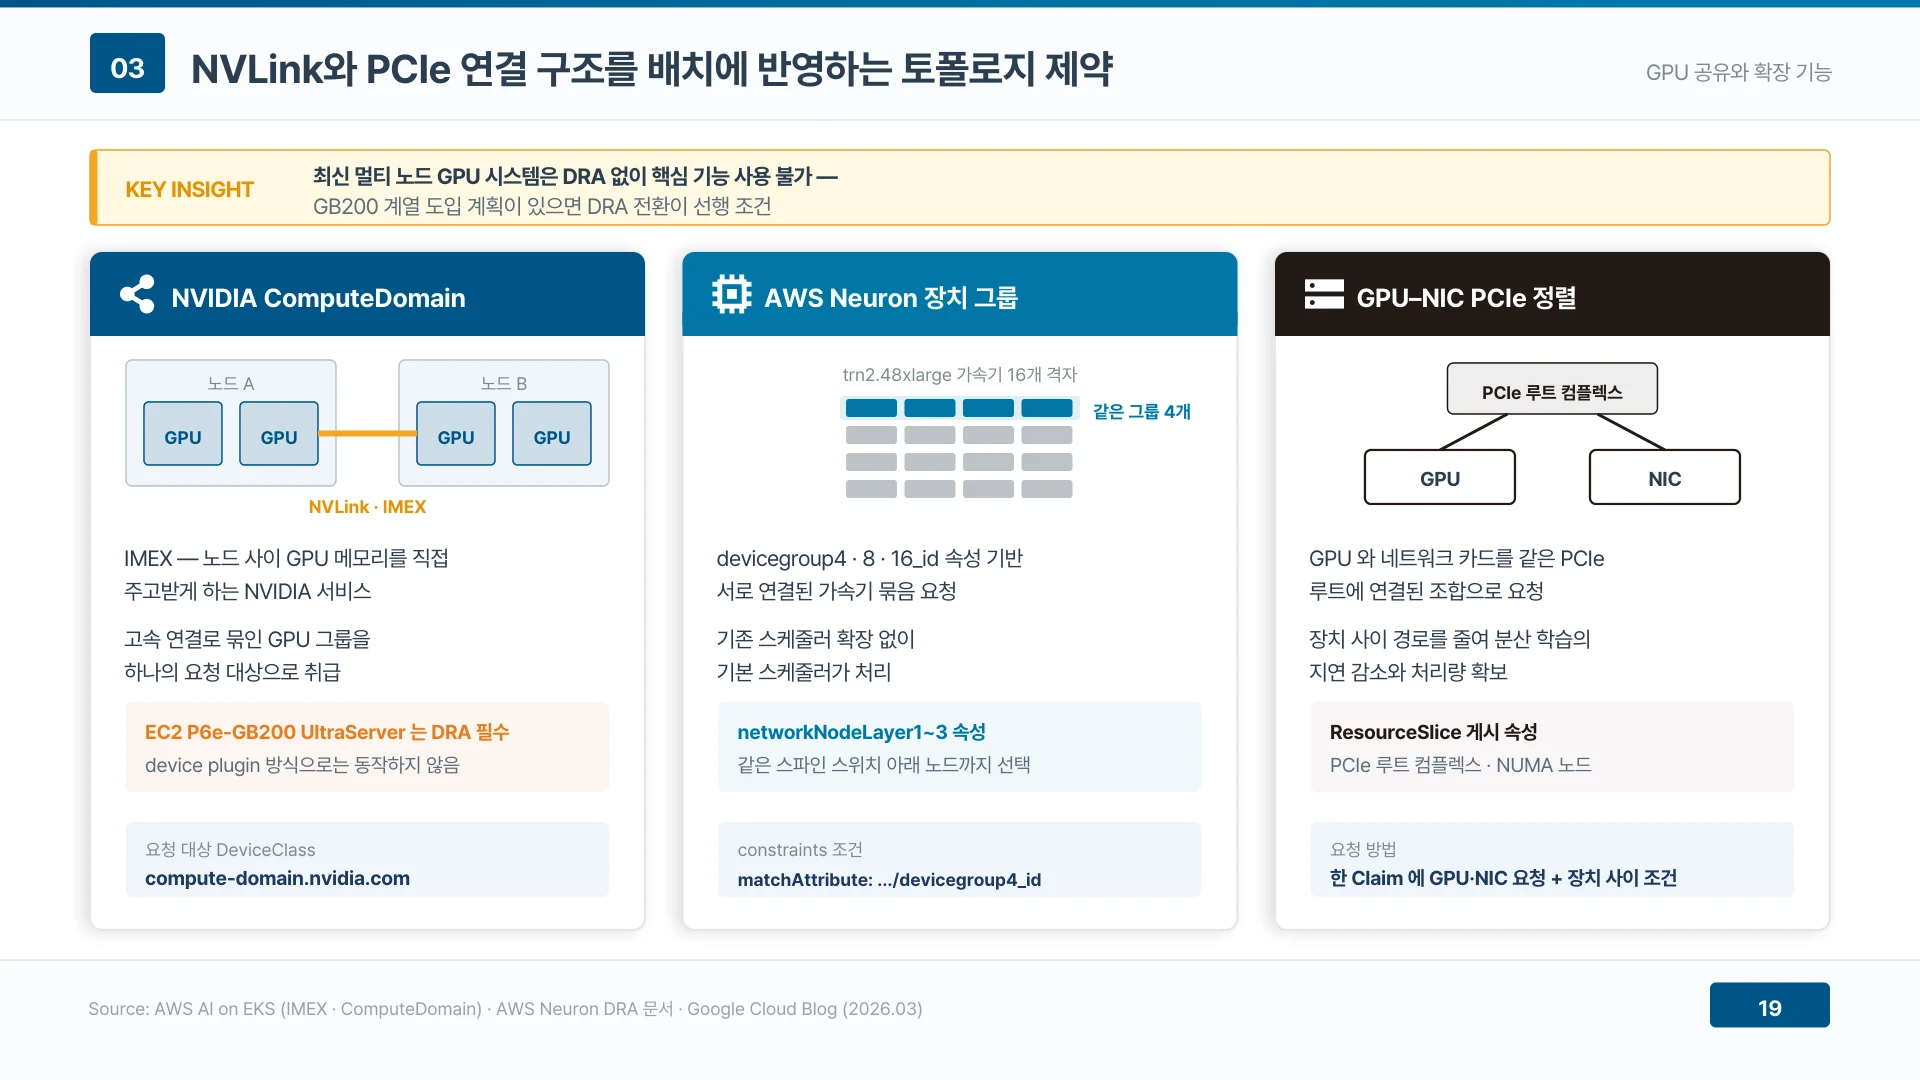
▲ NVLink와 PCIe 연결 구조를 요청에 적어야 최신 멀티 노드 GPU가 동작한다 (발표자료 19쪽)
플랫폼마다 요구 조건이 다르다
관리형 쿠버네티스마다 DRA 요구 조건이 조금씩 다르다. GKE는 NVIDIA GPU와 Google TPU용 DRA 드라이버를 정식 지원하고, EKS와 AKS와 Cast AI는 모두 1.34 이상을 요구하며, AWS Neuron은 노드 AMI 1.34.2 이상이 필요하다. AKS는 A10 vGPU 분할 VM을 지원하지만 GRID 드라이버 노드에서는 IMEX 관련 기능을 꺼야 한다. OpenShift는 4.21에서 DRA를 GA로 올렸고, NIM Operator의 DRA 지원은 아직 기술 프리뷰다. 같은 DRA라도 드라이버와 노드 이미지 조건이 다르기 때문에, 쓰려는 GPU 종류와 공유 방식이 실제로 지원되는지 먼저 점검해야 한다. 지원 목록에 없는 조합이면 드라이버 로드맵을 확인하고 전환 시점을 다시 결정해야 한다. MSAP.ai는 이 조건들을 한 화면에서 점검하고 GPU 배정과 반환을 정책으로 관리하는 자리를 제공한다.
| 플랫폼 | 최소 버전 | 드라이버·장치 조건 | 확인해야 할 제약 |
|---|---|---|---|
| GKE | DRA 정식 지원 | NVIDIA GPU, Google TPU용 DRA 드라이버 | TPU 드라이버는 커뮤니티 기증 경로 |
| Amazon EKS | 1.34 이상 | NVIDIA GPU, AWS Neuron은 노드 AMI 1.34.2 이상 | P6e-GB200 UltraServer는 DRA 필수 |
| AKS | 1.34 이상 | NVIDIA DRA 드라이버 25.8.1, A10 vGPU 분할 VM | GRID 드라이버 노드는 IMEX 기능을 꺼야 한다 |
| OpenShift | 4.21 | DRA GA, NVIDIA DRA 드라이버 | 별도 제약 기재 없음 |
| NIM Operator | 1.34 이상 | 전체 GPU와 MIG | 기술 프리뷰, 공유는 Time-slicing만 |
| Cast AI 자동 확장 | 1.34 이상 | EKS·GKE·AKS의 NVIDIA GPU | DRA 경로에서 MIG 미지원 |
이 표는 발표자료 22쪽을 그대로 옮긴 것이고, 도입을 검토한다면 우리 클러스터가 어느 행에 해당하는지부터 결정해야 한다.
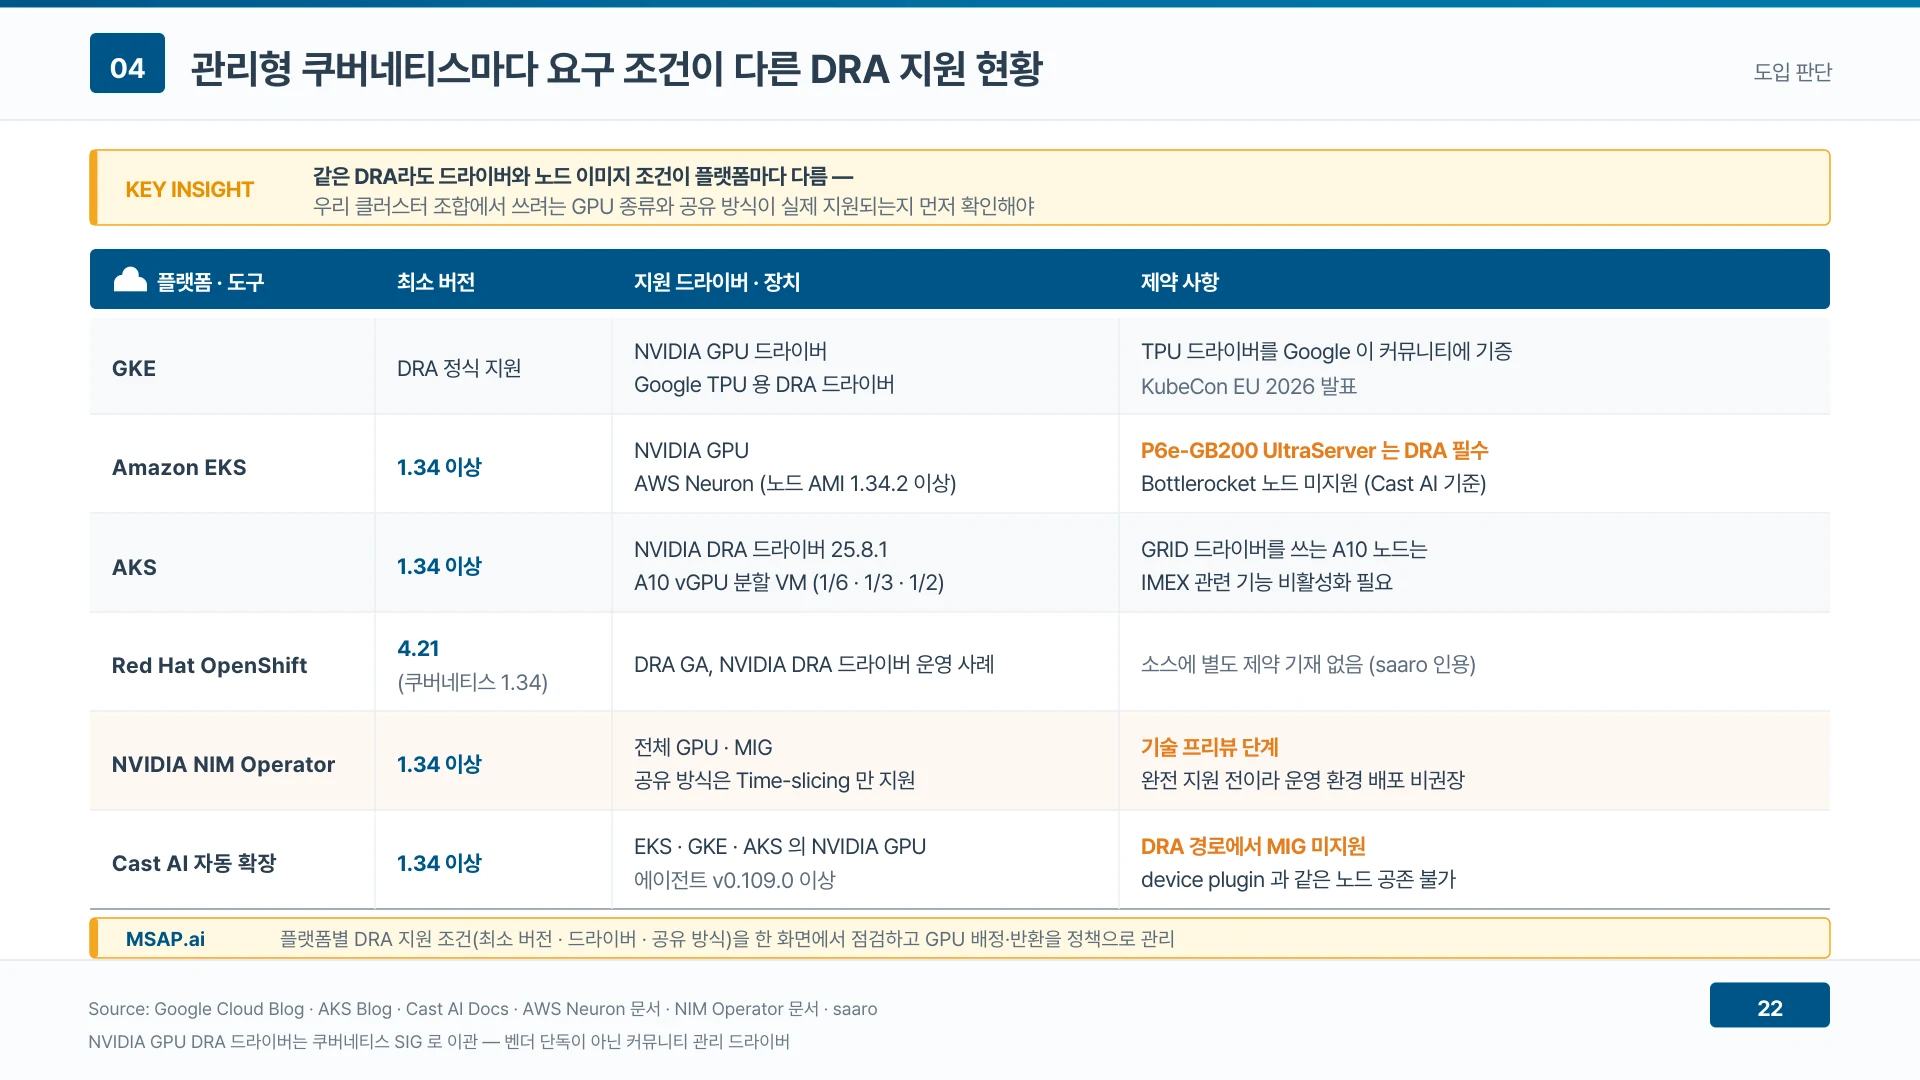
▲ 같은 DRA라도 최소 버전과 드라이버 조건이 플랫폼마다 다르다 (발표자료 22쪽)
device plugin과 DRA는 같은 노드에서 함께 돌 수 없다
기존 클러스터에 DRA를 들일 때 가장 먼저 부딪히는 제약은 공존 문제다. device plugin과 DRA 드라이버는 한 클러스터 안에서는 함께 쓸 수 있지만 같은 노드에서는 함께 돌 수 없다. 한 노드를 두 방식이 동시에 관리하면 같은 GPU가 이중으로 할당될 수 있기 때문이다. 그래서 nvidia.com/gpu.dra 라벨로 노드 풀 경계를 나누고, 기존 플러그인의 nodeAffinity에서 DRA 노드를 제외한다. 전환은 ComputeDomain만 먼저 켜고, 개발 환경과 추론 서비스를 옮긴 뒤, 핵심 학습 작업을 마지막에 옮기는 순서를 권한다. 각 단계에서 기존 플러그인 노드의 파드가 DRA 노드로 새지 않는지 점검해야 하고, 되돌릴 경로를 미리 준비해야 한다.
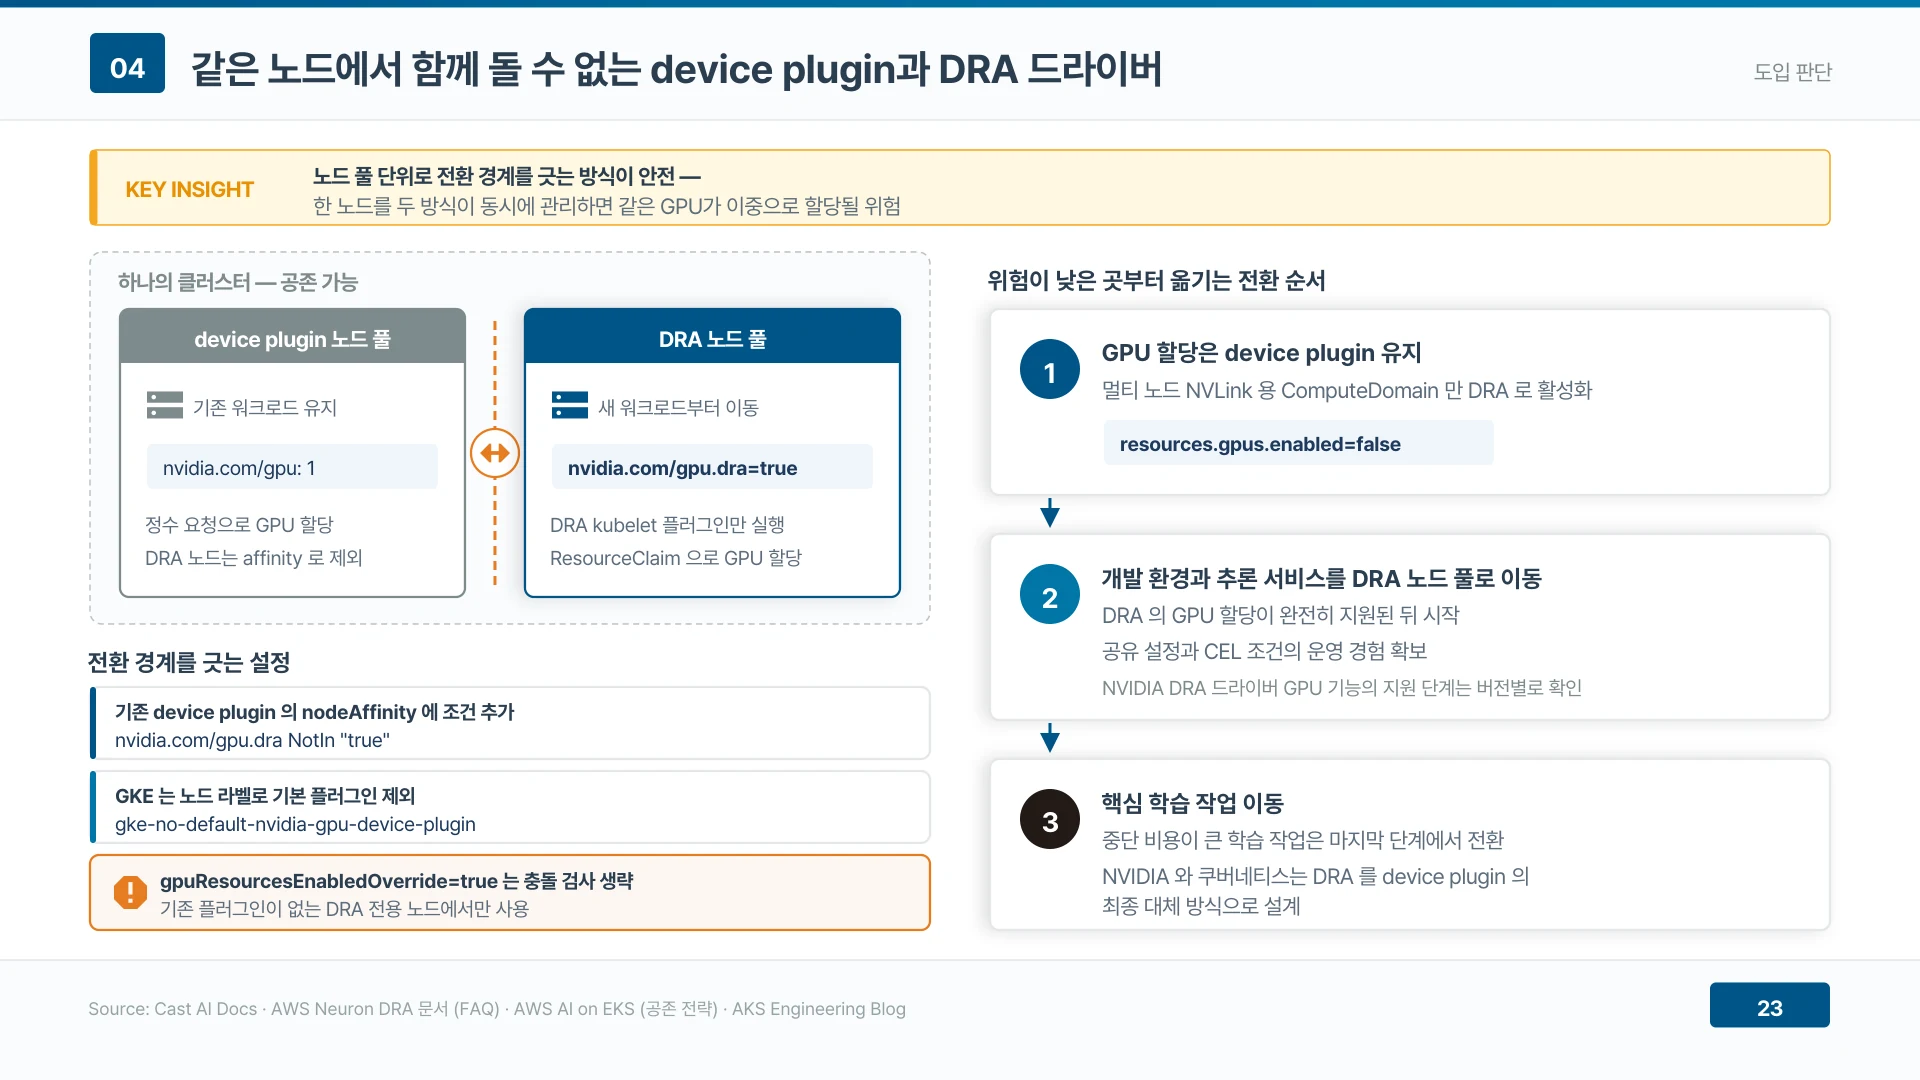
▲ device plugin과 DRA의 경계는 노드 풀 단위로 긋는 것이 안전하다 (발표자료 23쪽)
Pending에 멈추면 ResourceClaim 상태부터 본다
드라이버를 설치했다면 먼저 준비 상태를 확인한다. deviceclasses 조회에서 gpu.nvidia.com이 보이는지, resourceslices가 GPU 노드마다 게시되었는지, 드라이버의 컨트롤러와 kubelet 플러그인 파드가 Running인지 차례로 본다. 그다음 워크로드를 배포하고 ResourceClaim 상태가 allocated,reserved인지 확인한다. 파드가 Pending에 멈췄다면 이 상태를 기준으로 원인이 갈린다. 아직 할당되지 않았다면 요청 조건이나 장치 재고 쪽 문제이고, 할당은 되었는데 대기 중이라면 노드 쪽 장치 준비를 본다. spec.nodeName으로 스케줄러를 우회했는지, Binding Conditions 대기 시간인 기본 600초를 넘겼는지, MPS 복제본이 다른 노드로 흩어졌는지 차례로 점검해야 한다. 세 가지가 모두 아니면 드라이버 로그를 받아 두고 노드 준비 단계부터 다시 봐야 한다.
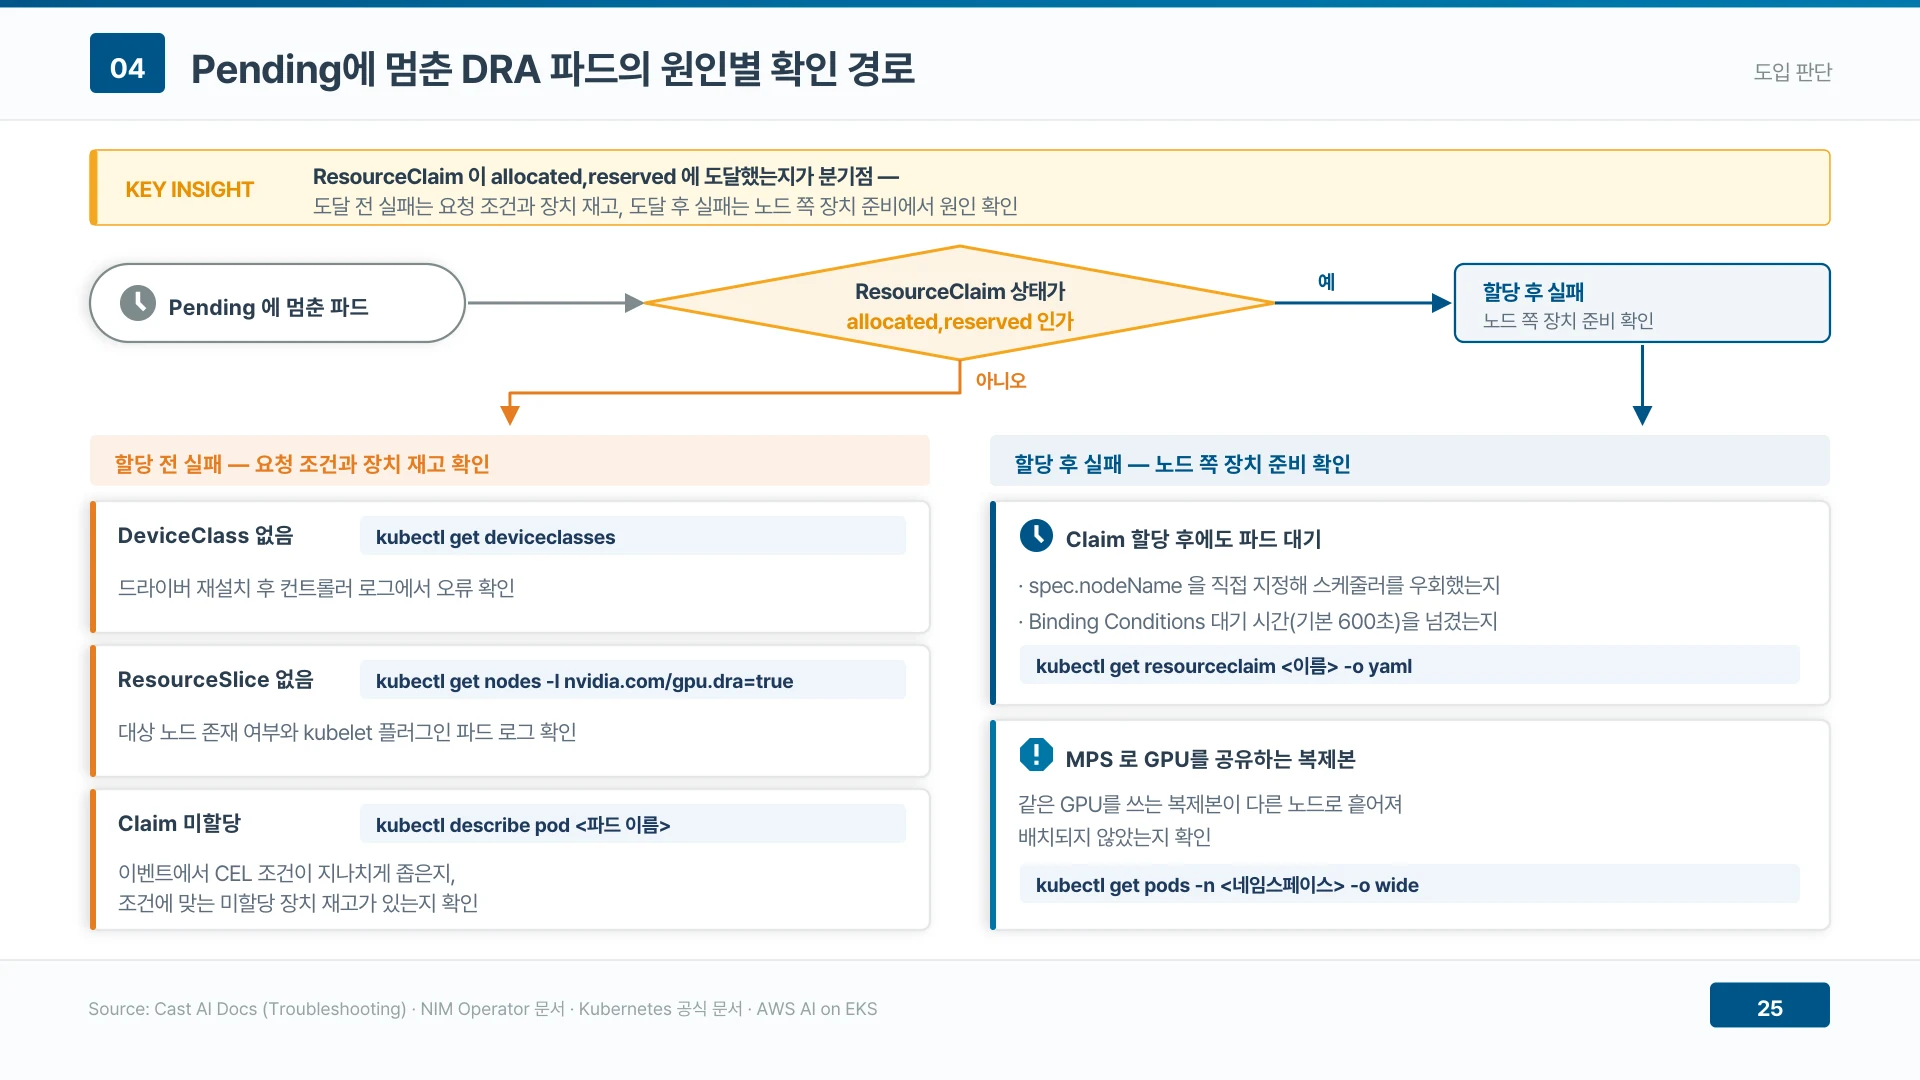
▲ ResourceClaim이 allocated,reserved에 닿았는지가 원인을 가르는 갈림길이다 (발표자료 25쪽)
부록이 답하는 것 — 드라이버는 배정과 준비로 나뉜다
발표자료 5부는 부록이다. DRA 드라이버를 안에서 열어 보면 장치를 누구에게 줄지 정하는 쪽과 노드에서 실제로 꽂아 주는 쪽이 분리되어 있다. 앞은 컨트롤러가, 뒤는 kubelet 플러그인이 맡는다. 그래서 실패도 배정 단계와 준비 단계 두 곳에서 따로 일어나고, 앞에서 본 Pending 진단이 두 갈래로 갈리는 이유가 여기 있다. 파드가 뜨기까지는 여섯 단계를 거친다. 요청은 클레임으로 적히고, 배정은 컨트롤러가, 준비는 kubelet이, 주입은 런타임이 맡으며, 종료할 때는 준비의 역순으로 정리되어 장치가 재고로 돌아간다.
마지막 한 칸은 CDI가 맡는다. 배정이 끝나도 컨테이너가 장치를 보려면 kubelet 플러그인이 쓴 CDI 파일을 런타임이 읽어 기동 설정을 고쳐야 한다. 여기까지 왔는지 확인하려면 컨테이너 안의 값과 노드의 CDI 파일이 같은지 보면 된다. GPU가 없어도 이 흐름은 그대로 따라갈 수 있다. kind 클러스터에 dra-example-driver를 올리면 배정된 장치가 환경 변수로 들어오므로, 요청부터 배정과 준비까지를 손으로 확인한 뒤 실제 GPU 드라이버로 옮겨 가면 된다. 부록에는 alpha 시절 자료를 v1.34 기준으로 읽는 대조표도 넣었다. DRA 자료는 대부분 v1.26 무렵 기준이라 이름과 구조가 지금과 달라서, 옛 블로그 글을 그대로 따라 하다 막히는 일이 흔하기 때문이다.
핵심 정리
GPU를 속성으로 요청하는 방식으로 옮겨 갈 때 정할 것은 세 가지다. 첫째, 클러스터와 노드 이미지가 v1.34 이상인지 확인한다. 둘째, device plugin과 DRA의 경계를 노드 풀 단위로 긋는다. 셋째, 워크로드마다 전용 할당과 Time-slicing과 MPS와 MIG 가운데 어떤 공유 기술을 쓸지 정한다. GPU 할당을 어떻게 할 것인가는 결국 AI 워크로드를 조직이 어디까지 끌고 갈 것인가에 딸린 결정이다. 그 위쪽 그림은 엔터프라이즈 AI란 무엇인가에서 도입 단계별로 정리했다. 세 가지가 정해지면 나머지는 드라이버 설치와 점검 순서의 문제다. 반대로 셋 가운데 하나라도 비어 있으면 도입 시점이 아니라 준비 단계를 먼저 밟아야 한다.
검토를 시작한다면 다음 순서로 30일 안에 결론을 내는 것을 권한다.
- 컨트롤 플레인과 노드 이미지 버전을 조사해 v1.34 기준을 충족하는지 결정해야 한다.
- 관리형 서비스 문서에서 우리 GPU 모델과 공유 방식이 지원 목록에 있는지 점검해야 한다.
- DRA 전용 노드 풀을 하나 만들고 기존 device plugin 노드와 라벨 경계를 그어야 한다.
- 개발 환경 워크로드 하나를 ResourceClaim으로 옮겨 배정부터 반납까지 확인해야 한다.
- 전환 전후를 같은 기준으로 비교할 수 있도록 활용률 수집 항목을 먼저 고정해야 한다.
- 학습 워크로드 전환은 앞의 다섯 단계가 끝난 뒤 60일 차에 착수해야 한다.
전환을 시작했다면 활용률이 실제로 올라갔는지를 같은 자로 다시 재야 한다. 할당 방식만 바꾸고 수집 항목을 그대로 두면 개선이 숫자로 드러나지 않고, 반대로 수집 기준이 바뀌면 나아진 것처럼 보이기도 한다. AI로 끝내는 쿠버네티스 파드 리소스 점검처럼 파드와 노드 단위의 자원 점검 경로를 먼저 정해 두면 DRA 전환 전후를 같은 기준으로 비교할 수 있고, 전환 근거를 숫자로 남길 수 있다.
자주 묻는 질문
DRA는 device plugin과 무엇이 다른가
device plugin은 장치를 개수로만 세고 스케줄러에 속성을 알리지 않는다. DRA는 드라이버가 ResourceSlice로 장치 속성을 API에 게시하고, 스케줄러가 그 속성을 직접 읽어 배치를 결정한다. 그래서 메모리 하한이나 MIG 프로파일 같은 조건을 요청에 적을 수 있고, 할당 결과가 ResourceClaim에 남아 추적이 된다.
ResourceClaim과 ResourceClaimTemplate은 언제 갈라 쓰는가
여러 파드가 장치 하나를 함께 써야 하면 resourceClaimName으로 ResourceClaim을 직접 참조한다. 복제본마다 전용 장치가 필요하면 resourceClaimTemplateName으로 템플릿을 참조한다. 추론 서비스처럼 한 GPU를 나눠 쓰는 경우는 전자, 분산 학습처럼 복제본마다 GPU가 필요한 경우는 후자가 맞다. 두 방식 모두 Claim이 파드와 같은 네임스페이스에 있어야 한다.
DRA를 쓰려면 쿠버네티스 버전이 얼마여야 하는가
DRA는 v1.34에서 GA가 되고 기본 활성화되었다. EKS와 AKS와 Cast AI는 모두 1.34 이상을 요구하고, AWS Neuron은 노드 AMI 1.34.2 이상이 필요하며, OpenShift는 4.21에서 GA로 올렸다. 컨트롤 플레인만이 아니라 노드 이미지 버전까지 함께 확인해야 한다.
Time-slicing과 MPS와 MIG 가운데 무엇을 골라야 하는가
처리량을 높일수록 작업 사이 보호 수준이 낮아진다는 점이 선택 기준이다. 장애 격리가 필요한 운영 워크로드는 MIG, 병렬 실행과 메모리 분리가 필요한 추론은 MPS, 격리보다 밀도가 중요한 개발 환경은 Time-slicing이 맞다. Time-slicing은 메모리 격리가 없어 한 작업의 메모리 고갈이 같은 장치의 다른 작업까지 멈추게 할 수 있다.
기존 device plugin 클러스터와 섞어 쓸 수 있는가
한 클러스터 안에서는 함께 쓸 수 있지만 같은 노드에서는 안 된다. 같은 GPU가 이중으로 할당될 수 있기 때문이다. nvidia.com/gpu.dra 라벨로 노드 풀 경계를 긋고 기존 플러그인의 nodeAffinity에서 DRA 노드를 제외하는 방식이 안전하다.
DRA 파드가 Pending에 멈추면 어디부터 보는가
ResourceClaim 상태가 갈림길이다. allocated,reserved에 도달하지 못했다면 DeviceClass나 ResourceSlice가 없는지, CEL 조건이 지나치게 좁지 않은지 본다. 할당은 되었는데 파드가 대기 중이라면 spec.nodeName 직접 지정, Binding Conditions 기본 600초 초과, MPS 복제본의 노드 분산을 차례로 확인한다.
GPU가 없어도 DRA를 미리 익힐 수 있는가
있다. 부록에서 다루는 dra-example-driver는 배정된 장치를 환경 변수로 넣어 주므로, kind 클러스터와 예제 드라이버만으로 요청부터 배정과 준비까지의 흐름을 손으로 확인할 수 있다. 개념을 확인한 뒤 실제 GPU용 드라이버로 옮겨 가는 순서가 가장 빠르다.
참고 리소스
GPU 자원 운영과 쿠버네티스 플랫폼을 더 깊이 볼 때 함께 읽을 자료다.
- 엔터프라이즈 AI란 무엇인가 — AI 에이전트 시대의 도입 기준
- LLM 도입이 실패하는 이유는 GPU가 부족해서가 아니다
- CNCF가 검증한 Certified Kubernetes 플랫폼
- AI LLM 가속 엔진 vLLM — GPU 병목과 도입 비용 줄이기
- 프라이빗 sLLM Qwen 3.6 27B — 데이터 주권과 TCO를 함께
- 쿠버네티스 관측성, OpenTelemetry, 분산 추적
- 코드 수정 없이 쿠버네티스 운영 상태 진단
- AI로 쿠버네티스 노드 상태 확인하는 방법
- 재실행된 파드, AI로 OOM과 보안과 베스트 프랙티스 한 번에 분석
- LLM 기반 AIOPS — 장애 대응을 바꾸는 7가지 기능과 도입 기준
- Docker Compose & Swarm 완벽 정리 — 컨테이너부터 클러스터까지
- 가상화에서 클라우드 네이티브로 — 전환 실행법과 비용 효과
- 클라우드 네이티브 도입 효과와 공공·AI 인프라 사례
- GSLB 기반 Active-Active DR 구축 개념과 방안
- 공공기관 AI, 왜 온프레미스여야 하는가
- 쿠버네티스 AI 워크로드 운영 가이드
- AI로 끝내는 쿠버네티스 파드 리소스 점검