TL;DR — AI 장애 원인 분석은 운영자가 자연어로 묻기만 하면 APM 지표와 트랜잭션 추적을 모아 원인을 짚고, 무엇을 할지까지 돌려주는 방식입니다. 이 영상은 외부 서비스 지연, 외부 API 에러, DB 지연, T-Map 패턴 감지, 느린 쿼리 진단을 실제 운영 환경 녹화로 보여 주며, 알람에서 멈추지 않고 원인과 조치까지 간다는 점을 확인합니다.
프로덕션 운영 환경에서 장애 담당자가 알람을 받고 로그와 지표를 하나씩 뒤지는 데 시간을 쓰고 있다면, 왜 그 과정이 느린지와 어떻게 AI 장애 원인 분석으로 줄일 수 있는지를 도입 전에 확인해 둘 만합니다. 이 글은 클라우드네이티브TV가 올린 영상 ‘AI가 장애 원인까지 짚는다 — LLM AIOps ② 실전 데모'(약 32분)를 장면 아홉 개로 나눠, 영상을 보지 않은 독자도 어떤 질문을 하면 어떤 답과 조치가 돌아오는지 따라가도록 정리했습니다. 앞 편이 AIOps의 필요성과 LLM이 더하는 기능을 개념으로 다뤘다면, 이번 편은 전부 데모입니다. 영상 속 화면은 모두 실제 운영 환경에서 녹화한 것이고, 눈여겨볼 대목은 하나입니다. 알람이 울리는 데서 멈추는지, 원인을 짚고 무엇을 하라는 데까지 가는지입니다.
영상으로 먼저 보기: 알람에서 멈추지 않는 AI 운영 데모
영상은 네 개 구간으로 나뉩니다. 첫 구간은 외부 서비스 지연, 외부 API 에러, DB 지연이라는 세 가지 장애 시나리오이고, 둘째 구간은 T-Map 장애 패턴 감지, 셋째 구간은 APM 연계 활용, 마지막 구간은 느린 쿼리 진단입니다. 전체를 관통하는 초점은 알람에서 멈추지 않고 원인과 조치까지 간다는 것 하나입니다. 네 구간 모두 AI 장애 원인 분석이 같은 방식으로 작동하는지를 확인하는 순서입니다.
영상에서 다루는 순서는 다음과 같습니다.
이 영상이 답하는 9가지 질문 정리
영상의 설명을 질문으로 바꾸면 아홉 가지입니다. AI 장애 원인 분석을 처음 접하는 담당자도 이 목록만 보면 영상의 흐름을 알 수 있습니다. 아래 아홉 개 절이 이 순서대로 답합니다.
- 외부 서비스가 느려지면 AI는 무엇부터 모으는가?
- 네 번의 질문만으로 탐지에서 조치까지 갈 수 있는 이유는?
- 외부 API 에러는 정상인 것을 지워 가며 어떻게 좁히는가?
- DB 지연에서 증상은 서비스 전체에 퍼지는데 원인은 어디에 있는가?
- T-Map은 표를 훑지 않고 어떻게 장애 유형을 먼저 짚는가?
- 히트맵에서 시작한 진단은 어떻게 쿼리와 인덱스까지 가는가?
- AI가 내놓은 답이 맞는지는 어떻게 증명하는가?
- 에러가 아닌 느린 응답은 사용자 활동 추적으로 어떻게 드러나는가?
- 느린 쿼리 진단은 해석에서 멈추지 않고 어떻게 수정 제안까지 가는가?
외부 서비스 지연: 질문 한 줄로 지표가 모이는 방식
첫 사례는 외부 서비스 지연에 따른 장애입니다. 이 서비스는 APM(애플리케이션 성능 모니터링) 환경에 LLM 기반 AIOps를 결합해, 운영자가 자연어로 장애 원인 분석을 즉시 요청하고 답변을 받도록 설계된 AI 트러블슈팅 서비스입니다. 운영자가 “지금 장애 원인 분석해줘”라고 입력하면 시스템은 TPS, 응답시간, 오류율, Apdex 같은 핵심 지표를 자동으로 분석합니다.
상세 분석 단계에서는 특정 트랜잭션의 처리 시간과 Trace 정보를 제공하고, 외부 API 지연 여부까지 탐지해 병목 지점을 자동으로 식별합니다. 이 과정에서 CogentAI는 MSA 기반 MCP 구조를 활용해 기존 모니터링 데이터와 로그, 외부 연동 시스템 정보를 통합적으로 분석합니다. 사람이 대시보드 여러 개를 오가며 맞춰 보던 일이 질문 한 줄 뒤로 들어가는 셈입니다. 이것이 AI 장애 원인 분석의 첫 단계입니다.
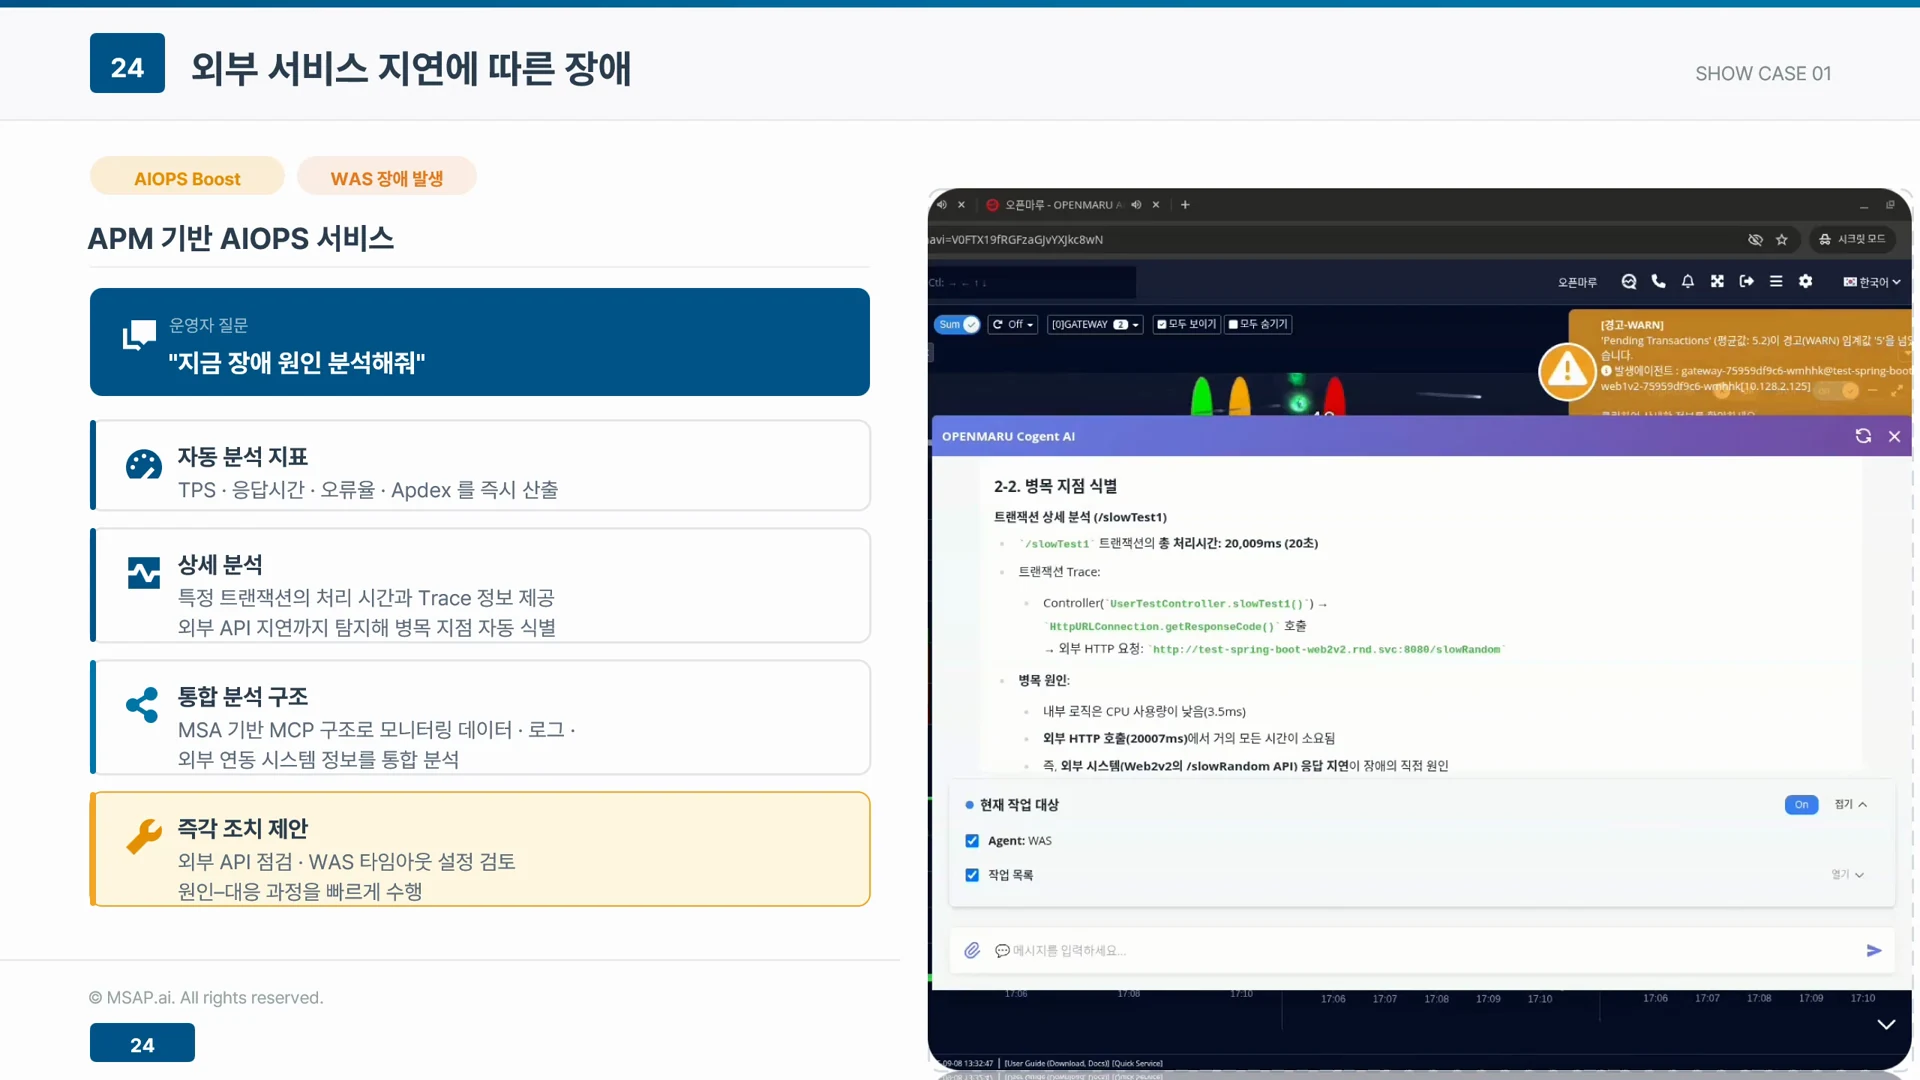
▲ 외부 서비스 지연 사례에서 질문 한 줄로 시작하는 분석 (영상 7:40)
화면 왼쪽에는 분석 흐름이, 오른쪽에는 실제 모니터링 화면이 놓여 있습니다. 영상이 짚는 요지는 질문 한 줄에 흩어져 있던 지표가 자동으로 모이는 지점입니다. 운영자는 지표를 직접 모으는 대신 외부 API 점검이나 WAS 타임아웃 설정 검토 같은 조치를 곧바로 제안받습니다.
이 사례에서 얻을 결론은 분석의 출발점이 도구 조작이 아니라 질문이라는 점입니다. 어떤 대시보드를 열어야 하는지 몰라도 현재 상황을 말로 물으면 되고, 그 질문이 지표 수집과 병목 식별 요청으로 바뀝니다. 장애 상황에서 담당자가 가장 많이 쓰는 시간이 어디를 봐야 할지 정하는 시간이라는 점을 떠올리면, AI 장애 원인 분석이 줄여 주는 구간이 어디인지 분명해집니다.
네 번의 질문으로 탐지에서 조치까지 끝나는 이유
영상은 방금 본 흐름을 네 단계 질문으로 풀어 줍니다. 첫 질문은 “지금 발생한 장애 원인을 분석해줘”입니다. AI는 이를 장애 분석 요청으로 바꾼 뒤 TPS, 응답시간, Apdex를 MCP로 불러옵니다. 답은 특정 구간에서 응답시간이 50밀리초에서 2,800밀리초로 급증했고 Apdex가 떨어졌으며, 외부 API 호출에서 지연이 발생했다는 것입니다.
두 번째 질문은 “응답시간이 왜 이렇게 길어졌는지 알려줘”입니다. AI는 정상 구간과 장애 구간의 성능 패턴을 견주고, 오류율과 TPS, Trace를 함께 분석합니다. 답은 슬로우테스트원 트랜잭션에서 외부 HTTP 호출이 20초 걸려 병목으로 확인되었고, 내부 WAS는 정상 처리했다는 것입니다.
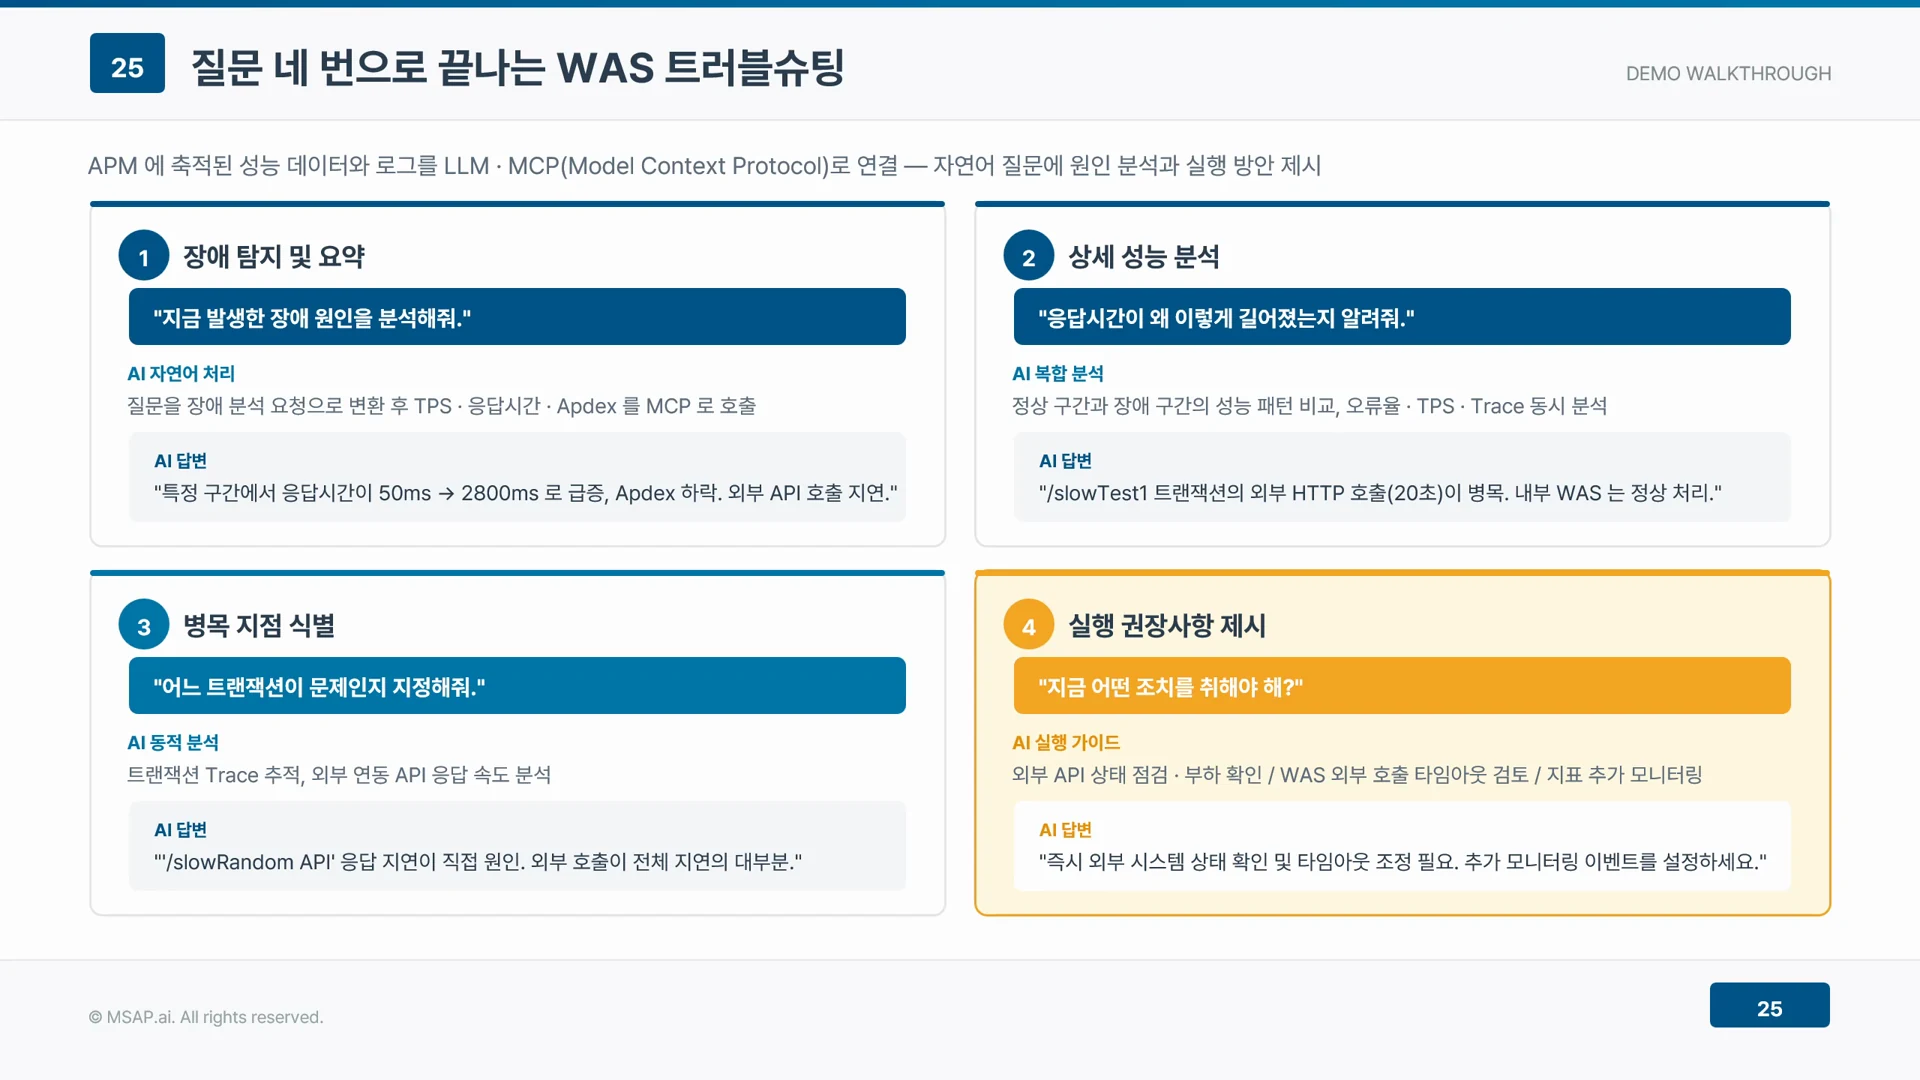
▲ 네 단계 질문으로 탐지부터 조치까지 (영상 9:00)
세 번째 질문은 “어느 트랜잭션이 문제인지 지정해줘”입니다. AI는 트랜잭션 Trace를 따라가며 외부 연동 API의 응답 속도를 분석하고, 슬로우랜덤 API의 응답 지연이 직접적인 원인이며 전체 지연시간의 대부분이 외부 호출에서 생겼다고 답합니다. 네 번째 질문은 “지금 어떤 조치를 취해야 해?”입니다. AI는 외부 API 상태 점검과 부하 확인, WAS의 외부 호출 타임아웃 설정 검토, 외부 연동 로그와 성능 지표 추가 모니터링을 안내합니다.
이 순서에서 눈여겨볼 점은 질문이 현상, 이유, 대상, 조치로 한 칸씩 좁혀 간다는 것입니다. 사람이 장애를 풀어 가는 순서와 같아서, 운영자는 AI의 답을 보고 다음 질문을 자연스럽게 이어 갈 수 있습니다. 영상은 네 번의 질문으로 탐지에서 조치까지 끝났다는 점을 핵심으로 꼽습니다. AI 장애 원인 분석이 알람 확인에서 조치 결정까지의 거리를 줄인다는 뜻입니다. 즉시 외부 시스템 상태를 확인하고 타임아웃을 조정하라는 안내와 추가 모니터링 이벤트를 걸어 두라는 안내가 마지막 답에 함께 들어 있습니다.
외부 API 에러에서 정상 지표를 지워 가며 원인을 좁히는 방식
두 번째 사례는 외부 API 에러에 따른 장애입니다. 운영자가 “에러율이 올라가는데 원인을 분석해줘”라고만 입력하면 시스템이 핵심 지표를 자동으로 분석합니다. 이번 시나리오에서는 WAS 인스턴스의 에러율이 60에서 65퍼센트까지 치솟고 Apdex가 35에서 45로 급락하는 심각한 상황이 감지됩니다.
여기서 중요한 것은 무엇이 정상이었는지입니다. TPS와 평균 응답시간, Heap 사용률은 모두 정상 범위였습니다. 그래서 WAS 자체의 자원 문제가 아니라 외부 API 장애, 구체적으로 HTTP 500으로 원인이 좁혀졌습니다.
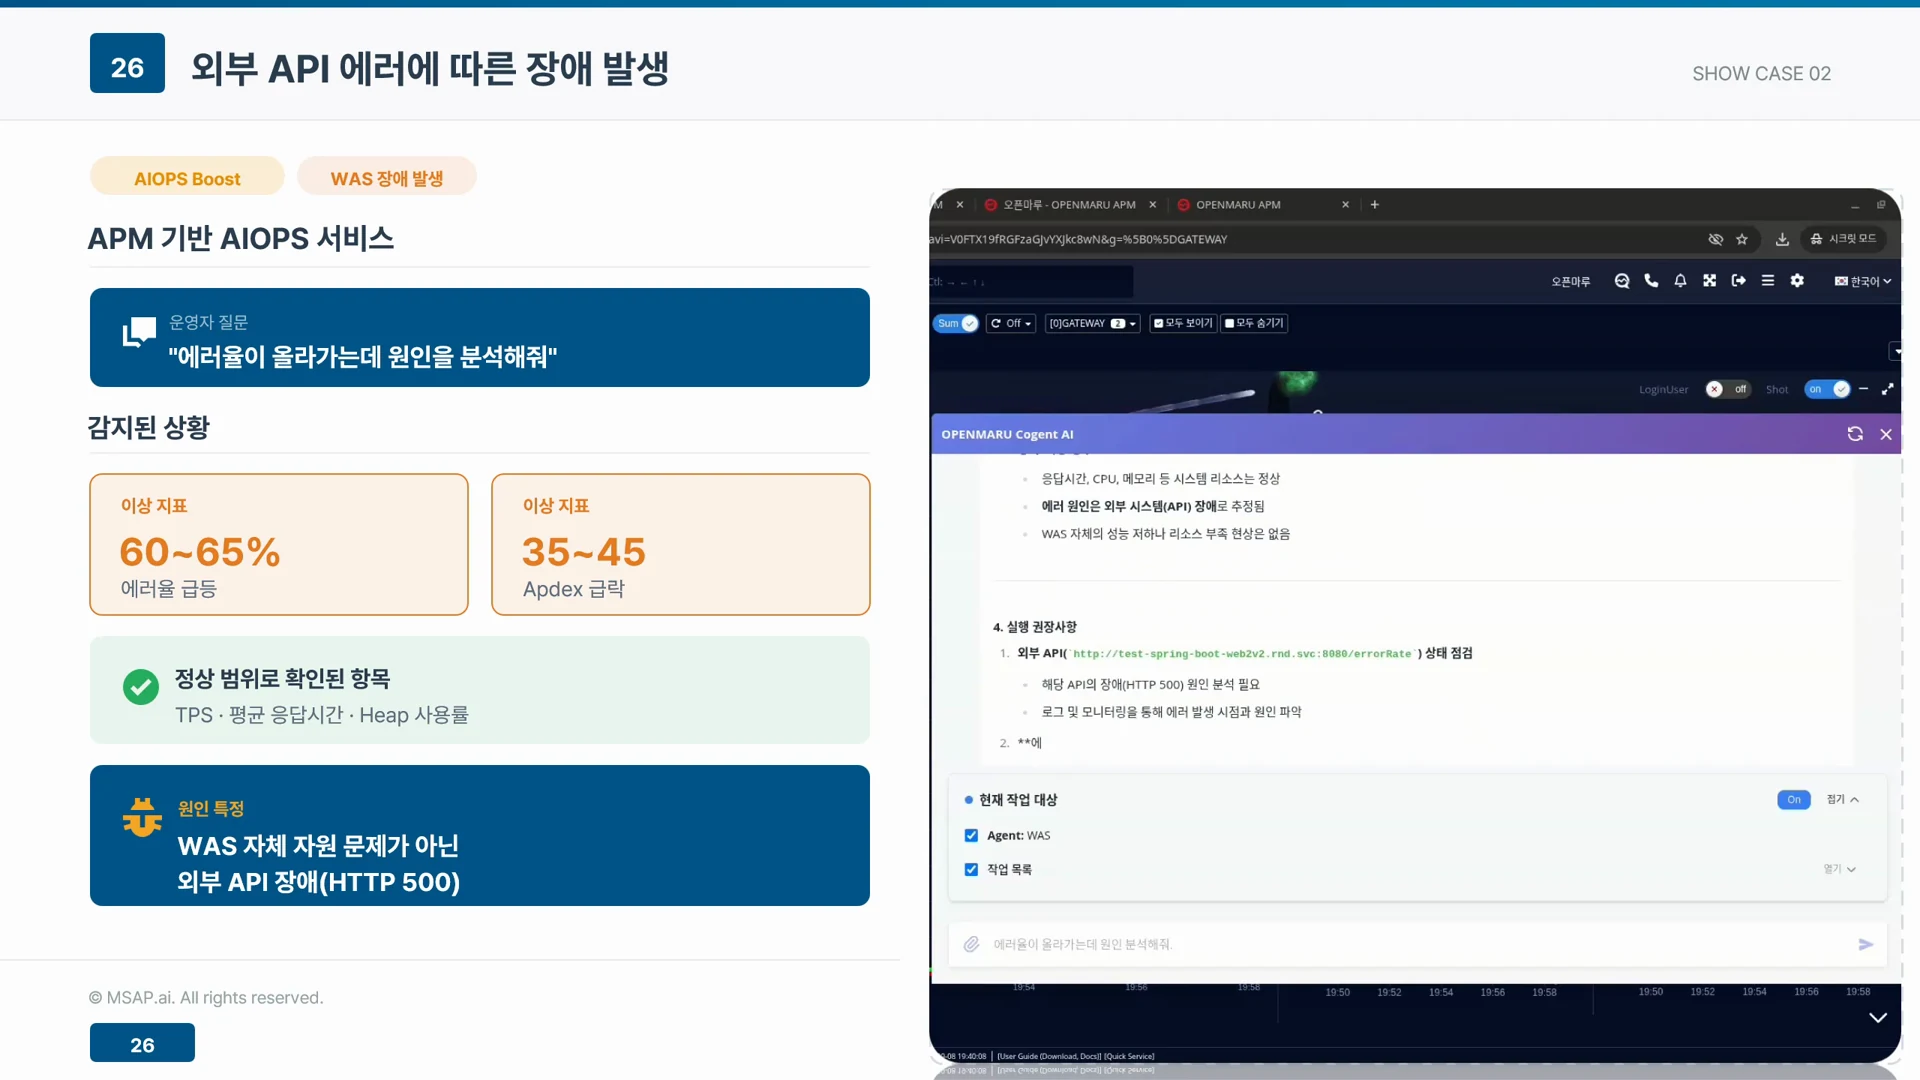
▲ 정상 지표를 하나씩 지워 원인에 도달 (영상 10:40)
화면 왼쪽에는 감지된 상황이 에러율과 Apdex 카드로, 그 아래에는 정상 범위로 확인된 항목이 초록색으로 놓여 있고, 하단 파란 띠가 결론을 적습니다. 영상은 오른쪽 화면에서 정상 지표와 이상 지표를 나란히 대조해 가는 과정을 보라고 말합니다. 이상한 것을 찾는 것이 아니라 정상인 것을 하나씩 지워 나가며 원인에 도달하는 방식이고, 사람이 하던 소거법을 그대로 자동화한 셈입니다.
처리 흐름은 네 단계입니다. 운영자가 에러율이 급격히 올라가는 원인을 묻고, AI가 APM 지표를 모으고 외부 API 호출 상태를 점검하며 에러 유형 통계를 분석합니다. 이어 에러테스트 트랜잭션 호출 중에 생긴 외부 API 오류, HTTP 500으로 원인을 특정하고, 마지막으로 외부 API 점검, 에러 핸들링 로직 강화, 네트워크 상태 추가 점검을 권고합니다. 기존 방식은 단순 알람만 제공해서 운영자가 로그와 지표를 직접 뒤져야 했습니다. 영상은 이 사례의 효과를 데이터 수집, 원인 파악, 자동 분석, 대응 시간의 네 가지로 정리하고, 장애 대응 시간이 10분의 1 수준으로 줄어든다고 말합니다. AI 장애 원인 분석의 효과를 가장 직접적으로 보여 주는 대목입니다.
DB 지연에서 커넥션 풀이 마르면 증상이 서비스 전체로 퍼지는 구조
세 번째 사례는 DB 관련 이슈로 인한 장애입니다. 운영자가 “현재 발생하는 지연현상 분석해줘”라고 묻기만 하면 시스템은 핵심 지표를 자동으로 분석합니다. WAS 인스턴스에서 DB 쿼리 처리 지연이 발생했고, JDBC 요청 중 sleep 함수가 들어간 쿼리가 실행되면서 평균 응답시간이 500밀리초에서 2,300밀리초까지 올랐습니다. HikariCP에서 커넥션을 얻는 데 24초 이상 걸렸고, 커넥션 풀이 말라붙은 상태입니다.
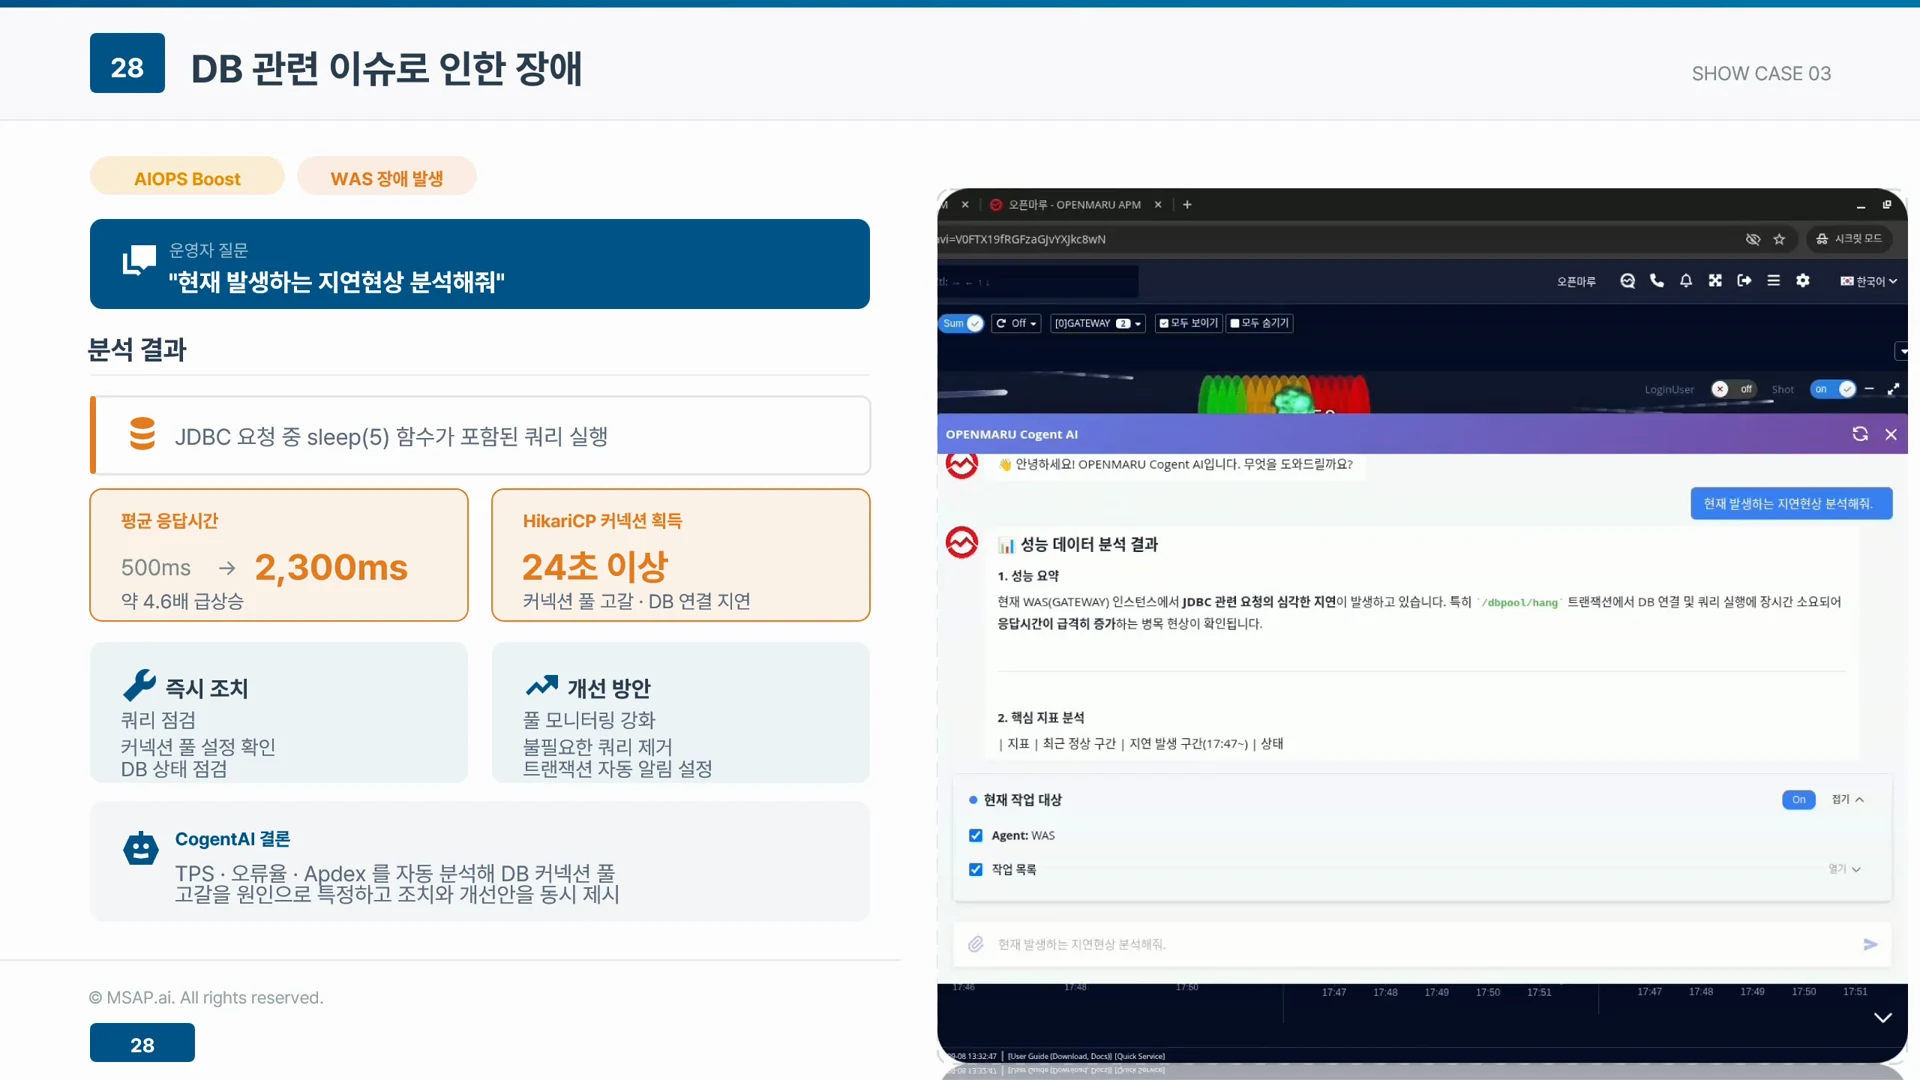
▲ DB 지연에서 커넥션 풀 고갈이 드러난 화면 (영상 14:00)
화면 왼쪽 카드에는 응답시간이 500밀리초에서 2,300밀리초로, 커넥션 획득 시간이 24초 이상으로 표시되고, 그 아래에 즉시 조치와 개선 방안이 나뉘어 있습니다. 영상이 이 대목에서 강조하는 것은 증상의 번지는 모양입니다. 느린 쿼리 하나가 커넥션을 오래 붙들면 뒤따르는 정상 요청까지 순서를 기다리다 함께 느려집니다. 원인은 한 곳인데 증상은 서비스 전체에 퍼지므로, 이것이 DB 장애가 유독 찾기 어려운 이유입니다. AI 장애 원인 분석이 이런 연쇄 증상에서 원인 한 곳을 가려내는 역할을 합니다.
CogentAI는 분석 결과를 바탕으로 즉시 조치와 개선 방안을 나눠서 제시합니다. 즉시 조치는 쿼리 점검, 커넥션 풀 설정 확인, DB 상태 점검이고, 개선 방안은 풀 모니터링 강화, 불필요한 쿼리 제거, 트랜잭션 자동 알림 설정입니다. 지금 당장 할 일과 다음에 할 일을 갈라서 준다는 점이 실무에서 특히 쓸모 있습니다. DB 장애 사례도 질문 흐름은 같습니다. 지연 현상 분석, DB 쿼리 때문인지 확인, 지금 바로 조치할 방법의 세 질문이 자연어 처리, 성능 데이터 수집, APM 분석, 병목 구간 식별 순서로 처리됩니다.
세 사례를 한 표로 놓고 보면 장애 유형이 달라도 다루는 방식이 하나라는 영상의 요점이 분명해집니다. 표는 AI 장애 원인 분석의 공통 흐름을 사례별로 비교한 것입니다.
| 사례 | 운영자의 질문 | AI가 좁힌 원인 | 제안된 조치 |
|---|---|---|---|
| 외부 서비스 지연 | 지금 장애 원인 분석해줘 | 외부 HTTP 호출 20초 지연 | 외부 API 점검, WAS 타임아웃 검토 |
| 외부 API 에러 | 에러율이 올라가는데 원인을 분석해줘 | 정상 지표를 지운 뒤 HTTP 500 | 외부 API 점검, 에러 핸들링 강화 |
| DB 지연 | 현재 발생하는 지연현상 분석해줘 | 커넥션 풀 고갈, 획득 24초 이상 | 쿼리 점검, 풀 설정 확인과 모니터링 강화 |
T-Map이 표를 훑지 않고 장애 유형을 먼저 짚는 방식
두 번째 구간은 T-Map 장애 패턴 감지입니다. 앞의 세 사례는 운영자가 무엇을 물어야 할지 이미 아는 경우였고, 이번에는 그 앞 단계입니다. 무엇이 잘못되고 있는지조차 모를 때 어디를 봐야 하는지를 시스템이 먼저 짚어 줍니다. AI 장애 원인 분석이 질문 이전 단계까지 넓어지는 지점입니다.
운영 중에는 수천에서 수만 건의 트랜잭션이 쏟아지는데, 그중 무엇이 어떤 유형으로 잘못되고 있는지를 표로 일일이 찾는 것은 느리고 놓치기 쉽습니다. 특히 쿼리 타임아웃 같은 장애는 징후가 여러 트랜잭션에 흩어져 눈에 잘 들어오지 않습니다. T-Map은 모든 트랜잭션을 시간과 응답시간 평면에 그린 히트맵이고, 장애 유형마다 고유한 시각 패턴이 나타나 원인의 방향을 즉시 좁혀 줍니다. 그 모양만으로 16종 패턴을 자동으로 분류하는데, 세로줄, 느린 응답, 파도치기, 단계적 성능 저하, 연쇄 장애 같은 것들이 있습니다. 타임아웃 특유의 패턴은 느린 SQL과 외부 호출 진단까지 자동으로 이어 줍니다.
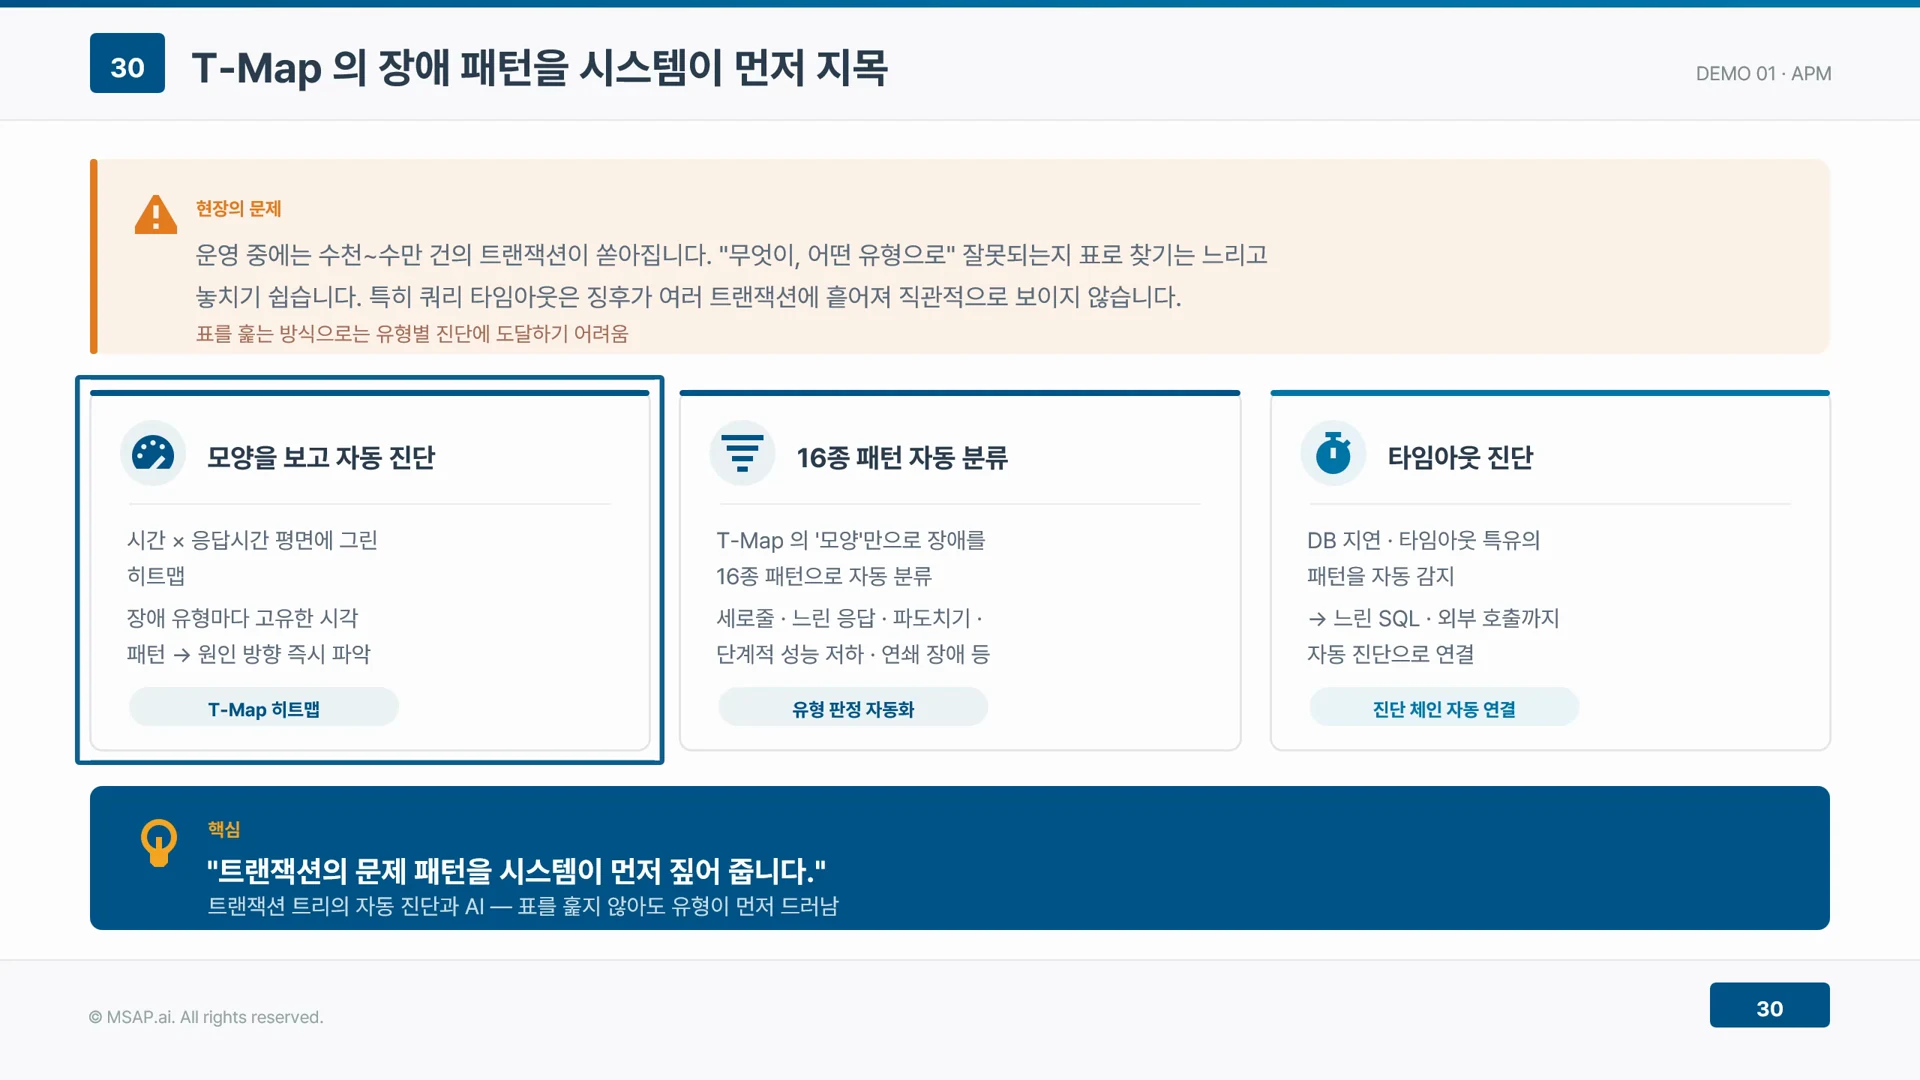
▲ 모양·16종 분류·타임아웃 진단, T-Map의 세 가지 역할 (영상 18:40)
실제 시연 화면의 격자가 T-Map입니다. 가로가 시간, 세로가 응답시간이고 점 하나가 트랜잭션 하나이며, 평소에는 아래쪽에 고르게 깔립니다. 특정 순간에 점들이 위아래로 한꺼번에 퍼지면 시스템이 곧바로 위험 패턴 감지를 띄우고, 추세는 세로줄과 5xx 군집으로 잡힙니다. 세로줄은 메모리 정리가 멈췄거나 데이터베이스 락이 걸렸을 때, 5xx 군집은 서버 오류가 몰릴 때 나오는 모양입니다.
표를 훑어서 찾아낸 것이 아니라 모양만 보고 유형이 먼저 나왔다는 점이 이 데모의 요지입니다. 이 방식은 AI 장애 원인 분석의 입구를 사람의 질문에서 시스템의 감지로 옮깁니다. 이어 운영자가 이 차트를 그대로 CogentAI에게 넘기고 히트맵의 패턴을 분석해 달라고 묻습니다. 화면 오른쪽에서 AI가 대상 인스턴스를 스스로 집어내는 것이 보입니다.
히트맵에서 출발한 진단이 쿼리와 인덱스까지 이어지는 과정
진단이 모양에서 끝나지 않고 트랜잭션 안쪽으로 파고드는 것이 이 데모의 핵심입니다. 해당 트랜잭션을 열면 DB 연결 실패가 확정으로 표시됩니다. MariaDB 드라이버에서 커넥션이 끊어졌고, 쿼리는 제한 시간을 넘겨 중단되었습니다.
그 아래 느린 SQL을 보면 사용자 테이블을 통째로 읽는 조회 한 건이 5.01초를 썼습니다. 전체 처리 시간에서 SQL이 차지하는 비율이 96.4퍼센트이고, CPU 시간은 189밀리초, 외부 호출은 0입니다. 이 트랜잭션이 느린 이유는 사실상 이 쿼리 하나였습니다.
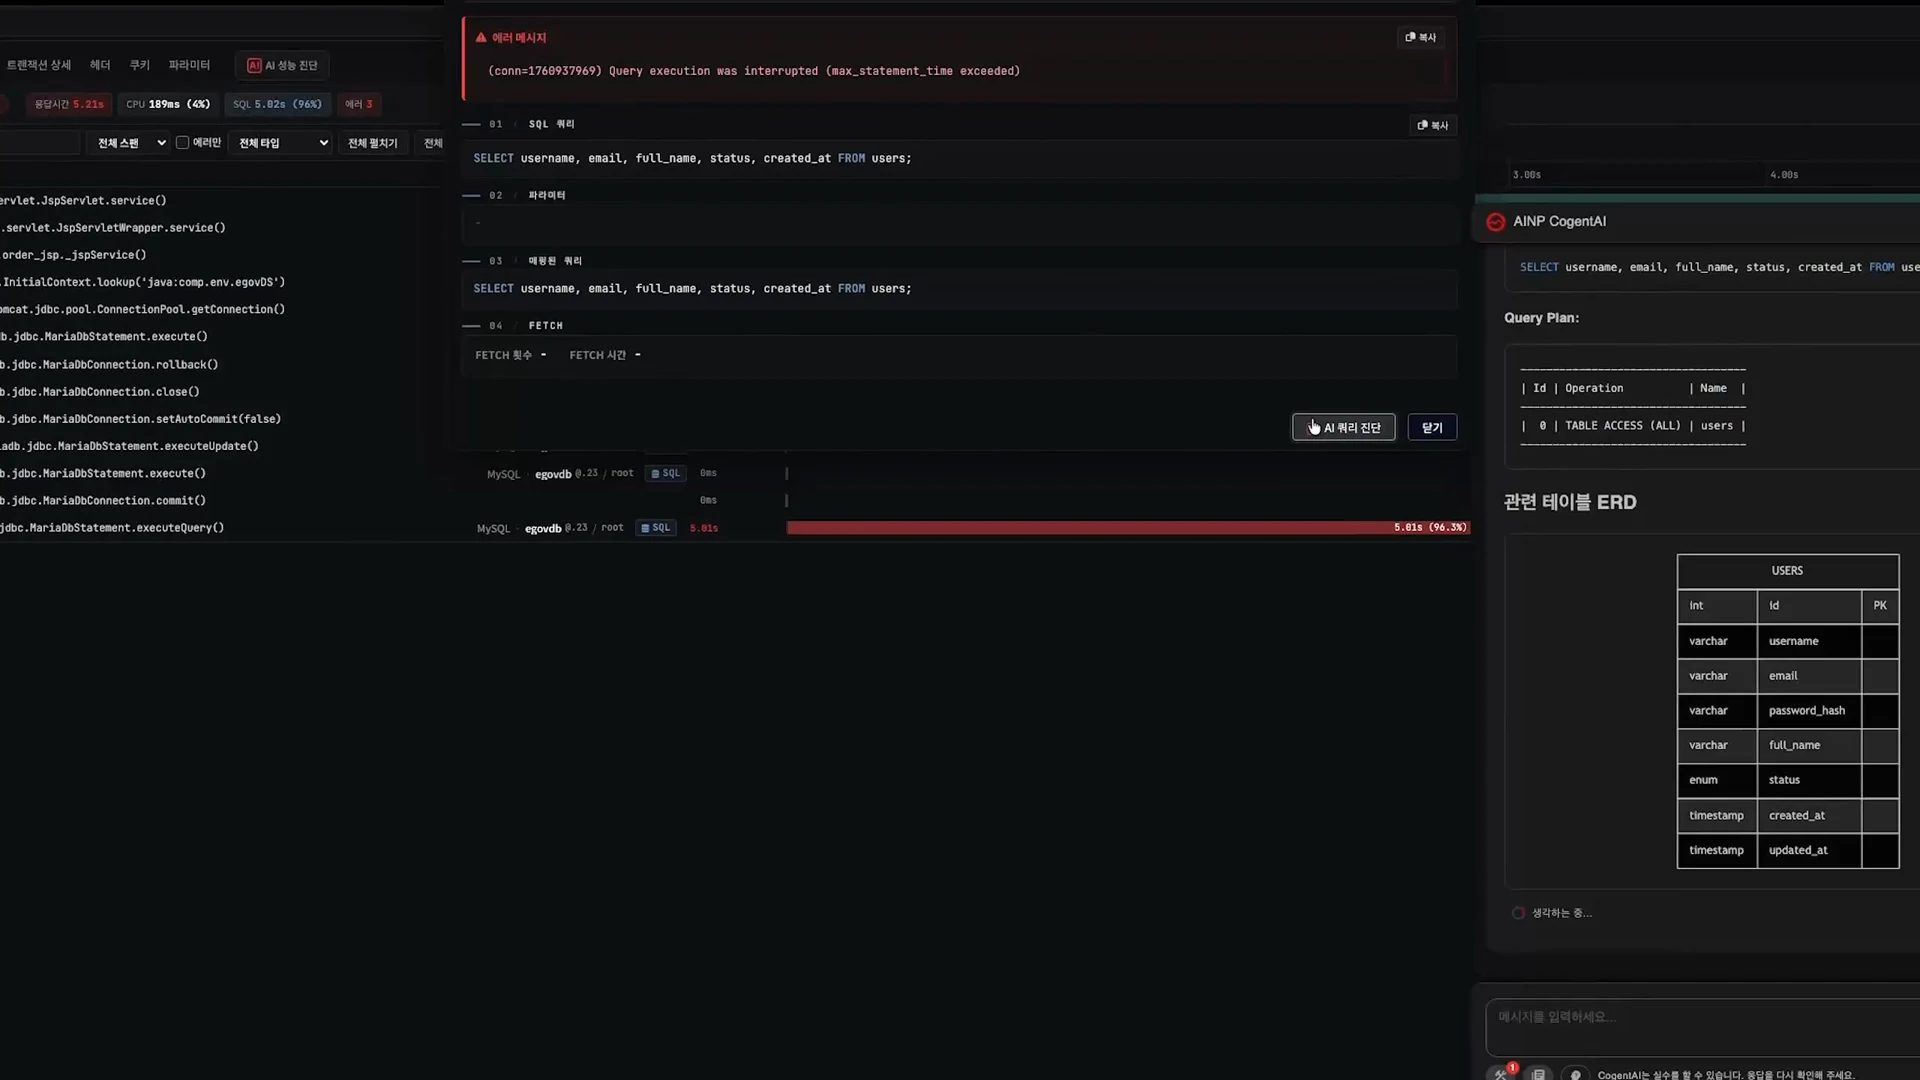
▲ 느린 SQL에서 인덱스 권장까지 이어지는 진단 (영상 21:00)
마지막으로 그 쿼리를 다시 AI에게 넘기면 답이 진단에서 멈추지 않습니다. 필터 조건을 붙여 읽는 행을 줄이고, 페이징으로 한 번에 가져오는 양을 제한하고, 읽기 전용 복제본과 결과 캐싱을 쓰라는 순서로 정리해 줍니다. 인덱스 권장 사항도 함께 나옵니다. 사용자 테이블에 인덱스가 여섯 개나 있는데 이 쿼리에서는 하나도 쓰이지 않았다는 사실까지 짚어 줍니다.
그래서 히트맵의 모양에서 시작해 고쳐야 할 쿼리와 만들어야 할 인덱스까지 한 화면 안에서 이어졌다는 것이 영상의 정리입니다. AI 장애 원인 분석의 결과가 실제 수정 작업으로 이어지는 장면입니다. 담당자 입장에서는 장애 유형 감지, 원인 트랜잭션 확인, 느린 SQL 지목, 수정 방향 제안이 서로 다른 도구를 오가지 않고 하나의 흐름으로 묶인다는 점이 가치입니다.
AI의 답이 맞는지를 트랜잭션 추적의 실측으로 증명하는 방식
세 번째 구간은 평소 운영에서 쓰는 APM 연계 활용입니다. 첫 번째 데모는 지연 트랜잭션의 원인 분석인데, AI가 내놓은 답을 그대로 두지 않고 실측으로 되짚어 증명한다는 점이 특징입니다.
먼저 APM 대시보드에서 order3 노드에 지연 트랜잭션이 잡히고, 이 시점 TPS는 9.0, 활성 사용자는 68명입니다. 운영자가 homepage 애플리케이션 그룹에 문제가 없는지 현재 상황을 분석해 달라고 묻습니다. AI의 원인 분석은 주문 통계 API가 6초 이상 걸리는데 그중 JDBC 실행 시간이 6,651밀리초이고, 지연의 거의 전부가 데이터베이스 구간이라는 것입니다.
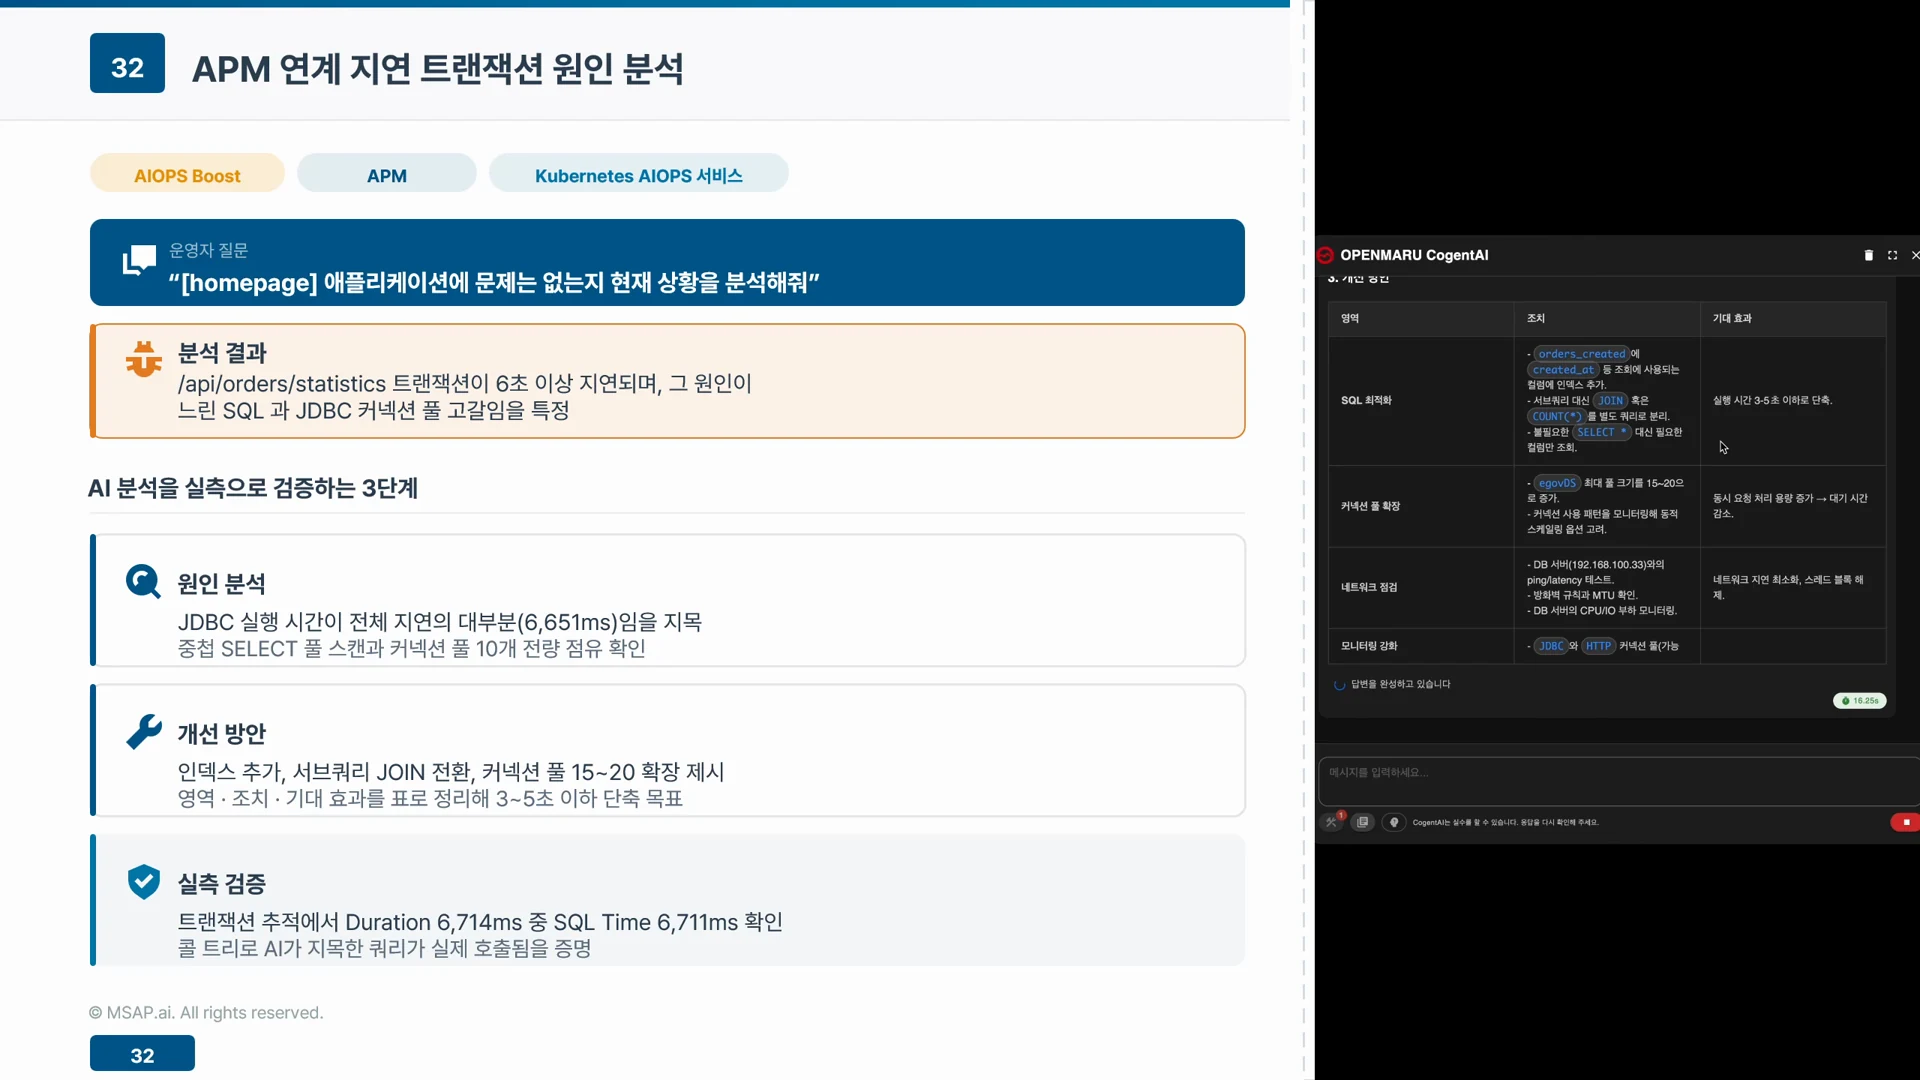
▲ AI 답을 실측으로 되짚어 증명하는 구간 (영상 23:45)
원인은 세 가지로 정리됩니다. 인덱스를 타지 않는 중첩 조회의 풀 스캔, 커넥션 풀 열 개를 전부 점유해 생긴 대기, 외부 데이터베이스 연결 구간의 지연입니다. CPU와 메모리는 정상이라는 점도 함께 짚습니다. 개선 방안은 표로 나옵니다. 인덱스를 추가하고 서브쿼리를 조인으로 바꿔 실행 시간을 3~5초 이하로 줄이고, 커넥션 풀을 15에서 20으로 넓히라는 제안입니다.
마지막 실측 검증이 이 데모의 차별점입니다. 트랜잭션 추적에서 전체 6,714밀리초 가운데 SQL 시간이 6,711밀리초임을 확인하고, 콜 트리를 열어 AI가 지목했던 그 쿼리가 실제로 호출되고 있음을 보여 줍니다. AI가 그럴듯한 답만 내놓는 것 아니냐는 의심에 대한 답이 이 장면입니다. AI 장애 원인 분석을 운영에 쓰려면 이 검증 단계가 반드시 있어야 합니다. 운영 도입을 검토하는 담당자라면 AI의 답과 APM의 실측 수치가 같은 화면에서 맞물리는지를 가장 먼저 점검해야 한다는 뜻으로 읽을 수 있습니다.
에러가 아닌 느린 응답을 사용자 활동 추적으로 찾는 이유
두 번째 APM 데모는 접속 사용자 활동 추적입니다. 운영자가 “지금 접속한 사용자와 활동 내역을 보여줘”라고 요청하면 CogentAI가 APM 세션과 트랜잭션 데이터를 조회해, 사용자가 어떤 화면과 API를 어떤 순서로 불렀는지 정리합니다. 단순히 접속자 수를 나열하지 않고 세 가지를 보여 줍니다. 활동 내역은 세션 아이디와 로그인 시각, 요청 경로를 타임라인으로 제시하고, 성능 진단은 응답 시간과 오류 구간을 함께 표시해 지연 지점을 짚고, 운영 활용은 이상 호출 패턴을 찾아 사용자 기준으로 장애를 재현하도록 돕습니다.
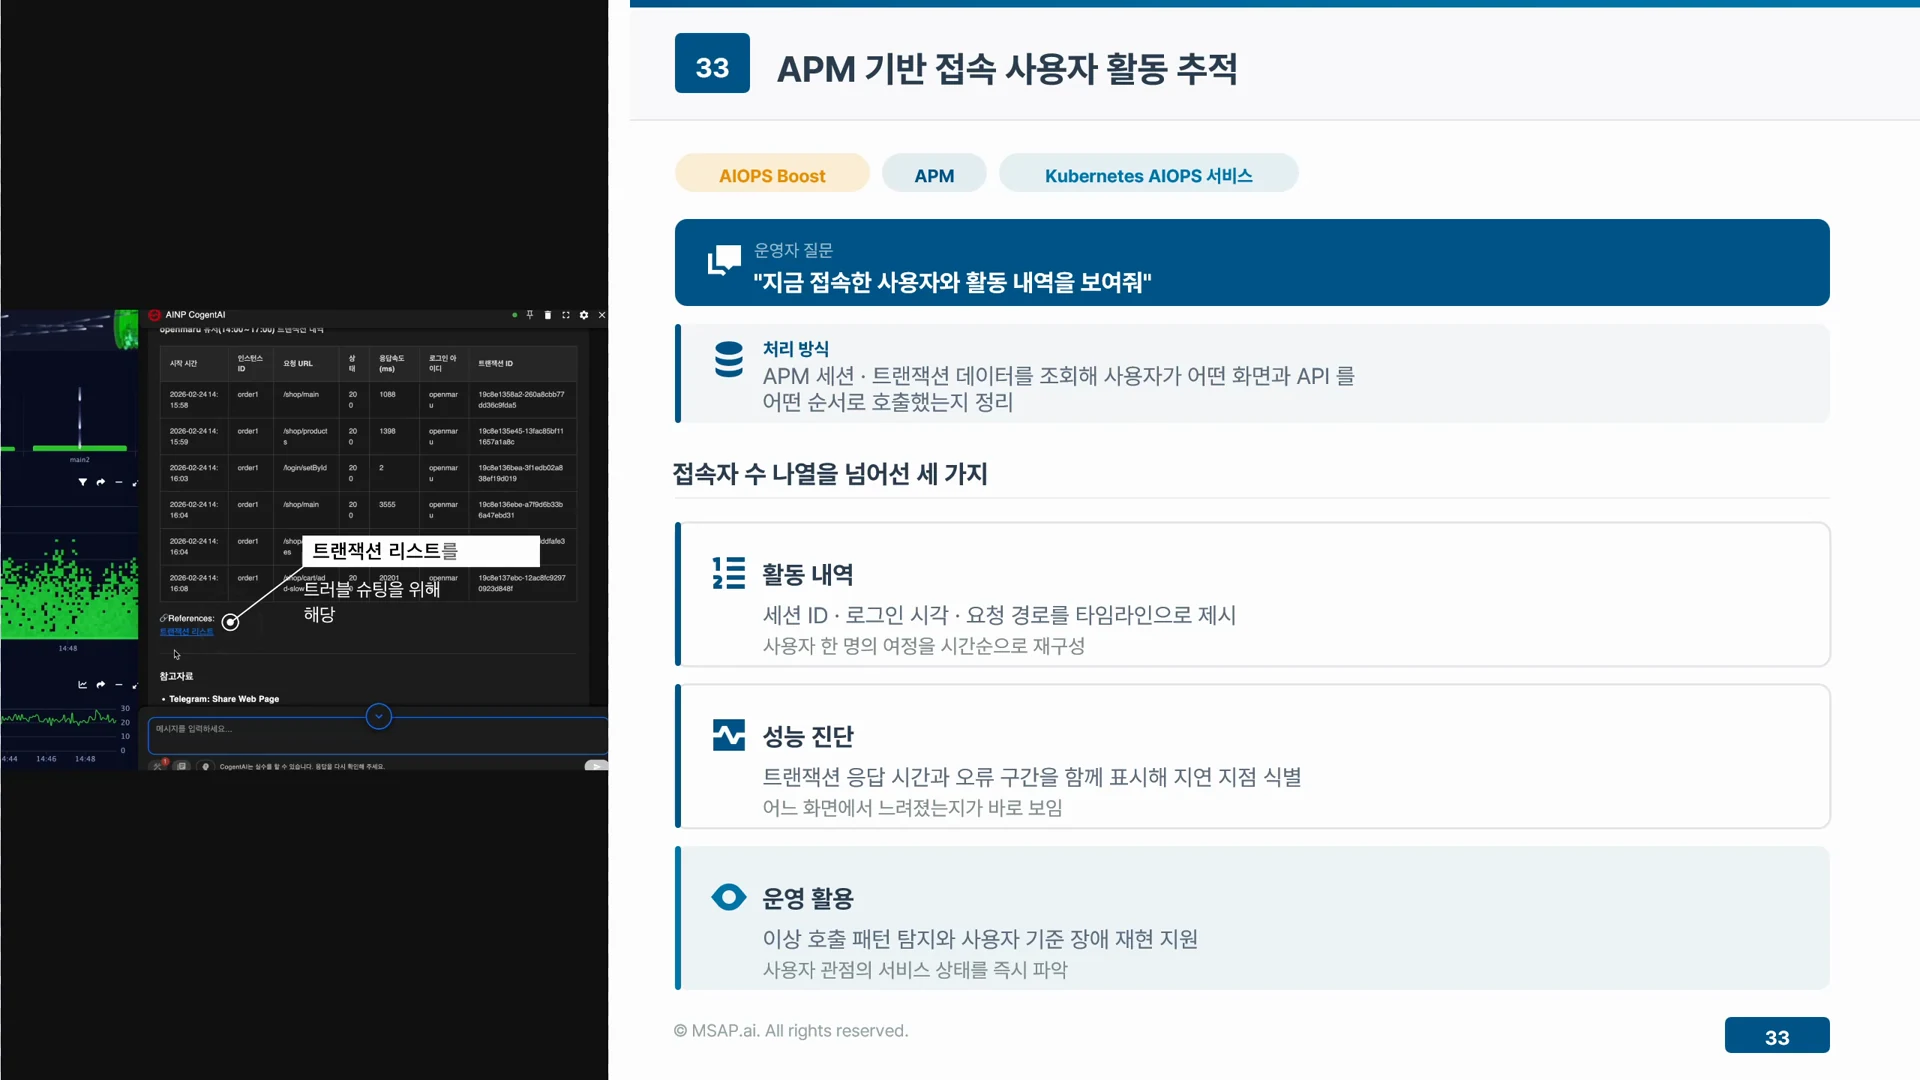
▲ 사용자 한 명의 이동 경로를 시간순으로 세우는 활동 추적 (영상 25:40)
특정 사용자의 세 시간치 이동 경로가 표에 한 줄씩 쌓이고, 열에는 시작 시간, 인스턴스, 요청한 주소, 상태 코드, 응답 속도가 있습니다. 앞선 요청들은 1초에서 3초 사이인데, 장바구니 담기 요청 하나가 20,201밀리초, 즉 20초를 넘깁니다. 상태 코드는 200, 곧 성공입니다.
이 대목이 중요한 이유는 에러가 아니기 때문에 기존 알람 체계로는 걸리지 않는다는 점입니다. 서버 지표만 보면 아무 일도 없지만 그 사용자는 20초를 기다렸습니다. 서버가 괜찮았느냐가 아니라 사용자가 괜찮았느냐를 묻는 순간 안 보이던 문제가 드러납니다. AI 장애 원인 분석이 서버 지표에서 사용자 경험으로 시선을 옮기는 사례입니다.
같은 구간의 마지막 데모는 보고서 자동 생성입니다. 운영자가 “APM 성능 데이터를 정리해 보고서로 만들어줘”라고 요청하면 CogentAI가 응답시간, 처리량, 에러율, 자원 사용률을 취합하고 LLM이 사람이 읽을 보고서로 씁니다. 분석과 요약, 개선 권고(GC 설정, 메모리 사용 패턴, 로그 레벨), 멀티포맷 출력(PDF, HWPX, DOCX)이 포함되며, 요청한 그 자리에서 운영과 경영 보고용 보고서가 완성됩니다. 특히 공공기관이나 금융권처럼 HWPX 형식이 필요한 환경에서 쓸모가 큽니다. AI 장애 원인 분석의 결과를 문서로 남기는 단계까지 포함되는 셈입니다.
느린 쿼리 진단이 해석에서 멈추지 않고 수정 제안까지 가는 방식
마지막 구간은 느린 쿼리 진단과 개선입니다. 느린 쿼리는 장애의 가장 흔한 원인인데 정작 찾아내기는 어렵습니다. 개별 쿼리는 8에서 18밀리초처럼 임계치 미만이라 일반 슬로우 쿼리 감지에는 안 잡히지만, N+1이나 대량 페치로 전체 응답이 느려지는 경우가 많기 때문입니다. 원인을 찾아도 실행 계획 해석과 인덱스 설계는 DBA의 전문 영역이라 개발자가 매번 DBA에게 묻는 병목이 생깁니다.
영상은 MSAP.ai가 이 문제를 세 가지로 푼다고 설명합니다. 첫째는 자동 진단으로, 트랜잭션을 여는 즉시 느린 SQL 상위 항목을 100밀리초 초과 정렬과 비율로 상단에 보여 주고 N+1과 대량 페치를 잡아냅니다. 둘째는 AI 슬로우 SQL로, 버튼 하나로 AI에게 넘기면 실행 계획 해석과 인덱스 추천을 스키마와 통계 기준으로 받습니다. Oracle, PostgreSQL, MySQL, MSSQL을 지원하므로 DBA 의존도가 내려갑니다. 셋째는 쿼리 원형 보존으로, 주석과 메타데이터를 그대로 AI에게 넘겨 정확도를 높입니다.
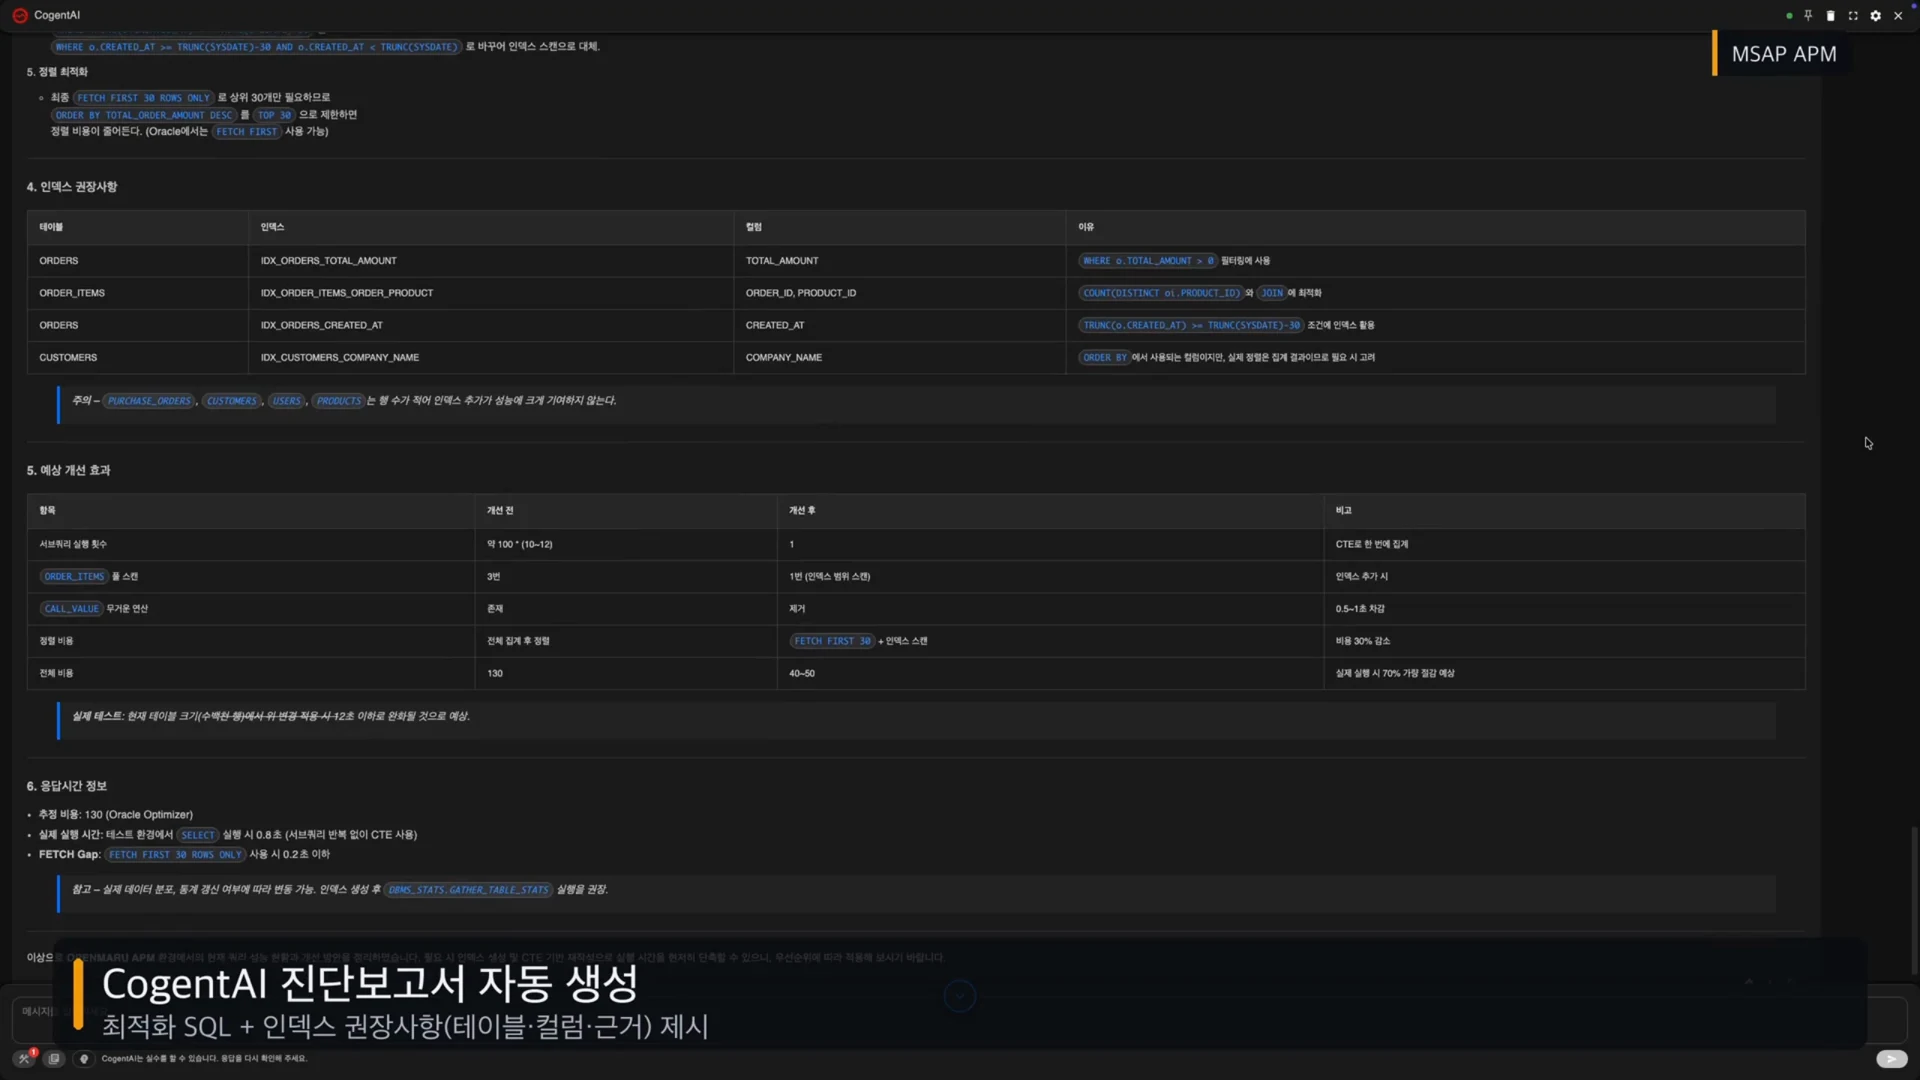
▲ CogentAI가 만든 느린 쿼리 진단 보고 (영상 32:10)
화면에서는 느린 쿼리 하나가 주석과 힌트까지 원형 그대로 AI에게 넘어갑니다. 쿼리를 다시 쓰지 않고 원문을 넘기기 때문에 그 쿼리가 무엇을 하려던 것인지까지 함께 읽힙니다. AI는 실행 계획을 단계별로 풀어 옵티마이저가 매긴 비용, 예상 처리 행수, 단계별 예상 시간을 보여 주고, 해석에서 끝나지 않고 어느 컬럼에 인덱스를 만들어야 하는지, 쿼리의 어느 부분을 바꿔야 하는지까지 제안합니다. 지금까지 DBA에게 물어야 알 수 있던 내용입니다. AI 장애 원인 분석이 DBA의 영역으로 들어가는 지점입니다.
영상의 마무리는 한 줄입니다. 지표를 통보하는 데서 멈추지 않고 원인을 짚고 무엇을 할지까지 말해 주며, 그 답이 맞는지 화면 안에서 되짚어 증명한다는 것입니다. 다음 편은 운영 중인 시스템이 아니라 기술 지원 자체를 AI로 바꾼 사례를 다룹니다. 이번 편의 AI 장애 원인 분석 데모는 여기까지입니다.
핵심 정리: 한 표로 보는 AI 장애 원인 분석
AI 장애 원인 분석은 운영자의 질문 한 줄에서 출발해 원인과 조치, 그리고 실측 검증까지 이어지는 흐름이고, 알람만 울리는 기존 방식과는 이 점에서 갈립니다. 도입을 검토한다면 AI 장애 원인 분석이 자사 지표와 맞물리는지부터 보시면 됩니다.
| 질문 | 영상의 답 | 영상 시각 |
|---|---|---|
| 첫 질문에서 AI는 무엇을 하는가 | TPS·응답시간·Apdex를 모아 병목 지점을 식별 | 7:40 |
| 장애 유형이 달라도 흐름이 같은가 | 질문, 지표 수집, 원인 특정, 조치 제안의 순서 | 9:00 |
| 외부 API 에러는 어떻게 좁히는가 | 정상 지표를 지워 HTTP 500으로 도달 | 10:40 |
| DB 장애는 왜 찾기 어려운가 | 커넥션 풀 고갈로 증상이 전체로 번짐 | 14:00 |
| 무엇이 잘못인지 모를 때는 | T-Map 모양만으로 유형을 먼저 감지 | 18:40 |
| AI 답을 믿어도 되는가 | 콜 트리와 SQL 시간으로 실측 검증 | 23:45 |
| 사용자 관점의 문제는 어떻게 찾는가 | 20초 걸린 성공 응답을 활동 추적으로 확인 | 25:40 |
| 느린 쿼리는 어디까지 돕는가 | 실행 계획 해석과 인덱스·수정 제안 | 32:10 |
자주 묻는 질문
AI 장애 원인 분석이란 무엇인가요?
운영자가 자연어로 묻기만 하면 APM 지표와 트랜잭션 추적을 모아 원인과 조치까지 돌려주는 방식입니다. 영상은 TPS, 응답시간, 오류율, Apdex 같은 핵심 지표가 질문 한 줄에 자동으로 모이고, 알람에서 멈추지 않고 무엇을 할지까지 간다는 점을 데모로 보여 줍니다.
장애 유형이 달라도 AI가 다루는 흐름은 같은가요?
같습니다. 질문, 지표 수집, 원인 특정, 조치 제안의 순서가 세 사례에서 반복됩니다. 외부 서비스 지연, 외부 API 에러, DB 지연 모두 운영자가 자연어로 묻고 시스템이 지표를 모아 원인을 짚은 뒤 조치를 제안하는 순서로 흘러갑니다.
정상 지표를 지워 가며 원인을 찾는다는 것은 무슨 뜻인가요?
TPS·응답시간·Heap이 정상임을 확인해 자원 문제를 배제하고 외부 API 장애로 좁히는 소거법입니다. 에러율이 60~65퍼센트까지 치솟고 Apdex가 급락한 시나리오에서 AI가 정상 항목을 하나씩 지워 HTTP 500 외부 API 장애에 도달하는 과정을 영상이 보여 줍니다.
T-Map은 무엇이고 무엇을 알려 주나요?
모든 트랜잭션을 시간과 응답시간 평면에 그린 히트맵으로, 모양만 보고 장애 유형을 먼저 짚어 줍니다. 세로줄, 느린 응답, 파도치기 같은 16종 패턴을 자동 분류하고, 타임아웃 패턴은 느린 SQL과 외부 호출 진단까지 이어 줍니다.
AI가 내놓은 원인이 맞는지는 어떻게 확인하나요?
트랜잭션 추적에서 SQL 시간을 재고 콜 트리에서 AI가 지목한 쿼리가 실제 호출되는지 확인합니다. 영상의 지연 트랜잭션 사례에서는 전체 6,714밀리초 가운데 SQL 시간이 6,711밀리초였고, AI가 지목한 쿼리가 콜 트리에서 실제로 호출되고 있음을 보여 줍니다.
200 응답인데 느린 요청은 어떻게 찾나요?
사용자 활동 추적으로 세션별 요청 경로와 응답 속도를 시간순 표로 세워 보면 드러납니다. 영상에서는 장바구니 담기 요청 하나가 상태 코드 200인데도 20초를 넘겼고, 에러가 아니라 기존 알람으로는 걸리지 않는 문제가 사용자 관점에서 드러났습니다.
느린 쿼리 진단은 어디까지 도와주나요?
실행 계획을 단계별로 해석하고 어느 컬럼에 인덱스를 만들지, 쿼리의 어느 부분을 바꿀지까지 제안합니다. 주석과 힌트까지 원형 그대로 AI에게 넘기며 Oracle, PostgreSQL, MySQL, MSSQL을 지원해 DBA에게 매번 묻는 병목을 줄입니다.
참고 리소스
AI 장애 원인 분석을 더 깊이 살펴볼 때 볼 원 영상과 이어서 읽을 글, 개념 문서를 모았습니다.
- AI가 장애 원인까지 짚는다 — LLM AIOps ② 실전 데모 — 클라우드네이티브TV, 이 글이 정리한 원 영상
- AI 에이전트란 무엇인가 — 에이전트 구조의 기본 개념
- 에이전틱 AI란 무엇인가 — 에이전트가 판단과 실행을 나누는 방식
- 에이전틱 AI 거버넌스 가이드 — 승인과 감사 절차 설계
- LLM이란 무엇인가 — 거대 언어 모델의 기본 원리
- MSAP.ai 솔루션 문의 — 도입 검토 상담
- MSAP.ai 홈페이지 — 제품과 자료 모음
- AI 분야 글 모음 — MSAP.ai AI 카테고리
- Application performance management — APM의 일반 개념
- Apdex — 응답 만족도 지표의 일반 개념
- Heat map — 히트맵 시각화의 일반 개념
- Query plan — 실행 계획의 일반 개념
다음 단계
우리 운영 환경에서 어떤 장애 질문부터 AI에게 맡기고 어떤 지표로 답을 검증할지는 시스템 구성에 따라 달라집니다. 우리 환경에 맞는 AIOps 도입 순서를 함께 검토하려면 아래에서 시작하세요.