- 발표자료 다운로드 — DNS 응답 코드와 실패 속도로 원인 구간을 좁히는 방법
- 발표 영상으로 먼저 보기 — eBPF 기반 MSAP.ai Observability 전체 기능 개요
- 이 발표자료가 답하는 여섯 가지 질문
- 원인이 코드 밖에 있어도 같은 화면에서 찾을 수 있는가
- IP를 받지 못하면 연결 시도는 시작되지 않는다
- 어느 DNS에 어떤 순서로 물을지는 인프라 설정이 정한다
- 이름이 없으면 밀리초, 대답이 없으면 초 단위로 실패한다
- CoreDNS는 대답이 없을 때만 다른 서버로 넘어간다
- 화면의 실패 시간은 가장 짧은 타임아웃을 가진 층이 정한다
- 외부 이름 하나에 NXDOMAIN 여섯 개는 정상 동작이다
- 외부 이름을 조회하는 서비스는 결제와 배송 둘뿐이다
- 평소에 쓰지 않는 보조 DNS 경로는 막혀 있어도 드러나지 않는다
- 문제 구간은 화면에서 좁히고 이유는 인프라에서 확정한다
- 두 장애는 실패 속도와 응답 코드로 갈린다
- 시나리오 ① 보조 DNS는 살아 있었지만 방화벽 허용 목록에서 빠져 있었다
- 고장 난 길은 하나인데 영향은 두 서비스에 나타났다
- 화면 세 곳에서 DNS 구간을 찾고 인프라 세 곳에서 이유를 확정했다
- 시나리오 ② 배포 직후 장애였지만 코드는 정상이었다
- NXDOMAIN은 확정 응답이라 보조 DNS로 넘어가지 않는다
- 찾는 순서는 같고 단계마다 보이는 값이 다르다
- 등록 직후의 실패를 등록 실패로 단정하지 않는다
- 느리면 응답 없는 DNS, 빠르면 이름 없는 DNS를 먼저 의심한다
- 여러 팀과 도구를 오가던 원인 구간 좁히기가 한 화면에서 끝난다
- 넓게, 빠르기, 연결, 이름, 확정 순서로 점검한다
- 쓰지 않는 경로와 빠진 등록은 평소 점검으로 미리 찾는다
- 핵심 정리
- 자주 묻는 질문
- 쿠버네티스 관측성, OpenTelemetry, 분산 추적
- 참고 리소스
- 자료 다운로드
발표자료 다운로드 — DNS 응답 코드와 실패 속도로 원인 구간을 좁히는 방법
전체 33장, PDF로 33쪽이다. MSAP.ai 옵저버빌리티 세미나의 세 번째 세션 자료로 개념, 데모 환경, 시나리오 두 가지, 정리 다섯 부분으로 나뉜다. 마지막에는 DNS 장애 점검 다섯 단계와 평소 점검 항목 네 가지를 실었다.
CoreDNS, Kubernetes, resolv.conf, RFC 문서와 데모 포워더 로그를 근거로 정리했고 장마다 바닥글에 출처를 적었다. 장애 대응 절차를 정비하는 운영팀과 플랫폼팀이 바로 참고할 수 있도록 PDF로 공개한다.
MSAP.ai 백서 구독하기🔔
새로운 백서 소식을 가장 먼저 만나보세요!
MSAP.ai 가 전하는 AI 기반 운영 인사이트와 최신 백서 소식을 가장 빠르게 받아보실 수 있습니다.
구독해 주시면 더 좋은 콘텐츠로 보답하겠습니다.🙏
발표 영상으로 먼저 보기 — eBPF 기반 MSAP.ai Observability 전체 기능 개요
이 세션만 다룬 영상은 아직 없다. 대신 이 세션의 데모 화면과 같은 제품인 MSAP.ai Observability의 전체 기능을 30분 동안 보여 주는 개요 영상을 소개한다.
세션 자료가 DNS 장애를 좁히는 순서를 설명한다면 개요 영상은 그 화면들이 제품 안에서 어떻게 이어지는지 보여 준다. 아래 영상은 이 세션의 녹화가 아니라 같은 제품의 기능 개요 편이다.
영상에서 다루는 순서는 다음과 같다.
- eBPF 기반 Zero-Instrument 수집과 APM 비교
- 토폴로지, 분산 추적, 로그 화면
- AI 기반 원인 분석
쿠버네티스 관측성의 전체 구조는 쿠버네티스 관측성, OpenTelemetry, 분산 추적에서 함께 볼 수 있다.
이 발표자료가 답하는 여섯 가지 질문
- DNS 문제인지 아닌지 어떻게 먼저 가를 수 있는가
- 보조 DNS가 있는데도 왜 서비스가 실패하는가
- NXDOMAIN이 쌓이면 모두 장애인가
- 실패까지 걸린 초 수는 무엇이 정하는가
- 서버에 접속하지 않고 어디까지 확인할 수 있는가
- 같은 장애를 막으려면 평소에 무엇을 점검하는가
원인이 코드 밖에 있어도 같은 화면에서 찾을 수 있는가
예시 인물은 결제와 배송 서비스를 맡은 쇼핑몰 개발자 김대리다. 코드에는 자신 있지만 인프라는 잘 모른다. 쇼핑몰은 서비스 8개, 언어 7개이고 모니터링 코드는 한 줄도 없다.
대신 노드마다 MSAP.ai Observability 에이전트가 하나씩 떠서 커널에서 모든 통신을 관측한다. 어느 날 배송 조회가 안 된다는 연락이 오는데, 바뀐 코드는 없다.
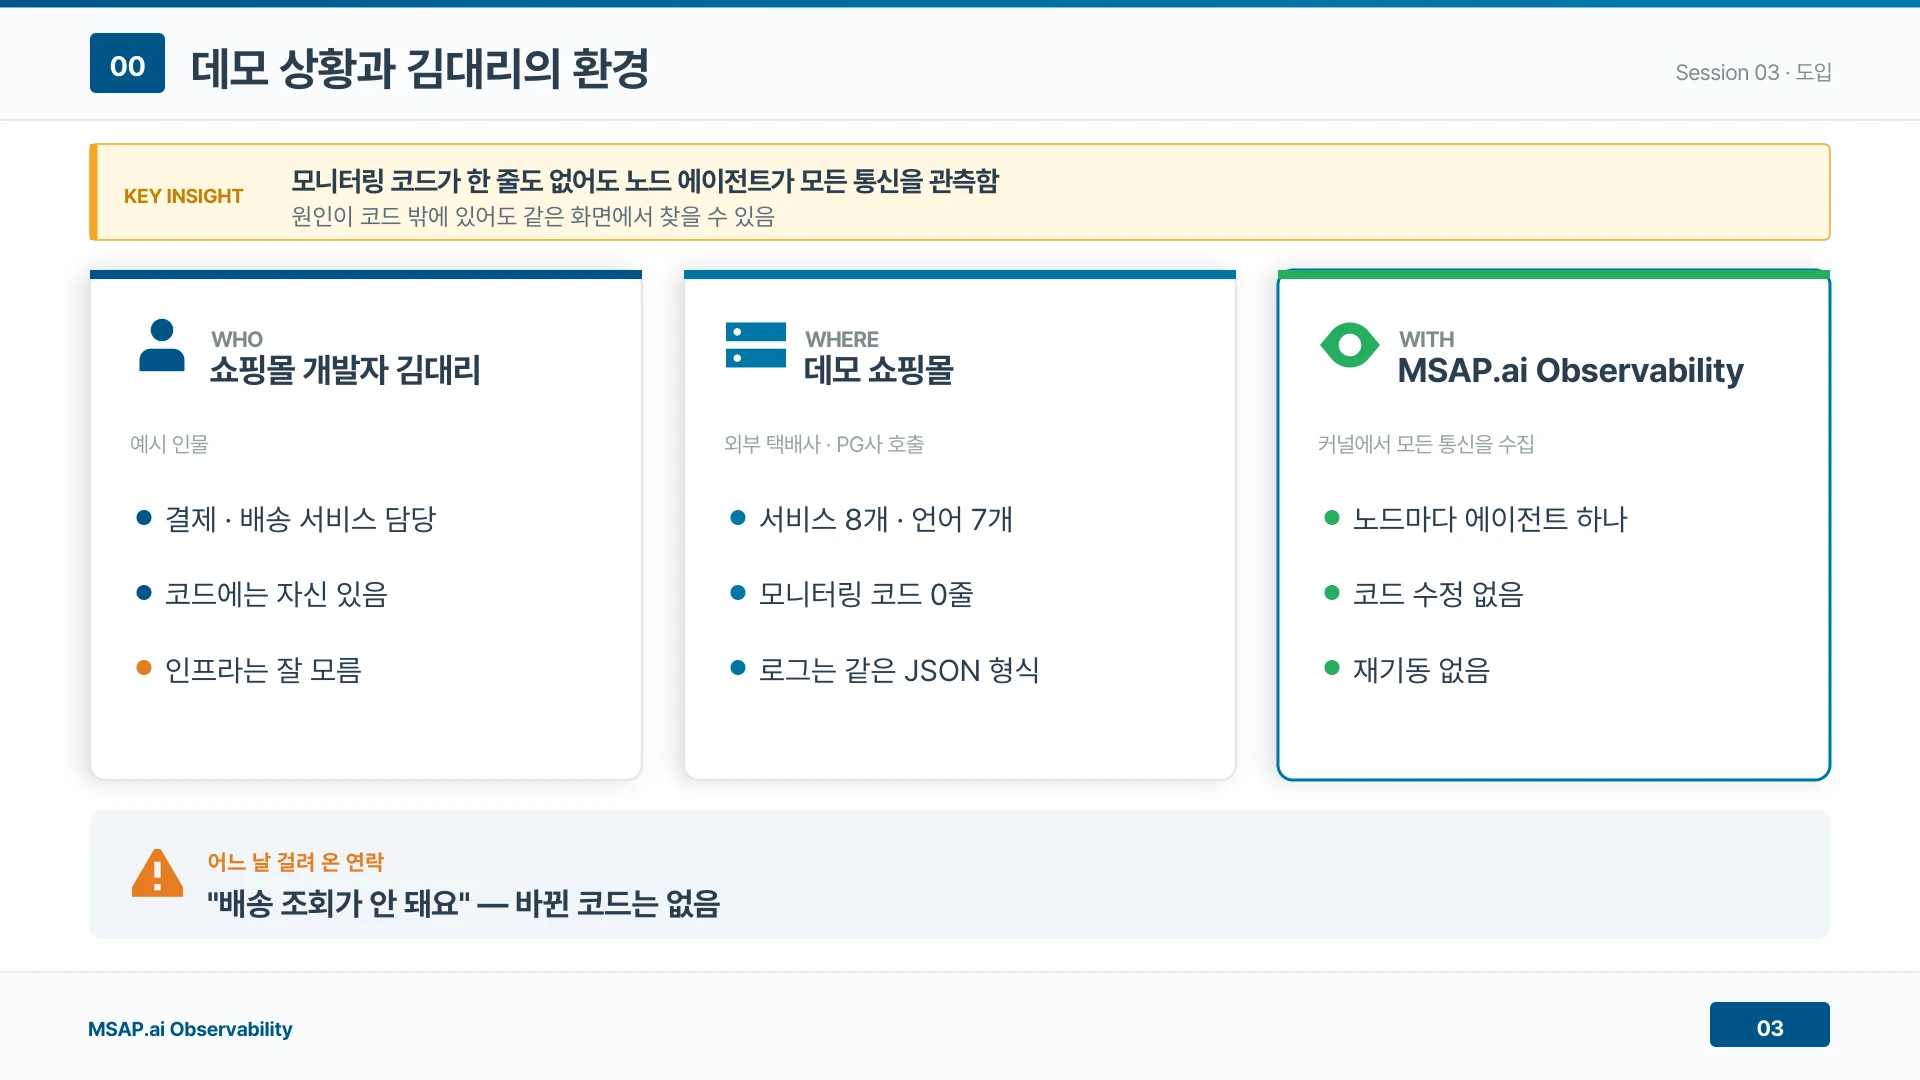
▲ 모니터링 코드가 한 줄도 없어도 노드 에이전트가 모든 통신을 관측함 (발표자료 3쪽)
IP를 받지 못하면 연결 시도는 시작되지 않는다
앱은 이름을 묻고, IP를 받고, 받은 IP로 연결하는 3단계를 거친다. 2단계에서 IP를 받지 못하면 3단계 연결은 시작조차 하지 않는다.
그래서 네트워크 기록에 연결 시도가 아예 없다면 DNS를 먼저 의심한다. 이 단서는 뒤의 두 시나리오에서 모두 쓰인다.
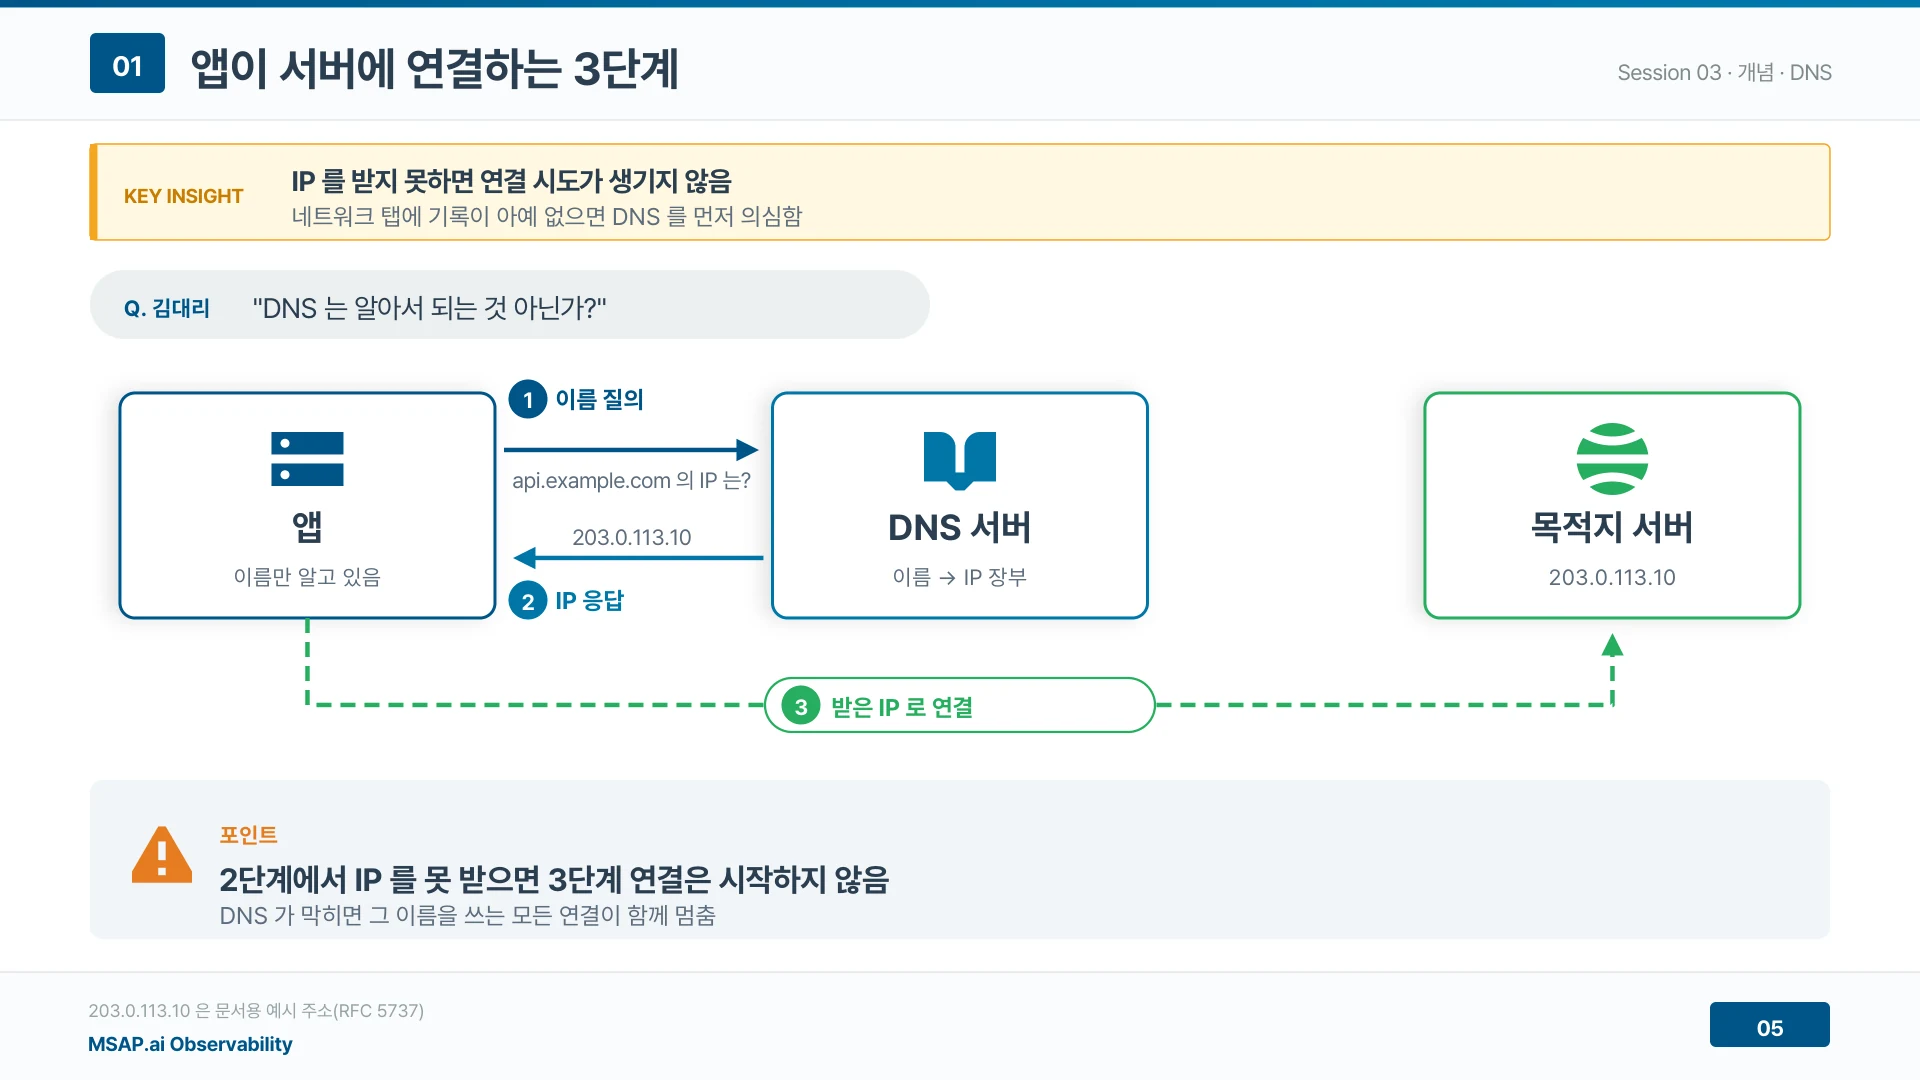
▲ IP 를 받지 못하면 연결 시도가 생기지 않음 (발표자료 5쪽)
어느 DNS에 어떤 순서로 물을지는 인프라 설정이 정한다
쿠버네티스 파드에서 앱이 이름을 물으면 OS 리졸버가 /etc/resolv.conf를 보고 CoreDNS에 묻는다. 클러스터 안의 서비스 이름은 CoreDNS가 바로 답하고, 바깥 이름은 사내 주 DNS와 보조 DNS로 넘긴다.
김대리가 코드에서 정하는 것은 어떤 이름을 부를지뿐이다. 질의 순서는 resolv.conf와 Corefile이, 그 서버까지 가는 길은 방화벽과 NetworkPolicy가 정한다. egress가 막힌 파드에 DNS 53번 포트 허용이 없으면 앱 포트를 열어 두어도 이름 해석 단계에서 먼저 실패한다.
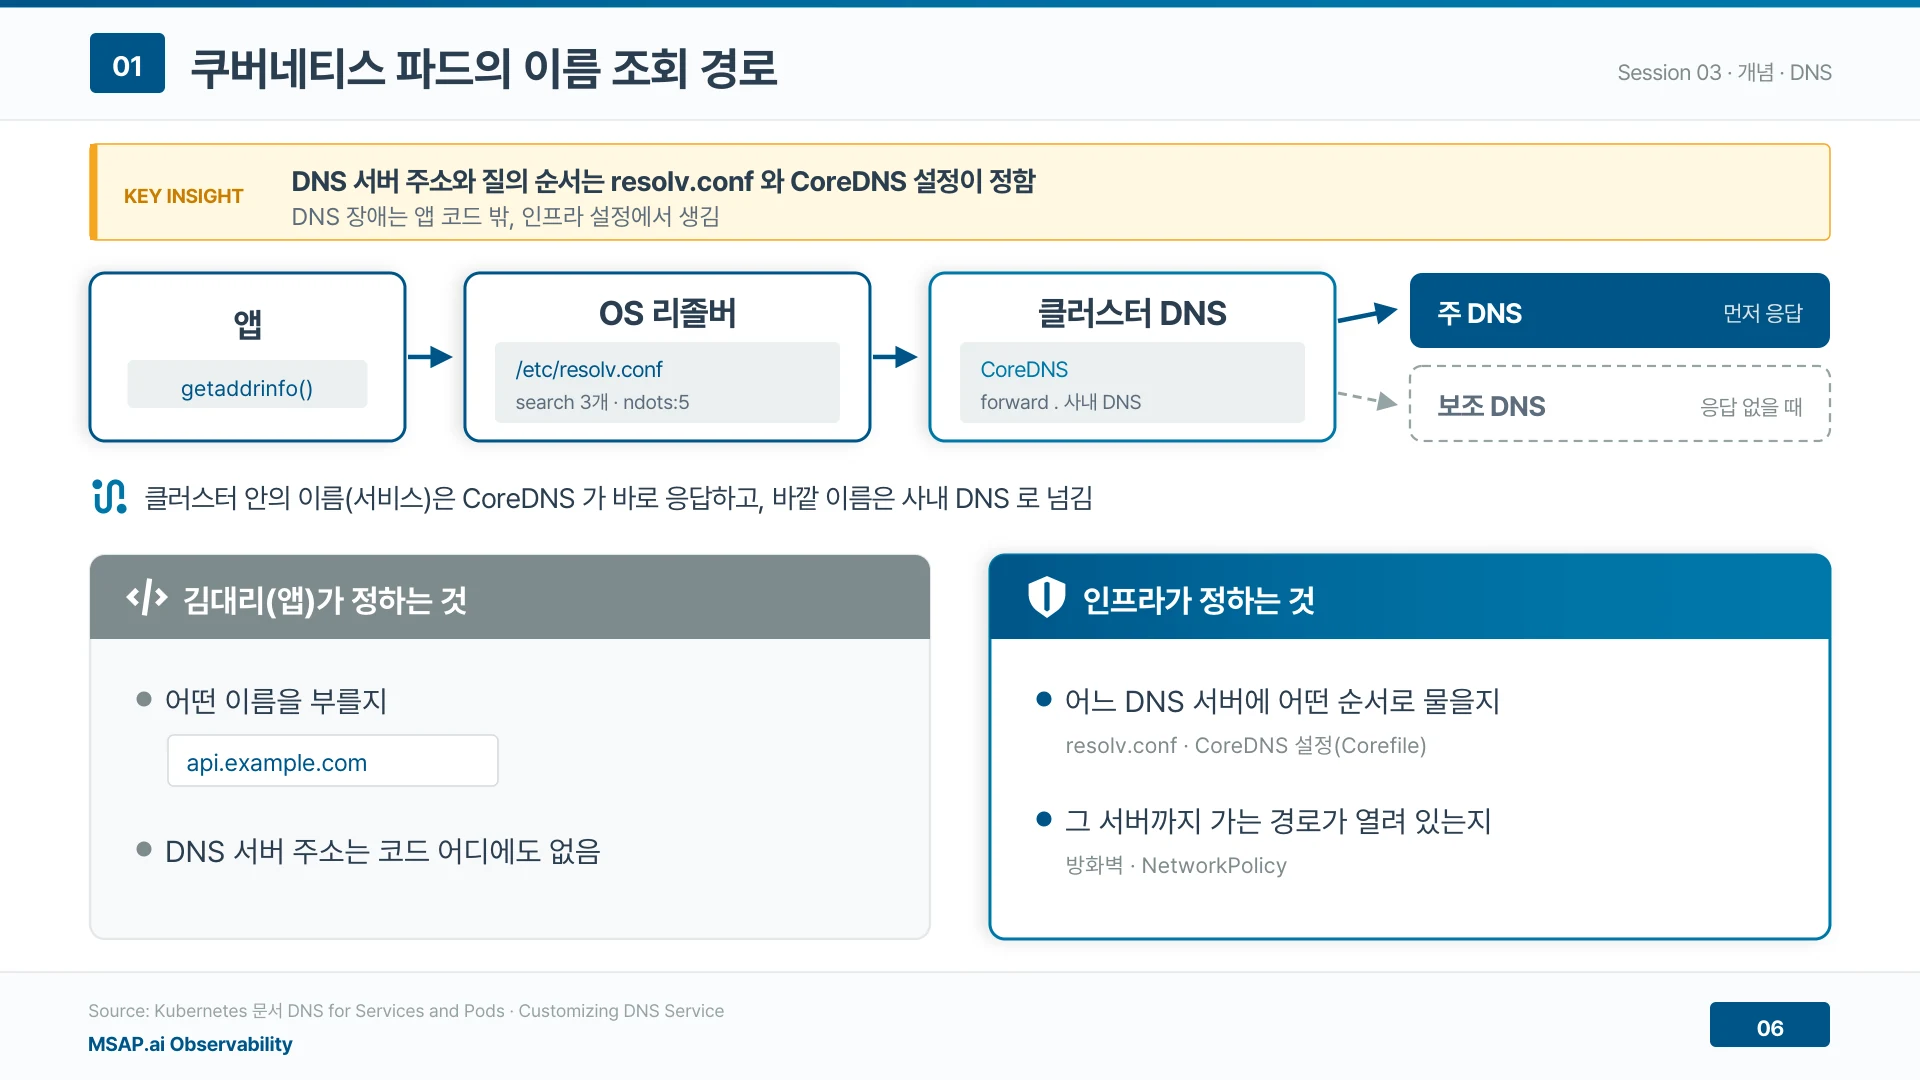
▲ DNS 서버 주소와 질의 순서는 resolv.conf 와 CoreDNS 설정이 정함 (발표자료 6쪽)
이름이 없으면 밀리초, 대답이 없으면 초 단위로 실패한다
NOERROR는 정상으로 IP를 받는다. NXDOMAIN은 그런 이름이 없다는 확정 응답이라 다른 서버에 묻지 않고 몇 밀리초 만에 실패한다. 응답 없음은 기다렸다가 다음 서버로 넘어가므로 몇 초가 걸린다.
앱 예외도 다르다. 이름이 없으면 ENOTFOUND, 대답이 없으면 EAI_AGAIN이 남는다. SERVFAIL과 REFUSED도 응답이 온 경우라 CoreDNS 기본 설정에서는 다음 서버로 넘어가지 않는다.
먼저 볼 곳도 갈린다. NXDOMAIN은 질의가 DNS 서버까지 닿았지만 이름을 찾지 못한 것이므로 이름, 네임스페이스, search 도메인을 본다. 타임아웃이면 53번 포트 경로와 CoreDNS 엔드포인트를 본다. NXDOMAIN을 보고 CoreDNS부터 재시작하는 것은 범위만 넓히는 조치다.
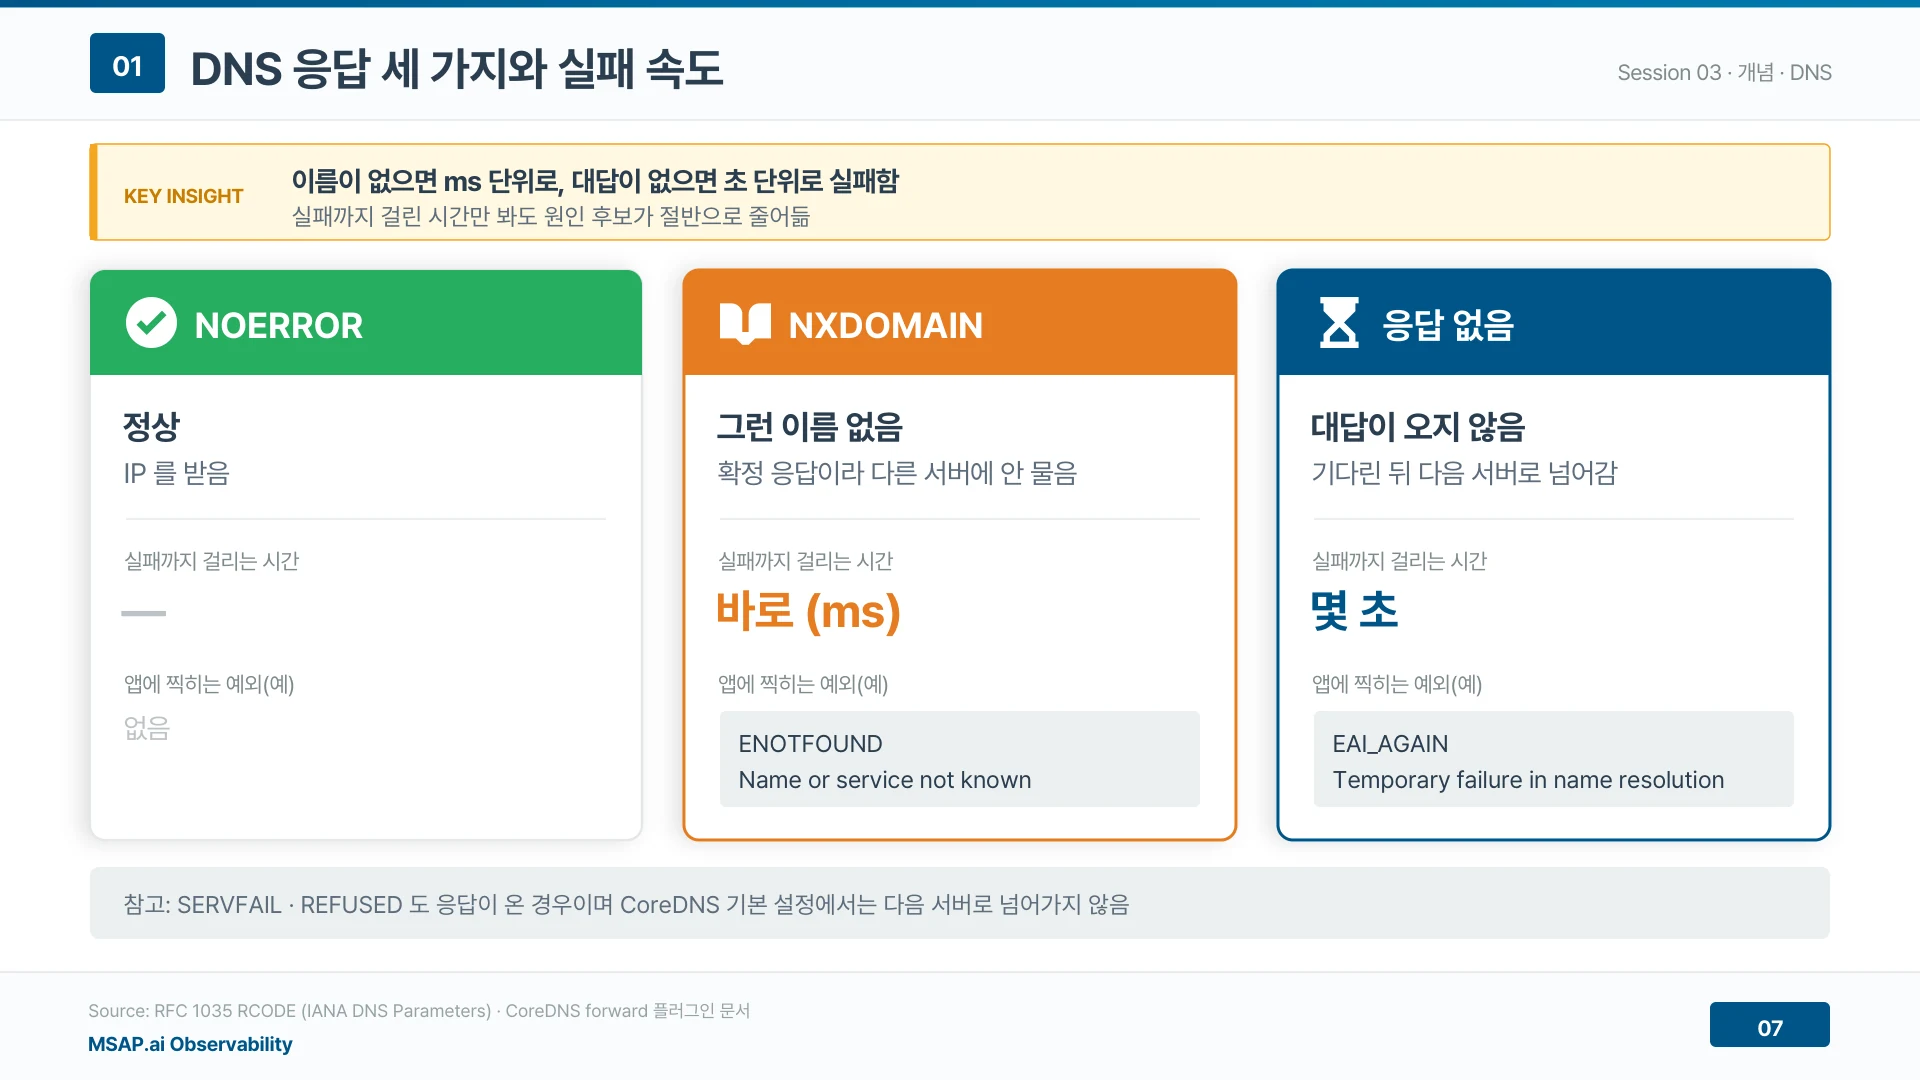
▲ 이름이 없으면 ms 단위로, 대답이 없으면 초 단위로 실패함 (발표자료 7쪽)
CoreDNS는 대답이 없을 때만 다른 서버로 넘어간다
CoreDNS forward 플러그인은 업스트림이 2초 안에 응답하지 않을 때만 다른 서버에 묻고, NXDOMAIN처럼 응답이 온 경우에는 그대로 앱에 돌려준다.
헬스 체크는 0.5초 간격이고 두 번 연속 실패한 서버는 다운으로 표시한다. 서버 선택 기본 정책은 random이고 policy sequential이면 적힌 순서대로 묻는다. 보조 DNS까지 가는 경로도 열려 있어야 대비책이 된다.
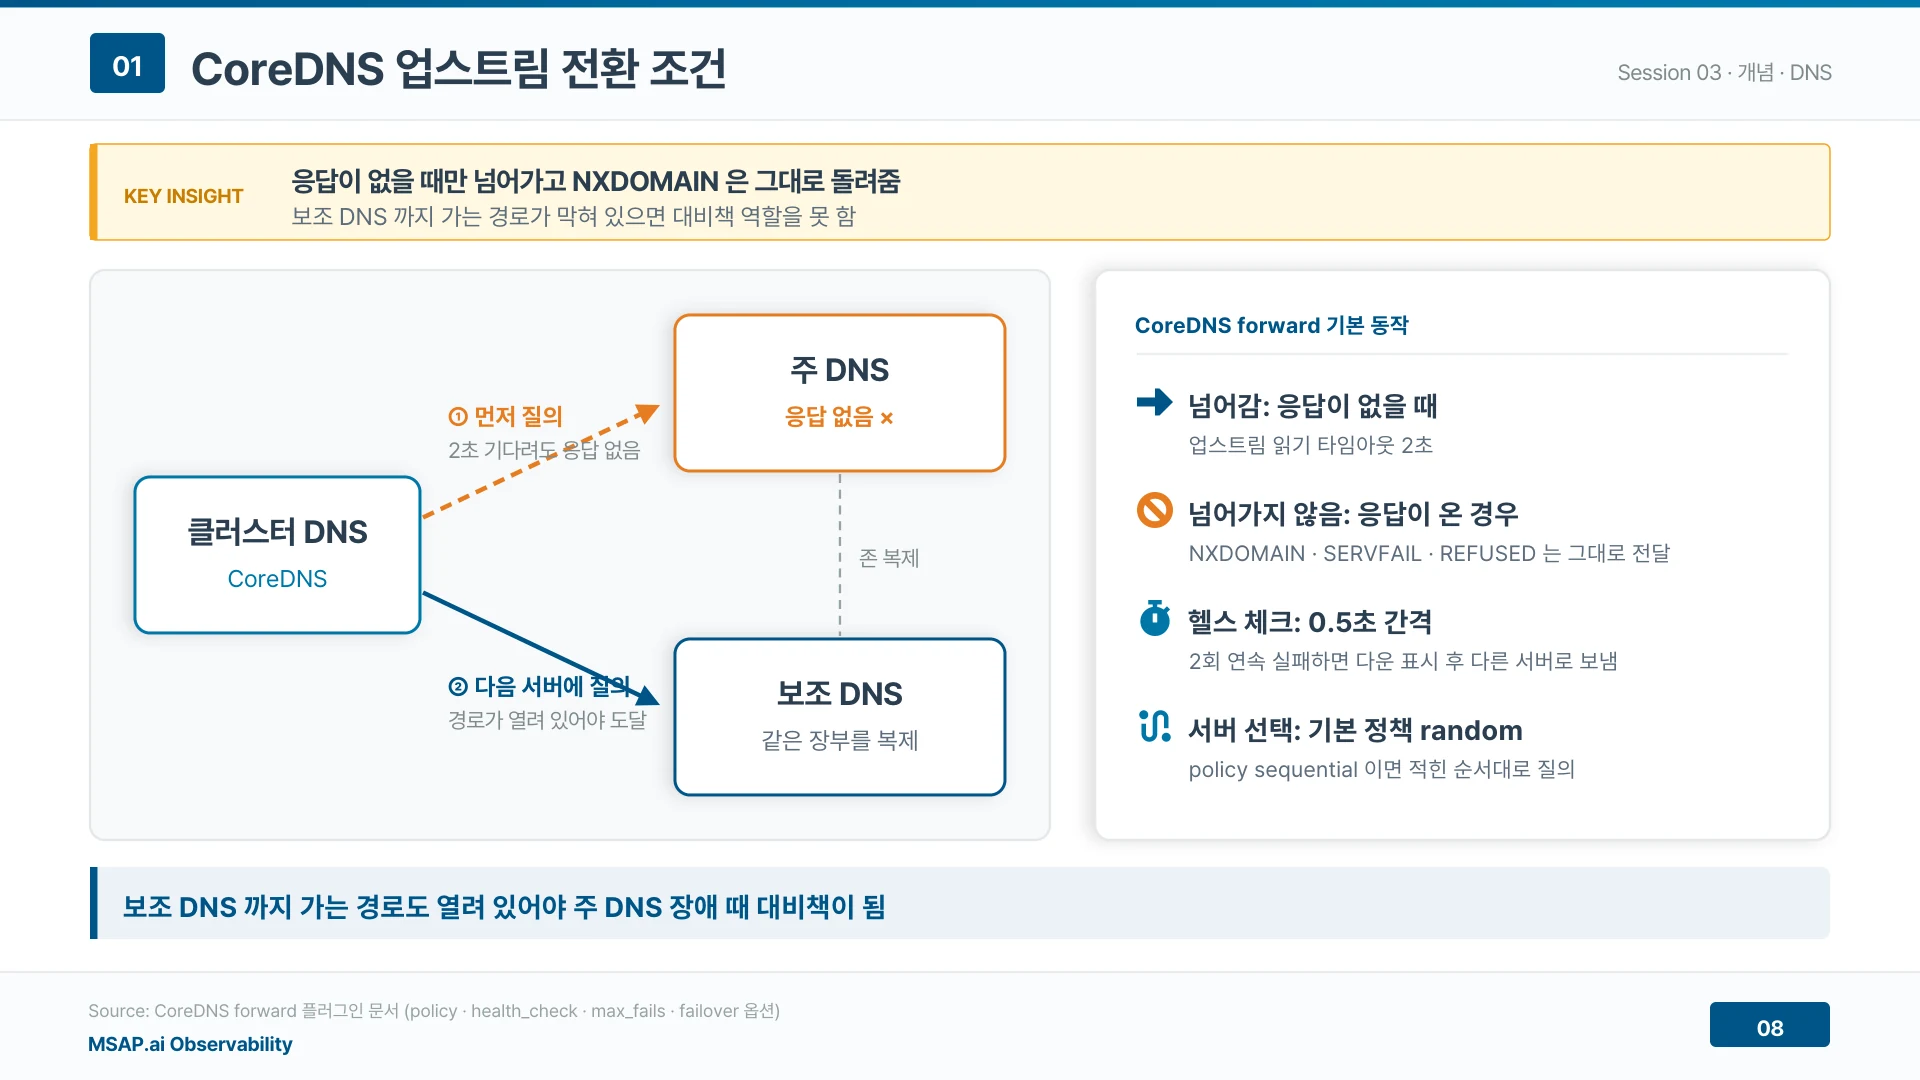
▲ 응답이 없을 때만 넘어가고 NXDOMAIN 은 그대로 돌려줌 (발표자료 8쪽)
화면의 실패 시간은 가장 짧은 타임아웃을 가진 층이 정한다
glibc 리졸버는 5초씩 2회가 기본이라 서버가 하나면 최악 약 10초를 기다린다. CoreDNS의 업스트림 읽기 타임아웃은 2초로 고정이고, Java는 실패한 이름 조회를 기본 10초 동안 캐시한다.
이 데모 앱은 DNS 응답을 3초 기다리다 포기했다. 측정한 실패 시간을 설정값과 맞춰 보면 어느 층에서 포기했는지 알 수 있다.
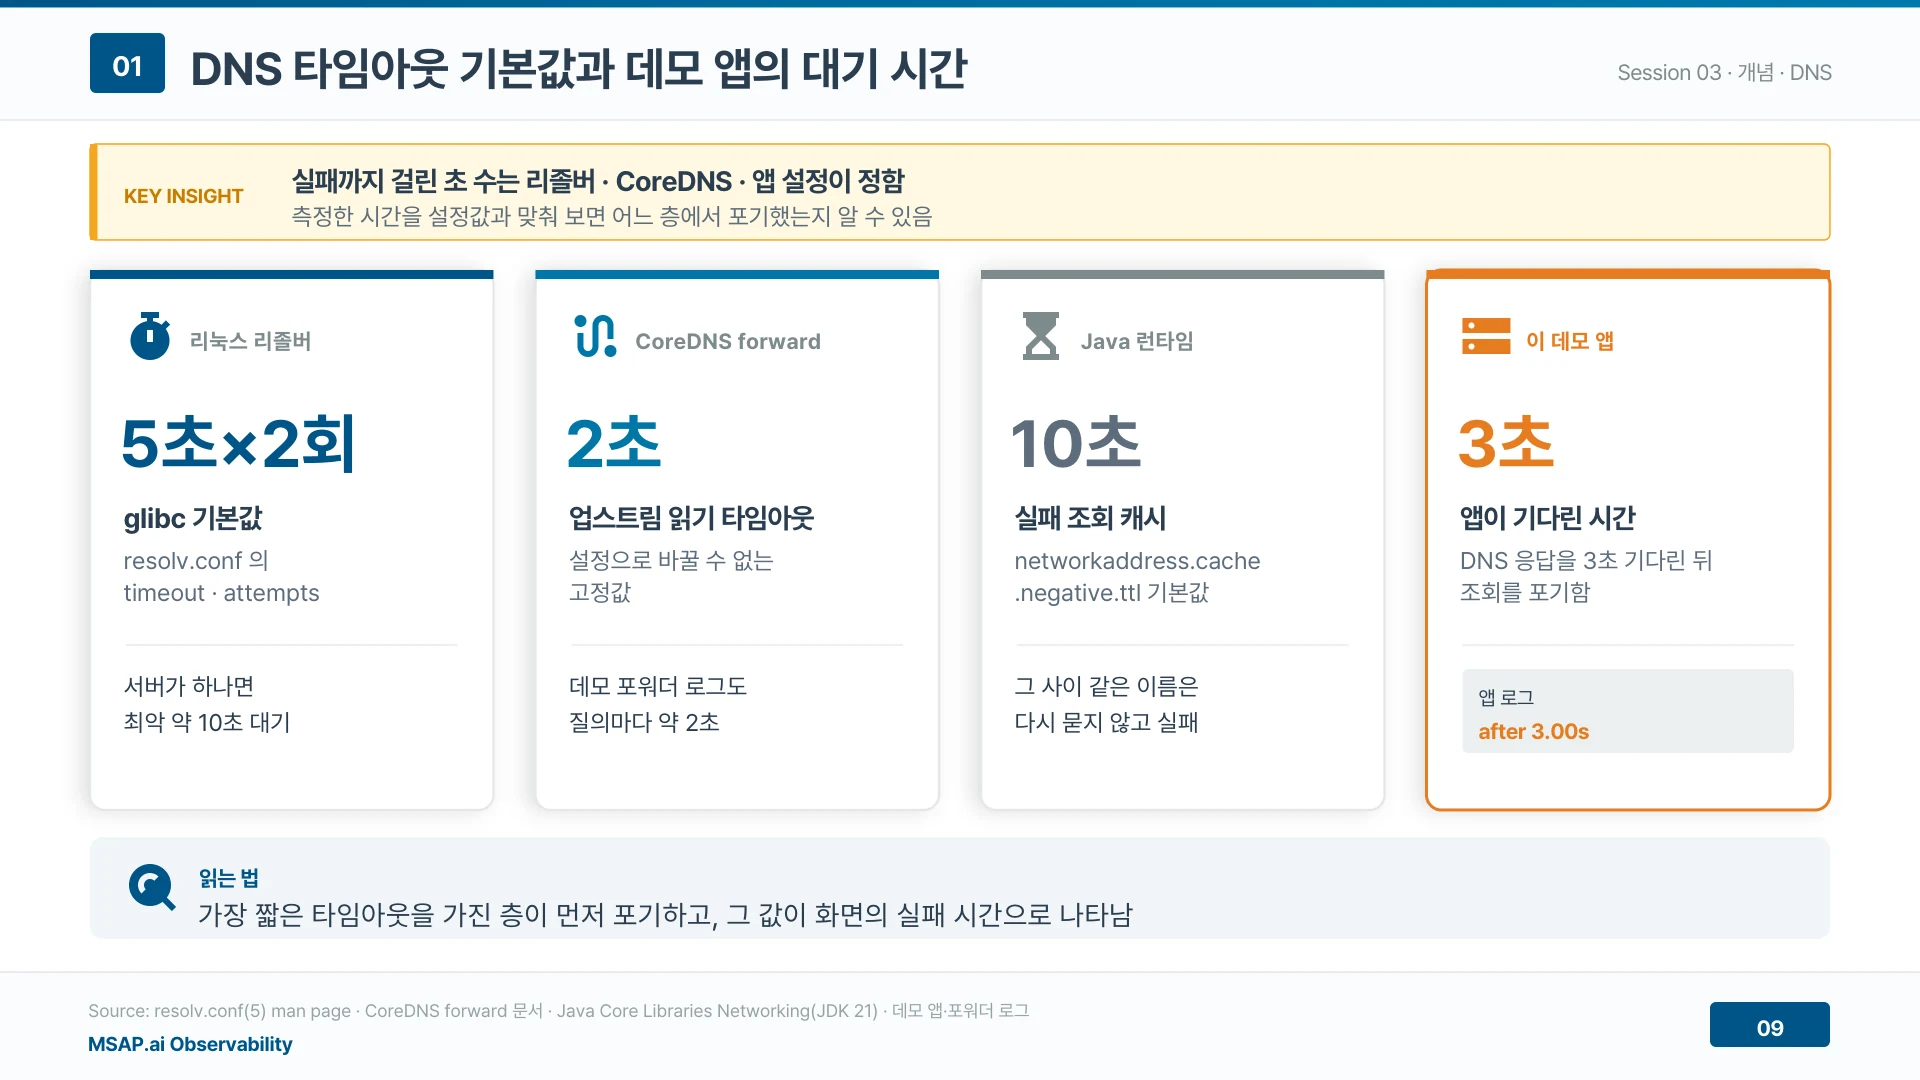
▲ 실패까지 걸린 초 수는 리졸버 · CoreDNS · 앱 설정이 정함 (발표자료 9쪽)
외부 이름 하나에 NXDOMAIN 여섯 개는 정상 동작이다
파드의 resolv.conf에는 ndots:5가 들어 있다. 점이 다섯 개보다 적은 api.example.com을 물으면 search 도메인 세 개를 붙인 질의가 먼저 나가 모두 NXDOMAIN을 받고, 마지막에 원래 이름으로 NOERROR를 받는다.
A와 AAAA를 함께 물으면 질의가 최대 8개이고 그중 NXDOMAIN 6개는 정상이다. 줄이려면 끝에 점을 붙인 이름으로 호출하거나 dnsConfig로 ndots 값을 낮춘다.
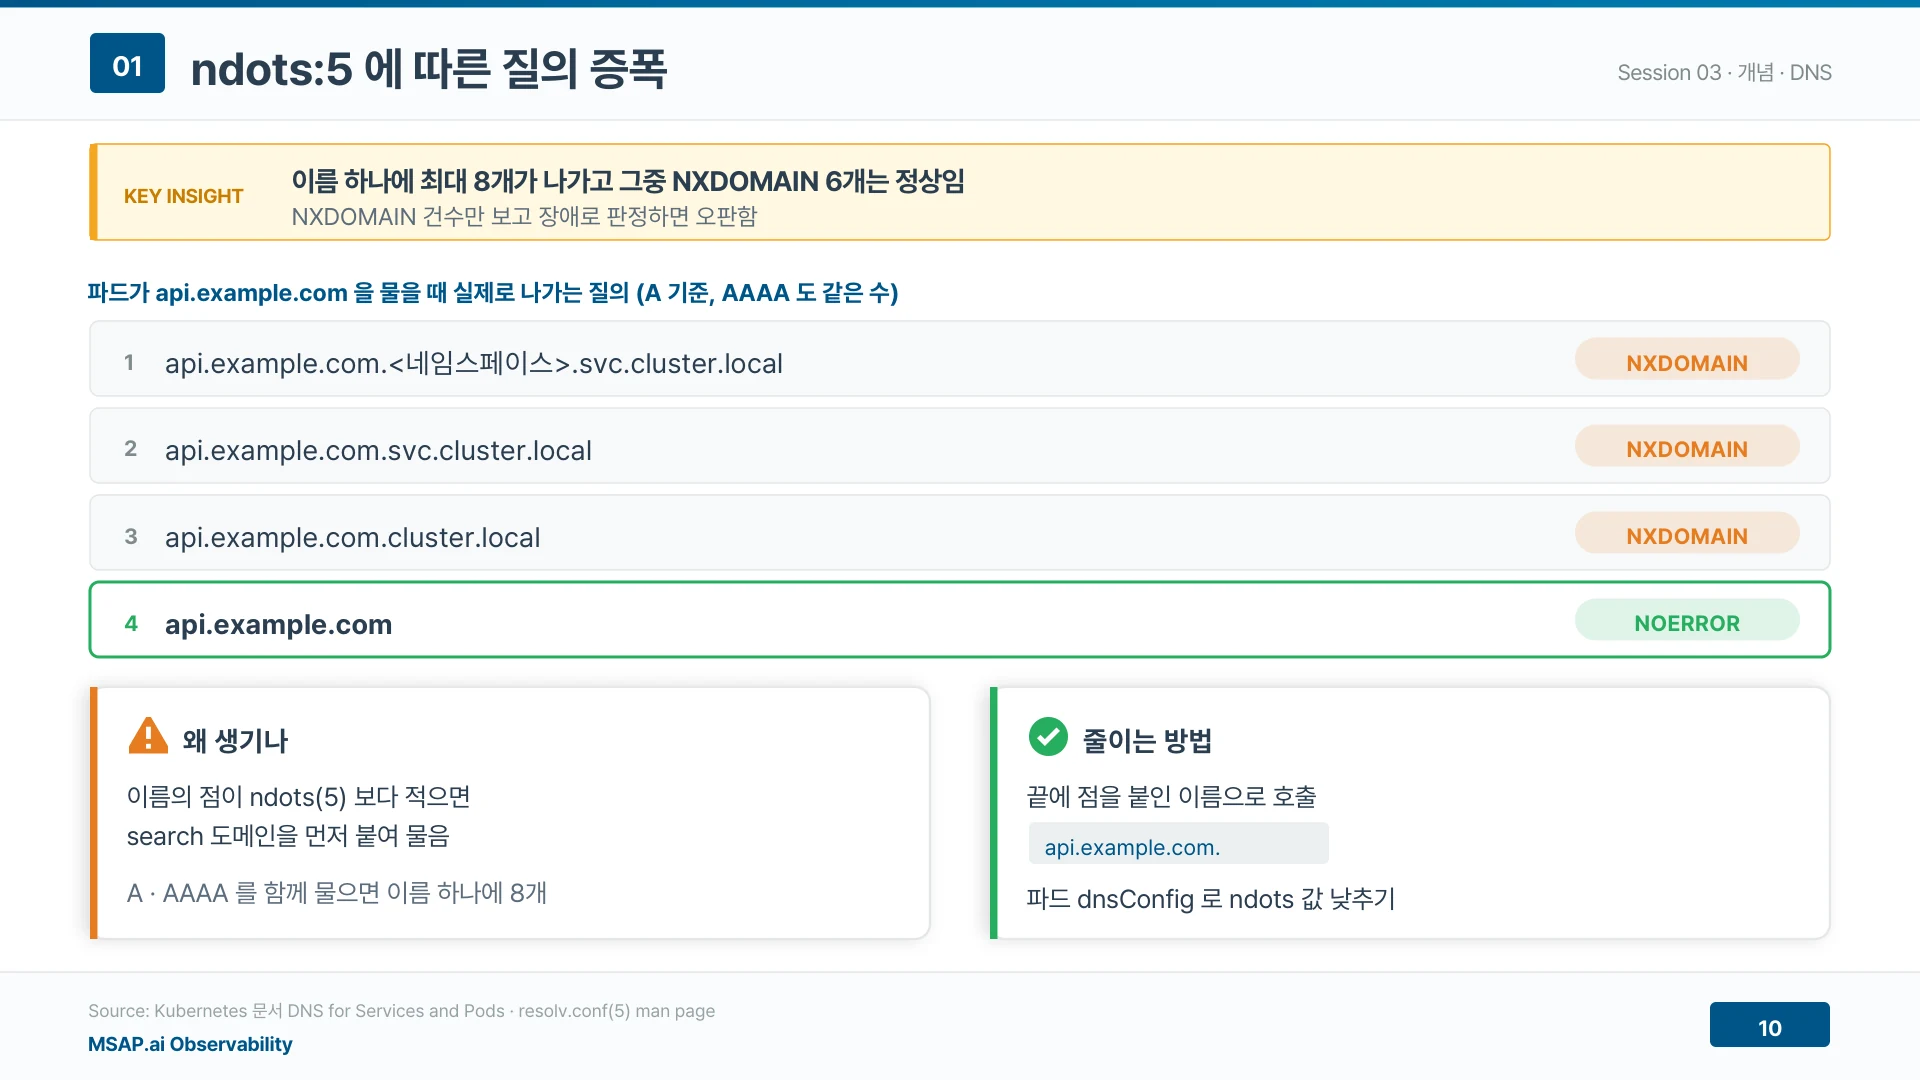
▲ 이름 하나에 최대 8개가 나가고 그중 NXDOMAIN 6개는 정상임 (발표자료 10쪽)
외부 이름을 조회하는 서비스는 결제와 배송 둘뿐이다
데모 쇼핑몰의 게이트웨이는 C#, 상품은 Go, 주문과 회원은 Java, 재고는 Ruby, 알림은 PHP, 결제는 Node.js, 배송은 Python이다.
밖으로 나가는 서비스는 외부 PG사를 부르는 결제와 외부 택배사를 부르는 배송뿐이다. 사내 DNS에 장애가 나면 이 두 서비스가 먼저 실패한다.
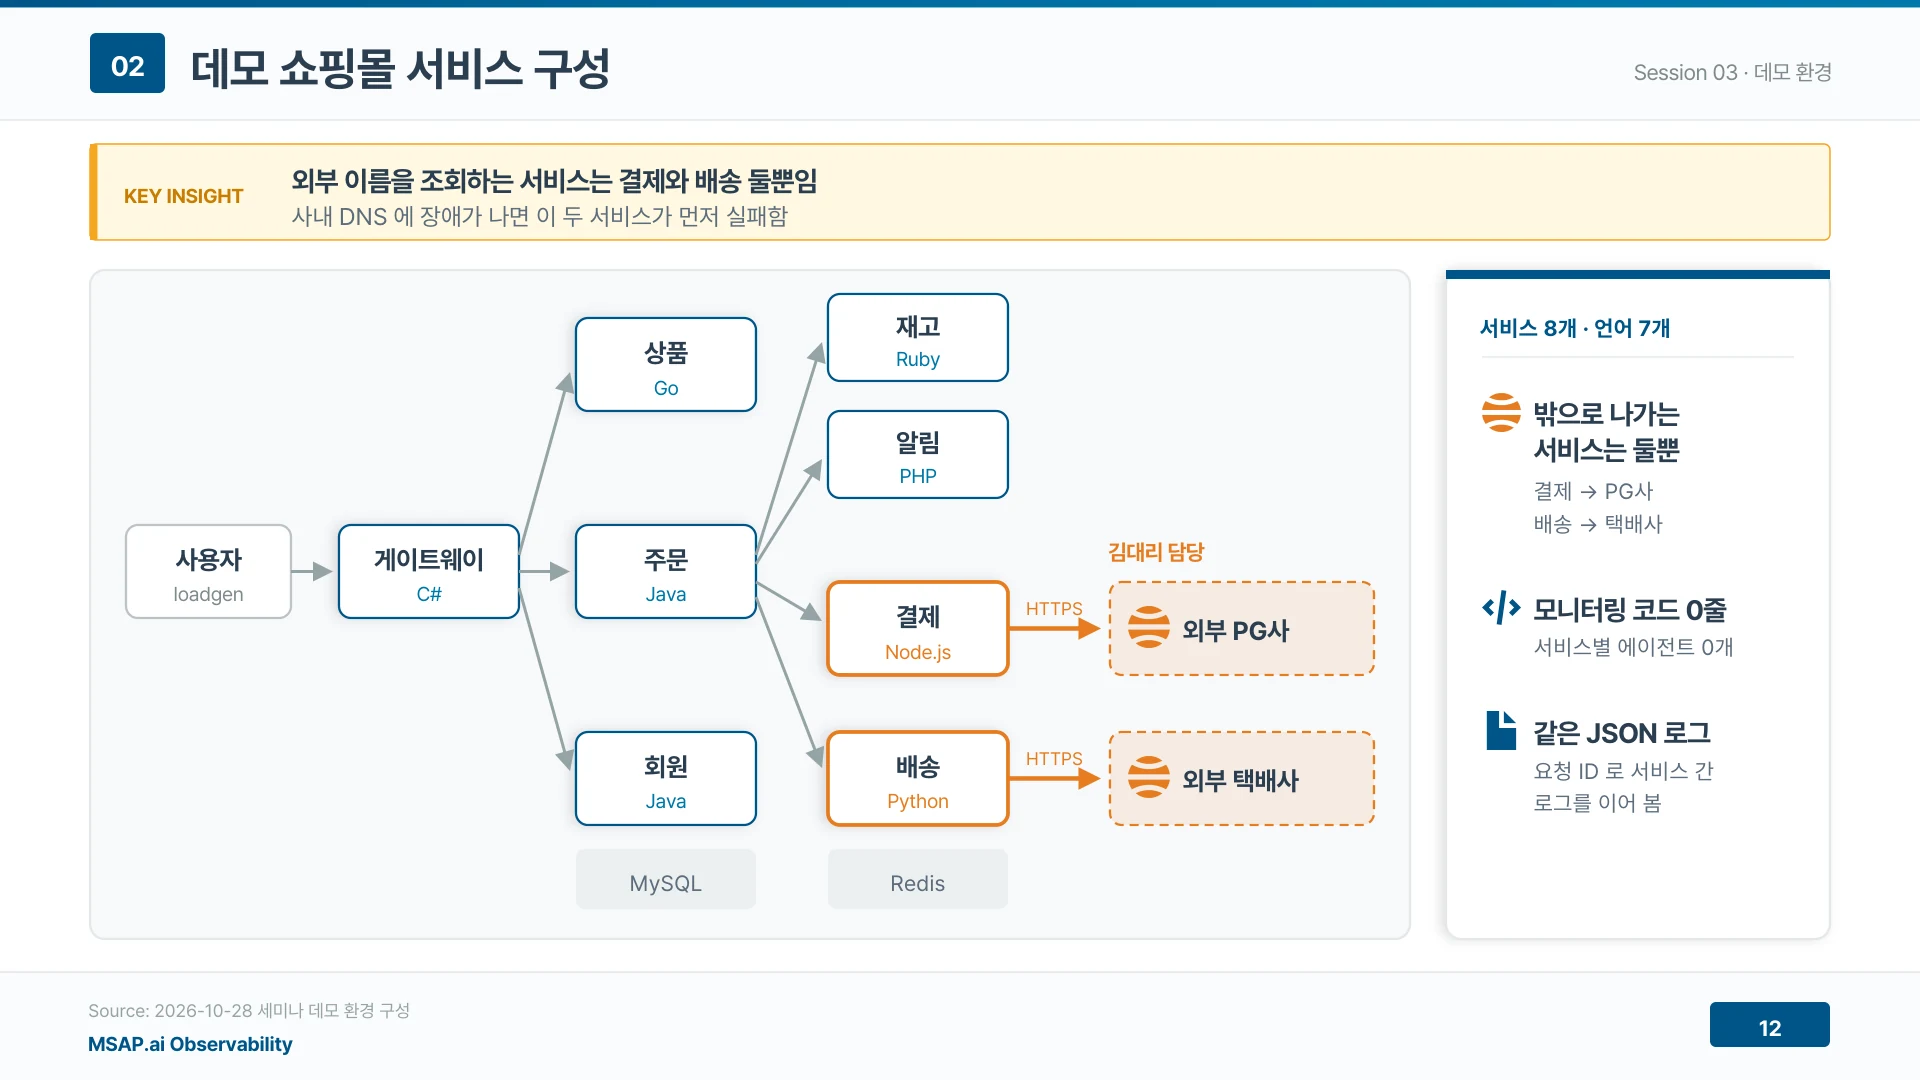
▲ 외부 이름을 조회하는 서비스는 결제와 배송 둘뿐임 (발표자료 12쪽)
평소에 쓰지 않는 보조 DNS 경로는 막혀 있어도 드러나지 않는다
결제와 배송은 클러스터 안의 DNS 포워더(CoreDNS)에 묻고, 포워더는 방화벽을 지나 사내 주 DNS에 전달한다. 보조 DNS는 같은 장부를 복제해 대기한다.
평소에는 주 DNS만 응답하므로 보조 DNS 쪽 경로는 쓰이지 않는다. 그 경로가 막혀 있어도 장애 전까지 아무도 모른다.
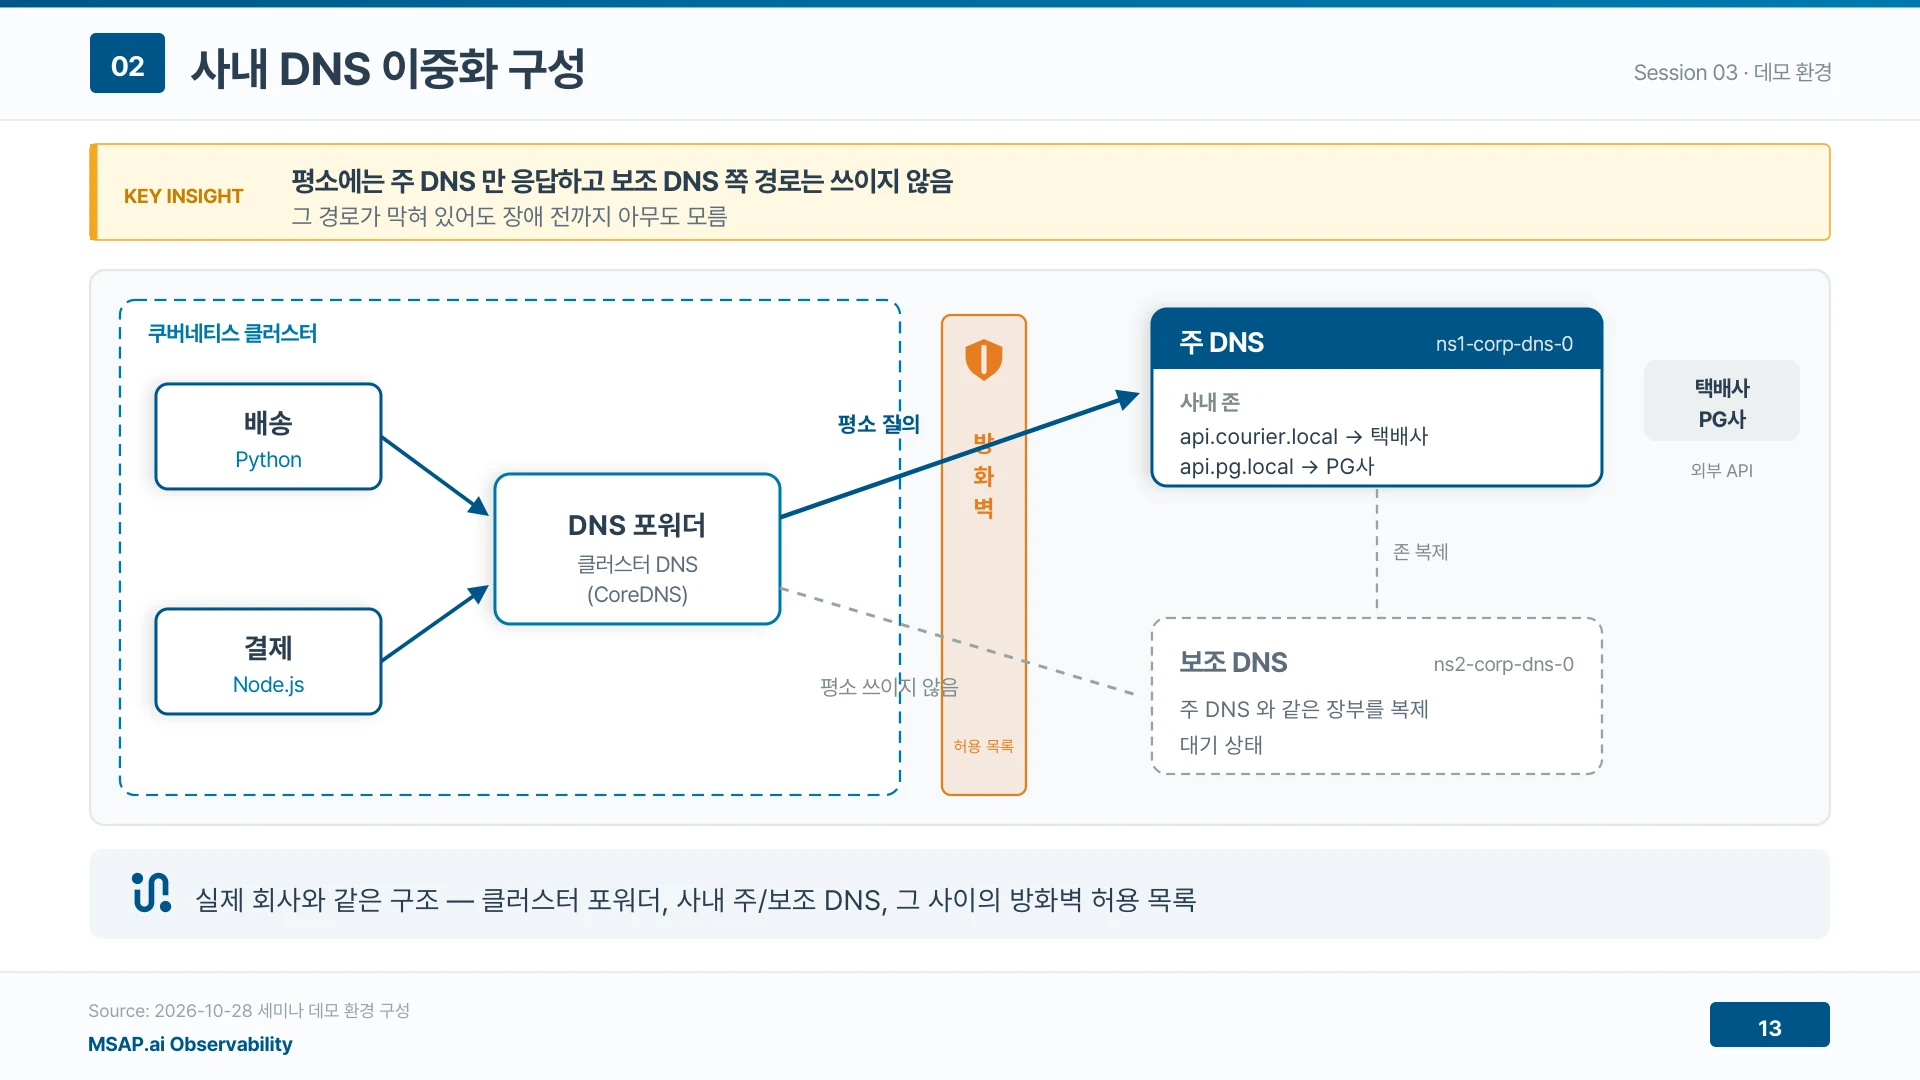
▲ 평소에는 주 DNS 만 응답하고 보조 DNS 쪽 경로는 쓰이지 않음 (발표자료 13쪽)
문제 구간은 화면에서 좁히고 이유는 인프라에서 확정한다
노드 에이전트는 DNS 질의와 응답, TCP 연결을 커널에서 수집한다. 도메인네임(DNS) 탭은 도메인별 질의 건수, 응답 코드, 응답 시간을 보여 주고, 네트워크 탭은 TCP 연결 실패와 재전송, 왕복 시간을 보여 준다.
인시던트 화면은 이슈 전파 경로와 근본 원인 분석을 보여 준다. 반대로 방화벽 규칙, DNS 응답으로 받은 IP, 사내 DNS 레코드는 화면에 없다.
서비스마다 DNS 조회 시간, 상대 서버와의 연결 시간, 왕복 시간, 재전송, 연결 실패를 앱 응답 시간과 따로 모으기 때문에 앱 처리는 정상인데 DNS 구간 때문에 느려진 경우를 구분할 수 있다. 에이전트를 둘 수 없는 CDN과 사용자 브라우저 구간은 직접 측정하지 않는다.
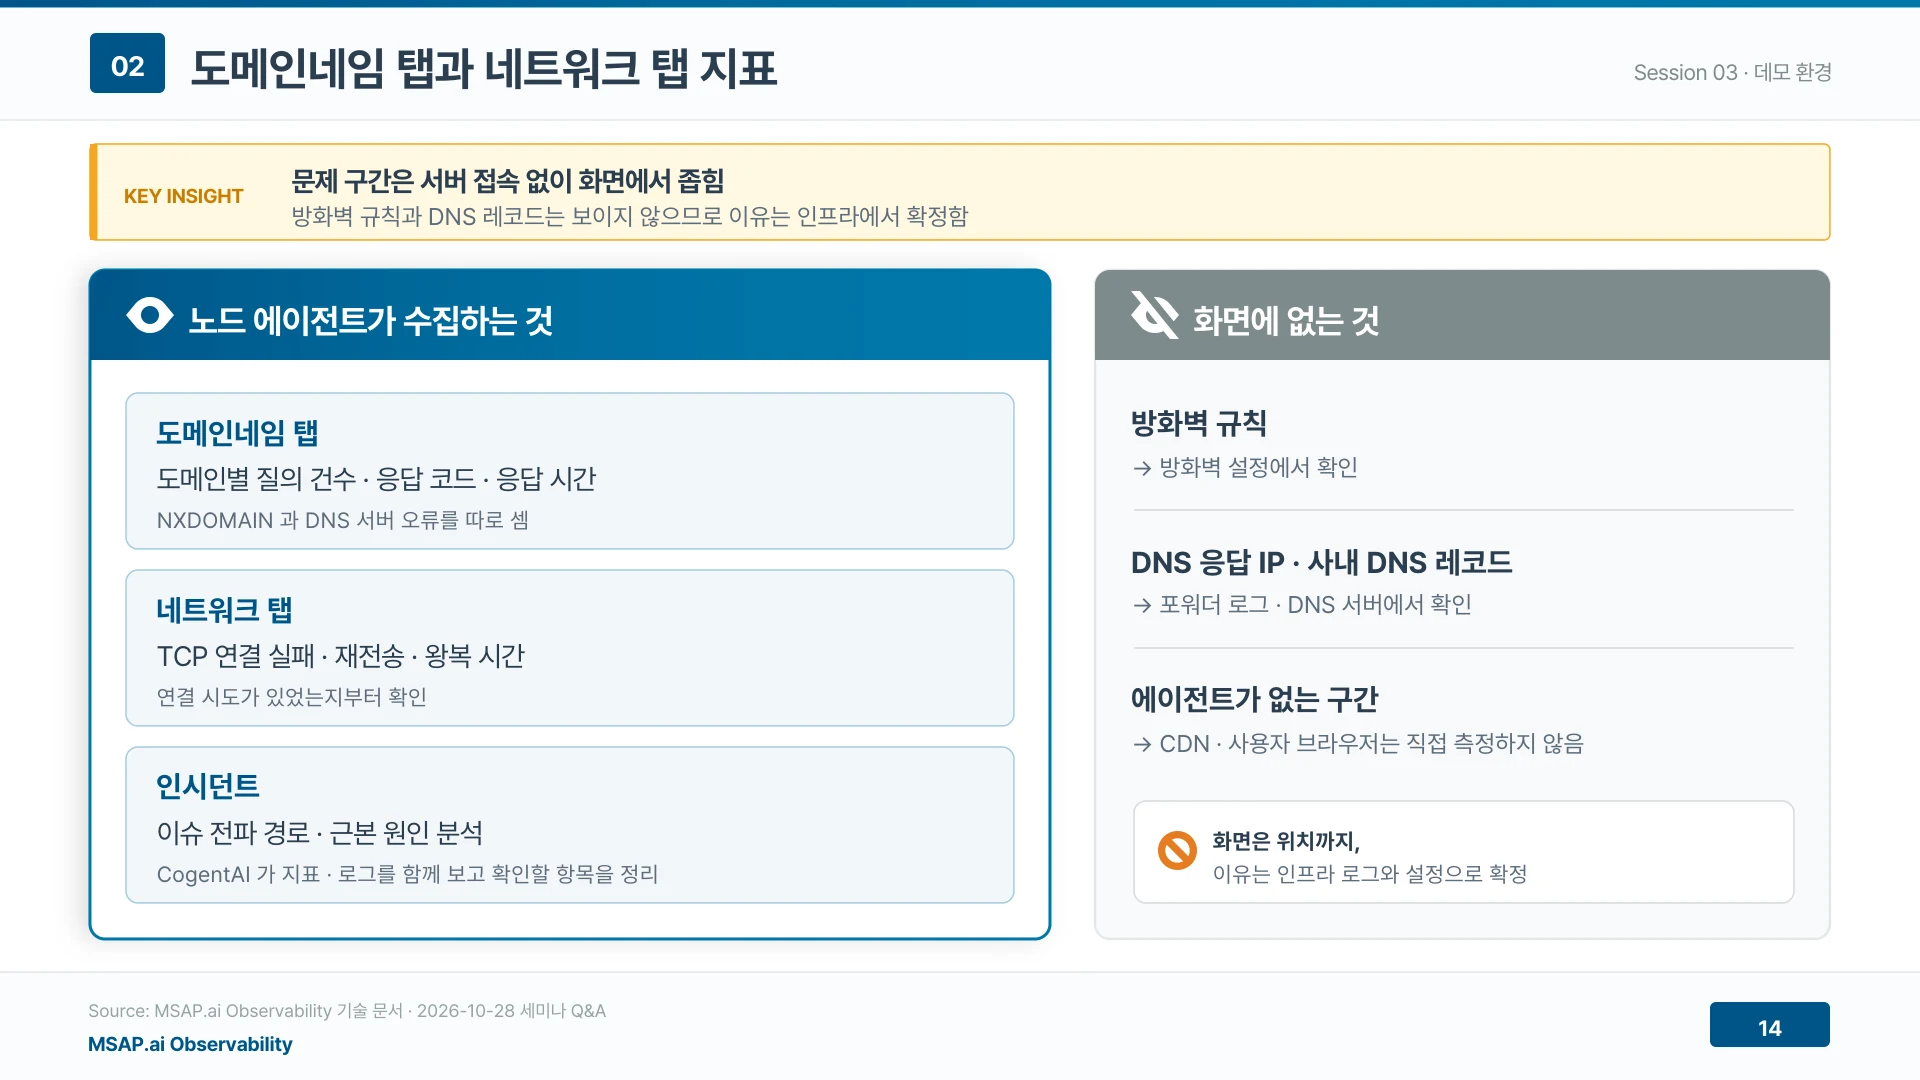
▲ 문제 구간은 서버 접속 없이 화면에서 좁힘 (발표자료 14쪽)
두 장애는 실패 속도와 응답 코드로 갈린다
시나리오 ①은 사내 주 DNS 서버 장애로 배송 조회와 결제가 약 3초 뒤에 실패하고, 단서는 응답 없음이다. 시나리오 ②는 PG사 도메인 변경으로 결제만 바로 실패하고, 단서는 NXDOMAIN이다.
두 장애 모두 앱 코드는 정상이었다.
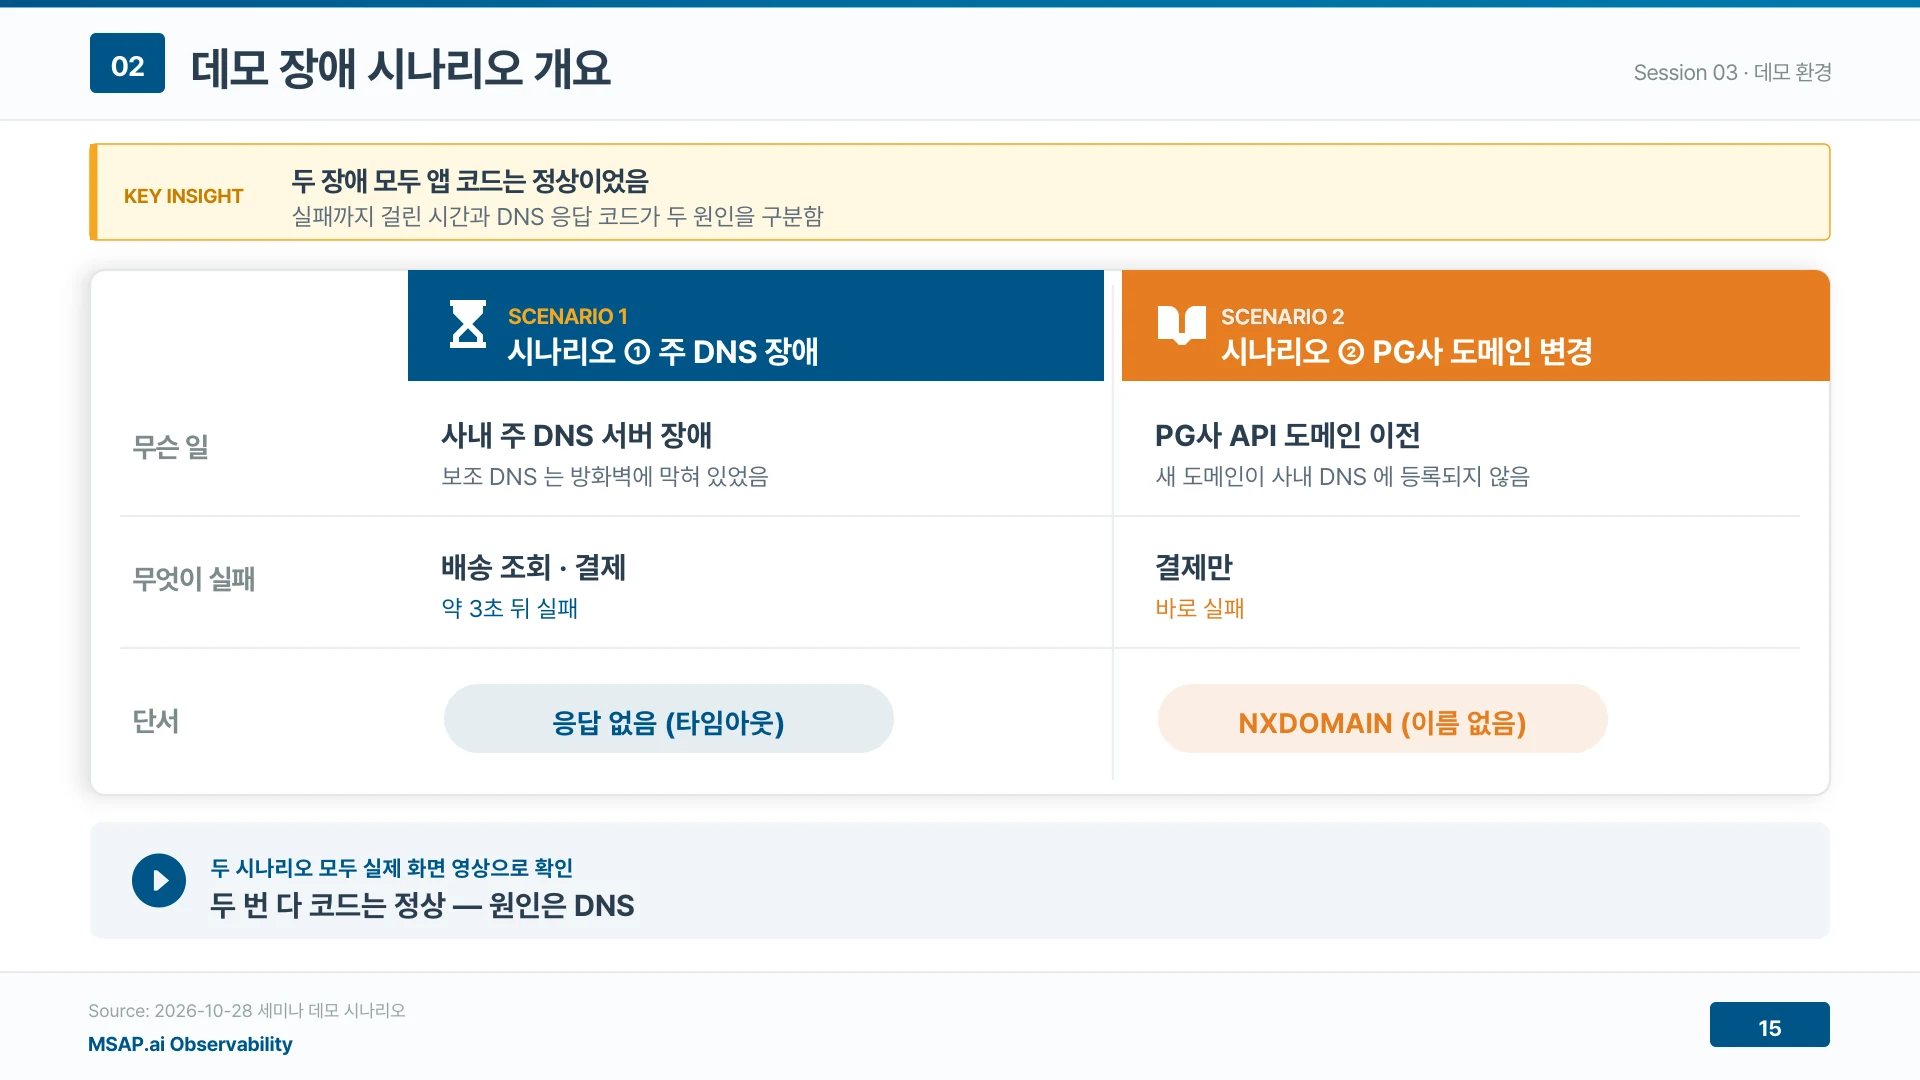
▲ 두 장애 모두 앱 코드는 정상이었음 (발표자료 15쪽)
시나리오 ① 보조 DNS는 살아 있었지만 방화벽 허용 목록에서 빠져 있었다
월요일 밤 주 DNS 서버가 멈췄고 화요일 아침 9시에 배송 조회도 결제도 안 된다는 연락이 왔다. 김대리는 보조 DNS가 있으니 DNS는 아니라고 생각했다.
보조 DNS는 살아 있었지만 방화벽 신청 때 빠져 있어서 아무도 닿지 못했다. 9시 10분에 이상 지점을 찾았고 9시 40분에 방화벽 허용 한 줄로 회복했다.
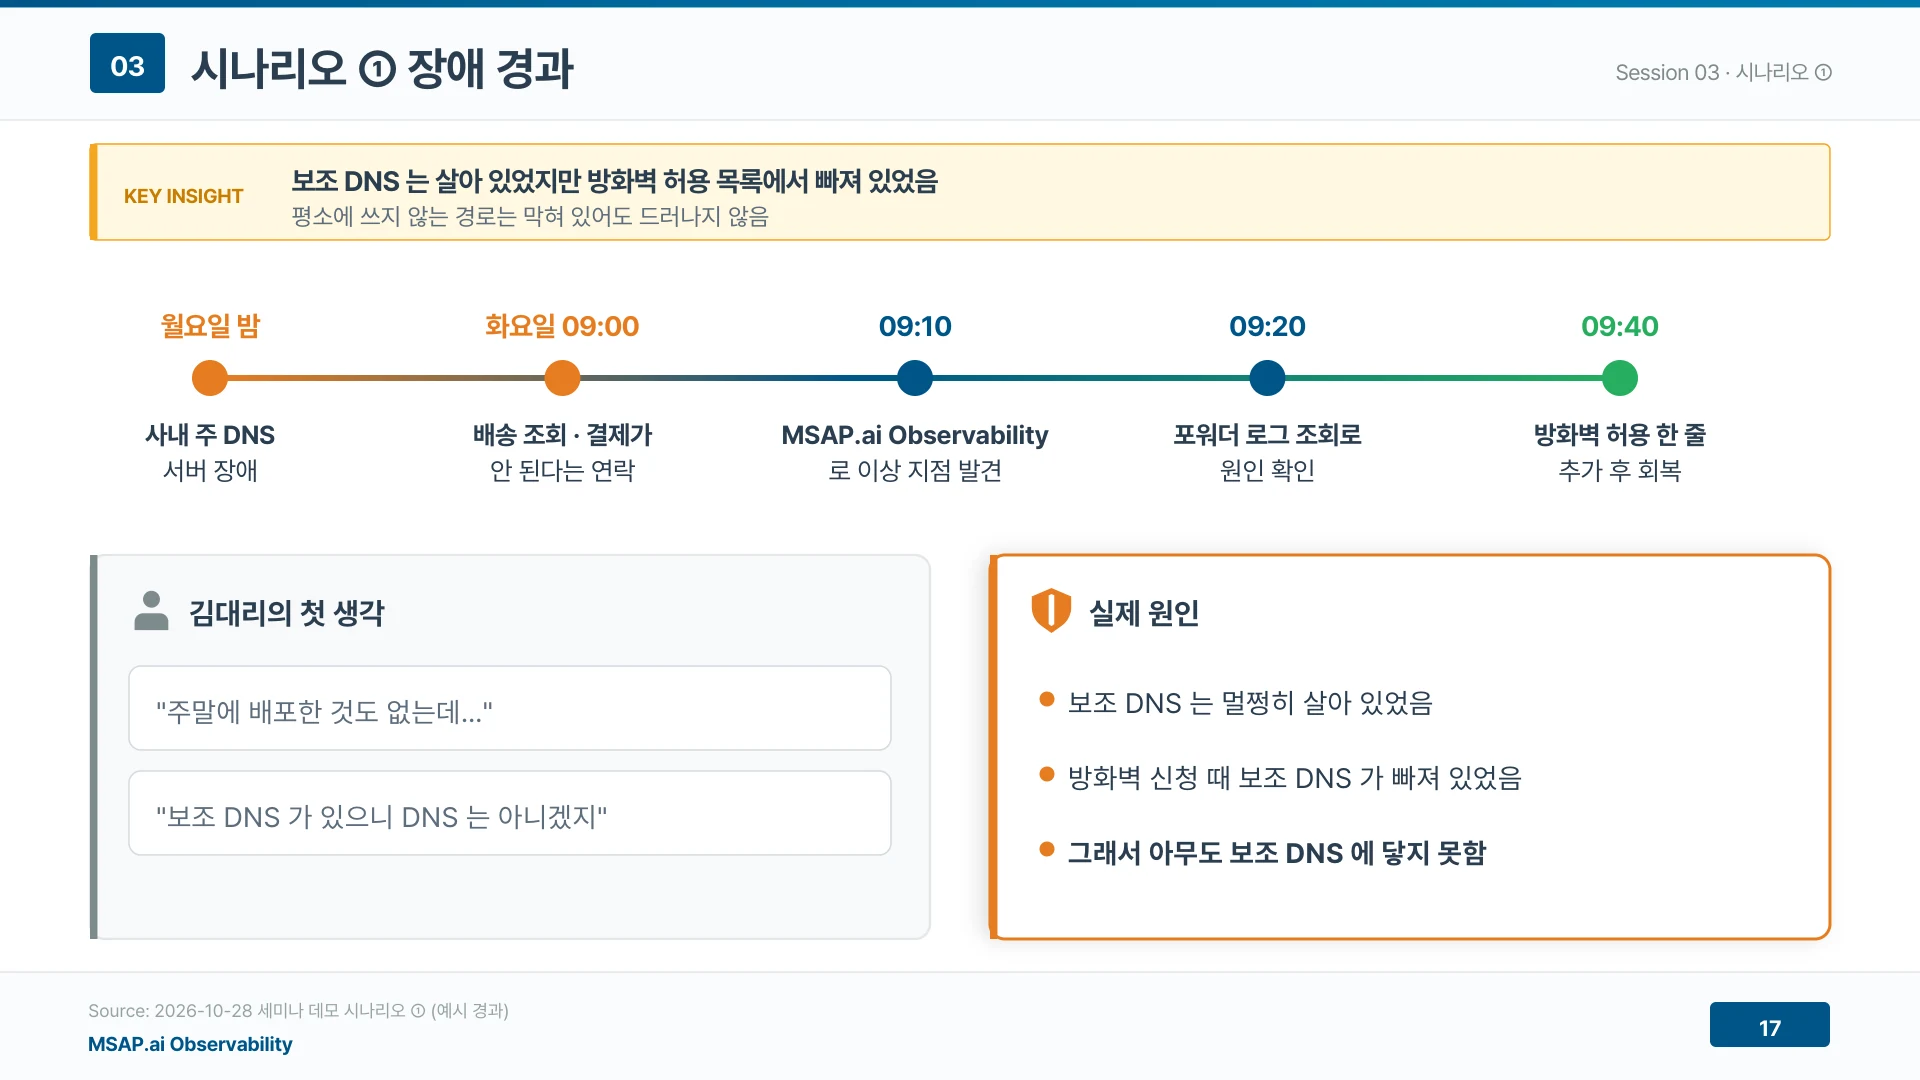
▲ 보조 DNS 는 살아 있었지만 방화벽 허용 목록에서 빠져 있었음 (발표자료 17쪽)
고장 난 길은 하나인데 영향은 두 서비스에 나타났다
데모 영상에서는 주 DNS를 내리자 배송 서비스에 인시던트가 열리고 가용성이 50% 정도까지 떨어진다. 응답 시간 히트맵의 요청이 3초 근처에 몰려 있어 기다렸다가 실패하는 모습이다.
포워더가 주 DNS에서 타임아웃을 맞고 보조 DNS로 넘어가지만 방화벽에 허용 규칙이 없어 질의가 버려진다. 포워더 로그에는 두 서버 모두 i/o timeout이 질의마다 약 2초씩 찍혔다.
같은 세미나 두 번째 세션의 데모에서도 언어가 다른 배송과 결제가 같은 외부 도메인 DNS 조회 실패로 함께 무너졌다. 원인 서비스를 끝까지 따라가면 코드가 아니라 인프라 구간에 닿는 경우가 많다.
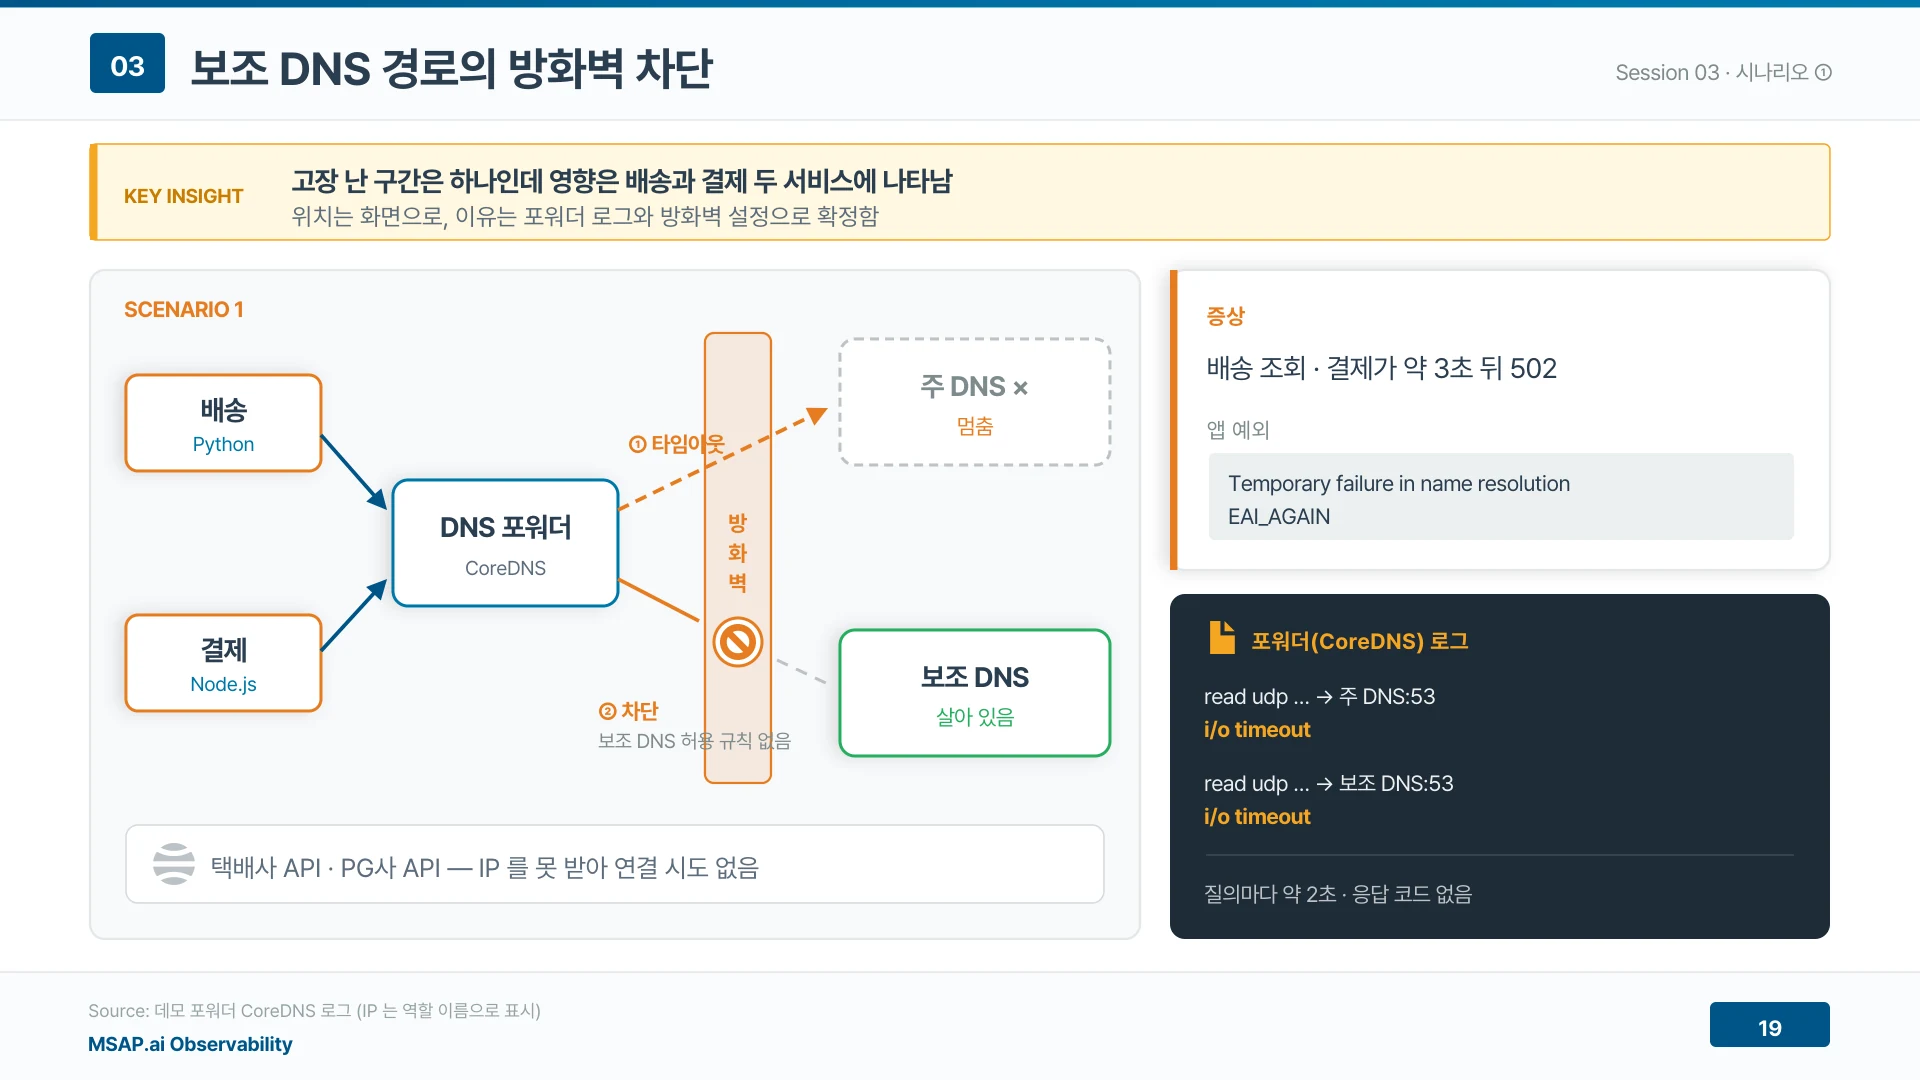
▲ 고장 난 구간은 하나인데 영향은 배송과 결제 두 서비스에 나타남 (발표자료 19쪽)
화면 세 곳에서 DNS 구간을 찾고 인프라 세 곳에서 이유를 확정했다
토폴로지와 SLO에서 배송과 결제만 약 3초 뒤 실패한다. 네트워크 탭에는 택배사와 PG사로 가는 연결이 아예 없다. 도메인네임 탭에서는 택배사 도메인 조회가 응답 없이 끝났다.
그다음 포워더 로그의 타임아웃, 보조 DNS 로그에 오지 않은 질의, 방화벽 규칙에 없는 허용 줄을 확인했다. 한 줄을 추가하자 주 DNS가 멈춘 상태에서도 서비스가 회복됐다.
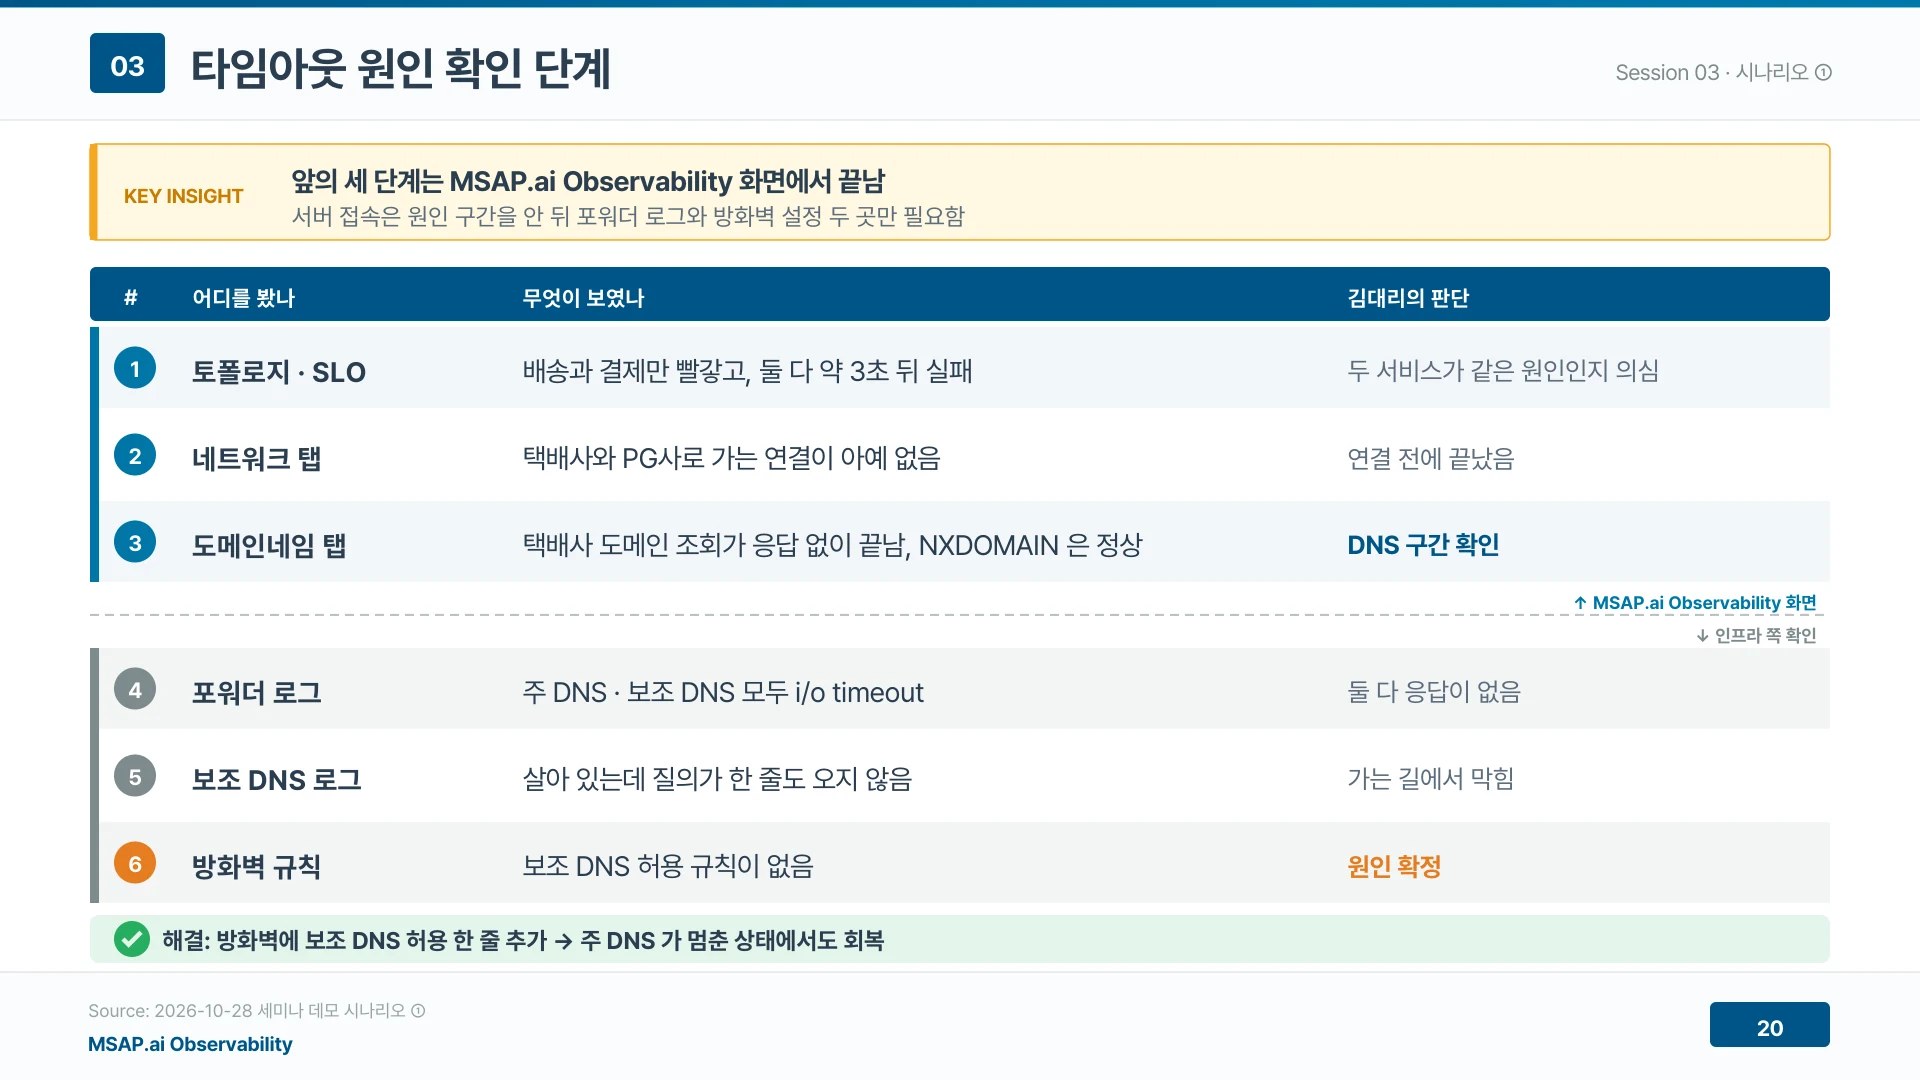
▲ 앞의 세 단계는 MSAP.ai Observability 화면에서 끝남 (발표자료 20쪽)
시나리오 ② 배포 직후 장애였지만 코드는 정상이었다
PG사의 도메인 이전 공지에 따라 김대리가 새 도메인 api.pg-new.local로 배포하자 결제가 전부 실패했다. 방금 배포했으니 롤백부터 고민하기 쉽다.
원인은 새 도메인이 사내 DNS에 등록되지 않은 것이었다. 응답 코드를 먼저 보면 불필요한 롤백을 피한다.
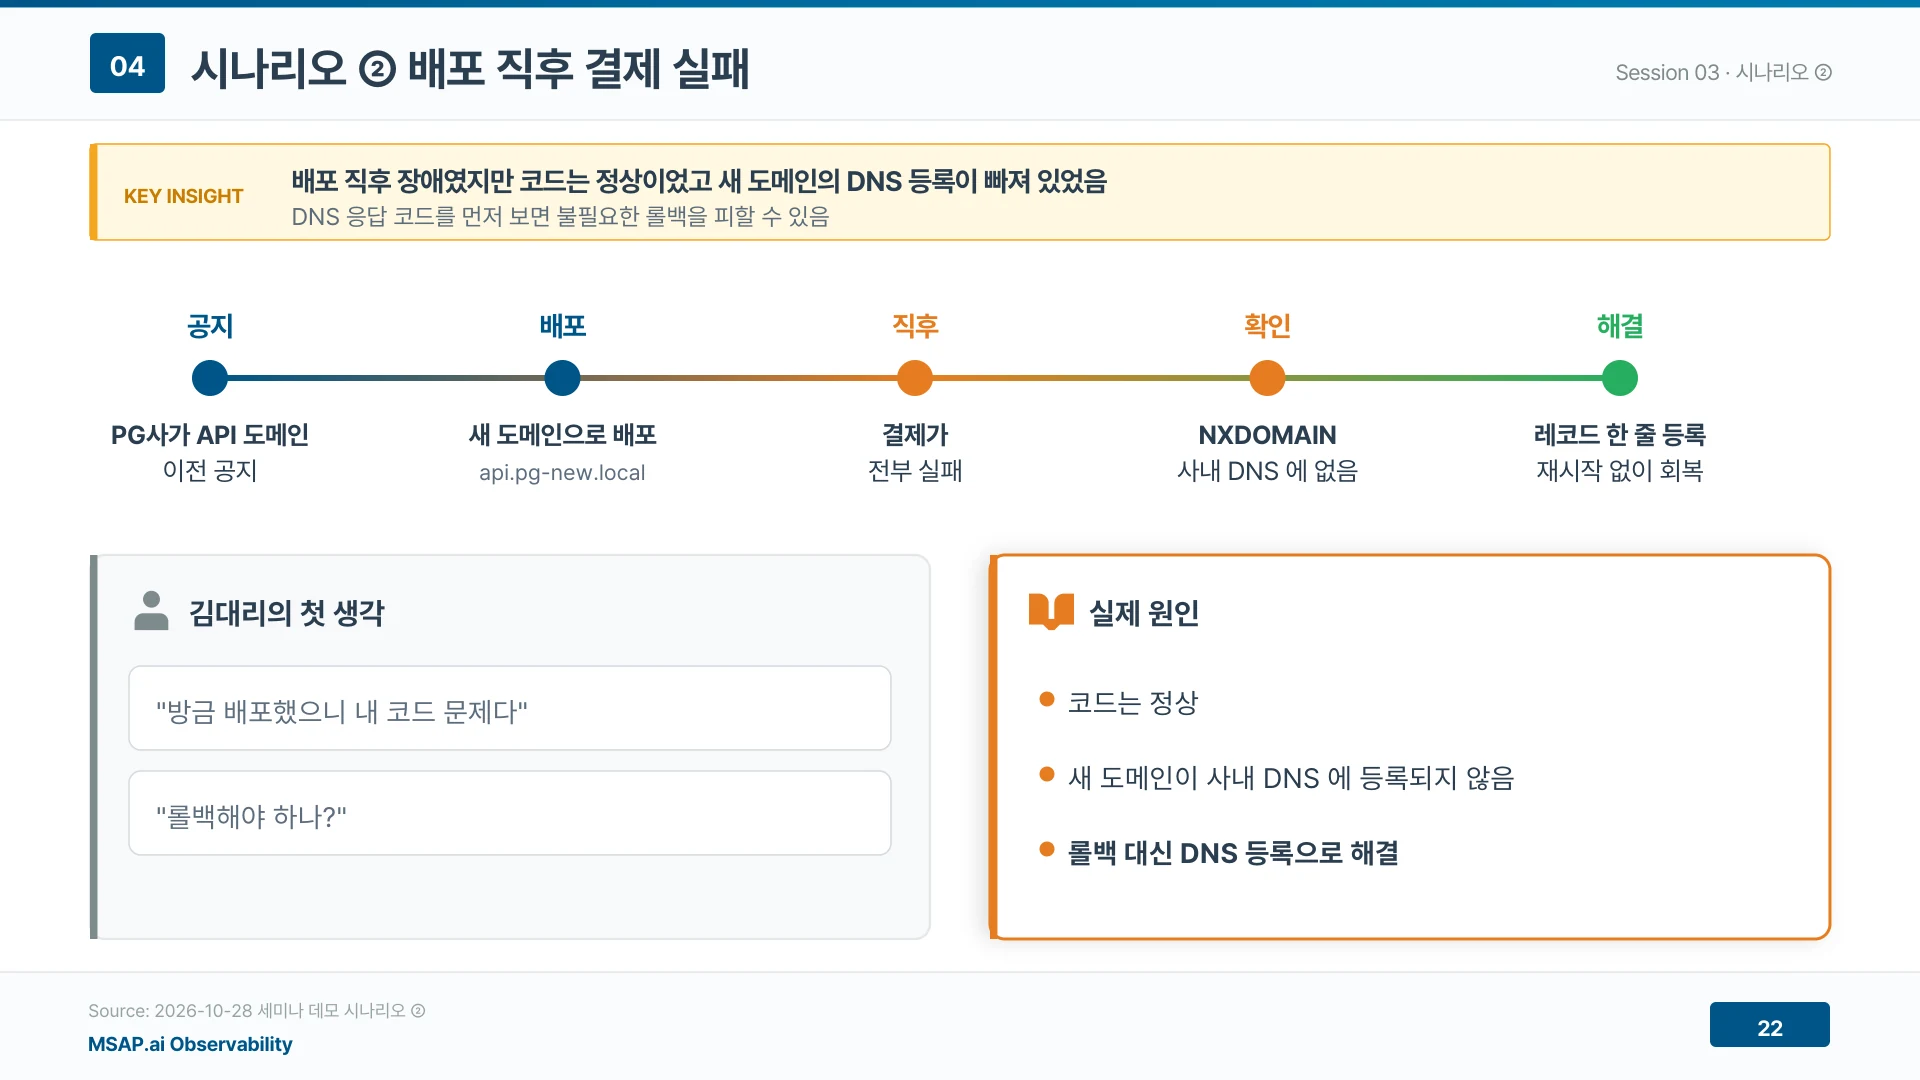
▲ 배포 직후 장애였지만 코드는 정상이었고 새 도메인의 DNS 등록이 빠져 있었음 (발표자료 22쪽)
NXDOMAIN은 확정 응답이라 보조 DNS로 넘어가지 않는다
데모 영상에서 결제 서비스 가용성은 27%까지 떨어지지만 응답 시간 SLO는 100% 정상이다. 느려진 것이 아니라 바로 실패한다는 뜻이다. 도메인네임 탭에는 새 도메인을 약 75,000번 물어 A와 AAAA 모두 NXDOMAIN을 받은 기록이 쌓인다.
주 DNS가 이름이 없다는 답을 바로 돌려주므로 결제만 약 100ms 만에 실패하고 배송 조회는 정상이다. 포워더 로그의 NXDOMAIN은 0.5ms 이내에 돌아왔다.
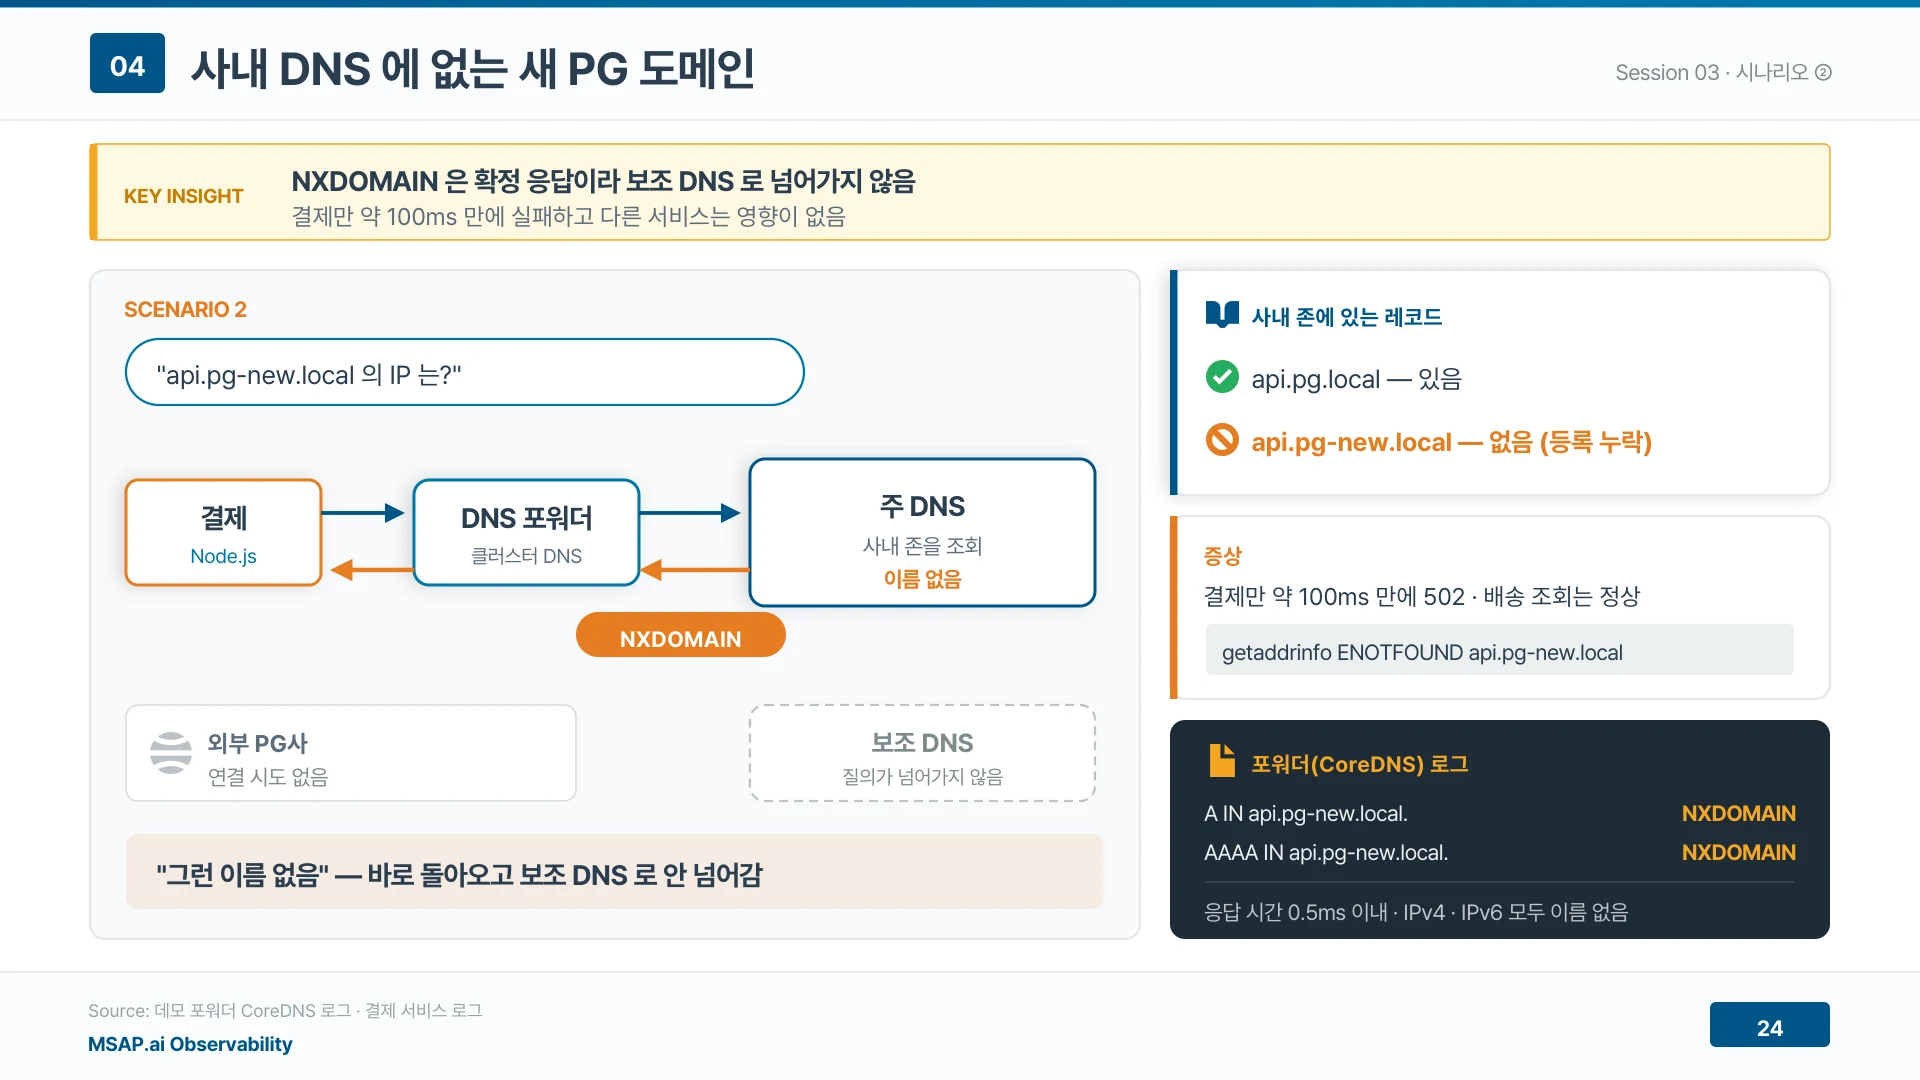
▲ NXDOMAIN 은 확정 응답이라 보조 DNS 로 넘어가지 않음 (발표자료 24쪽)
찾는 순서는 같고 단계마다 보이는 값이 다르다
토폴로지에서 결제만 빨갛고 실패가 즉시다. 네트워크 탭에는 PG사로 가는 연결이 없고, 도메인네임 탭에는 api.pg-new.local의 NXDOMAIN이 쌓인다.
결제 서비스 로그의 getaddrinfo ENOTFOUND와 사내 DNS 레코드에 새 이름이 없는 것을 확인해 원인을 확정한다. 레코드 한 줄 등록으로 롤백 없이 회복했다.
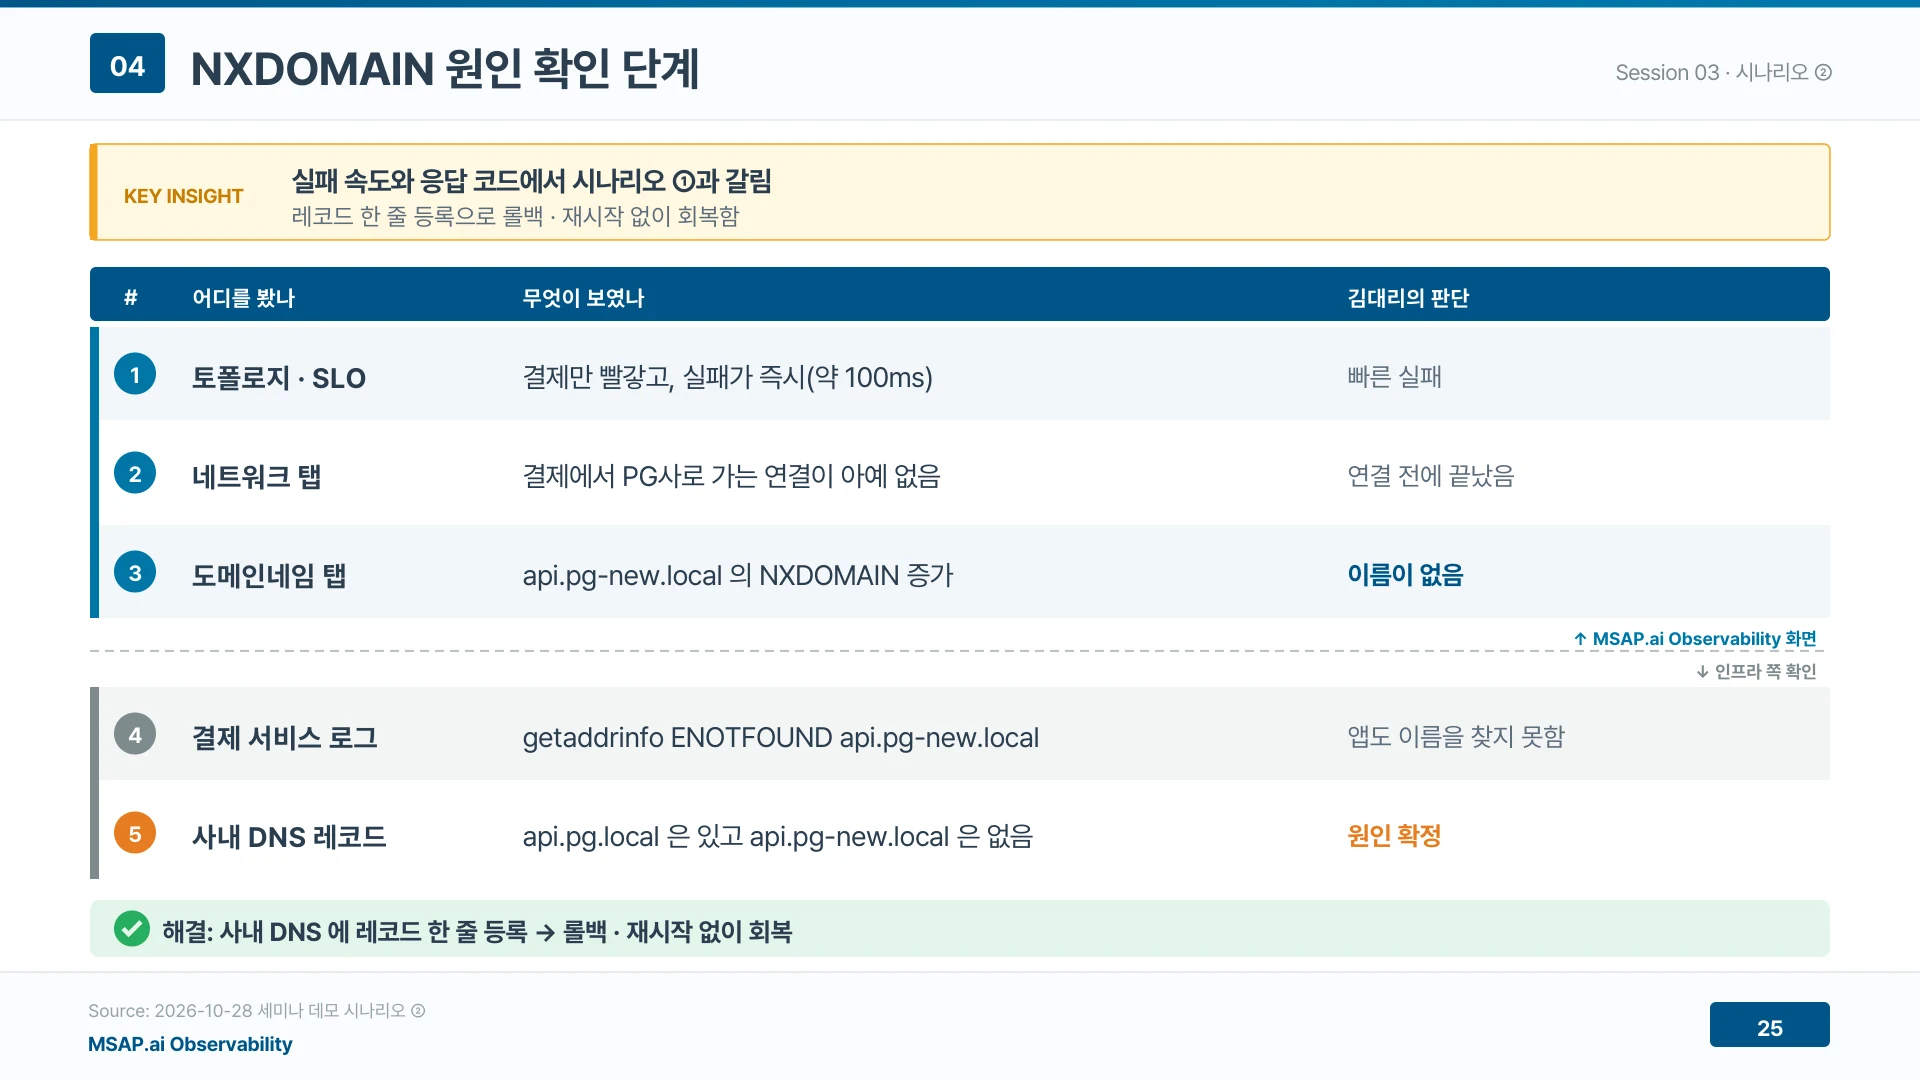
▲ 실패 속도와 응답 코드에서 시나리오 ①과 갈림 (발표자료 25쪽)
등록 직후의 실패를 등록 실패로 단정하지 않는다
쿠버네티스 기본 Corefile은 cache 30이라 부정 응답도 최대 30초 캐시되고, Java 앱은 실패한 조회를 기본 10초 동안 캐시한다. 권한 DNS 서버의 부정 응답 캐시 시간은 SOA 값이 정한다. 리졸버와 클라이언트가 TTL이 끝날 때까지 캐시된 답을 쓰기 때문에, 레코드를 고쳐도 반영은 캐시 사슬을 따라 늦게 퍼진다.
캐시 시간이 지난 뒤 도메인네임 탭에서 새 도메인의 NXDOMAIN 건수가 줄어드는지 확인한다.
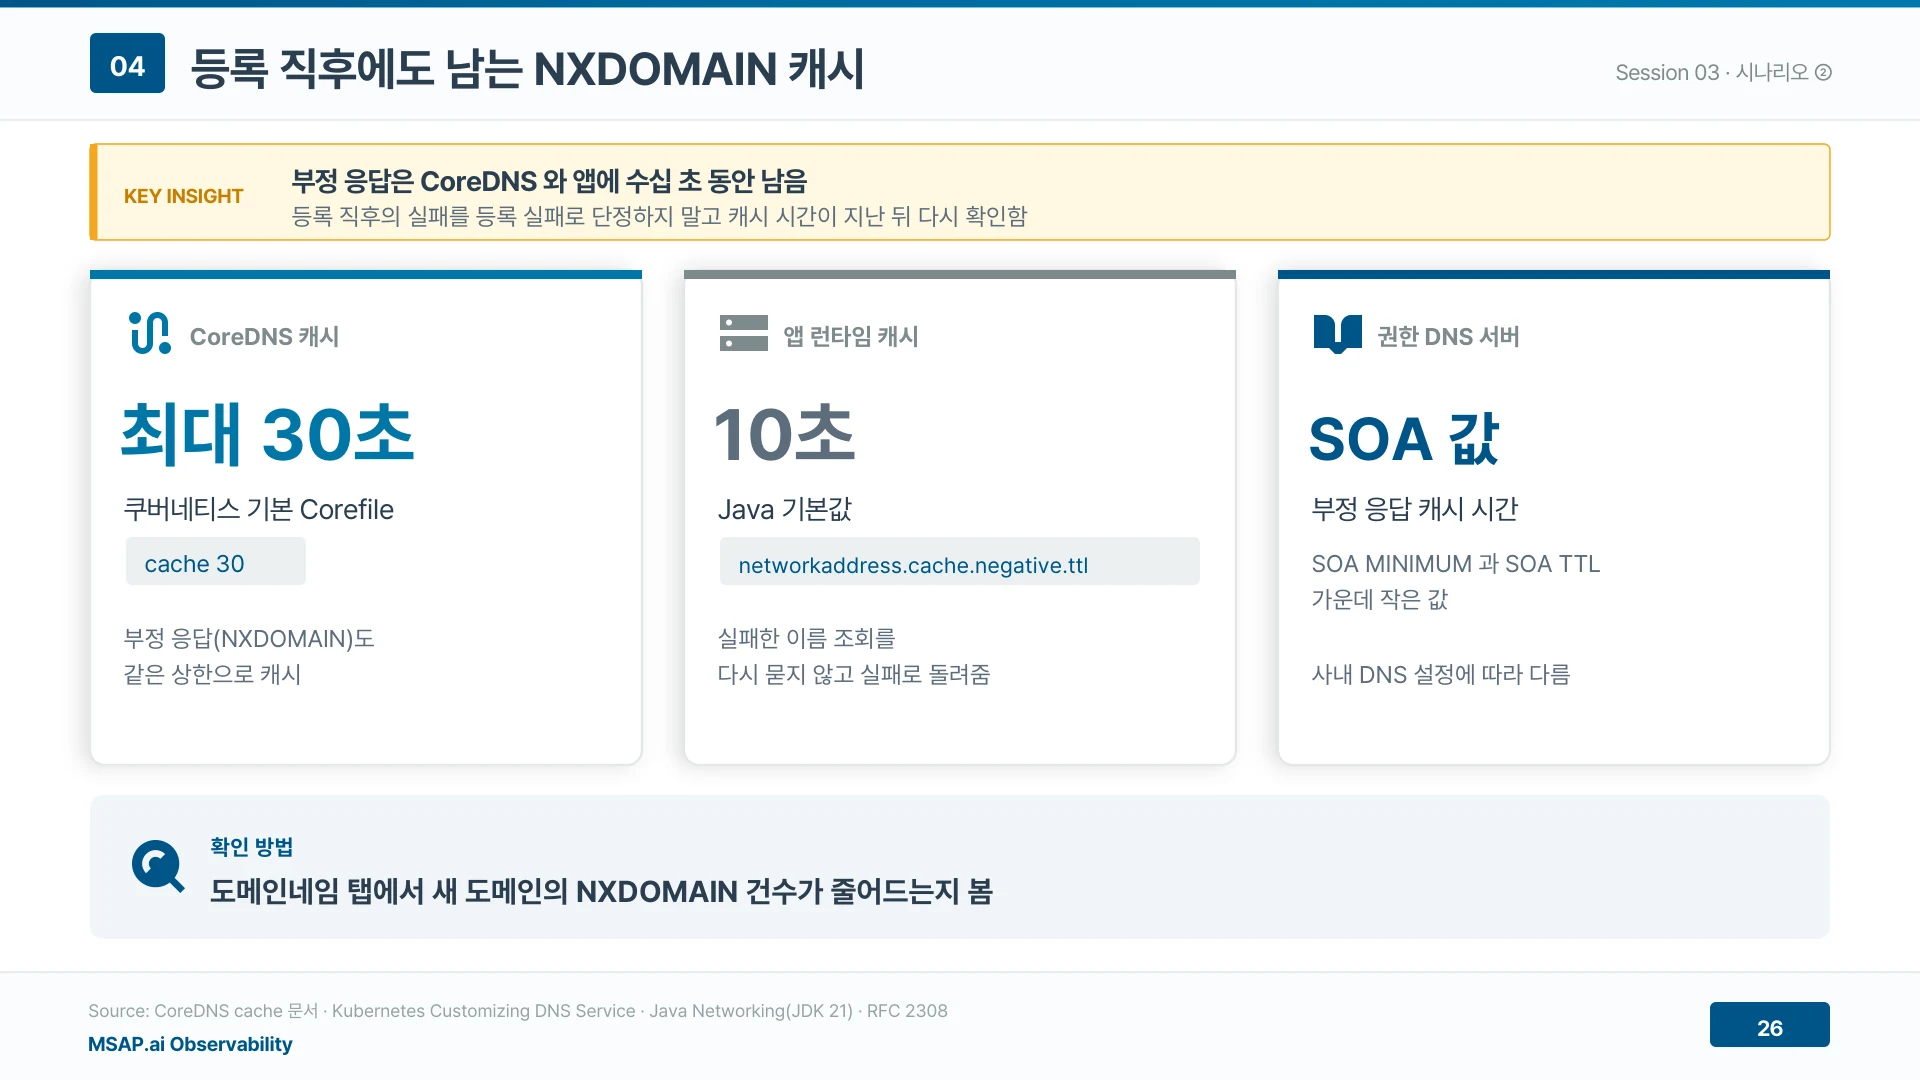
▲ 부정 응답은 CoreDNS 와 앱에 수십 초 동안 남음 (발표자료 26쪽)
느리면 응답 없는 DNS, 빠르면 이름 없는 DNS를 먼저 의심한다
| 항목 | 시나리오 ① 주 DNS 장애와 방화벽 | 시나리오 ② 이름 등록 누락 |
|---|---|---|
| DNS 응답 | 없음 (타임아웃) | NXDOMAIN |
| 실패 속도 | 약 3초 | 약 100ms |
| 영향 범위 | 배송 · 결제 | 결제만 |
| 결정적 단서 | 포워더 로그의 실패한 두 서버 | 도메인네임 탭의 NXDOMAIN |
| 해결 | 방화벽에 보조 DNS 허용 | 사내 DNS에 레코드 등록 |
판별할 때는 실패까지 걸린 시간과 DNS 응답 코드를 함께 본다.
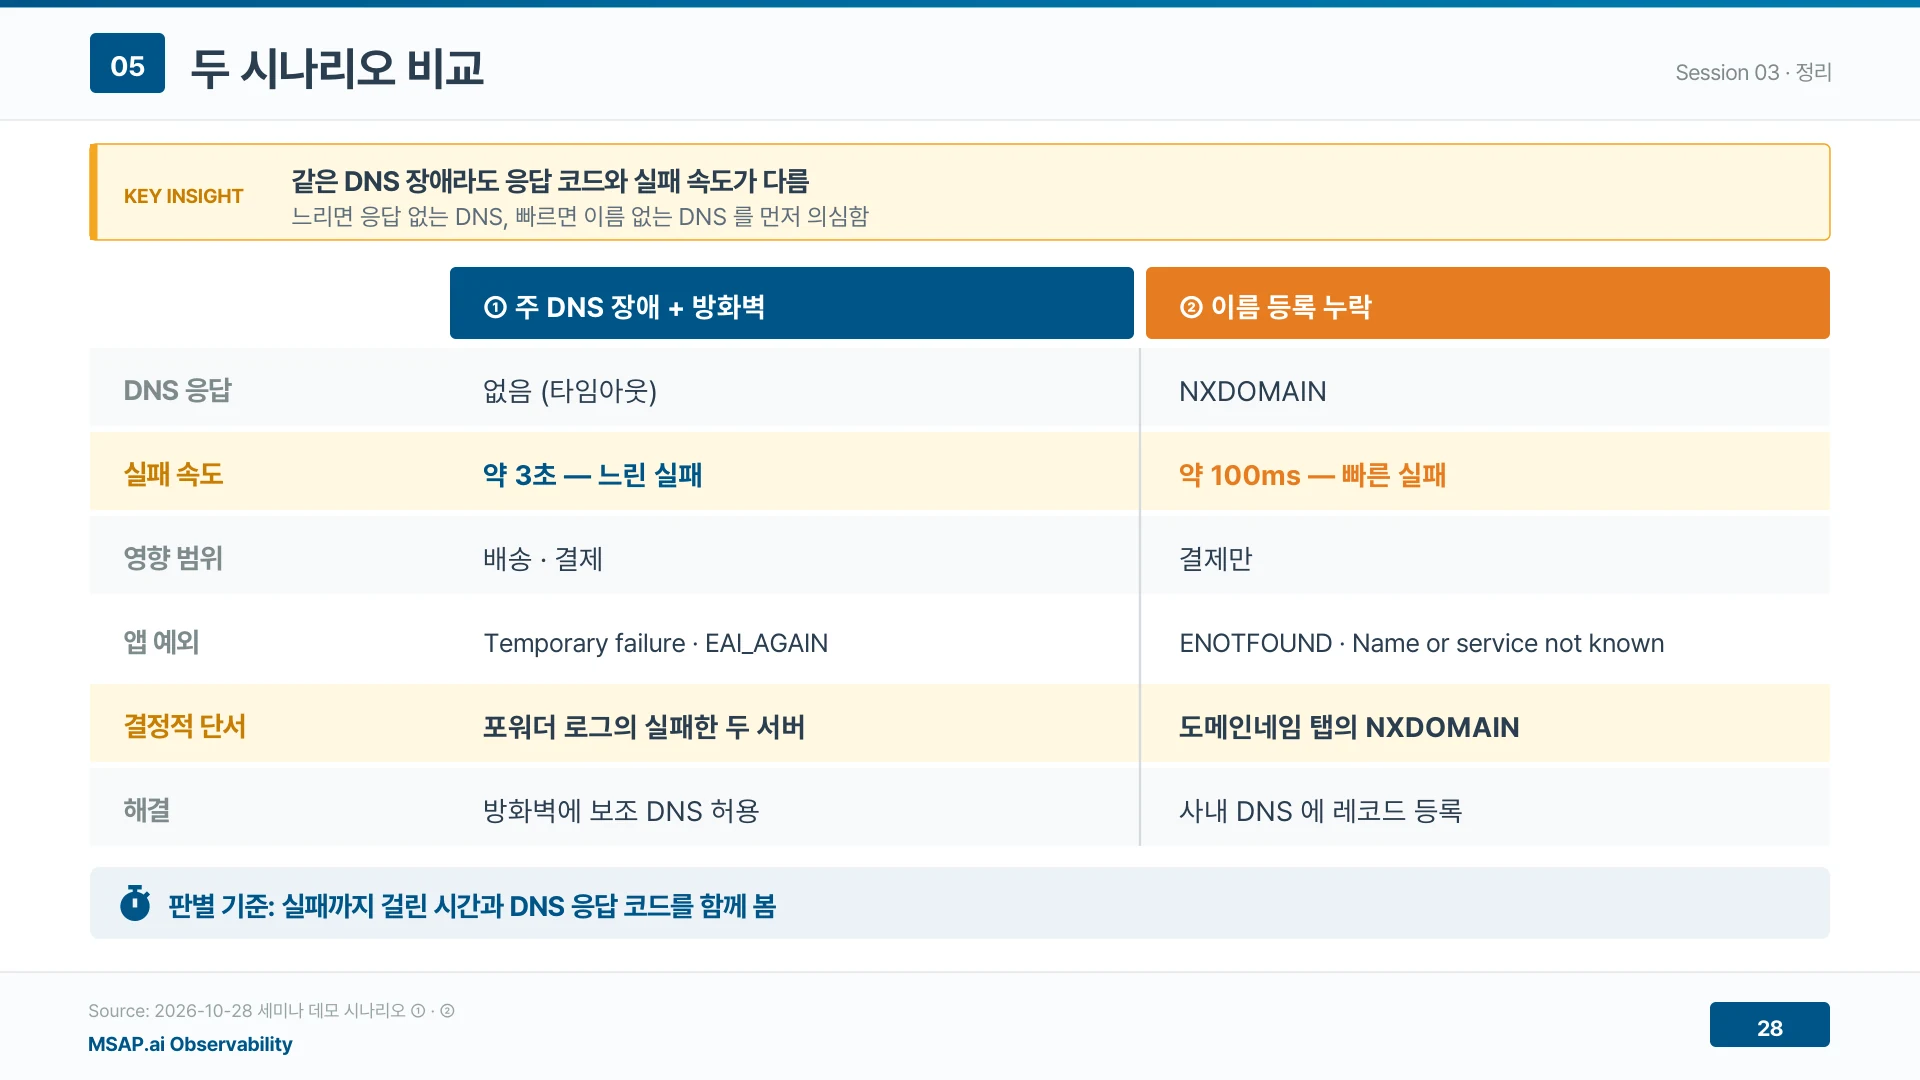
▲ 같은 DNS 장애라도 응답 코드와 실패 속도가 다름 (발표자료 28쪽)
여러 팀과 도구를 오가던 원인 구간 좁히기가 한 화면에서 끝난다
관측 도구가 없다면 로그의 타임아웃 한 줄로 시작해 노드에서 tcpdump를 뜨고, 영향 범위는 팀마다 물어야 한다.
MSAP.ai Observability를 쓰면 토폴로지에서 오류와 영향 범위를, 도메인네임 탭에서 응답 코드와 응답 시간을 바로 본다. 계측하지 않은 서비스도 같은 화면에 나타난다.
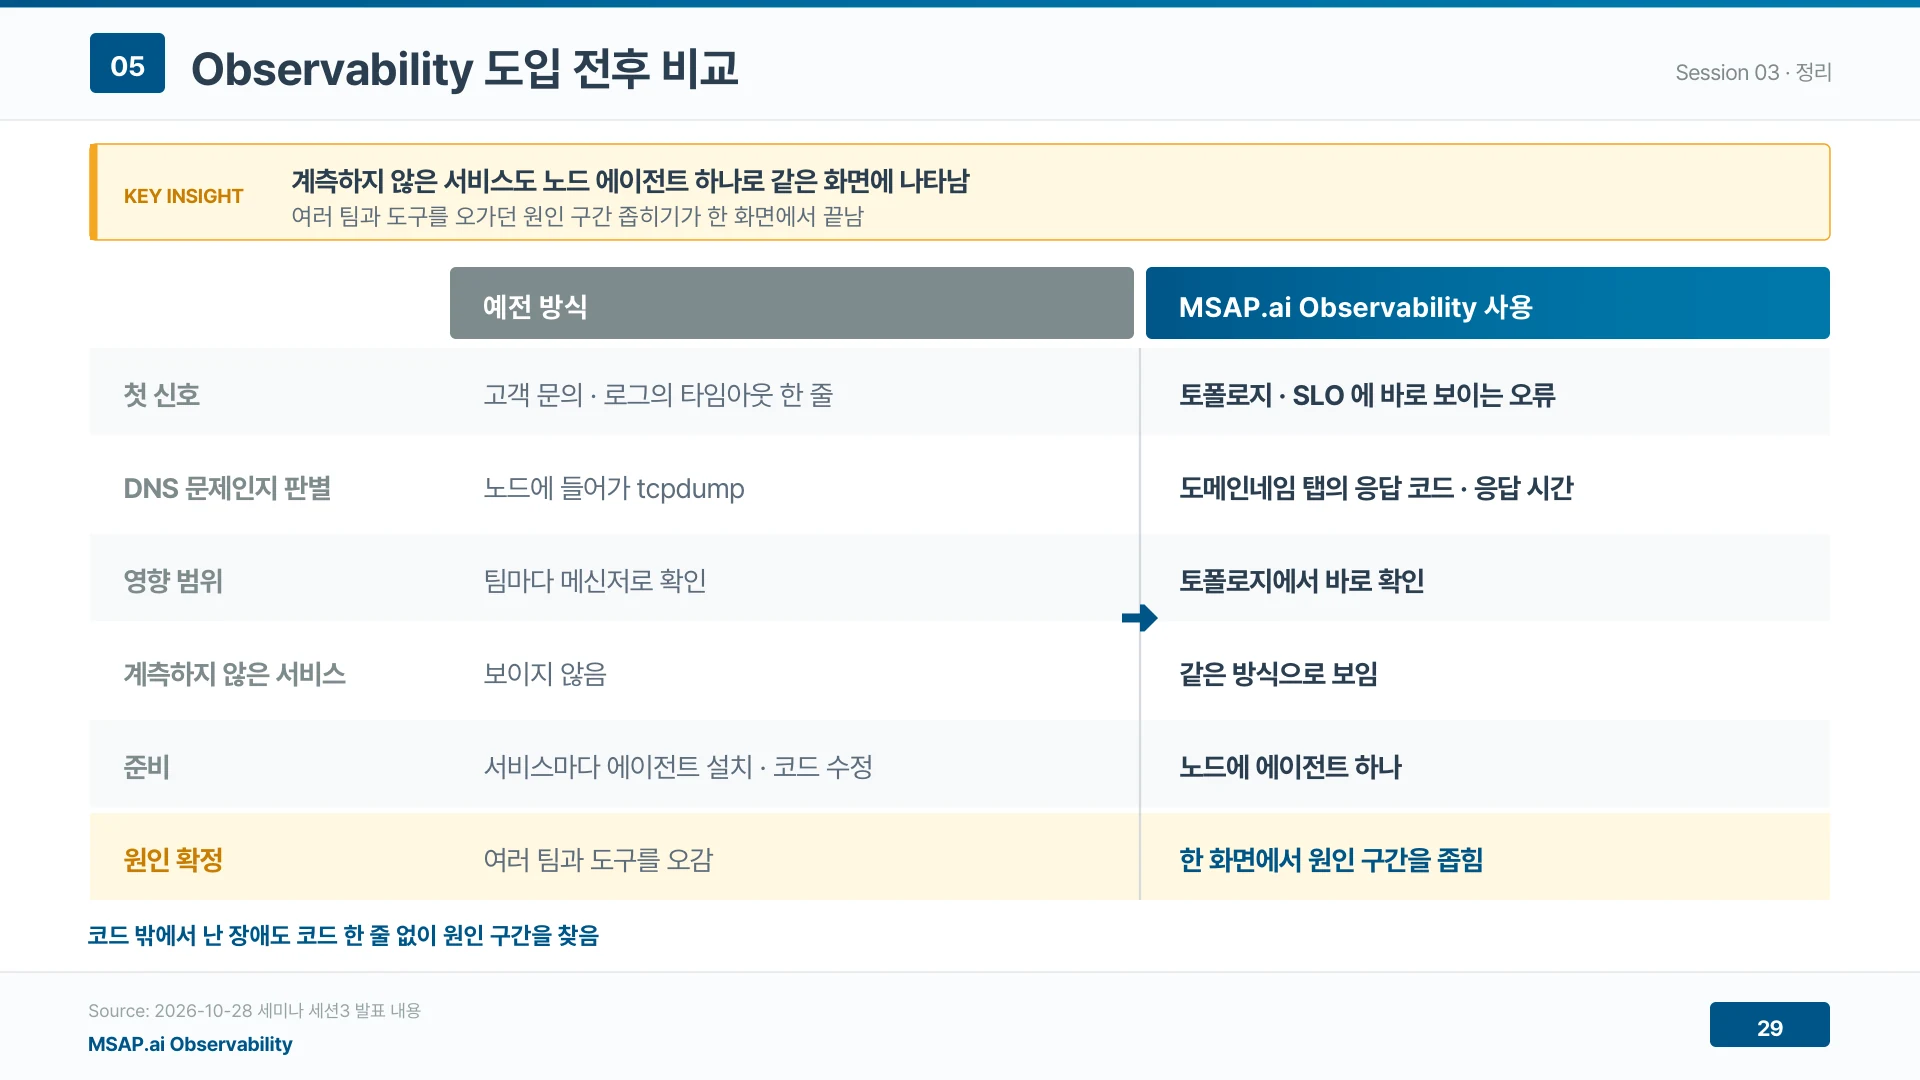
▲ 계측하지 않은 서비스도 노드 에이전트 하나로 같은 화면에 나타남 (발표자료 29쪽)
넓게, 빠르기, 연결, 이름, 확정 순서로 점검한다
넓게는 몇 개 서비스가 실패하는지, 빠르기는 바로 실패인지 몇 초 뒤인지, 연결은 시도조차 없는지, 이름은 도메인네임 탭의 응답 코드가 무엇인지 본다.
마지막 확정만 인프라 로그와 설정에서 한다. 서버 접속은 원인 구간을 안 뒤 필요한 곳에만 하면 된다. 클러스터 안 서비스라면 FQDN 조회는 실패하는데 ClusterIP 직접 호출은 성공하는지만 봐도 DNS 계층인지 가를 수 있다.
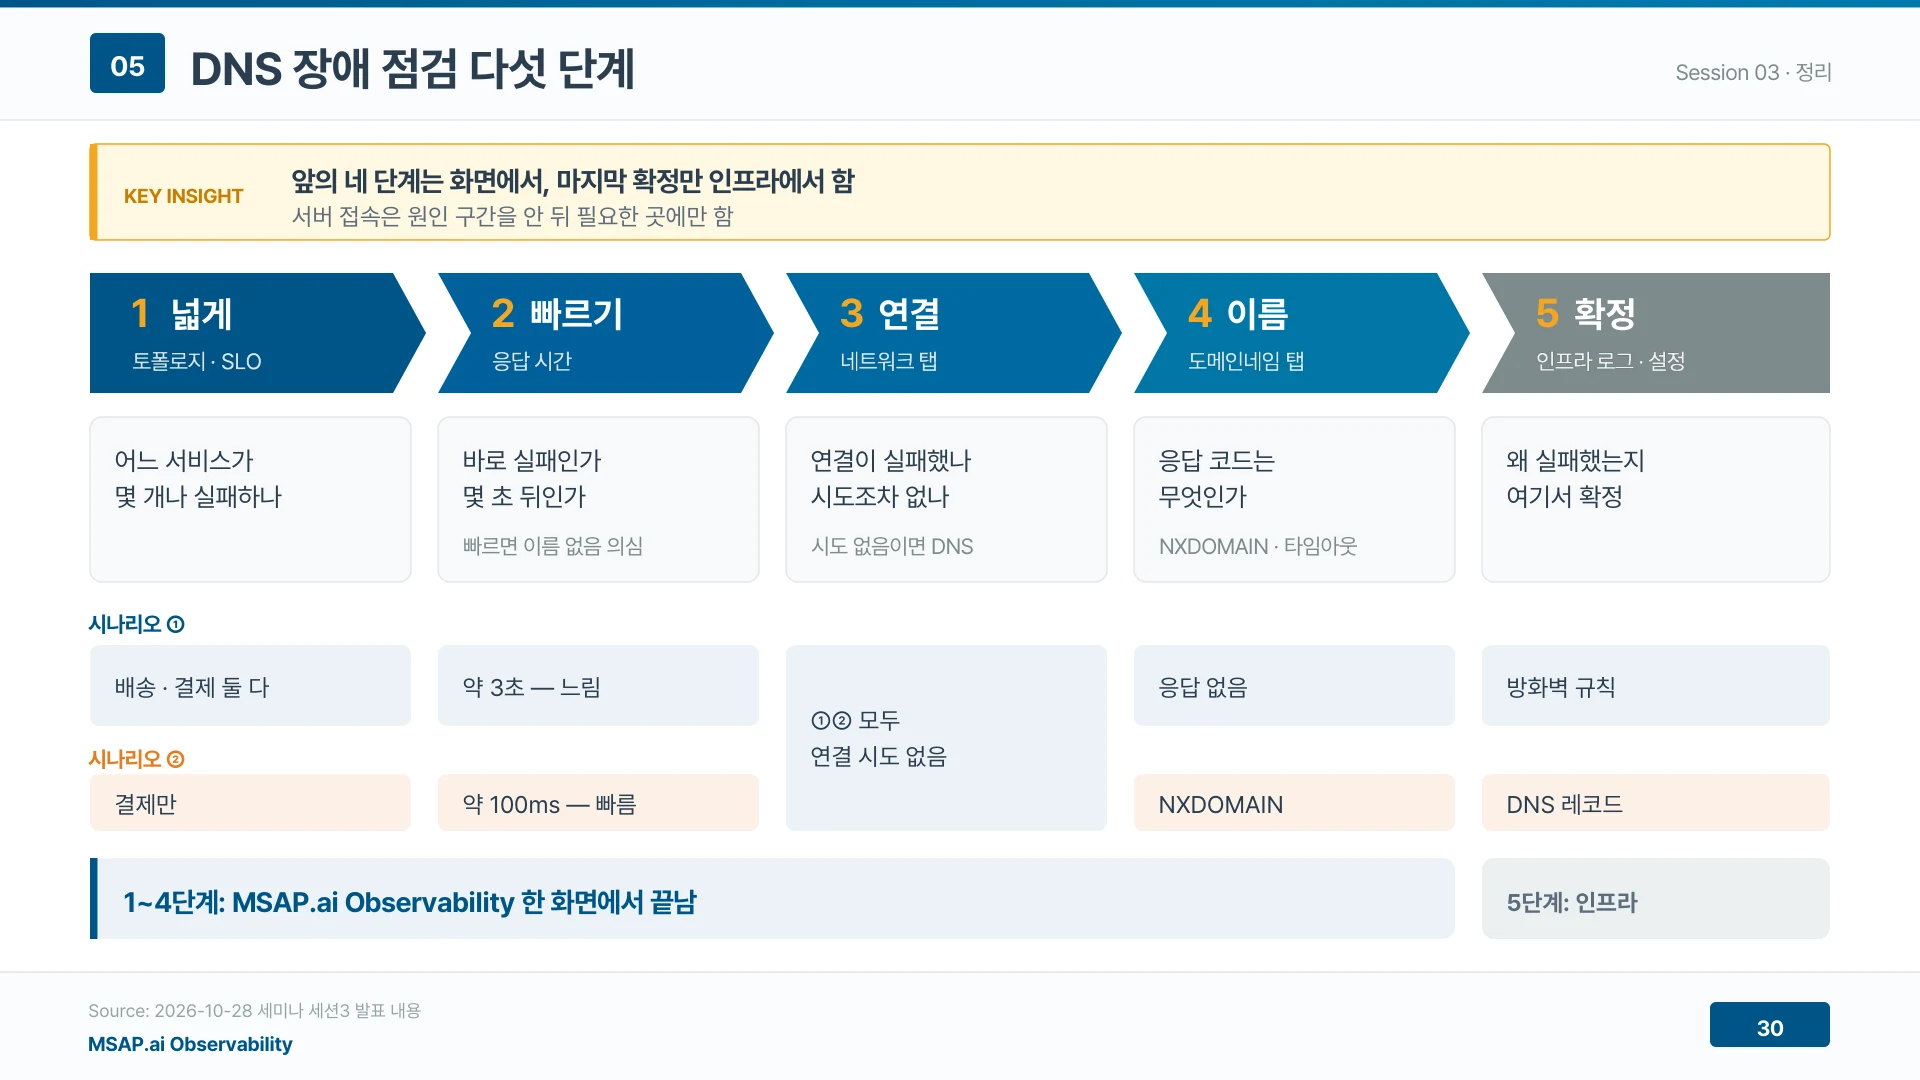
▲ 앞의 네 단계는 화면에서, 마지막 확정만 인프라에서 함 (발표자료 30쪽)
쓰지 않는 경로와 빠진 등록은 평소 점검으로 미리 찾는다
보조 DNS에 실제로 질의를 보내 응답을 확인하고 방화벽 신청서에 주 DNS와 보조 DNS를 함께 적는다. 외부 도메인 변경은 배포 체크리스트에 넣고, 타임아웃 값을 적어 두고, DNS 응답 시간과 NXDOMAIN 알림을 켠다.
2021년 10월 Meta 장애에서는 DNS 서버가 동작했지만 경로가 사라져 닿을 수 없었고, 2025년 10월 AWS us-east-1 장애에서는 빈 DNS 레코드 때문에 접속이 시작되지 않았다.
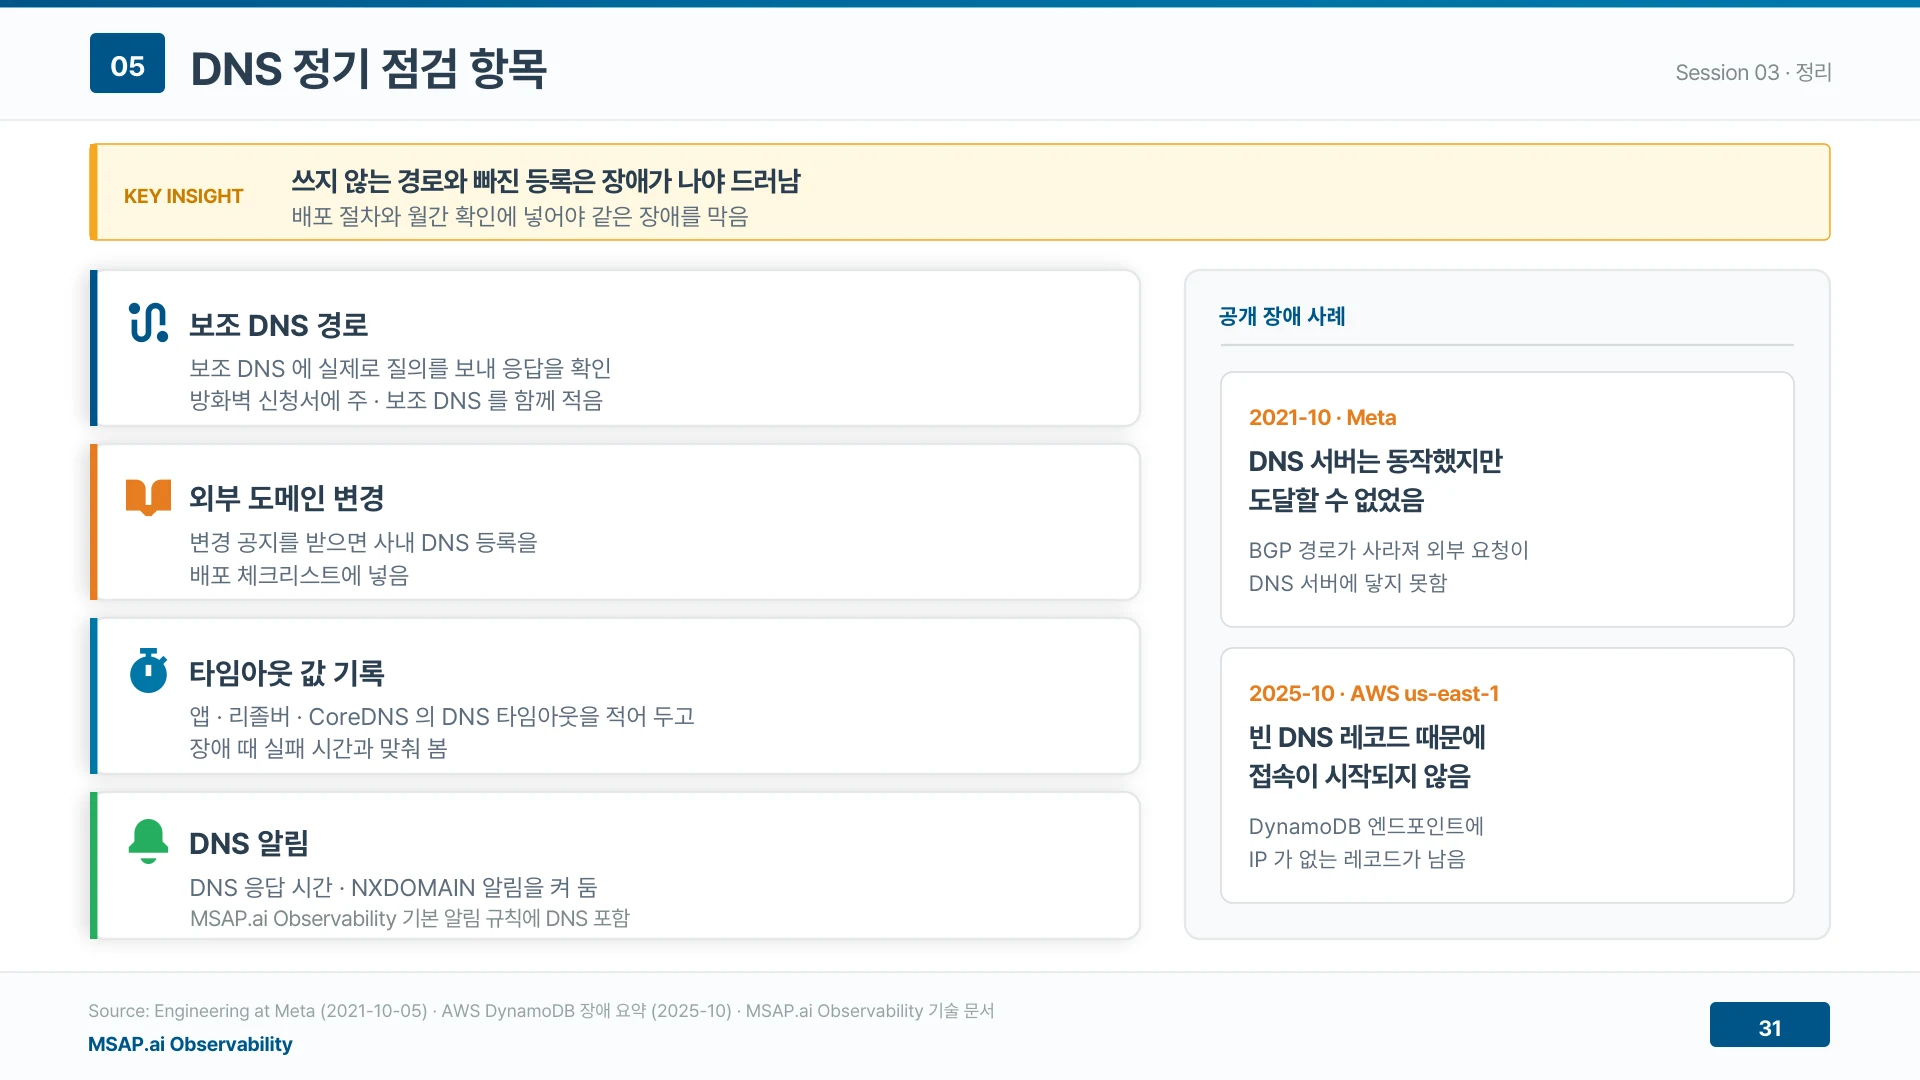
▲ 쓰지 않는 경로와 빠진 등록은 장애가 나야 드러남 (발표자료 31쪽)
핵심 정리
두 DNS 장애 모두 김대리의 코드는 정상이었다. 그 통신도 커널을 지나가므로 노드 에이전트 하나로 코드 수정 없이 관측된다.
느리게 실패하면 응답 없는 DNS, 빠르게 실패하면 이름 없는 DNS, 연결 시도조차 없으면 DNS부터 확인한다.
자주 묻는 질문
DNS 장애인지 어떻게 먼저 판별하는가
네트워크 탭에서 외부로 가는 연결 시도가 있었는지 본다. 연결 기록이 아예 없다면 DNS를 먼저 의심한다.
NXDOMAIN과 DNS 타임아웃은 무엇이 다른가
NXDOMAIN은 이름이 없다는 확정 응답이라 몇 밀리초 만에 실패한다. 타임아웃은 대답이 없어 몇 초 뒤에 실패한다.
보조 DNS가 있는데 왜 장애가 났는가
보조 DNS로 가는 경로가 방화벽에서 막혀 있었다. 평소에 쓰지 않는 경로라 장애 전까지 드러나지 않았다.
NXDOMAIN이 많으면 모두 장애인가
아니다. ndots:5 설정 때문에 search 도메인을 붙인 질의가 NXDOMAIN을 받는 것은 정상이다.
도메인을 등록했는데도 잠시 실패하는 이유는 무엇인가
부정 응답 캐시 때문이다. CoreDNS 기본 설정은 최대 30초, Java는 기본 10초 동안 실패를 기억한다.
MSAP.ai Observability 화면에서 보이지 않는 것은 무엇인가
방화벽 규칙, DNS 응답 IP, 사내 DNS 레코드다. 이유는 포워더 로그와 방화벽 설정에서 확정한다.