- 발표자료 다운로드 — 알림에서 원인 서비스까지 도구를 바꾸지 않고 따라가는 방법
- 발표 영상으로 먼저 보기 — 알림에서 원인까지 4분 만에 보는 화면 흐름
- 이 발표자료가 답하는 여섯 가지 질문
- 원인 위치를 찾는 데 79분, 고치는 데는 3분이 걸렸다
- 업계 조사에서도 장애 시간의 상당 부분은 진단에 쓰인다
- MSA에서 장애는 호출하는 쪽으로 번진다
- 세 계층이 세 번씩 재시도하면 DB에는 최대 64번의 시도가 쌓인다
- 팀마다 다른 도구를 보면 정상이라는 말이 모두 맞을 수 있다
- 토폴로지 맵은 등록 없이 서비스 간 통신을 관찰해 그려진다
- 인시던트는 사용자가 겪은 결과인 SLO 위반으로만 열린다
- 루트 원인 분석 탭은 위에서 아래로 요약에서 근거 순서로 읽는다
- RCA는 이미 돌고 있는 판정 17개와 여섯 규칙으로 후보를 고른다
- RCA 결과는 확정이 아니라 근거로 확인할 후보로 표시된다
- 원인 서비스를 찾은 뒤에는 한 화면에서 탭만 넘겨 코드까지 내려간다
- 후보 선정은 규칙이 맡고 로그 해석과 확인 순서는 AI가 맡는다
- 주문이 안 되는 쇼핑몰 장애를 세 단계로 추적했다
- 데모 장애의 원인은 외부 도메인 DNS 조회 실패였다
- 추측하던 79분이 시작점, 후보, 근거를 확인하는 절차로 바뀐다
- 코드에 문제가 없어도 DNS와 네트워크 구간에서 서비스가 멈출 수 있다
- 핵심 정리
- 자주 묻는 질문
- 쿠버네티스 관측성, OpenTelemetry, 분산 추적
- 참고 리소스
- 자료 다운로드
발표자료 다운로드 — 알림에서 원인 서비스까지 도구를 바꾸지 않고 따라가는 방법
원인 서비스를 찾는 시간은 같은 시간대의 전체 호출 경로를 한 화면에서 볼 때 줄어든다. 이 발표자료의 메시지는 이 한 문장이다.
전체 24장, PDF로 24쪽이다. MSAP.ai 옵저버빌리티 세미나의 두 번째 세션 자료로, 문제, 해결, 데모, 정리 네 부분으로 나뉜다. 마지막에는 데모 장애의 원인과 원인을 근거로 확인하는 세 단계를 실었다.
업계 수치는 PagerDuty 2024 조사, Microsoft의 Teams 인시던트 152건 연구, Grafana Labs 2025 조사를 근거로 정리했고 장마다 바닥글에 출처를 적었다. 첫 장의 79분 사례는 특정 고객의 기록이 아니라 흔히 겪는 장애 대응을 재구성한 예다.
장애 대응 절차를 팀 안에서 다시 정하거나 운영 도구 통합을 검토할 때 바로 쓸 수 있도록 PDF로 공개한다.
MSAP.ai 백서 구독하기🔔
새로운 백서 소식을 가장 먼저 만나보세요!
MSAP.ai 가 전하는 AI 기반 운영 인사이트와 최신 백서 소식을 가장 빠르게 받아보실 수 있습니다.
구독해 주시면 더 좋은 콘텐츠로 보답하겠습니다.🙏
발표 영상으로 먼저 보기 — 알림에서 원인까지 4분 만에 보는 화면 흐름
이 세션만 다룬 영상은 아직 없다. 대신 같은 제품에서 알림을 받고 원인까지 내려가는 화면 흐름을 4분 동안 보여 주는 개요 영상을 소개한다.
세션 자료가 왜 그 순서로 확인해야 하는지를 설명한다면 개요 영상은 실제 화면에서 그 순서가 어떻게 이어지는지 보여 준다. 아래 영상은 이 세션의 녹화가 아니라 같은 제품의 기능 개요 편이다.
영상에서 다루는 순서는 다음과 같다.
- 알림과 인시던트에서 장애 시작점 확인
- 토폴로지 맵으로 호출 관계와 오류 구간 보기
- 근본 원인 분석으로 원인 후보와 전파 경로 좁히기
- 메트릭, 로그, 분산 추적 탭을 오가며 근거 확인
이 세션의 앞 단계인 코드 수정 없는 수집은 eBPF 기반 서비스 모니터링 발표자료에서 먼저 볼 수 있다.
이 발표자료가 답하는 여섯 가지 질문
운영팀이 MSA 장애를 대응하면서 반복해서 묻는 질문을 기준으로 슬라이드를 배치했다.
- 장애 시간은 고치는 데보다 찾는 데 왜 더 오래 걸리는가
- 알림이 먼저 울린 서비스는 왜 원인이 아닐 수 있는가
- 경보 여러 건 가운데 무엇을 인시던트로 묶어야 하는가
- 자동 RCA는 무엇을 근거로 원인 후보를 고르는가
- RCA와 AI 로그 분석은 각각 무엇을 맡는가
- 원인이 코드가 아닐 때는 어디를 봐야 하는가
원인 위치를 찾는 데 79분, 고치는 데는 3분이 걸렸다
장애 시간 대부분은 복구가 아니라 원인 위치를 찾는 데 쓰였다. 흔히 겪는 장애 대응을 하나 재구성하면 이렇다.
새벽 2시 41분에 알람이 울렸고 6분 뒤 담당자들이 모였다. 3시 5분까지 나온 말은 “우리 쪽은 정상인데요”였고, 그다음 30분은 각자 로그를 확인했다. 원인은 4시에 확인했고 복구는 4시 3분에 끝났다. 고치는 데 3분, 어디가 문제인지 찾는 데 79분이 걸린 셈이다. 대응 시간을 줄이려면 찾는 단계를 줄여야 한다.
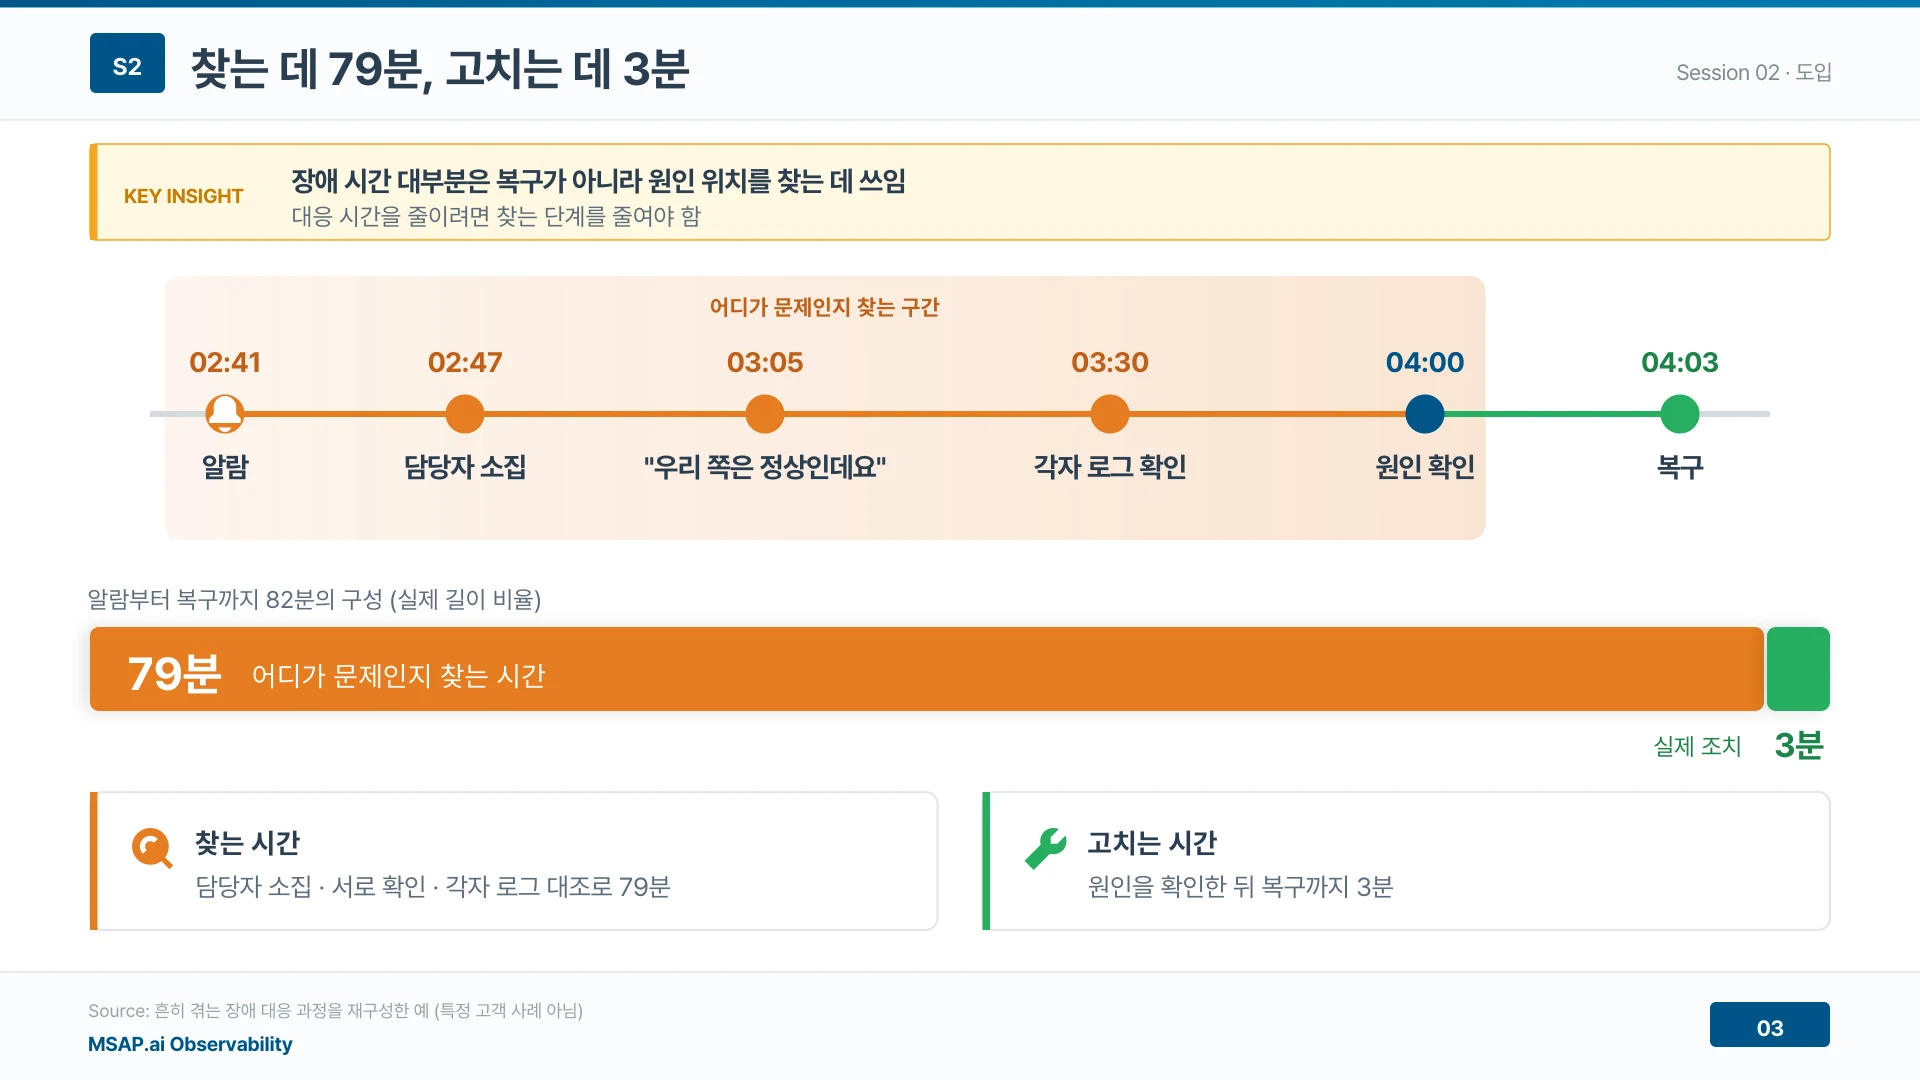
▲ 장애 시간 대부분은 복구가 아니라 원인 위치를 찾는 데 쓰임 (발표자료 3쪽)
업계 조사에서도 장애 시간의 상당 부분은 진단에 쓰인다
이 현상은 한 회사만의 일이 아니다. 업계 조사도 장애 시간의 상당 부분이 원인 진단에 쓰인다고 말한다.
PagerDuty 2024 조사(직원 1,000명 이상 기업 IT 리더 500명)에서 인시던트 평균 해결 시간은 175분이었다. PagerDuty는 자사 데이터로 인시던트 시간의 최대 50%가 진단과 담당자 확인에 쓰인다고 밝혔는데, 이 수치의 방법론은 공개하지 않았다.
Microsoft가 Teams의 고심각도 인시던트 152건을 분석한 연구(SoCC 2022)에서는 90% 이상이 코드 변경 없이 롤백, 설정 변경, 재시작으로 완화됐다. 원인의 60%는 코드가 아니라 의존성, 인프라, 배포, 설정 쪽이었다.
| 조사 | 대상 | 결과 |
|---|---|---|
| PagerDuty 2024 | IT 리더 500명 | 평균 해결 시간 175분 |
| PagerDuty 자사 데이터 | 비공개 | 인시던트 시간 최대 50%가 진단·담당자 확인 |
| Microsoft SoCC 2022 | Teams 인시던트 152건 | 90% 이상 코드 변경 없이 완화, 원인 60%는 비코드 |
정리하면 인시던트 대부분은 코드 수정 없이 완화되지만 원인 범주를 알기까지 오래 걸린다. 진단 단계를 줄이는 쪽이 효과가 크다.
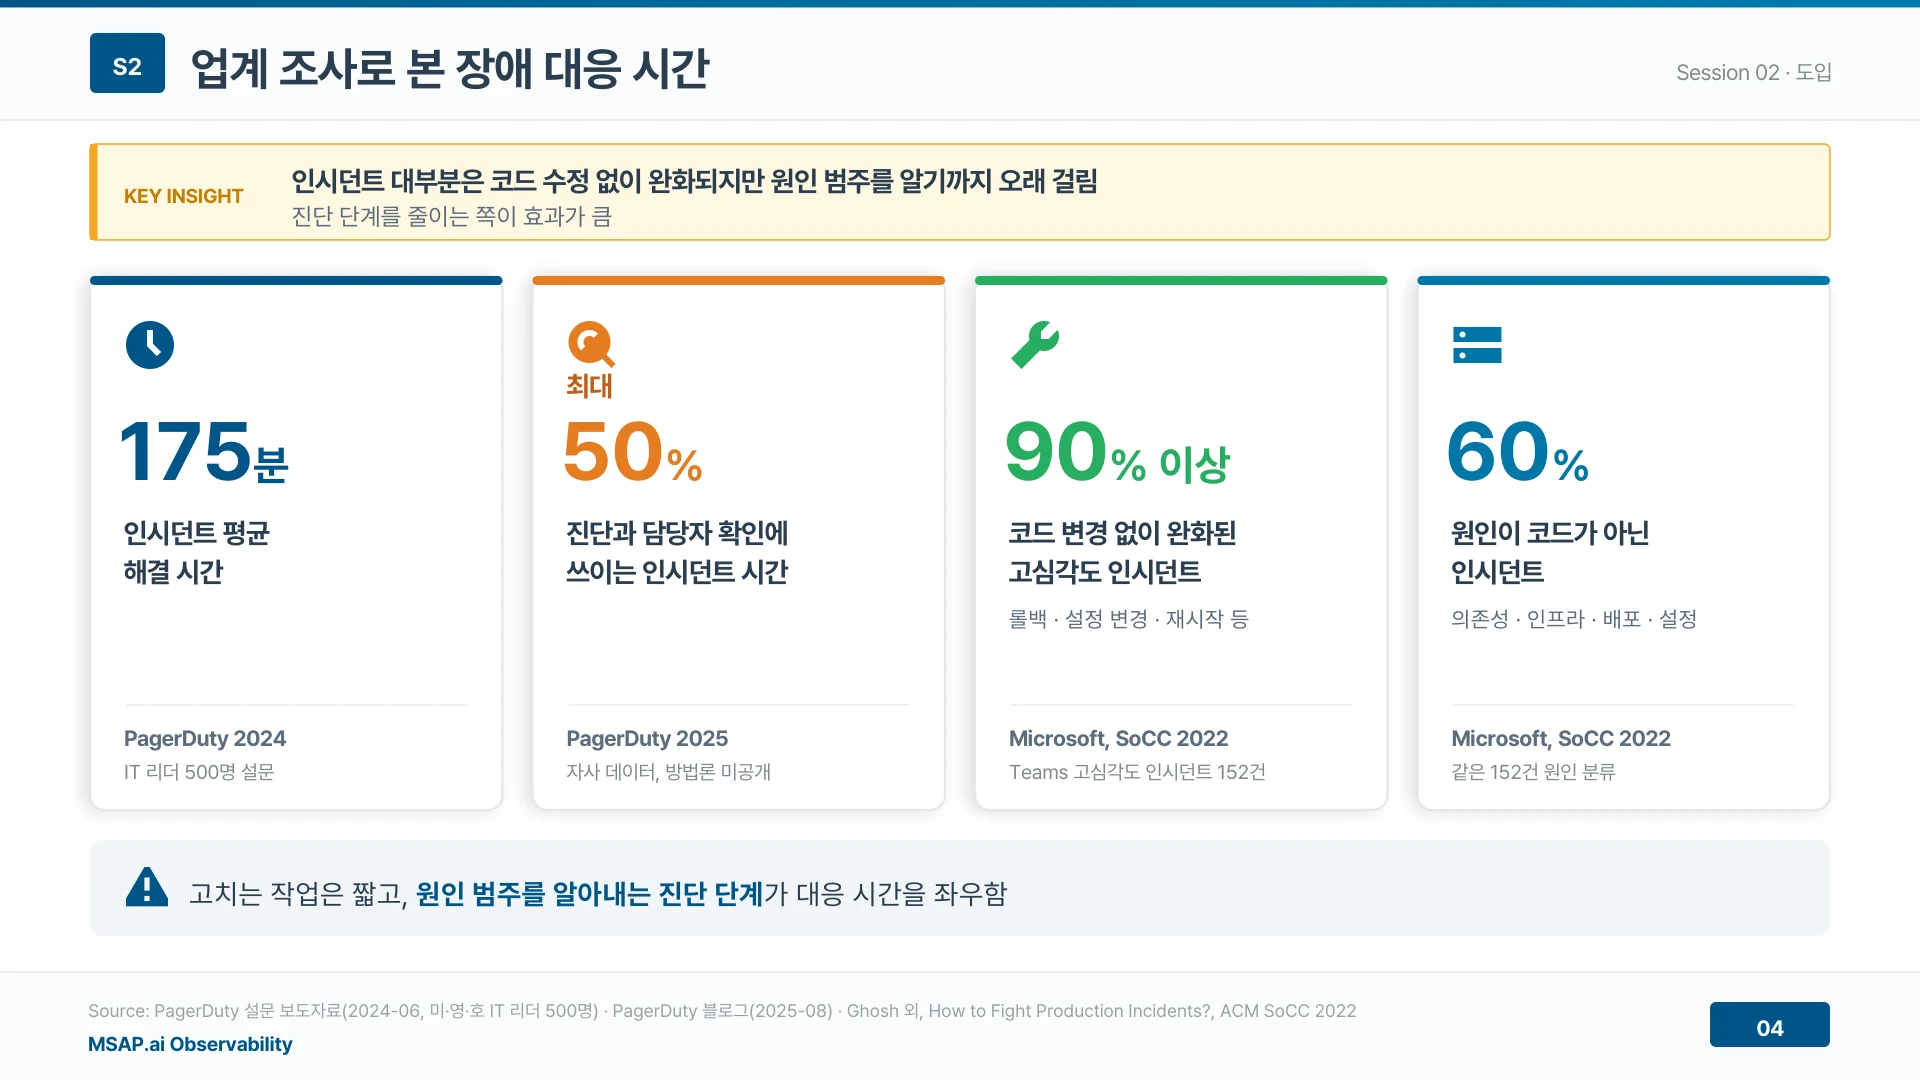
▲ 인시던트 대부분은 코드 수정 없이 완화되지만 원인 범주를 알기까지 오래 걸림 (발표자료 4쪽)
MSA에서 장애는 호출하는 쪽으로 번진다
MSA에서는 결제가 느려지면 결제를 부르는 주문과 게이트웨이가 함께 느려진다. 그래서 알림이 먼저 울린 서비스가 원인이 아닐 수 있다.
MSA는 기능마다 서비스를 나눠 따로 만들고 따로 배포하므로 사용자 요청 하나가 서비스 여러 개를 차례로 거친다. 장애가 번지는 방향은 호출하는 쪽이라, 알림은 게이트웨이나 주문에서 먼저 울릴 수 있다. 요청이 거친 전체 경로를 봐야 원인을 가릴 수 있다.
서비스를 왜 나누고 나눈 뒤 무엇이 어려워지는지는 미니서비스 설계와 MSA 전환 판단 기준에서 함께 볼 수 있다.
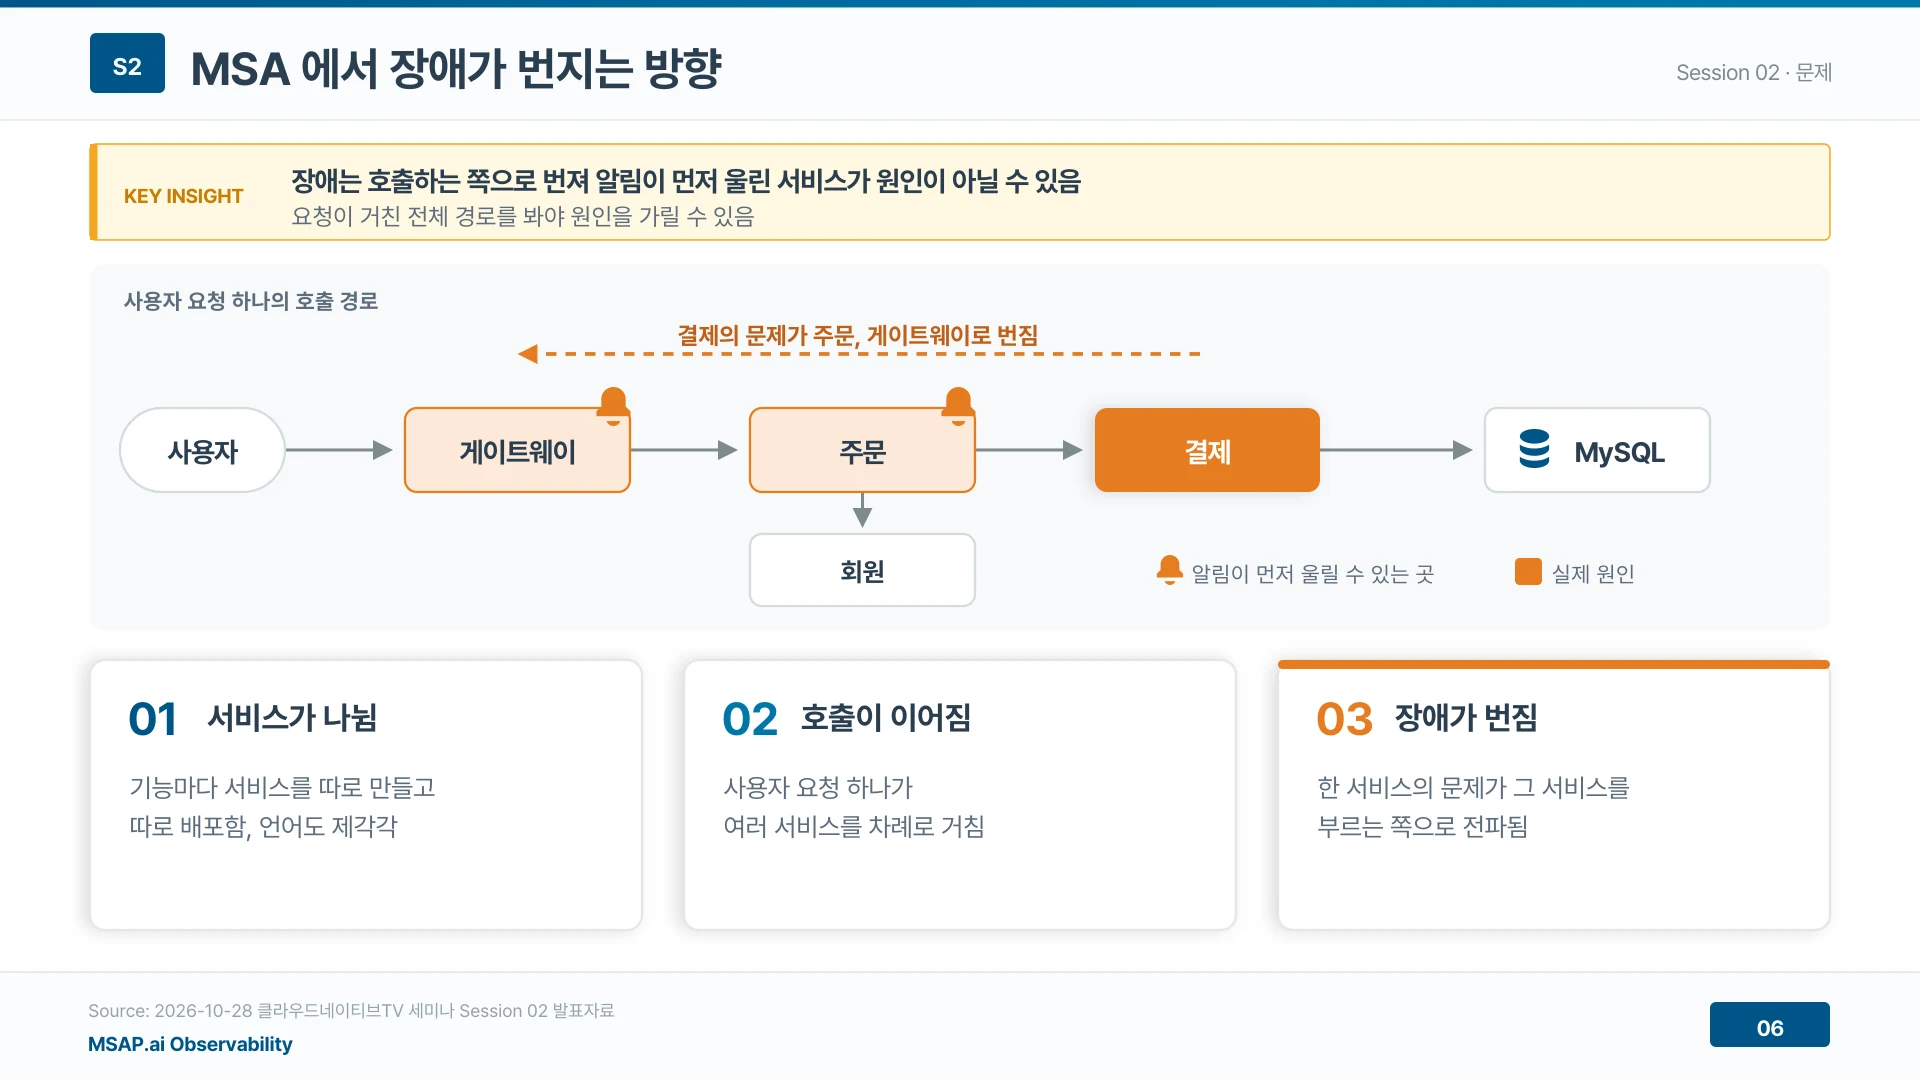
▲ 장애는 호출하는 쪽으로 번져 알림이 먼저 울린 서비스가 원인이 아닐 수 있음 (발표자료 6쪽)
세 계층이 세 번씩 재시도하면 DB에는 최대 64번의 시도가 쌓인다
느려진 서비스를 부르는 쪽은 재시도를 하고, 재시도는 계층마다 곱해진다. 이 과부하가 만든 2차 증상이 처음 문제가 생긴 곳을 가린다.
세 계층이 각각 세 번씩 재시도하면 사용자 동작 한 번이 게이트웨이 1회, 주문 최대 4회, 결제 최대 16회, DB 최대 64회의 시도로 바뀐다. 과부하가 생기면 지연 증가, 헬스체크 실패, 다른 서버로의 부하 이동 같은 2차 증상이 생긴다. Google SRE 책도 연쇄 장애에서 2차 증상이 원래 원인을 가린다고 설명한다.
| 계층 | 사용자 동작 1회당 최대 시도 |
|---|---|
| 게이트웨이 | 1회 |
| 주문 | 4회 |
| 결제 | 16회 |
| DB | 64회 |
담당 팀이 다르면 각 팀은 자기 서비스의 증상만 본다. 그래서 알림 위치보다 먼저 이상해진 지점을 찾아야 한다.
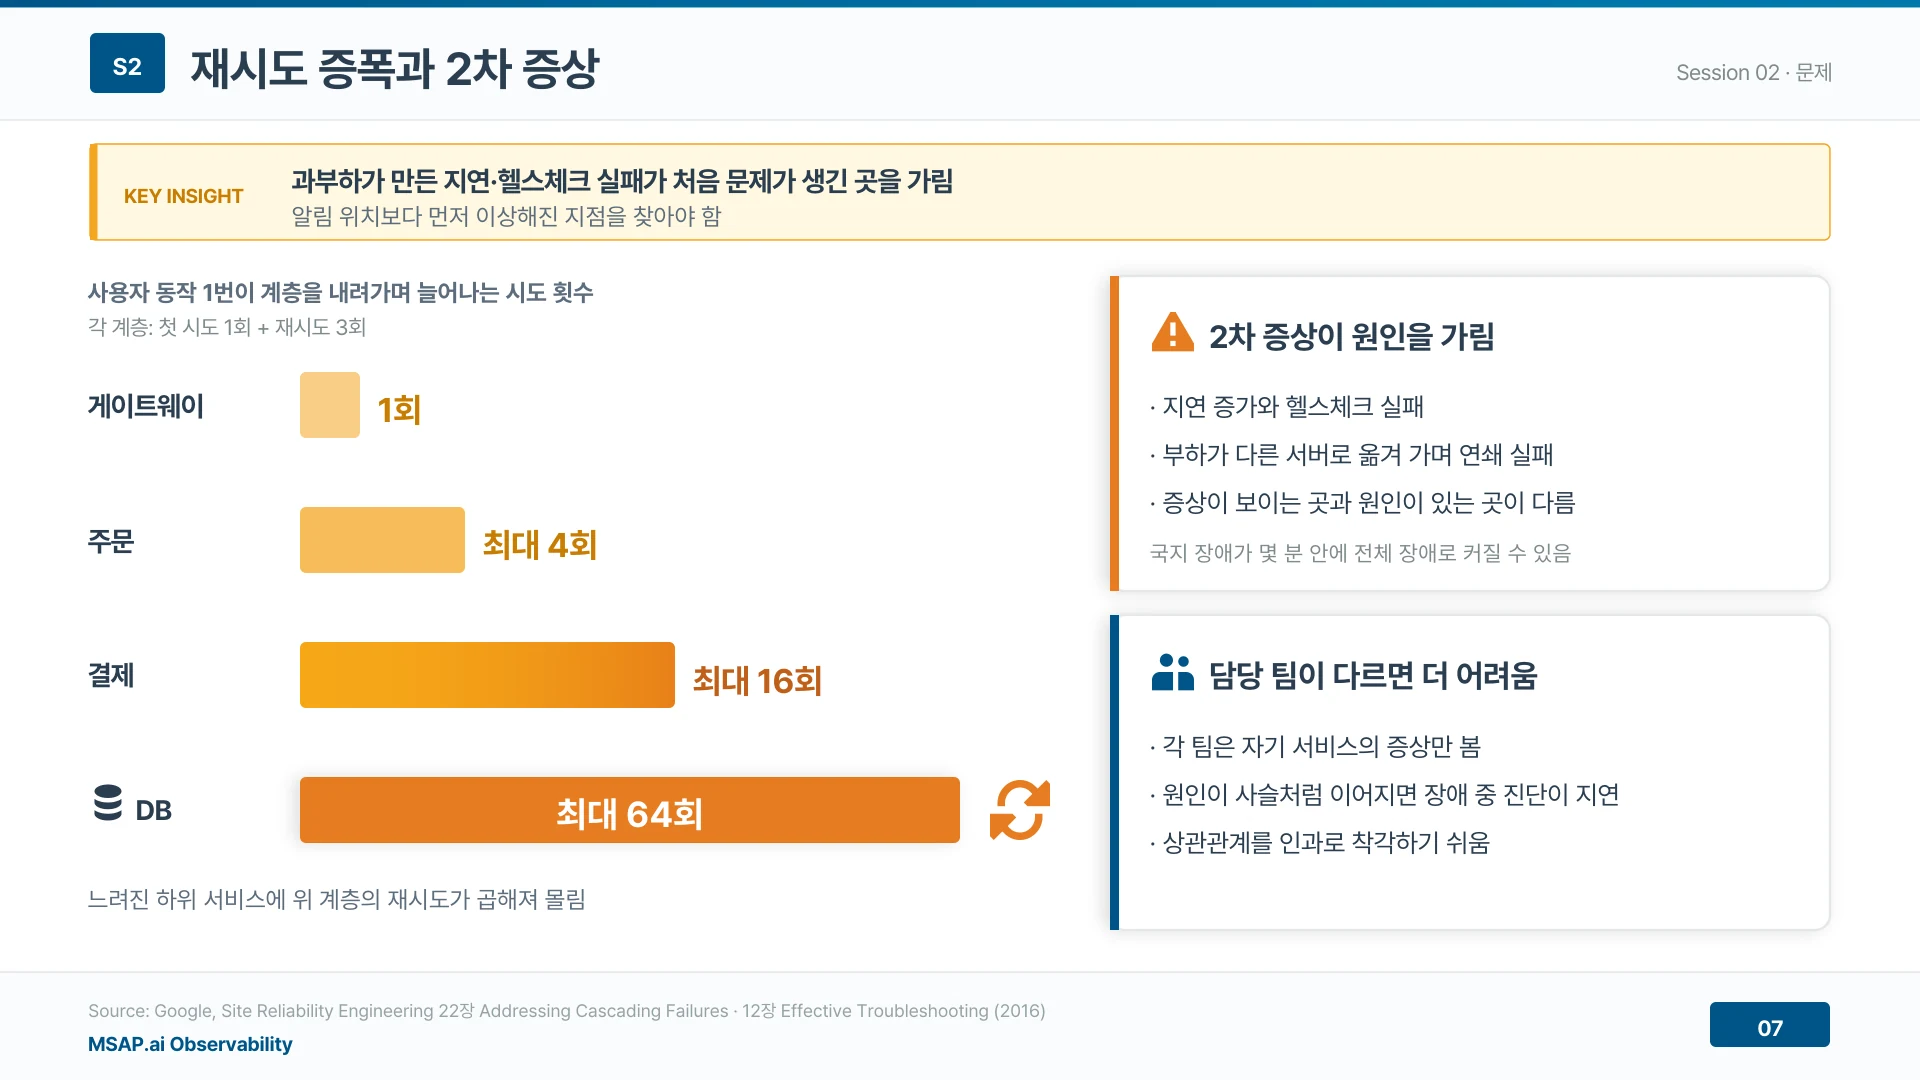
▲ 재시도가 만든 지연과 헬스체크 실패가 처음 문제가 생긴 곳을 가림 (발표자료 7쪽)
팀마다 다른 도구를 보면 정상이라는 말이 모두 맞을 수 있다
각 팀이 자기 서비스 화면만 보면 “우리 쪽은 정상인데요”가 모두 사실일 수 있다. 서로의 판단을 맞춰 보는 데 시간이 든다.
게이트웨이 팀, 주문 팀, 결제 팀이 서로 다른 도구를 보고 도구마다 서비스 이름과 시간대가 다르다. Grafana Labs 2025 조사(응답 1,255명)에서 조직은 평균 8개의 옵저버빌리티 기술을 쓰고, Splunk 2025 조사(응답 1,855명)에서는 59%가 서로 다른 도구가 너무 많은 것을 과제로 꼽았다.
같은 시간대의 전체 경로를 한 화면에서 봐야 대조 시간이 사라진다. 필요한 화면은 호출 관계 전체를 한 그림으로 보여 주고, 같은 시간대로 고정한 채 탭을 옮기고, 원인 후보를 근거와 함께 보여 주는 화면이다.
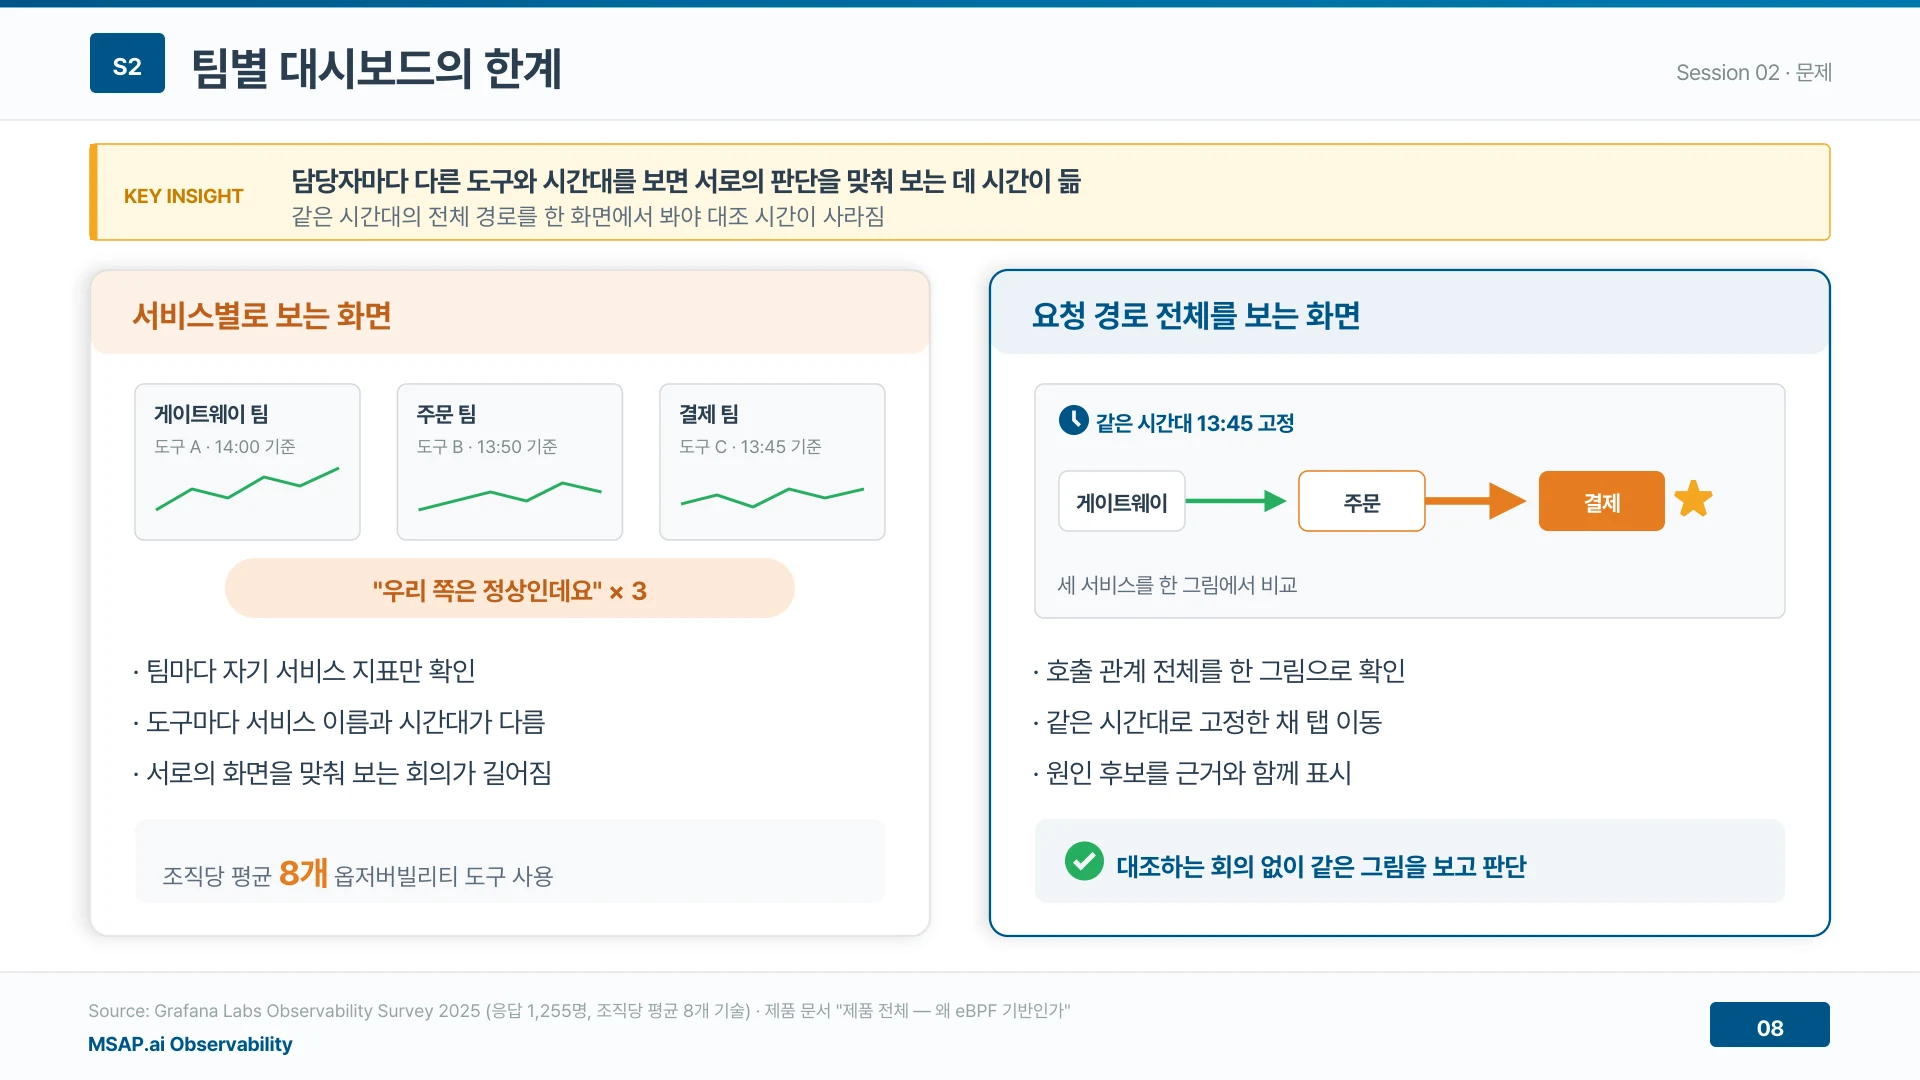
▲ 같은 시간대의 전체 경로를 한 화면에서 봐야 팀 간 대조 시간이 사라짐 (발표자료 8쪽)
토폴로지 맵은 등록 없이 서비스 간 통신을 관찰해 그려진다
토폴로지 맵은 서비스 하나를 노드 하나, 호출 관계를 선 하나로 그린다. 이 맵을 그리려고 서비스를 등록하거나 관계를 설정하지 않는다.
선 굵기는 초당 요청 수, 선 색은 오류율을 뜻한다. 오류율이 1%를 넘으면 노랑, 5%를 넘으면 빨강이다. 노드 안에는 상태와 Pod 수, CPU, 메모리 게이지가 함께 나온다.
노드 에이전트가 eBPF로 서비스 간 통신을 관찰해 맵을 자동으로 그리고, 10초마다 달라진 부분을 반영한다. 새로 생긴 서비스와 사라진 서비스가 지금 상태 그대로 보인다. 서비스가 수백 개여도 미니맵과 네임스페이스 필터로 필요한 부분만 좁혀 본다. 그래프에는 수집된 호출 관계만 담기므로 감시 대상 밖 서비스를 거친 구간은 그림에 없다.
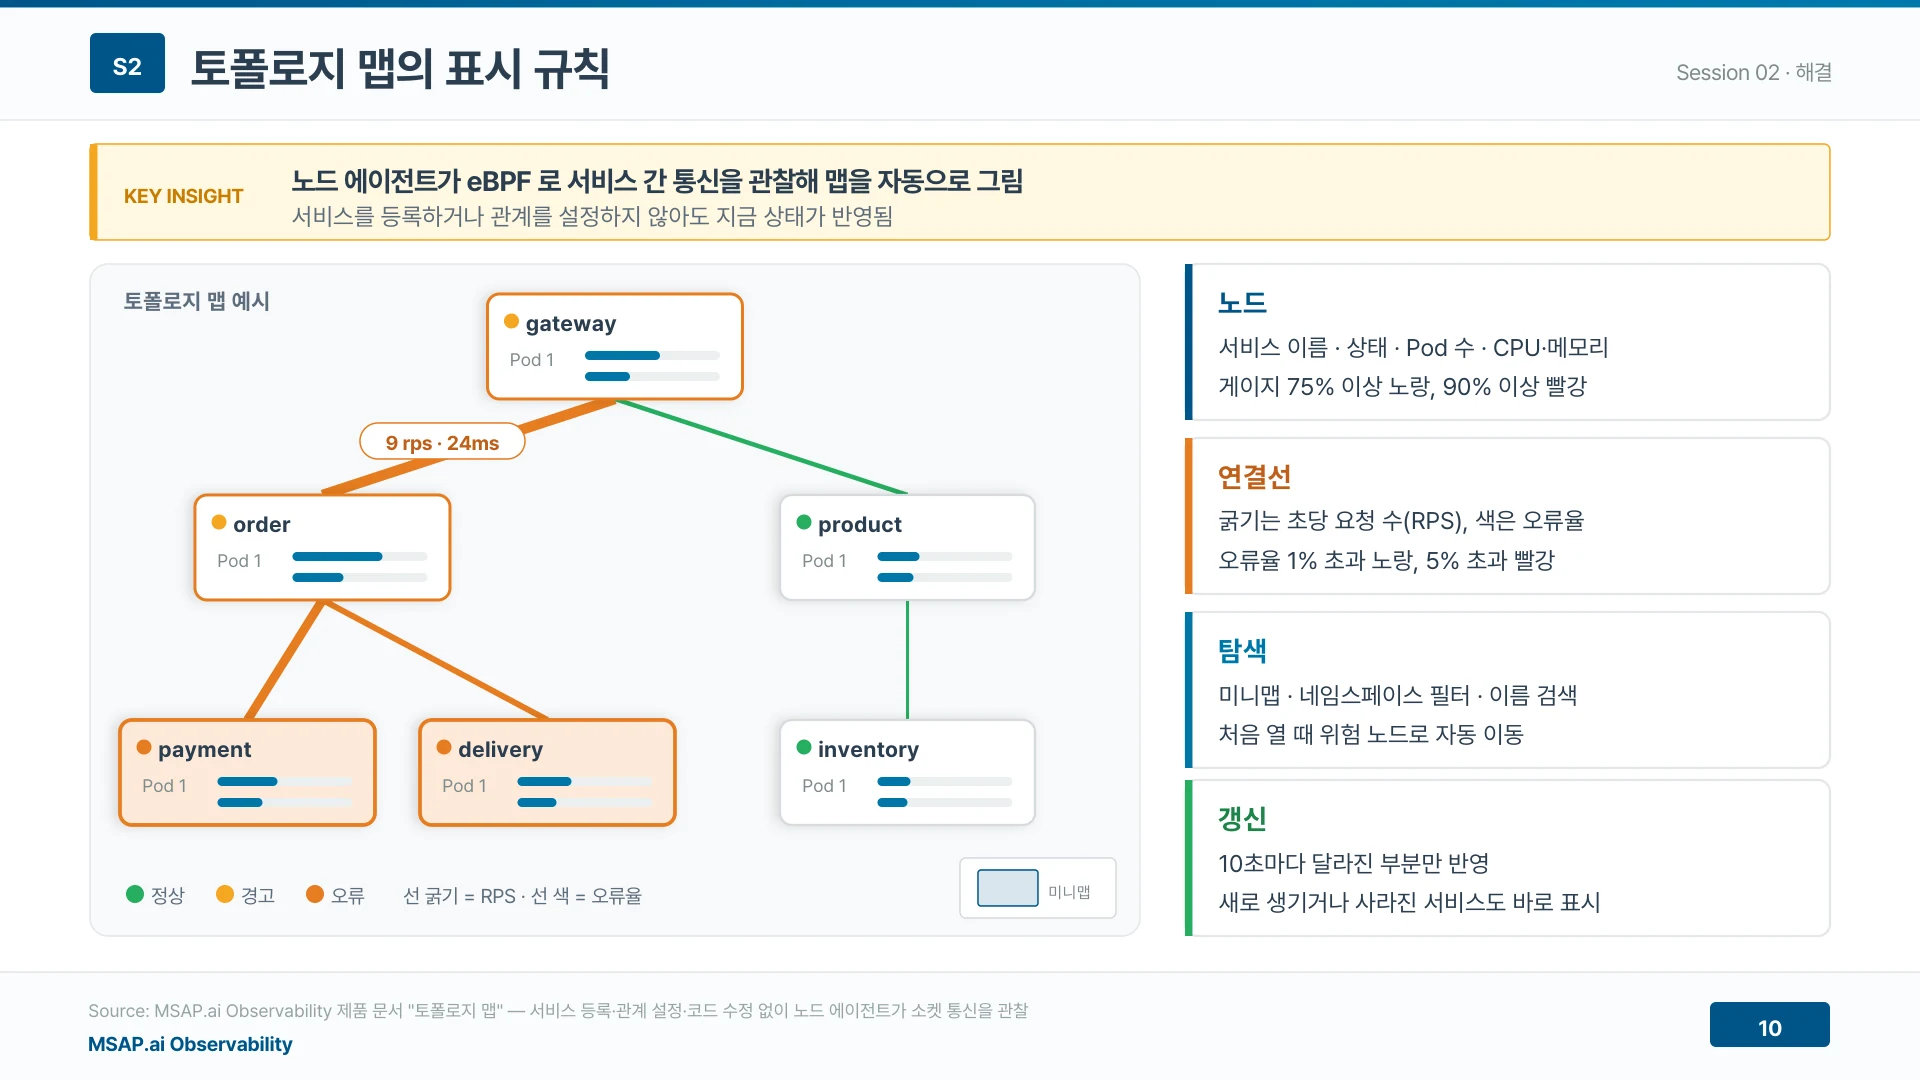
▲ 노드 에이전트가 서비스 간 통신을 관찰해 등록 없이 맵을 자동으로 그림 (발표자료 10쪽)
인시던트는 사용자가 겪은 결과인 SLO 위반으로만 열린다
장애가 나면 CPU, 응답시간, 오류율, 로그 경보가 거의 동시에 여러 건 온다. 인시던트는 가용성이나 응답시간 SLO를 위반했을 때만 하나 열린다.
SLO를 위반하면 인시던트가 자동으로 생기고 원인이 사라지면 자동으로 해결된다. 이상 탐지 같은 개별 규칙은 인시던트가 아니라 알림으로 따로 간다. CPU가 높아도 응답시간이 느려지지 않으면 인시던트는 생기지 않는다. 경보 여러 건을 사건 하나로 묶어 대응자가 볼 대상을 하나로 줄이는 설계다.
| 구분 | 생기는 조건 | 쓰임 |
|---|---|---|
| 인시던트 | 가용성·응답시간 SLO 위반 | 대응 대상 하나로 묶음, 자동 해결 |
| 알림 | 이상 탐지 등 개별 규칙 | 참고 신호, 인시던트와 별도 |
인시던트 목록에는 소비한 오류 예산이 함께 나온다. 같은 30분짜리라도 오류 예산을 12% 쓴 것과 140% 쓴 것은 먼저 볼 순서가 다르다. 오류 예산 소비량이 대응 순서를 정한다.
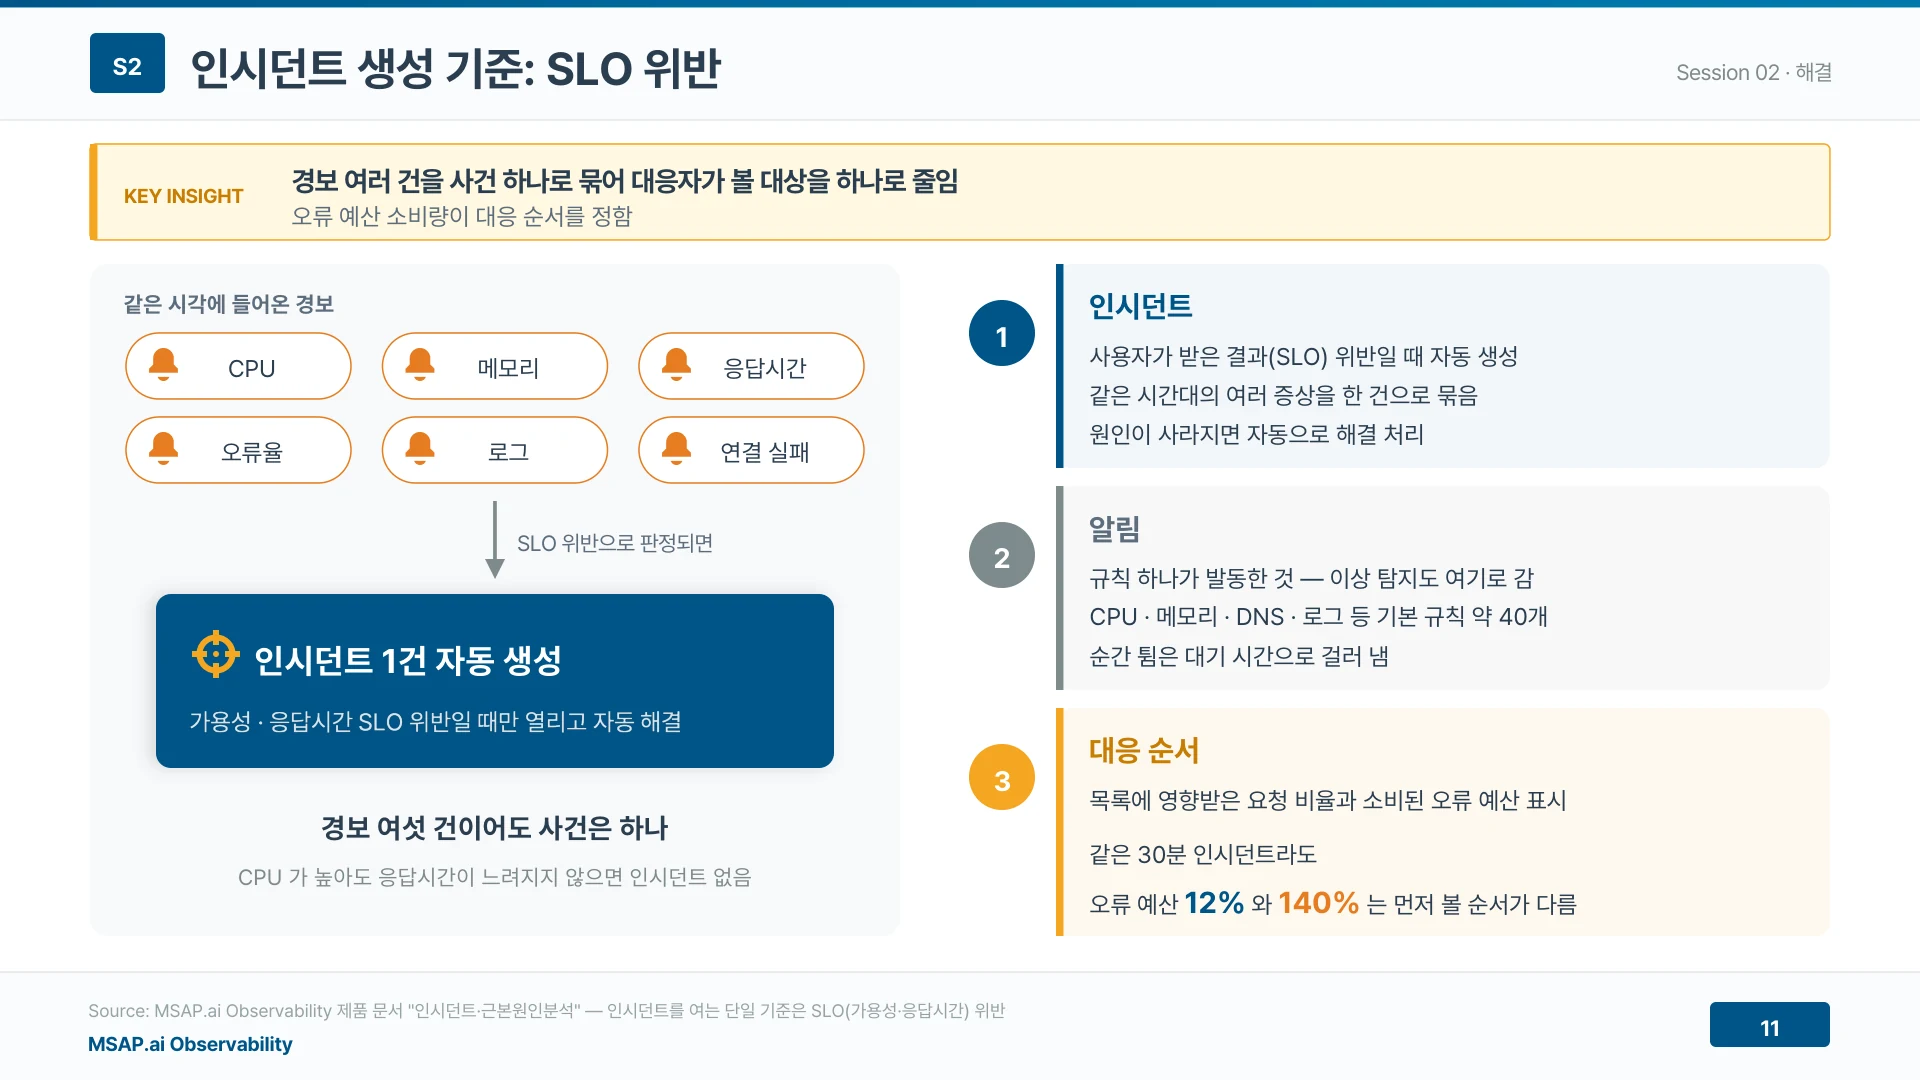
▲ 경보 여러 건을 SLO 위반 인시던트 하나로 묶고 오류 예산 소비량으로 대응 순서를 정함 (발표자료 11쪽)
루트 원인 분석 탭은 위에서 아래로 요약에서 근거 순서로 읽는다
인시던트를 열면 루트 원인 분석 탭이 나온다. SLI, 분석 요약, 이슈 전파 경로, 인과 타임라인, 상세 보고서 순서로 읽는다.
먼저 인시던트 기간의 서비스 상태가 SLI 차트로 나오고, 분석 요약에 추정 근본 원인이 나온다. 이슈 전파 경로는 관련 서비스만 남긴 그림으로, 인시던트가 난 서비스에는 조준점, 추정 근본 원인 서비스에는 별이 표시되고 그 사이 경로가 강조된다.
인과 타임라인에서는 무엇이 먼저 일어났는지 시간 순서로 보고, 상세 보고서에서는 원인 항목마다 근거 차트와 로그 표본을 본다. 급할 때는 위쪽 요약과 전파 경로만 보고, 근거가 필요하면 아래 보고서까지 내려간다. 요약만 보여 주면 근거를 확인할 수 없고 전부 나열하면 읽히지 않기 때문에 이렇게 나눴다.
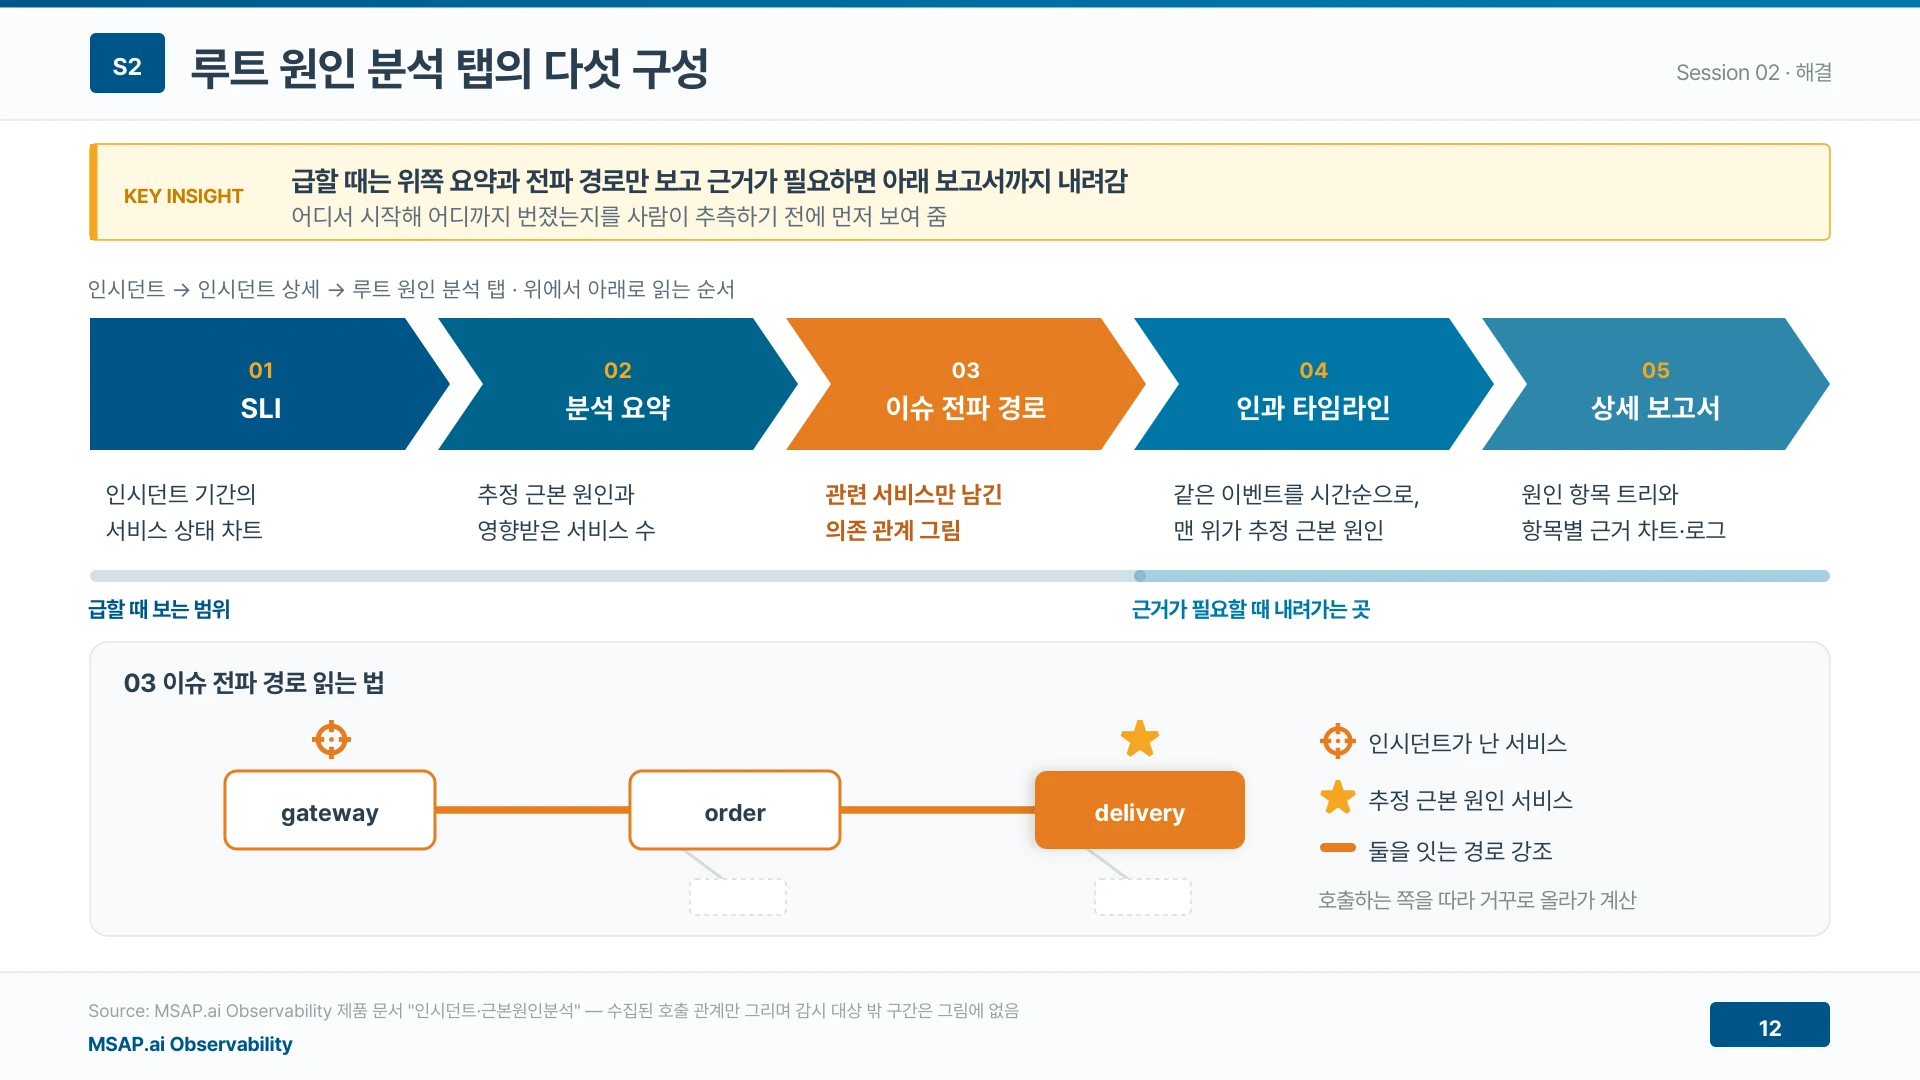
▲ 급할 때는 요약과 전파 경로만, 근거가 필요하면 상세 보고서까지 내려감 (발표자료 12쪽)
RCA는 이미 돌고 있는 판정 17개와 여섯 규칙으로 후보를 고른다
RCA는 새 판단 기준을 만들지 않는다. 애플리케이션마다 이미 돌고 있는 판정 결과를 여섯 가지 규칙으로 모아 원인 후보를 고른다.
근거는 SLO, CPU, 메모리, 네트워크, DNS, DB, 배포 등 17개 판정이다. 그래서 애플리케이션 상세 화면이 말하는 상태와 RCA가 말하는 원인이 같은 판정에서 나온다. 여기에 배포 상관, 업스트림 장애, 리소스 포화, 로그 패턴, SLO 연쇄, DB 이슈라는 여섯 규칙을 적용한다.
| 순서 요인 | 가중치 |
|---|---|
| 시간 상관 | 0.35 |
| 토폴로지 근접 | 0.25 |
| 심각도 | 0.20 |
| 증거 강도 | 0.20 |
핵심은 가장 먼저 발동한 판정을 근본 원인 후보로 올린다는 점이다. DB 응답시간이 5분 전, 업스트림 SLO 위반이 3분 전, 대상 서비스 오류율이 방금이라면 원인이 이어진 순서는 그 반대다. 이 계산에는 언어 모델을 쓰지 않아 같은 입력에 같은 결과가 나오고, 왜 그 후보인지 화면에서 되짚을 수 있다.
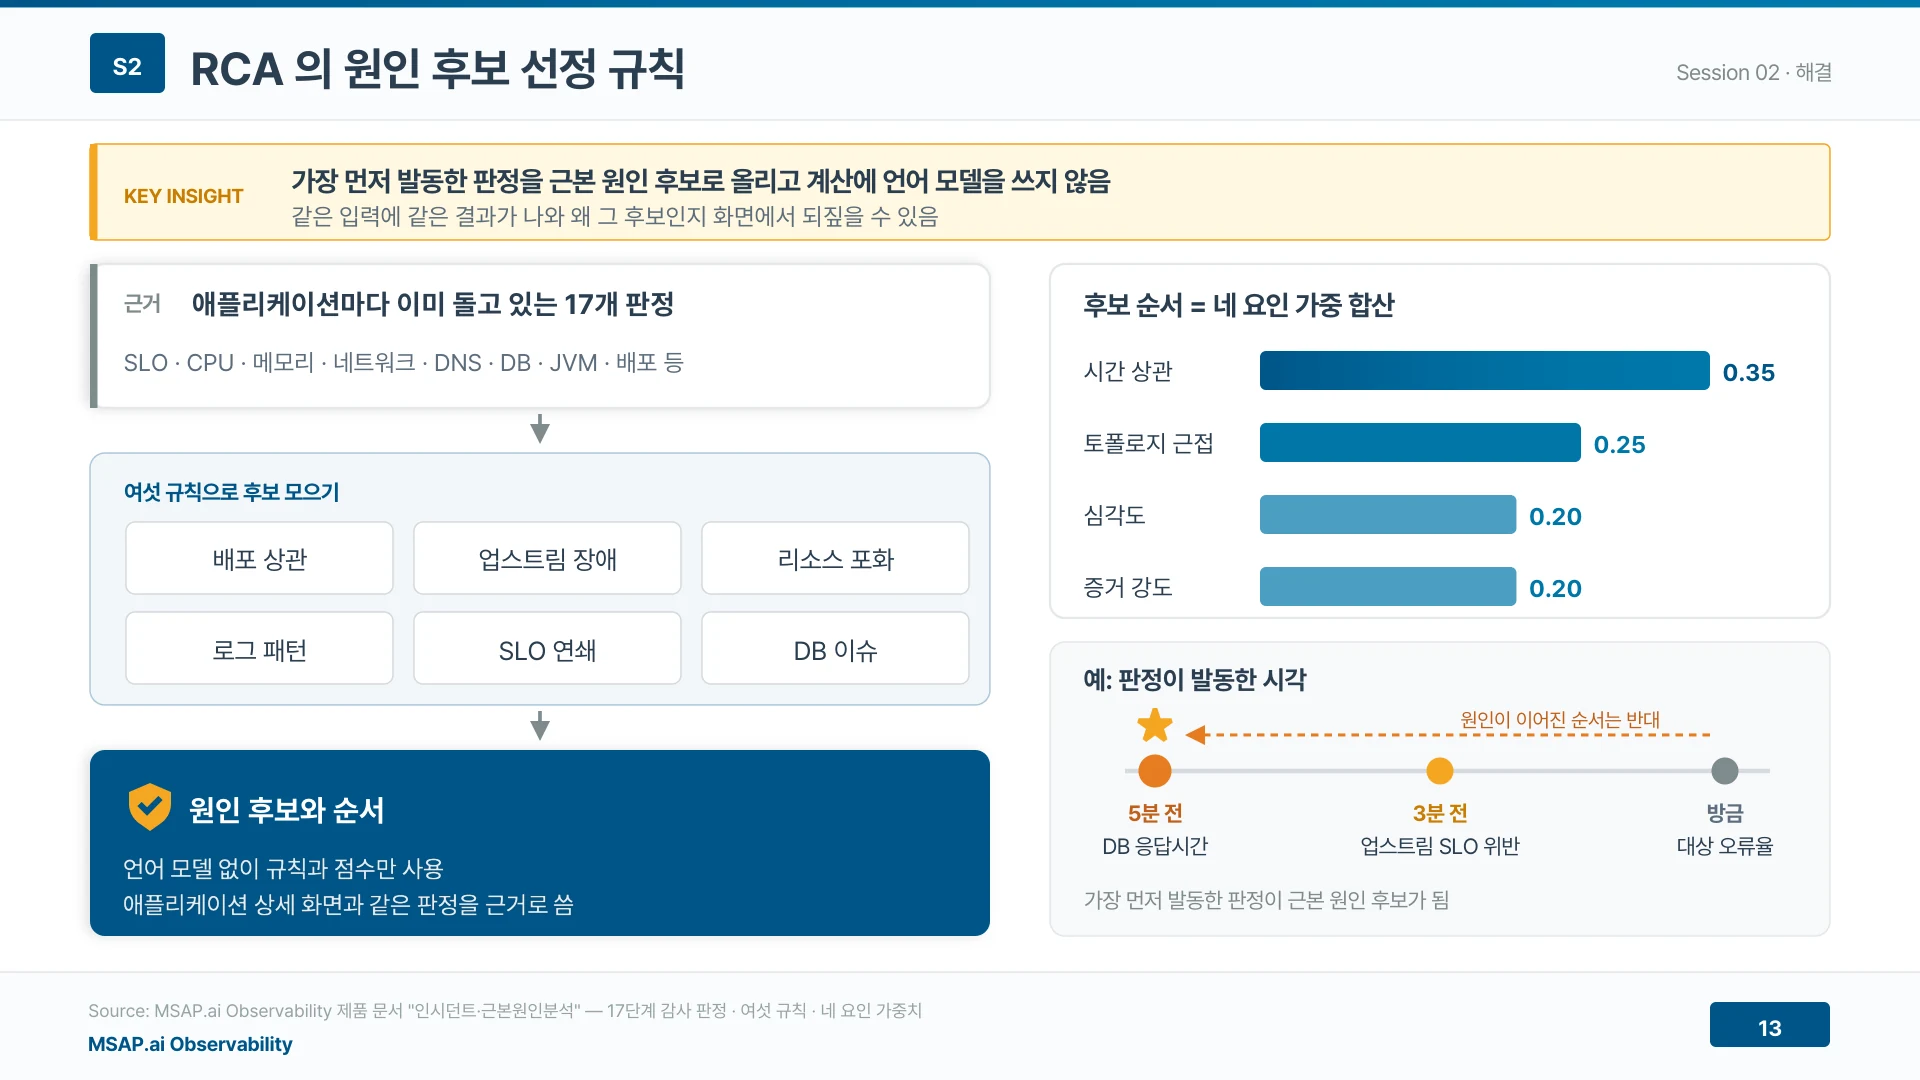
▲ 가장 먼저 발동한 판정을 원인 후보로 올리고 계산에 언어 모델을 쓰지 않음 (발표자료 13쪽)
RCA 결과는 확정이 아니라 근거로 확인할 후보로 표시된다
RCA 화면은 결과를 확정이라고 말하지 않는다. 원인 항목의 라벨은 추정 근본 원인이고, 근거가 얼마나 갖춰졌는지를 신뢰도로 표시한다.
신뢰도는 높음, 중간, 낮음 세 단계이며 정확도가 아니라 근거의 충족 정도를 나타낸다. 항목을 누르면 근거 차트와 로그 표본이 나오고, 인시던트 상세의 추적 탭은 그 시간대로 자동 필터링돼 응답시간 SLO를 넘긴 요청을 먼저 보여 준다.
RCA가 하지 않는 일도 분명하다. 여섯 규칙 밖의 원인, 예를 들어 애플리케이션 내부 로직 결함은 찾지 못하고, 상관관계를 인과로 확정하지 않으며, 감시하지 않는 구간은 그리지 않는다. 코드 수준의 조치 방안도 RCA의 몫이 아니다. 자동 원인 분석의 위험은 틀리는 것 자체보다 틀린 결론을 확신 있게 제시하는 데 있다. 마이크로서비스 RCA 기법 21종을 비교한 ASE 2024 연구도 모든 상황에서 최고인 방법은 없다고 밝혔다.
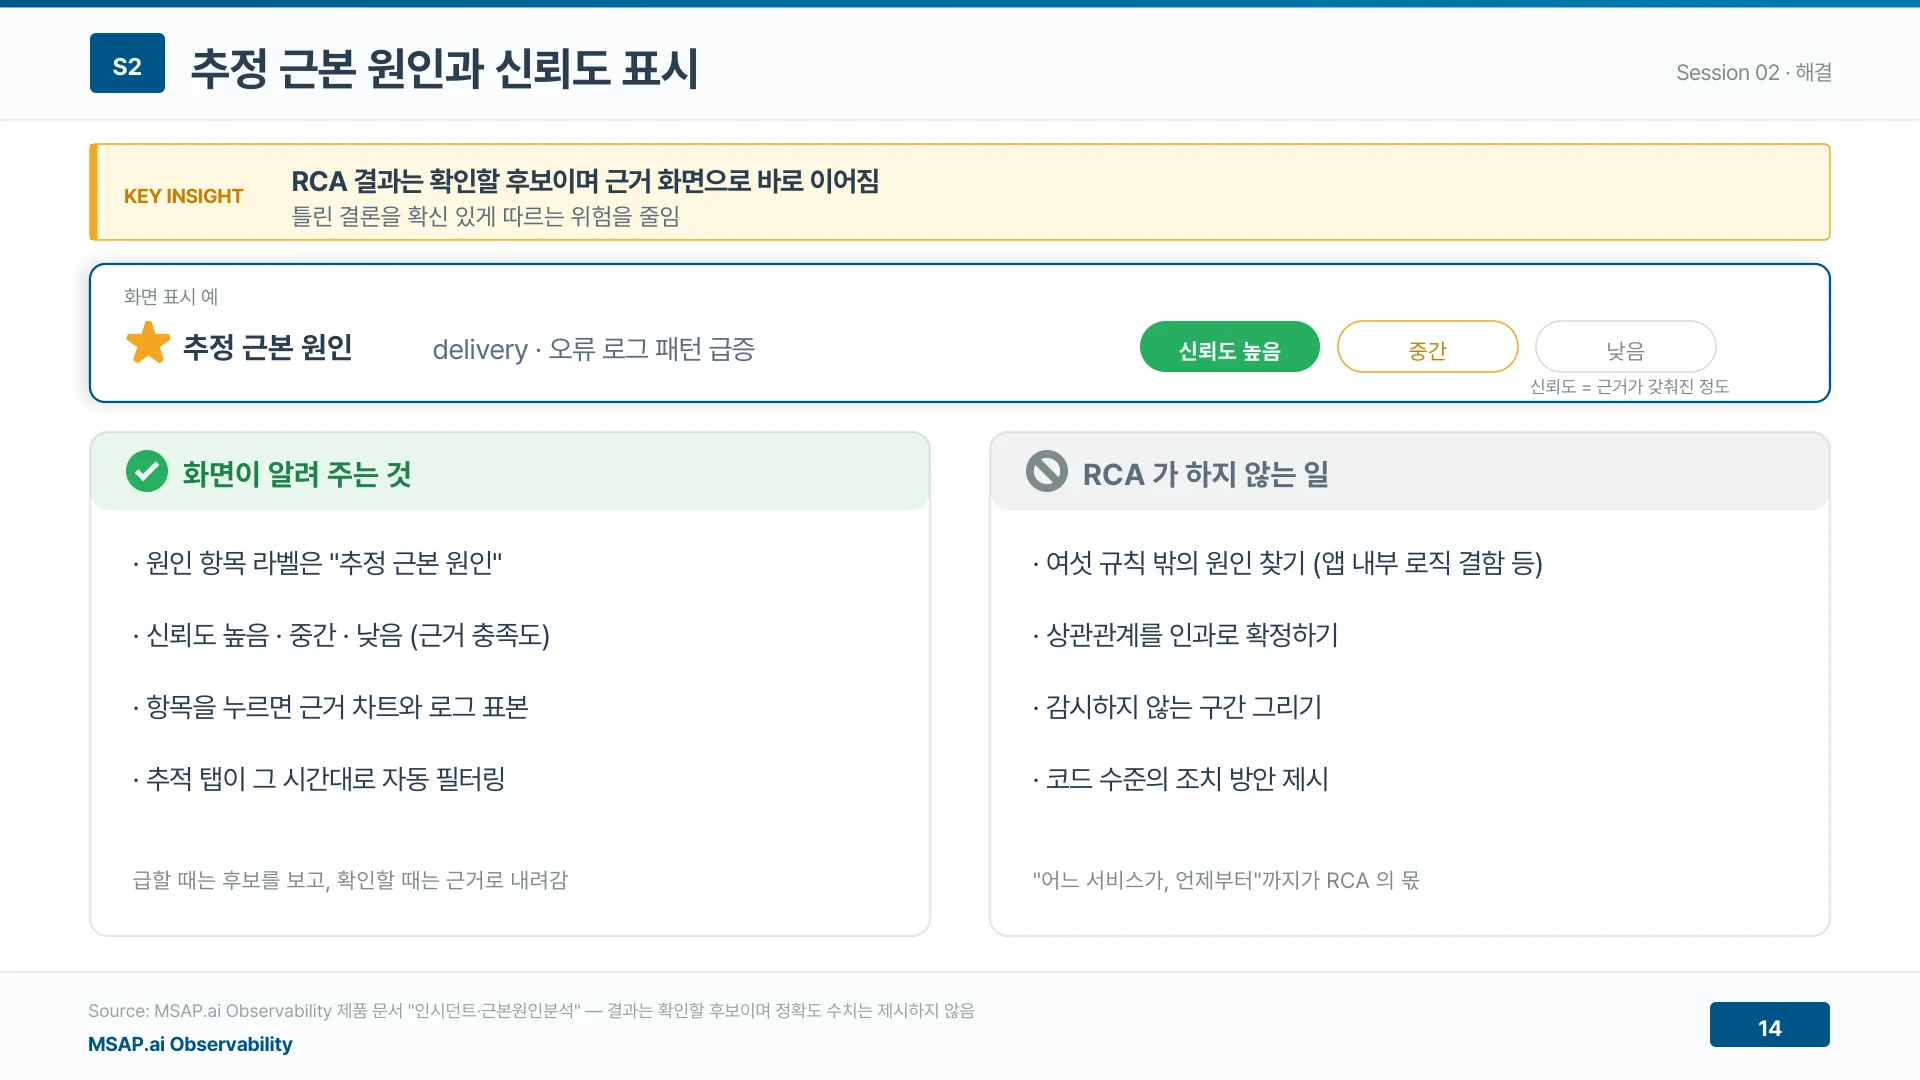
▲ RCA 결과는 확인할 후보이며 근거 화면으로 바로 이어짐 (발표자료 14쪽)
원인 서비스를 찾은 뒤에는 한 화면에서 탭만 넘겨 코드까지 내려간다
원인 서비스를 찾은 뒤에는 서비스 상세 화면 하나에서 메트릭, 로그, 분산 추적, 프로파일링 탭을 차례로 넘긴다. 네 가지 데이터가 같은 시간 범위로 묶여 있다.
보통은 이 단계에서 도구를 여러 개 연다. 메트릭은 대시보드에서, 로그는 로그 도구에서, 추적은 또 다른 도구에서 보고, 도구를 바꿀 때마다 시각을 맞추고 대상을 다시 찾는다.
여기서는 메트릭 탭에서 무엇이 이상한지, 로그 탭에서 무슨 일이 있었는지, 분산 추적 탭에서 어디서 지연됐는지, 프로파일링 탭에서 어떤 코드가 느린지까지 이어서 본다. 시각을 맞추고 대상을 다시 찾는 대조 시간이 사라진다. 이 네 신호가 왜 함께 필요한지는 쿠버네티스 관측성, OpenTelemetry, 분산 추적에서 자세히 다룬다.
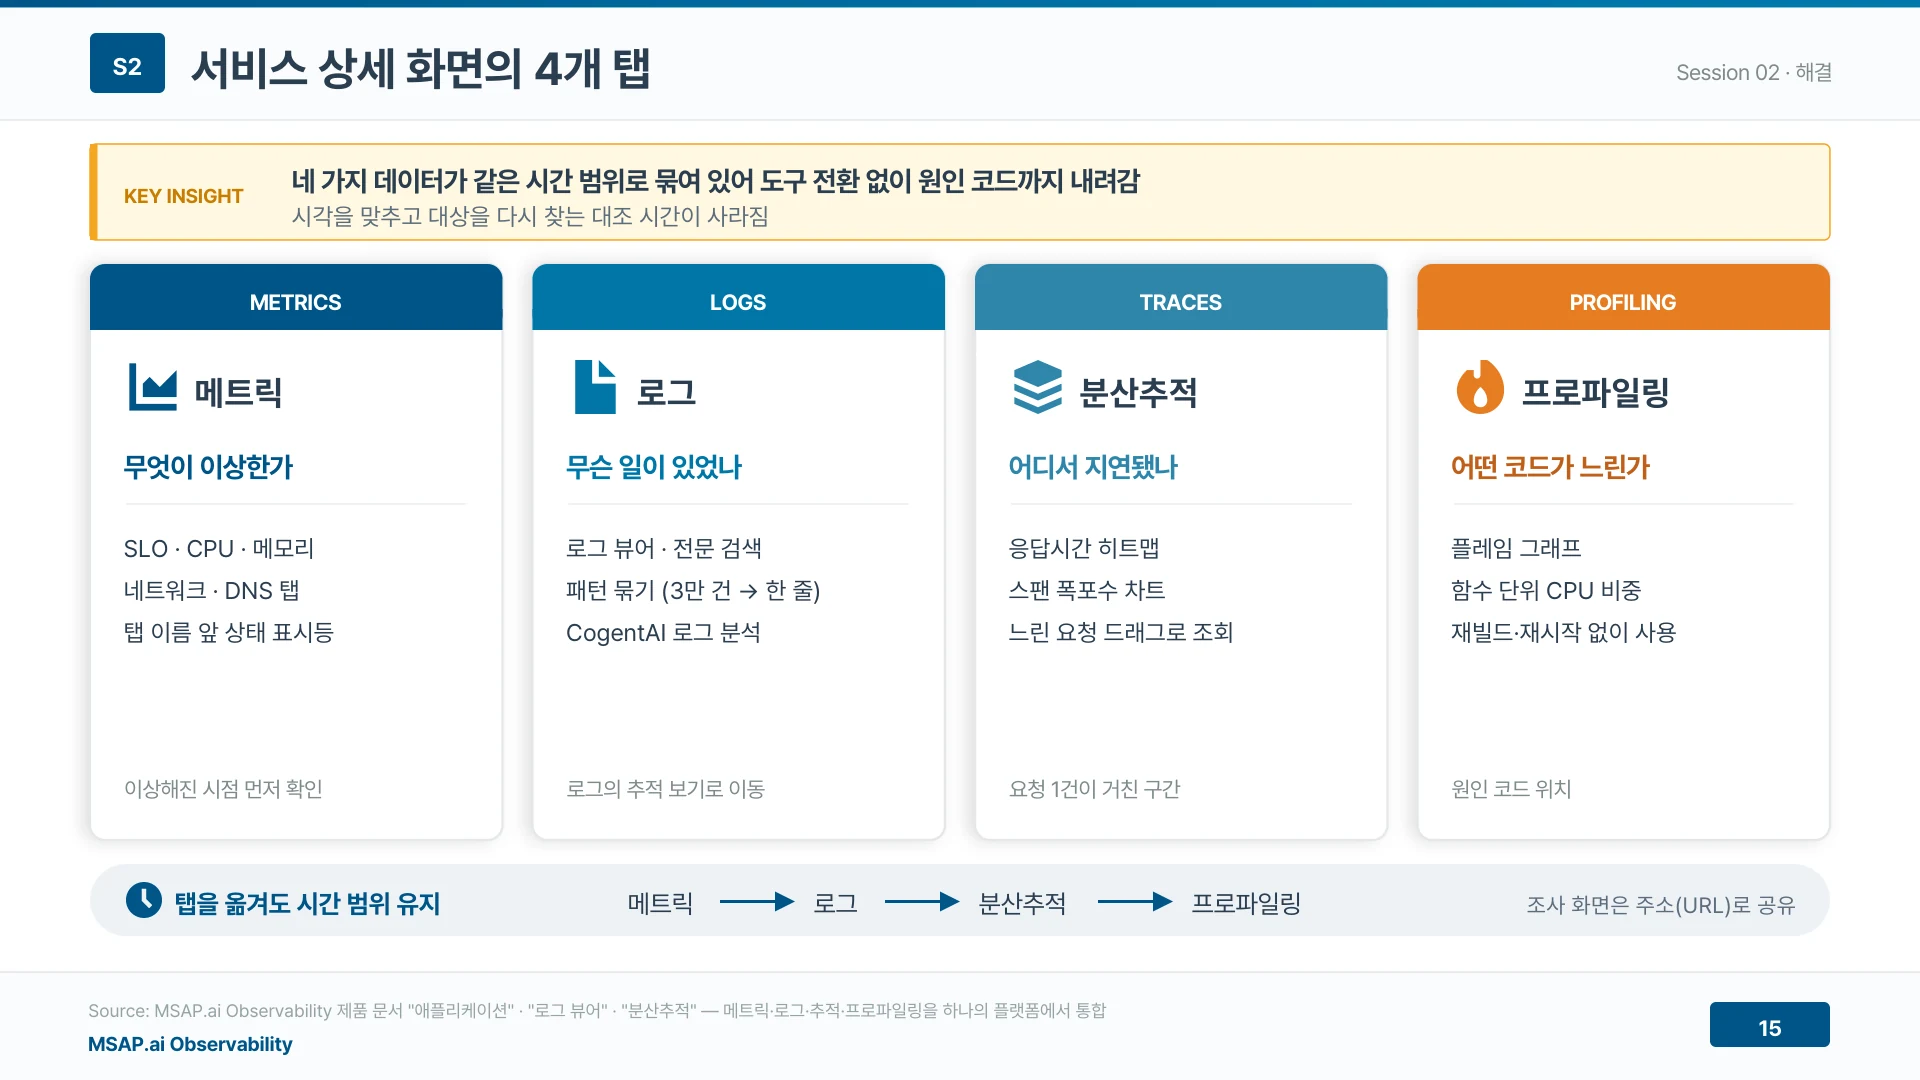
▲ 네 가지 데이터가 같은 시간 범위로 묶여 도구 전환 없이 원인 코드까지 내려감 (발표자료 15쪽)
후보 선정은 규칙이 맡고 로그 해석과 확인 순서는 AI가 맡는다
RCA가 규칙으로 원인 후보와 경로를 좁히면, CogentAI는 그 서비스의 로그를 읽어 무엇이 실패했고 무엇을 확인해야 하는지 설명한다.
RCA는 어느 서비스가 언제부터 이상했는지를 판정 기반으로 알려 준다. CogentAI는 버튼 한 번으로 긴 스택 트레이스를 표로 정리하고, 핵심 원인을 한 줄로 짚고, 확인 순서와 kubectl 명령을 제시한다.
| 구분 | RCA | CogentAI |
|---|---|---|
| 맡는 일 | 원인 후보와 전파 경로 | 로그 해석과 확인 순서 |
| 방식 | 판정 17개와 규칙 6개, 언어 모델 미사용 | 언어 모델로 로그 분석 |
| 결과 | 추정 근본 원인과 신뢰도 | 원인 요약, 점검 순서, 명령 예시 |
예를 들어 DNS 조회 실패 로그를 분석하면 도메인과 서비스 등록 여부, 클러스터 DNS 동작, 네트워크 정책 차단, Pod DNS 설정 순서로 점검하라고 안내한다. 사람이 판단할 재료가 근거와 설명으로 함께 나온다. 로그 분석 화면의 쓰임은 AI 장애 원인 분석 실전 데모에서도 볼 수 있다.
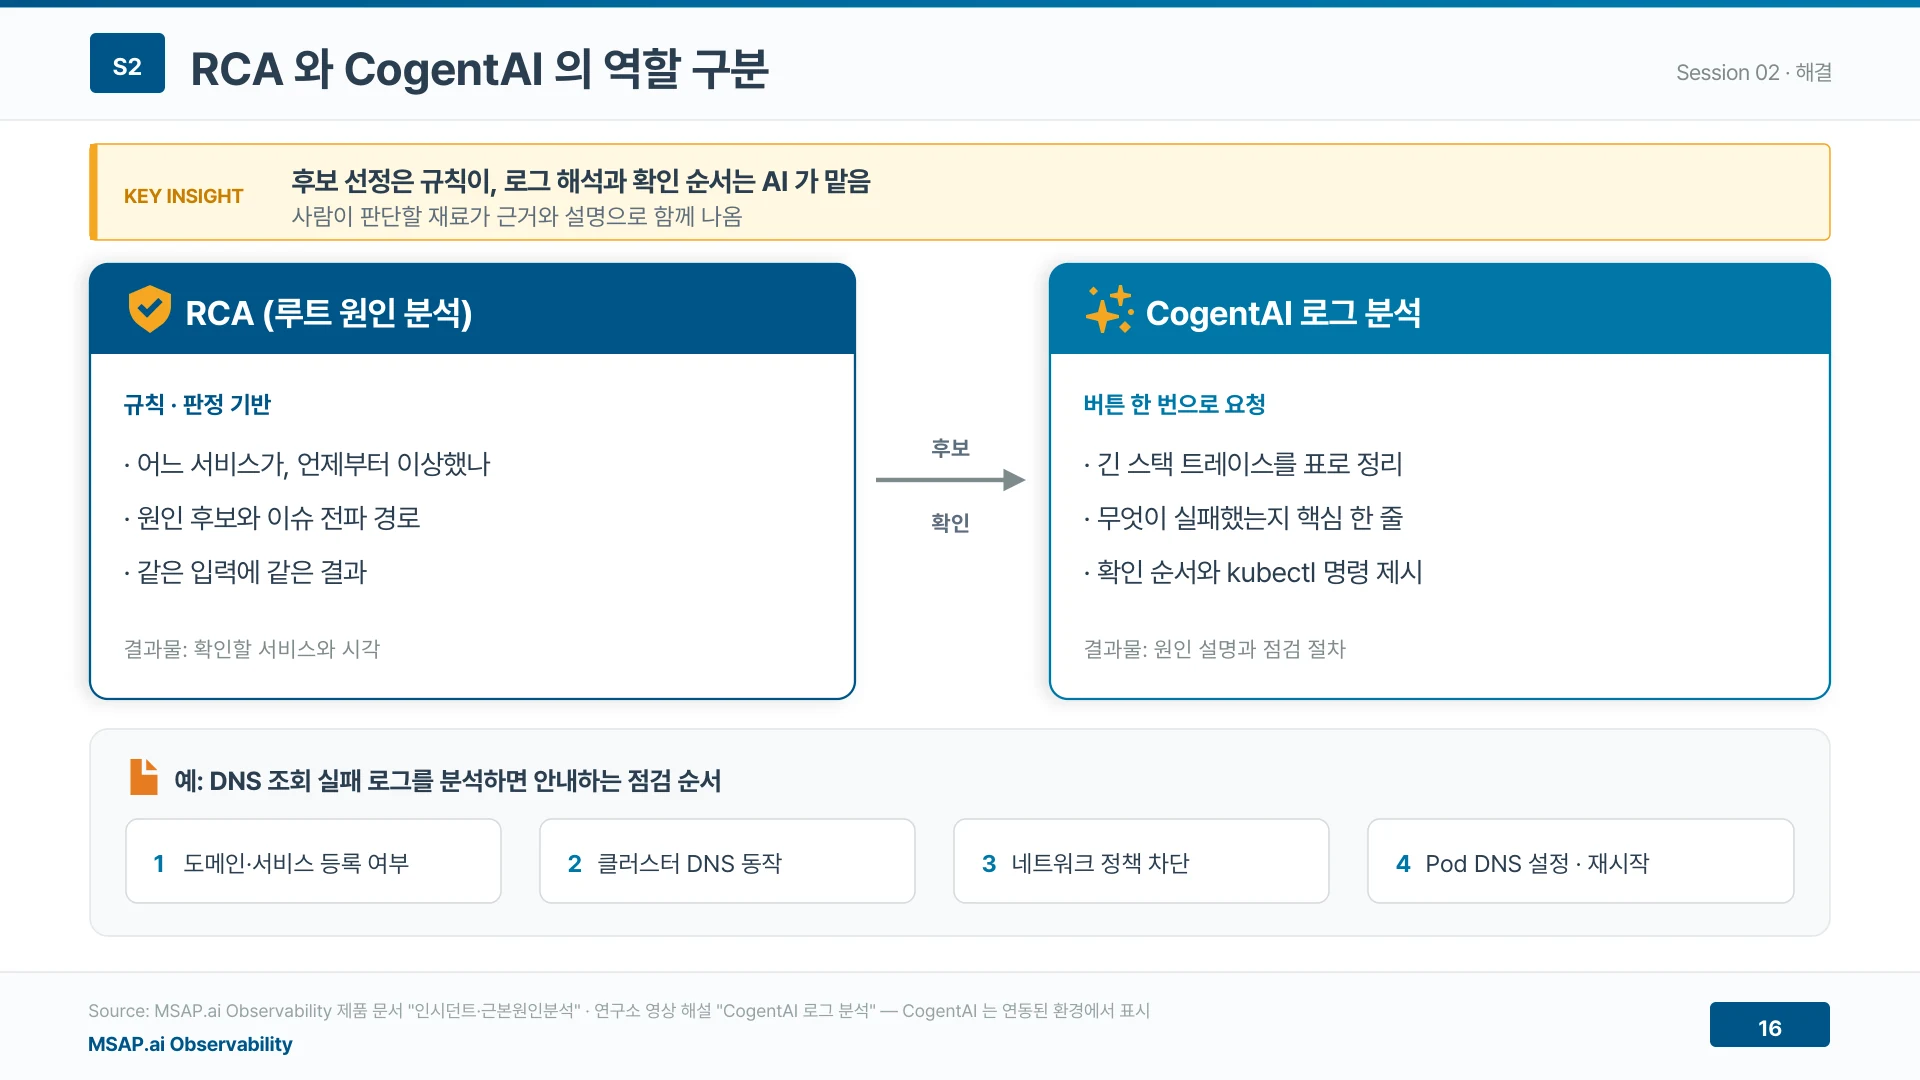
▲ 후보 선정은 규칙이, 로그 해석과 확인 순서는 AI가 맡음 (발표자료 16쪽)
주문이 안 되는 쇼핑몰 장애를 세 단계로 추적했다
데모는 세션1에서 쓴 쇼핑몰 서비스에 장애가 난 상황이다. 사용자는 주문이 안 된다고 하고, 어디가 원인인지 세 단계로 찾는다.
시작 시점의 오류율은 약 45%, 사용자 만족도는 절반이고 심각 인시던트가 3건 열려 있다. 1단계는 토폴로지 맵과 인시던트로 어디서 시작됐는지 본다. 2단계는 RCA로 원인 후보와 전파 경로를 좁힌다. 3단계는 메트릭, 로그, CogentAI로 배송과 결제 서비스에서 원인을 확인한다.
토폴로지 맵에서는 게이트웨이에서 결제로 가는 선이 전부 빨갰고, 인시던트가 열린 순서는 배송, 주문, 게이트웨이였다. 가장 먼저 열린 배송 서비스를 따라가는 동안 도구는 한 번도 바뀌지 않는다.
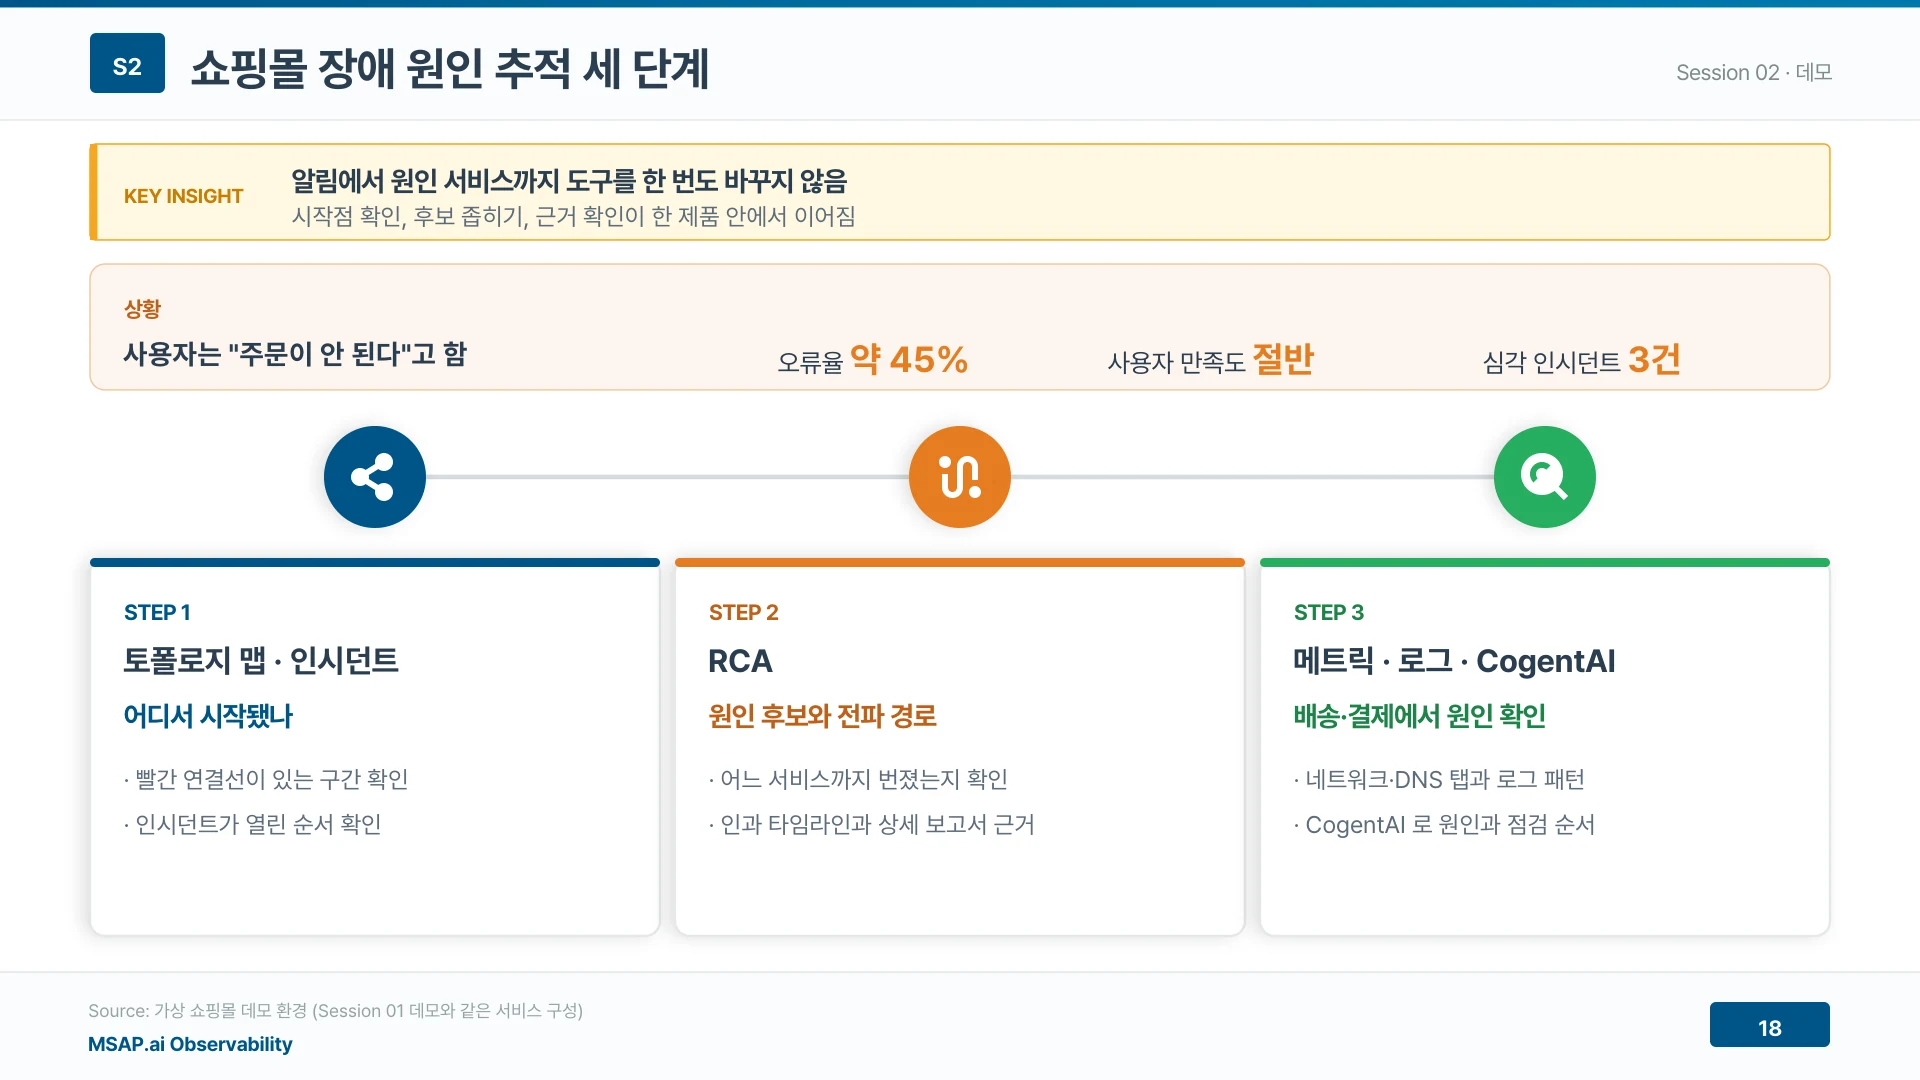
▲ 알림에서 원인 서비스까지 도구를 한 번도 바꾸지 않는 세 단계 (발표자료 18쪽)
데모 장애의 원인은 외부 도메인 DNS 조회 실패였다
인시던트 순서로 배송을 먼저 보고, RCA로 주문까지 번진 경로를 확인한 뒤, 네트워크, DNS, 로그 탭에서 원인이 DNS 조회 실패임을 찾았다.
RCA 상세 보고서는 배송 서비스의 로그 이상과 주문 서비스까지 번진 SLO 연쇄를 근거로 보여 줬다. 배송 서비스의 네트워크 탭에서는 13시 45분부터 택배사 API로 나가는 연결 시도 자체가 없었다. TCP 연결 상태는 정상이었고, 도메인 이름 탭에서 택배사 도메인 조회가 서버 실패로 끝나고 있었다. 로그 한 줄을 열면 IP가 비어 있고 실패 단계가 DNS였다.
결제 서비스도 13시 45분부터 같은 에러였고, CogentAI는 결제 서비스가 PG사 도메인을 조회하다 DNS에서 실패했다고 정리했다. 배송은 택배사 도메인, 결제는 PG사 도메인으로, 언어가 다른 두 서비스가 같은 원인으로 실패했다. 코드가 아니라 인프라 구간에서 시작된 장애도 같은 화면 흐름으로 짚을 수 있다.
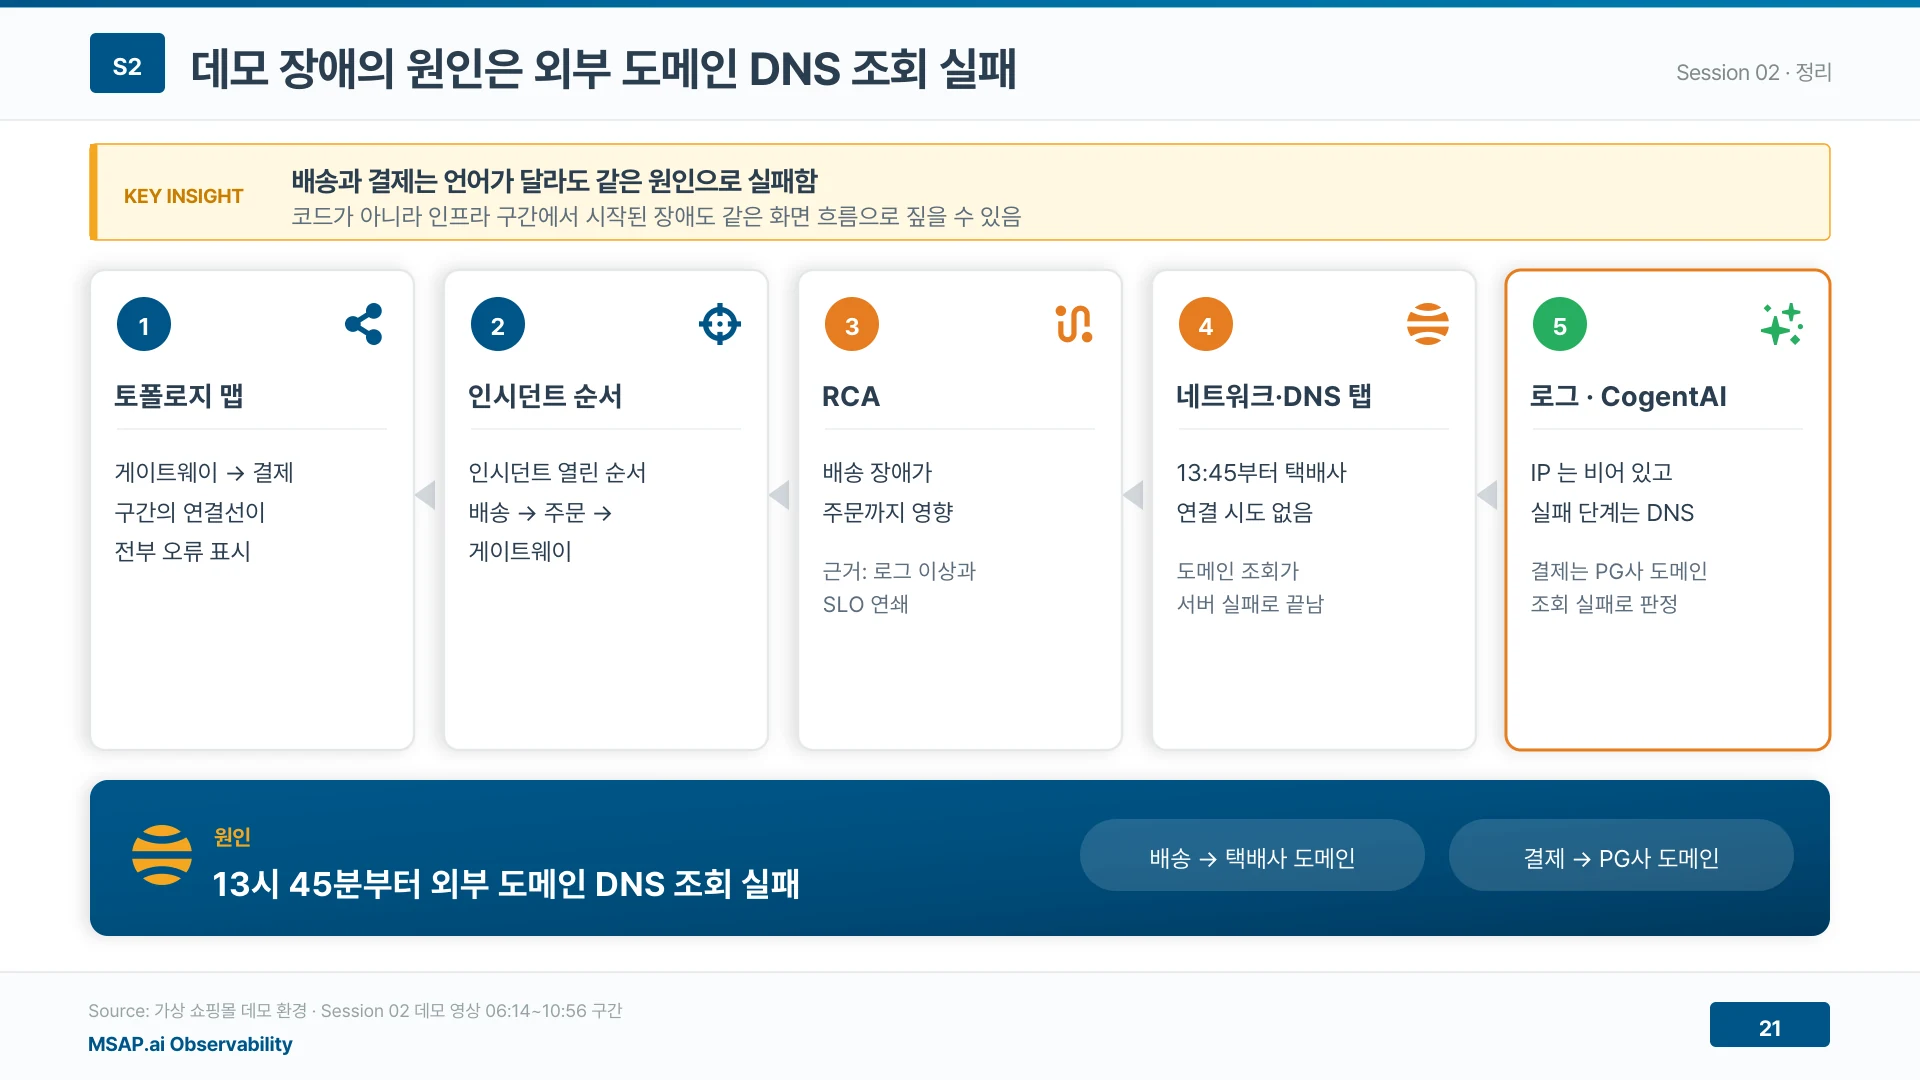
▲ 배송과 결제는 언어가 달라도 외부 도메인 DNS 조회 실패라는 같은 원인으로 실패함 (발표자료 21쪽)
추측하던 79분이 시작점, 후보, 근거를 확인하는 절차로 바뀐다
처음에 본 79분은 담당자들이 각자 화면을 열고 서로 물어보며 추측하던 시간이었다. 이 발표자료의 방식은 시작점, 후보, 근거를 화면에서 차례로 확인한다.
| 단계 | 이전 방식 | 이 발표자료의 방식 |
|---|---|---|
| 시작점 | 알림이 울린 서비스부터 각자 확인 | 토폴로지 맵과 인시던트 순서 |
| 원인 후보 | 담당자 경험과 추측 | RCA가 근거와 함께 제시 |
| 원인 확인 | 도구를 바꿔 가며 시각 맞추기 | 한 화면 4개 탭과 CogentAI 설명 |
담당자 경험에 기대던 조사가 화면에 남은 증거를 따라가는 절차로 바뀐다. 같은 장애에 필요한 사람과 시간이 줄어든다.
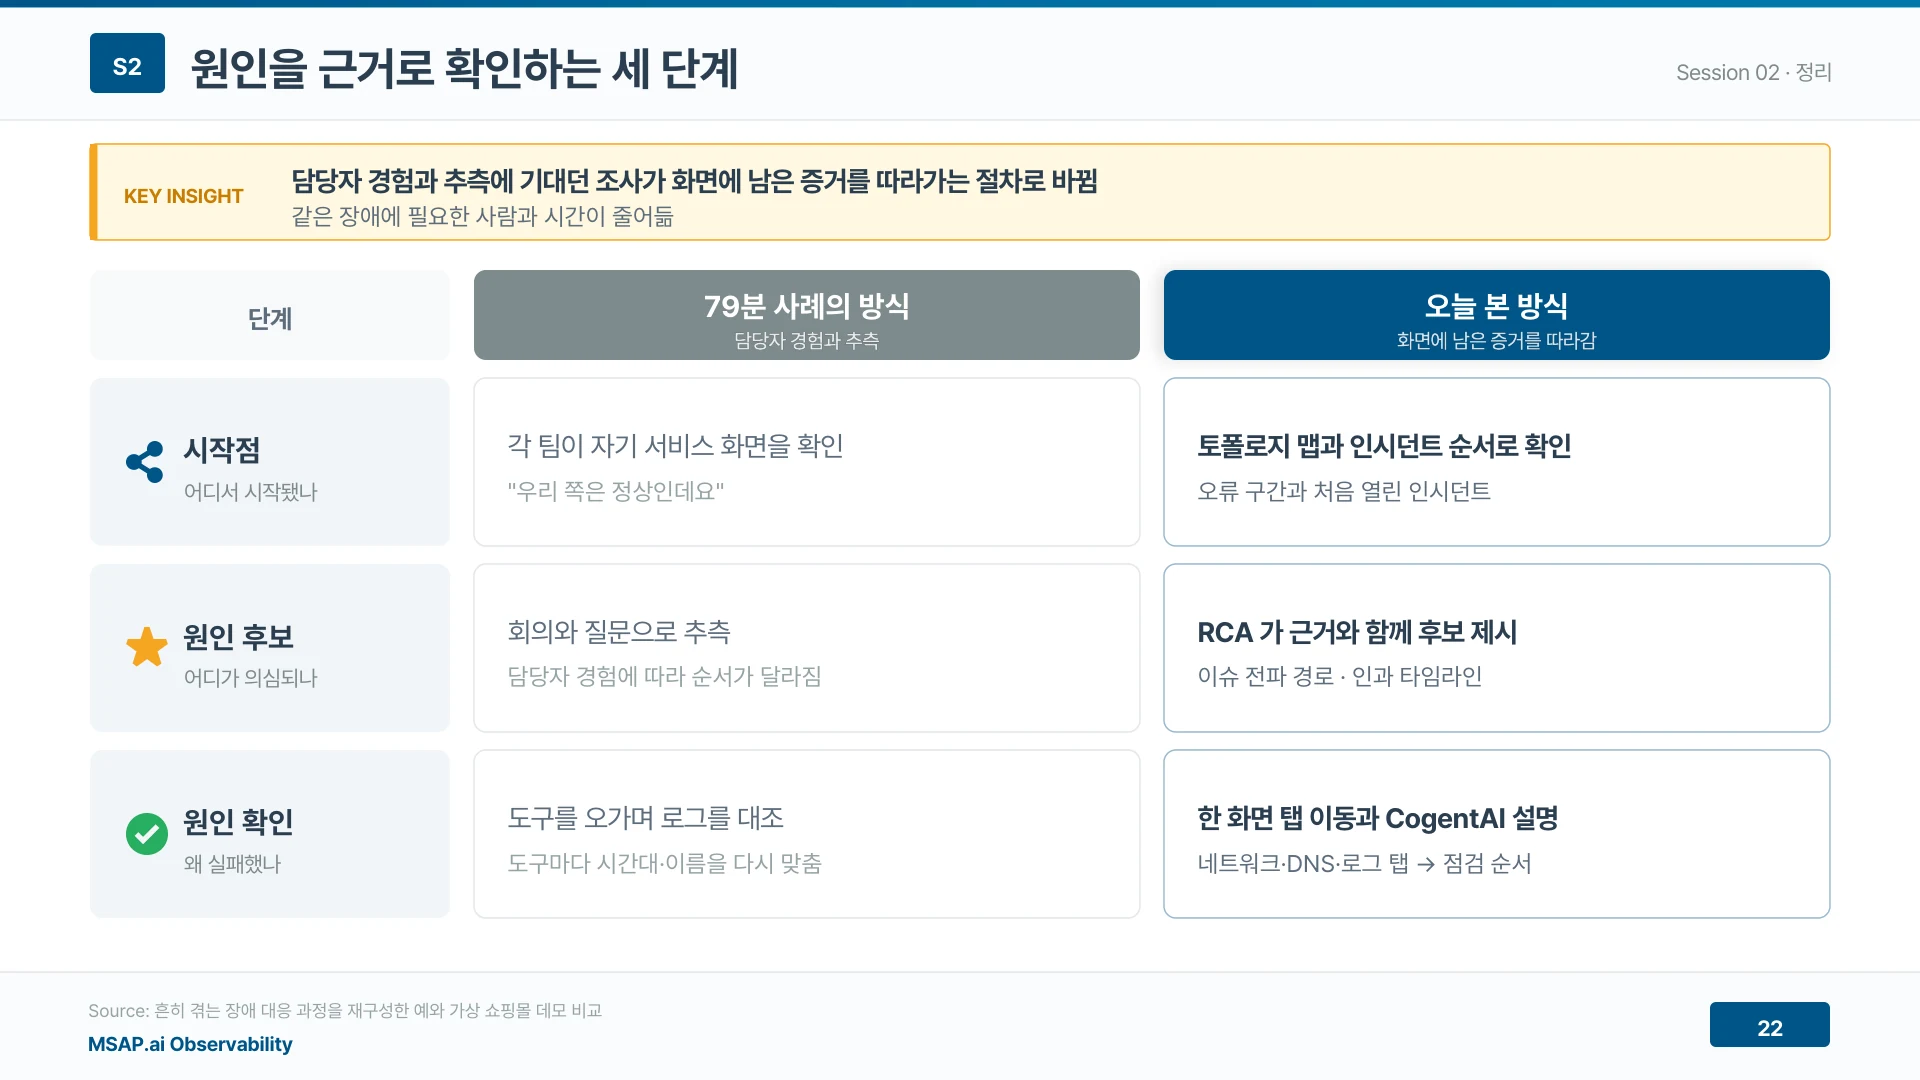
▲ 추측에 기대던 조사가 화면에 남은 증거를 따라가는 절차로 바뀜 (발표자료 22쪽)
코드에 문제가 없어도 DNS와 네트워크 구간에서 서비스가 멈출 수 있다
이번 데모 장애의 원인은 코드가 아니라 DNS였다. 인프라 구간 장애는 보이는 곳과 보이지 않는 곳을 나눠 짚어야 원인이 나온다.
DNS와 네트워크 탭은 TCP 왕복 시간과 연결 설정 지연, 연결 실패와 실패한 목적지, DNS 질의와 응답 지연, 도메인별 NXDOMAIN과 ServFail 건수를 본다. 반면 응답 전에 끊긴 외부 호출의 상세나, 연결이 막혀 요청이 아예 없는 구간의 오류율처럼 보이지 않는 구간도 있다.
쿠버네티스 파드는 기본 설정이 ndots:5라 클러스터 밖 이름 하나를 조회할 때 질의가 여러 번 나간다. 2019년 Zalando의 공개 사후 보고에서는 재시도 폭증이 CoreDNS 질의 폭증과 메모리 부족 재시작으로 이어져 클러스터 전체 DNS가 1시간 넘게 멈췄다. 클러스터 DNS의 동작 원리는 쿠버네티스 DNS 자동화와 CoreDNS 실무 적용 가이드에 정리돼 있다. 이어지는 세 번째 세션은 DNS와 네트워크 구간의 지연 진단을 다룬다.
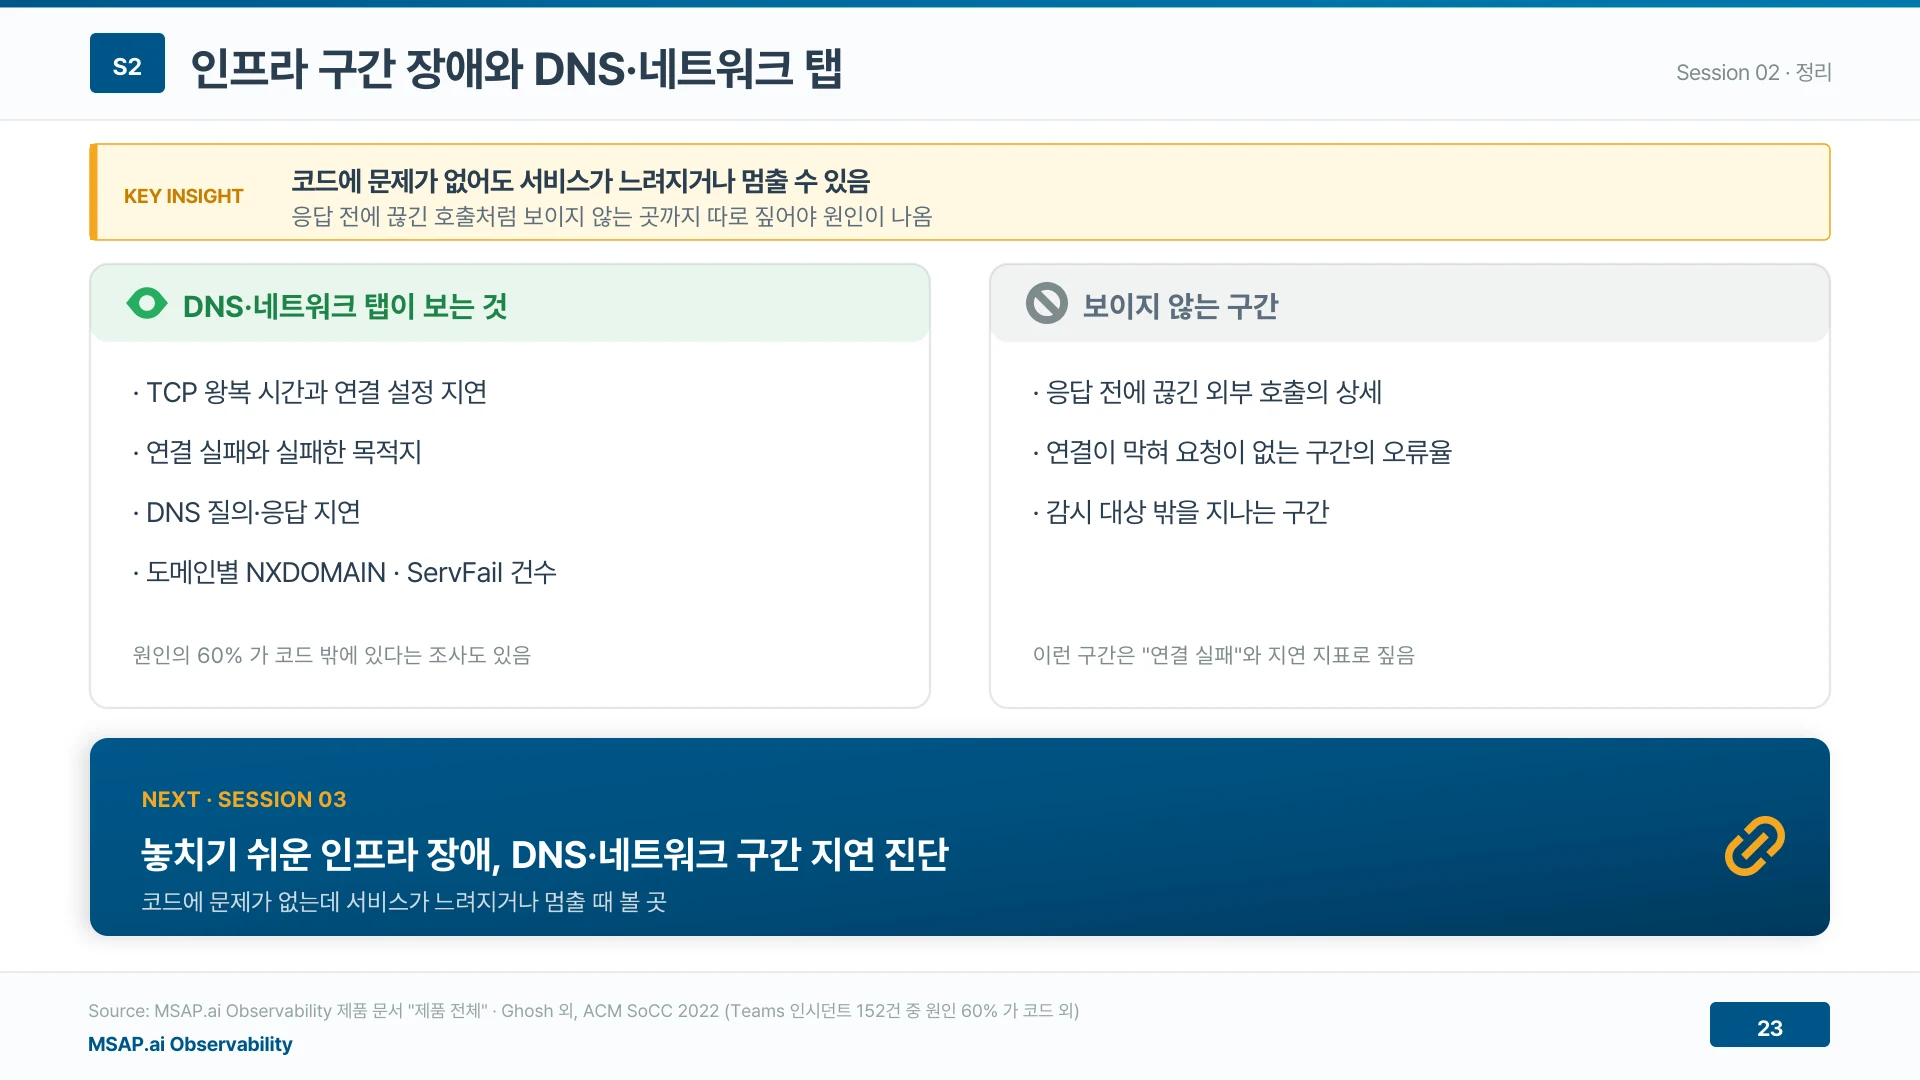
▲ 코드에 문제가 없어도 DNS와 네트워크 구간에서 서비스가 느려지거나 멈출 수 있음 (발표자료 23쪽)
핵심 정리
MSA 장애 대응에서 오래 걸리는 단계는 복구가 아니라 원인 서비스를 찾는 단계다. 장애는 호출하는 쪽으로 번지고 재시도가 2차 증상을 키우므로, 알림 위치보다 먼저 이상해진 지점을 찾아야 한다.
토폴로지 맵과 인시던트 순서로 시작점을 보고, 규칙 기반 RCA로 원인 후보와 전파 경로를 좁히고, 한 화면의 4개 탭과 CogentAI 설명으로 근거를 확인한다. RCA 결과는 확정이 아니라 후보이고, 데모처럼 원인이 코드 밖 DNS에 있을 때도 같은 흐름으로 찾는다.
자주 묻는 질문
MSA에서 원인 서비스를 찾기 어려운 이유는 무엇인가
장애가 호출하는 쪽으로 번지고 재시도가 2차 증상을 만들어 처음 문제가 생긴 곳을 가리기 때문이다. 팀마다 다른 도구와 시간대를 보면 각자 정상이라는 판단을 맞춰 보는 데도 시간이 든다.
알림이 먼저 울린 서비스가 원인이 아닌 경우가 있는가
있다. 결제가 느려지면 결제를 부르는 주문과 게이트웨이가 함께 느려져 알림이 그쪽에서 먼저 울릴 수 있다. 요청이 거친 전체 경로를 같은 시간대로 봐야 원인을 가린다.
인시던트는 어떤 조건에서 만들어지는가
가용성이나 응답시간 SLO를 위반했을 때만 자동으로 만들어진다. 이상 탐지 같은 개별 규칙은 인시던트가 아니라 알림으로 따로 가고, 원인이 사라지면 인시던트는 자동으로 해결된다.
RCA는 무엇을 근거로 원인 후보를 고르는가
애플리케이션마다 이미 돌고 있는 판정 17개에 배포 상관, 업스트림 장애, 리소스 포화, 로그 패턴, SLO 연쇄, DB 이슈 여섯 규칙을 적용한다. 순서는 시간 상관, 토폴로지 근접, 심각도, 증거 강도의 가중 합산으로 정하고 언어 모델은 쓰지 않는다.
RCA 결과를 그대로 원인으로 믿어도 되는가
그대로 믿지 않고 근거로 확인한다. 화면은 결과를 추정 근본 원인과 신뢰도로 표시하고, 항목을 누르면 근거 차트와 로그 표본, 같은 시간대로 걸러진 추적이 이어진다.
RCA와 CogentAI는 어떻게 다른가
RCA는 규칙과 판정으로 어느 서비스가 언제부터 이상했는지 후보와 경로를 좁힌다. CogentAI는 그 서비스의 로그를 읽어 무엇이 실패했는지 정리하고 확인 순서와 명령 예시를 제시한다.
원인이 코드가 아닐 때는 어디를 보는가
네트워크 탭과 DNS 탭에서 연결 실패, 실패한 목적지, DNS 응답 지연, NXDOMAIN과 ServFail 건수를 본다. 데모 장애도 외부 도메인 DNS 조회 실패가 원인이었다.
참고 리소스
MSAP.ai 자료
- eBPF 기반 서비스 모니터링 발표자료 (세미나 세션 1)
- AI Native 옵저버빌리티로 5분 내에 장애 원인 찾는 3가지 방법 (세미나 안내)
- 쿠버네티스 관측성, OpenTelemetry, 분산 추적
- AI 장애 원인 분석 실전 데모 — 알람에서 조치까지 가는 운영 방식
- AIOps 기능 활용, 운영자가 장애 원인을 빠르게 찾는 기준
- 코드 수정 없이 쿠버네티스 운영 상태 진단 (Observability)
- 쿠버네티스 DNS 자동화 — CoreDNS 실무 적용 가이드
외부 공개 자료
- Google SRE Book — Addressing Cascading Failures (2016)
- Microsoft Research — How to Fight Production Incidents? (SoCC 2022)
- PagerDuty — 2024 고객 대면 인시던트 조사 보도자료
- Grafana Labs — Observability Survey 2025
- Pham 외 — Root Cause Analysis for Microservice System based on Causal Inference (ASE 2024)
- Kubernetes 문서 — DNS for Services and Pods
- Kubernetes 문서 — Debugging DNS Resolution
- Zalando — Total DNS outage in Kubernetes cluster 사후 보고 (2019)